
Cybersicherheit
Warum Adversarial Image-Angriffe kein Scherz sind

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
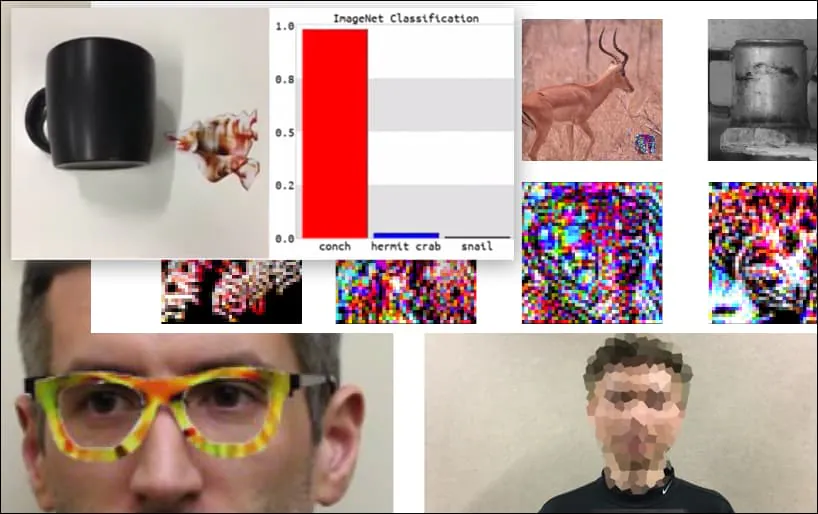
Den Angriff auf Bilderkennungssysteme mit sorgfältig erstellten adversarialen Bildern wurde in den letzten fünf Jahren als amüsantes, aber triviales Konzept betrachtet. Neue Forschung aus Australien legt jedoch nahe, dass die lockere Verwendung hochpopulärer Bild-Datensätze für kommerzielle KI-Projekte ein neues, langfristiges Sicherheitsproblem schaffen könnte.
Seit ein paar Jahren versucht eine Gruppe von Akademikern an der University of Adelaide, etwas Wichtiges über die Zukunft von AI-basierten Bilderkennungssystemen zu erklären.
Es ist etwas, das schwierig (und sehr teuer) zu beheben wäre, und das unerträglich teuer wäre, zu beheben, sobald die aktuellen Trends in der Bilderkennungsforschung in kommerzielle und industrielle Einrichtungen in 5-10 Jahren umgesetzt werden.
Bevor wir uns damit befassen, lassen Sie uns uns ein Bild ansehen, das als Präsident Barack Obama klassifiziert wird, aus einem der sechs Videos, die das Team auf der Projektseite veröffentlicht hat:
Quelle: https://www.youtube.com/watch?v=Klepca1Ny3c
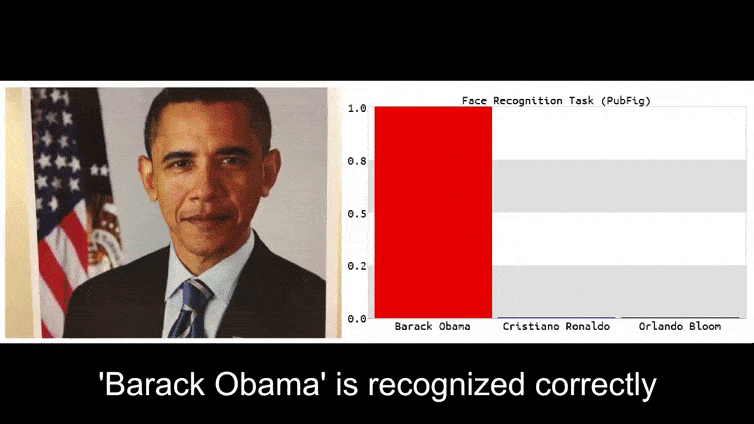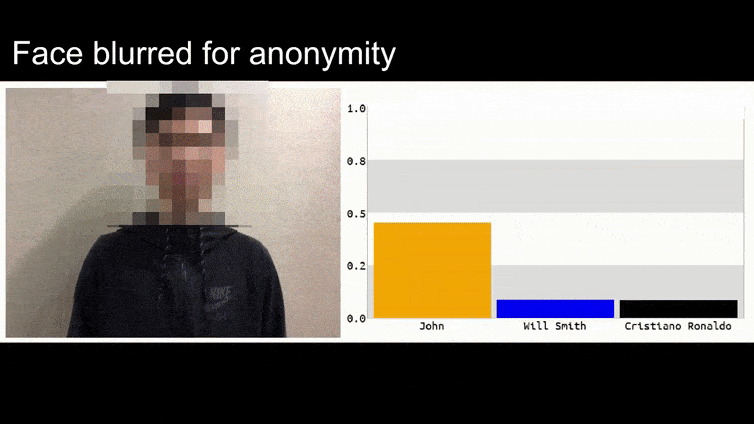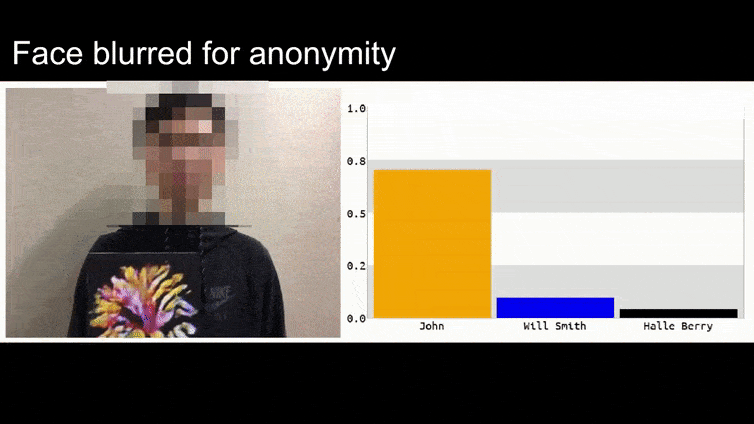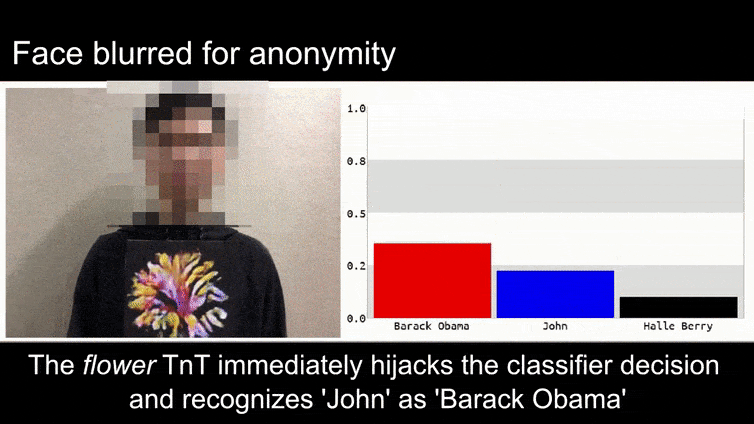
Im obigen Bild wird ein Gesichtserkennungssystem, das offensichtlich weiß, wie man Barack Obama erkennt, hereingelegt und ist zu 80% sicher, dass ein anonymisierter Mann, der ein gefertigtes, gedrucktes adversarialles Bild einer Blume hält, auch Barack Obama ist. Das System kümmert sich nicht einmal darum, dass das “falsche Gesicht” auf der Brust des Subjekts und nicht auf seinen Schultern ist.
Obwohl es beeindruckend ist, dass die Forscher es geschafft haben, diese Art von Identitätsübernahme durch die Generierung eines kohärenten Bildes (einer Blume) anstelle von nur zufälligem Rauschen zu erreichen, scheint es, dass solche albernen Ausbeutungen wie diese in der Sicherheitsforschung auf Computer-Vision ziemlich regelmäßig auftauchen. Zum Beispiel die seltsam gemusterten Brillen, die 2016 Gesichtserkennung ausgetrickst haben, oder speziell gefertigte adversarialle Bilder, die versuchen, Straßenschilder umzuschreiben.
Wenn Sie interessiert sind, ist das Convolutional Neural Network (CNN)-Modell, das in dem obigen Beispiel angegriffen wird, VGGFace (VGG-16), das auf dem PubFig-Datensatz der Columbia University trainiert wurde. Andere Angriffsbeispiele, die von den Forschern entwickelt wurden, verwendeten unterschiedliche Ressourcen in verschiedenen Kombinationen.

Eine Tastatur wird als Muschel neu klassifiziert, in einem WideResNet50-Modell auf ImageNet. Die Forscher haben auch sichergestellt, dass das Modell keine Voreingenommenheit gegenüber Muscheln hat. Siehe das vollständige Video für erweiterte und zusätzliche Demonstrationen unter https://www.youtube.com/watch?v=dhTTjjrxIcU
Bilderkennung als aufkommender Angriffsvektor
Die vielen beeindruckenden Angriffe, die die Forscher skizzieren und illustrieren, sind keine Kritik an einzelnen Datensätzen oder spezifischen maschinellen Lernalgorithmen, die diese verwenden. Auch können sie nicht leicht durch das Umschalten von Datensätzen oder Modellen, das erneute Trainieren von Modellen oder andere “einfache” Abhilfen verteidigt werden, die ML-Praktiker dazu bringen, über sporadische Demonstrationen dieser Art von Trickerei zu spotten.
Rather, die Ausbeutungen der Adelaide-Gruppe exemplifizieren eine zentrale Schwäche in der gesamten aktuellen Architektur der Bilderkennungsentwicklung; eine Schwäche, die viele zukünftige Bilderkennungssysteme anfällig für eine einfache Manipulation durch Angreifer machen und alle nachfolgenden Abwehrmaßnahmen auf dem Rückfuß setzen könnte.
Stellen Sie sich vor, dass die neuesten adversarialen Angriffsbilder (wie die Blume oben) als “Zero-Day-Exploits” zu den Sicherheitssystemen der Zukunft hinzugefügt werden, genauso wie aktuelle Anti-Malware- und Antiviren-Frameworks ihre Virendefinitionen jeden Tag aktualisieren.
Das Potenzial für neue adversarialle Bildangriffe wäre unerschöpflich, weil die Grundarchitektur des Systems nicht auf nachfolgende Probleme vorbereitet war, wie es mit dem Internet, dem Millennium-Bug und dem schiefen Turm von Pisa der Fall war.
In welcher Weise also bereiten wir uns auf dies vor?
Das Erhalten der Daten für einen Angriff
Adversarialle Bilder wie das “Blumen”-Beispiel oben werden durch den Zugriff auf die Bild-Datensätze erzeugt, die die Computermodelle trainiert haben. Sie benötigen keinen “privilegierten” Zugriff auf Trainingsdaten (oder Modellarchitekturen), da die meisten populären Datensätze (und viele trainierte Modelle) in einer robusten und ständig aktualisierten Torrent-Szene weit verbreitet sind.
Beispielsweise ist das renommierte ImageNet, der Goliath der Computer-Vision-Datensätze, über Torrent in all seinen vielen Iterationen verfügbar, wodurch die üblichen Einschränkungen umgangen werden und wichtige sekundäre Elemente wie Validierungssets verfügbar gemacht werden.

Quelle: https://academictorrents.com
Wenn Sie die Daten haben, können Sie (wie die Adelaide-Forscher bemerken) effektiv jeden populären Datensatz wie CityScapes oder CIFAR “reverse-engineeren”.
Im Fall von PubFig, dem Datensatz, der das “Obama-Blumen”-Beispiel ermöglichte, hat die Columbia University eine wachsende Tendenz bei Urheberrechtsproblemen bei der Weiterverteilung von Bild-Datensätzen angegangen, indem sie Forschern anweist, wie man den Datensatz über kuratierte Links reproduzieren kann, anstatt die Kompilation direkt verfügbar zu machen, und bemerkt ‘Dies scheint der Weg zu sein, den andere große webbasierte Datenbanken gehen’.
In den meisten Fällen ist das nicht notwendig: Kaggle schätzt, dass die zehn populärsten Bild-Datensätze in der Computer-Vision CIFAR-10 und CIFAR-100 (beide direkt herunterladbar) sind; CALTECH-101 und 256 (beide verfügbar und derzeit als Torrents verfügbar); MNIST (offiziell verfügbar, auch auf Torrents); ImageNet (siehe oben); Pascal VOC (verfügbar, auch auf Torrents); MS COCO (verfügbar, und auf Torrents); Sports-1M (verfügbar); und YouTube-8M (verfügbar).
Die Verfügbarkeit ist auch repräsentativ für den breiteren Bereich verfügbarer Computer-Vision-Bild-Datensätze, da Unsichtbarkeit der Tod in einer “publizieren oder untergehen”-Kultur der Open-Source-Entwicklung ist.
In jedem Fall verschärfen die Knappheit an verwaltbaren neuen Datensätzen, die hohen Kosten für die Entwicklung von Bild-Sätzen, die Abhängigkeit von “alten Favoriten” und die Tendenz, ältere Datensätze einfach anzupassen, alle das Problem, das in dem neuen Adelaide-Papier skizziert wird.
Typische Kritik an adversarialen Bild-Angriffsmethoden
Die häufigste und anhaltendste Kritik von maschinellen Lernalgorithmen an der Wirksamkeit der neuesten adversarialen Bild-Angriffstechnik ist, dass der Angriff spezifisch für einen bestimmten Datensatz, ein bestimmtes Modell oder beides ist; dass er nicht “verallgemeinerbar” auf andere Systeme ist; und dass er daher nur eine triviale Bedrohung darstellt.
Die zweithäufigste Beschwerde ist, dass der adversarale Bild-Angriff ‘white box’ ist, was bedeutet, dass man direkten Zugriff auf die Trainingsumgebung oder Daten benötigt. Dies ist tatsächlich ein unwahrscheinliches Szenario in den meisten Fällen – beispielsweise, wenn man die Trainingsprozesse für die Gesichtserkennungssysteme der Metropolitan Police von London ausbeuten wollte, müsste man in NEC eindringen, entweder mit einer Konsole oder einer Axt.
Das langfristige “DNA” populärer Computer-Vision-Datensätze
Was die erste Kritik betrifft, sollten wir berücksichtigen, dass nicht nur eine Handvoll Computer-Vision-Datensätze die Branche Jahr für Jahr dominiert (d. h. ImageNet für mehrere Arten von Objekten, CityScapes für Fahrzeugszenen und FFHQ für Gesichtserkennung); sondern auch, dass sie als einfache annotierte Bild-Daten “plattform-agnostisch” und hochgradig übertragbar sind.
Je nach ihren Fähigkeiten wird jedes Computer-Vision-Trainings-Modell irgendeine Merkmale von Objekten und Klassen im ImageNet-Datensatz finden. Einige Architekturen finden möglicherweise mehr Merkmale als andere oder machen nützlichere Verbindungen als andere, aber alle sollten mindestens die höchsten Merkmale finden:

ImageNet-Daten mit der minimalen Anzahl korrekter Identifizierungen – ‘hochrangige’ Merkmale.
Es sind diese “hochrangigen” Merkmale, die einen Datensatz unterscheiden und “fingerprinten” und die zuverlässigen “Haken” sind, an denen man eine langfristige adversarale Bild-Angriffsmethode aufhängen kann, die verschiedene Systeme überbrücken und mit dem “alten” Datensatz wachsen kann, wenn dieser in neuen Forschungen und Produkten perpetuiert wird.
Eine komplexere Architektur wird genauere und detailliertere Identifizierungen, Merkmale und Klassen produzieren:

Je mehr jedoch ein adversaraler Angriffsgenerator auf diese niedrigeren Merkmale angewiesen ist (d. h. “junges kaukasisches Männchen” anstelle von “Gesicht”), desto weniger effektiv wird er in Übertragungen oder späteren Architekturen sein, die verschiedene Versionen des ursprünglichen Datensatzes verwenden – wie z. B. ein Teil- oder Filter-Set, in dem viele der ursprünglichen Bilder aus dem vollen Datensatz nicht vorhanden sind:

Adversarale Angriffe auf “Zeroed”, vorab trainierte Modelle
Was passiert, wenn man einfach ein vorab trainiertes Modell herunterlädt, das ursprünglich auf einem sehr populären Datensatz trainiert wurde, und es dann völlig neuen Daten gibt?
Das Modell wurde bereits auf ImageNet trainiert, und alles, was übrig bleibt, sind die Gewichte, die möglicherweise Wochen oder Monate zum Trainieren benötigt haben und jetzt bereit sind, ähnliche Objekte wie diejenigen zu identifizieren, die im ursprünglichen (jetzt abwesenden) Datensatz vorhanden waren.

Mit dem ursprünglichen Datensatz, der aus der Trainingsarchitektur entfernt wurde, bleibt die ‘Vorprägung’ des Modells, Objekte auf die Weise zu klassifizieren, die es ursprünglich gelernt hat, was im Wesentlichen dazu führen wird, dass viele der ursprünglichen ‘Signaturen’ sich neu bilden und erneut anfällig für die gleichen alten adversarialen Bild-Angriffsmethoden werden.
Diese Gewichte sind wertvoll. Ohne die Daten oder die Gewichte hat man im Wesentlichen eine leere Architektur ohne Daten. Man muss es von Grund auf trainieren, was einen enormen Zeitaufwand und Rechenressourcen erfordert, genau wie die ursprünglichen Autoren es getan haben (wahrscheinlich mit leistungsfähigerer Hardware und einem höheren Budget als dem, das man zur Verfügung hat).
Das Problem ist, dass die Gewichte bereits ziemlich gut geformt und widerstandsfähig sind. Obwohl sie sich während des Trainings ein wenig anpassen werden, werden sie auf neue Daten ähnlich reagieren wie auf die ursprünglichen Daten, was zu Merkmalen führt, die ein adversarales Angriffssystem wiedererkennen kann.
Auf lange Sicht bewahrt dies das “DNA” von Computer-Vision-Datensätzen, die zwölf oder mehr Jahre alt sind und möglicherweise eine bemerkenswerte Evolution von Open-Source-Bemühungen bis hin zu kommerziellen Einrichtungen durchlaufen haben – selbst wenn die ursprünglichen Trainingsdaten zu Beginn des Projekts vollständig entfernt wurden. Einige dieser kommerziellen Einrichtungen mögen erst in einigen Jahren stattfinden.
Keine White Box benötigt
Was die zweite häufige Kritik an adversarialen Bild-Angriffssystemen betrifft, haben die Autoren des neuen Papiers festgestellt, dass ihre Fähigkeit, Erkennungssysteme mit gefertigten Bildern von Blumen zu täuschen, sehr übertragbar auf eine Reihe von Architekturen ist.
Während sie bemerken, dass ihre “Universal Naturalistic Adversarial Patches” (TnT)-Methode die erste ist, die erkennbare Bilder (anstelle von zufälligem Rauschen) verwendet, um Bild-Erkennungssysteme zu täuschen, erklären die Autoren auch:
‘[TnTs] sind effektiv gegen mehrere State-of-the-Art-Klassifizierer, von denen, die im Large-Scale-Visual-Recognition-Aufgaben des ImageNet-Datensatzes verwendet werden, bis hin zu VGG-Face-Modellen im Gesichtserkennungsaufgaben des PubFig-Datensatzes, sowohl in gezielten als auch in ungezielten Angriffen.
‘TnTs können besitzen: i) die Naturalismus, der mit den Auslösern in Trojan-Angriffsmethoden erreichbar ist; und ii) die Verallgemeinerung und Übertragbarkeit von adversarialen Beispielen auf andere Netze.
‘Dies wirft Sicherheits- und Sicherheitsbedenken hinsichtlich bereits eingesetzter DNNs sowie zukünftiger DNN-Einsätze auf, bei denen Angreifer unscheinbare, natürlich aussehende Objekt-Patches verwenden können, um neuronale Netzwerksysteme zu täuschen, ohne das Modell zu manipulieren und die Entdeckung zu riskieren.’
Die Autoren schlagen vor, dass herkömmliche Abwehrmaßnahmen wie die Verschlechterung der sauberen Genauigkeit eines Netzwerks theoretisch einige Verteidigung bieten könnten, dass ‘TnTs jedoch erfolgreich diese SOTA-bewährten Abwehrmethoden mit den meisten der verteidigenden Systeme umgehen können, die 0% Robustheit erreichen’.
Mögliche andere Lösungen umfassen federatives Lernen, bei dem die Herkunft der beitragenden Bilder geschützt ist, und neue Ansätze, die Daten direkt während des Trainings “verschlüsseln” könnten, wie einer kürzlich vorgeschlagenen von der Nanjing University of Aeronautics and Astronautics.
Selbst in diesen Fällen wäre es wichtig, auf wirklich neuen Bild-Daten zu trainieren – inzwischen sind die Bilder und zugehörigen Annotationen in der kleinen Gruppe der populärsten CV-Datensätze so sehr in Entwicklungszyklen auf der ganzen Welt verankert, dass sie eher Software als Daten ähneln; Software, die oft in den letzten Jahren nicht wesentlich aktualisiert wurde.
Schlussfolgerung
Adversarale Bild-Angriffe werden nicht nur durch Open-Source-Machine-Learning-Praktiken ermöglicht, sondern auch durch eine Unternehmens-KI-Entwicklungs-Kultur, die motiviert ist, etablierte Computer-Vision-Datensätze aus mehreren Gründen wiederzuverwenden: Sie haben sich bereits als effektiv erwiesen; sie sind viel billiger als “von vorne zu beginnen”; und sie werden von Vorreitern und Organisationen in Wissenschaft und Industrie auf hohem Niveau mit Finanzierung und Personal betreut, was für ein einzelnes Unternehmen schwer zu erreichen wäre.
Zusätzlich sind in vielen Fällen, in denen die Daten nicht ursprünglich sind (wie CityScapes), die Bilder vor den jüngsten Kontroversen um Datenschutz und Datenerfassungspraktiken gesammelt worden, was diese älteren Datensätze in eine Art halblegale Zwischenwelt versetzt, die aus Unternehmenssicht wie ein “sicherer Hafen” aussehen mag.
TnT-Angriffe! Universelle naturalistische adversarale Patches gegen tiefe neuronale Netzwerksysteme ist von Bao Gia Doan, Minhui Xue, Ehsan Abbasnejad, Damith C. Ranasinghe von der University of Adelaide, zusammen mit Shiqing Ma von der Abteilung für Informatik der Rutgers University, verfasst.
Stand: 1. Dezember 2021, 7:06 Uhr GMT+2 – Tippfehler korrigiert.


