
AGI und Zukunft der KI
Was ist der Turing-Test und warum ist er wichtig?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Der Turing-Test entstand aus Alan Turings 1950er Aufsatz “Computing Machinery and Intelligence”. Anstatt zu versuchen, Denken zu definieren, schlug Turing ein Imitationsspiel: ein menschlicher Prüfer tauscht schriftliche Nachrichten mit unsichtbaren Teilnehmern aus und beurteilt, welcher Mensch und welcher Maschine ist.
Der Test bleibt einflussreich, weil er eine abstrakte philosophische Frage in eine beobachtbare Interaktion verwandelt. Er ist jedoch begrenzt: menschlich zu wirken in einer Unterhaltung ist nicht dasselbe wie wahrheitsgemäß, sachkundig, sicher, bewusst oder allgemein intelligent zu sein.
Wesentliche Erkenntnisse
- Turings ursprüngliches Imitationsspiel ist ein textbasierter Verhaltenstest, keine Checkliste interner kognitiver Eigenschaften.
- Ergebnisse hängen vom Bewerter, Prompt, Dauer, den Anweisungen der Teilnehmenden und der Bewertungsregel ab.
- Ein Modell kann menschliche Konversation imitieren, dabei jedoch Fakten halluzinieren oder bei einfachen Robustheitstests scheitern.
- Moderne Bewertung benötigt Aufgabenmetriken, adversarielle Tests, menschliche Überprüfung und risikospezifische Evidenz zusätzlich zur Konversation.
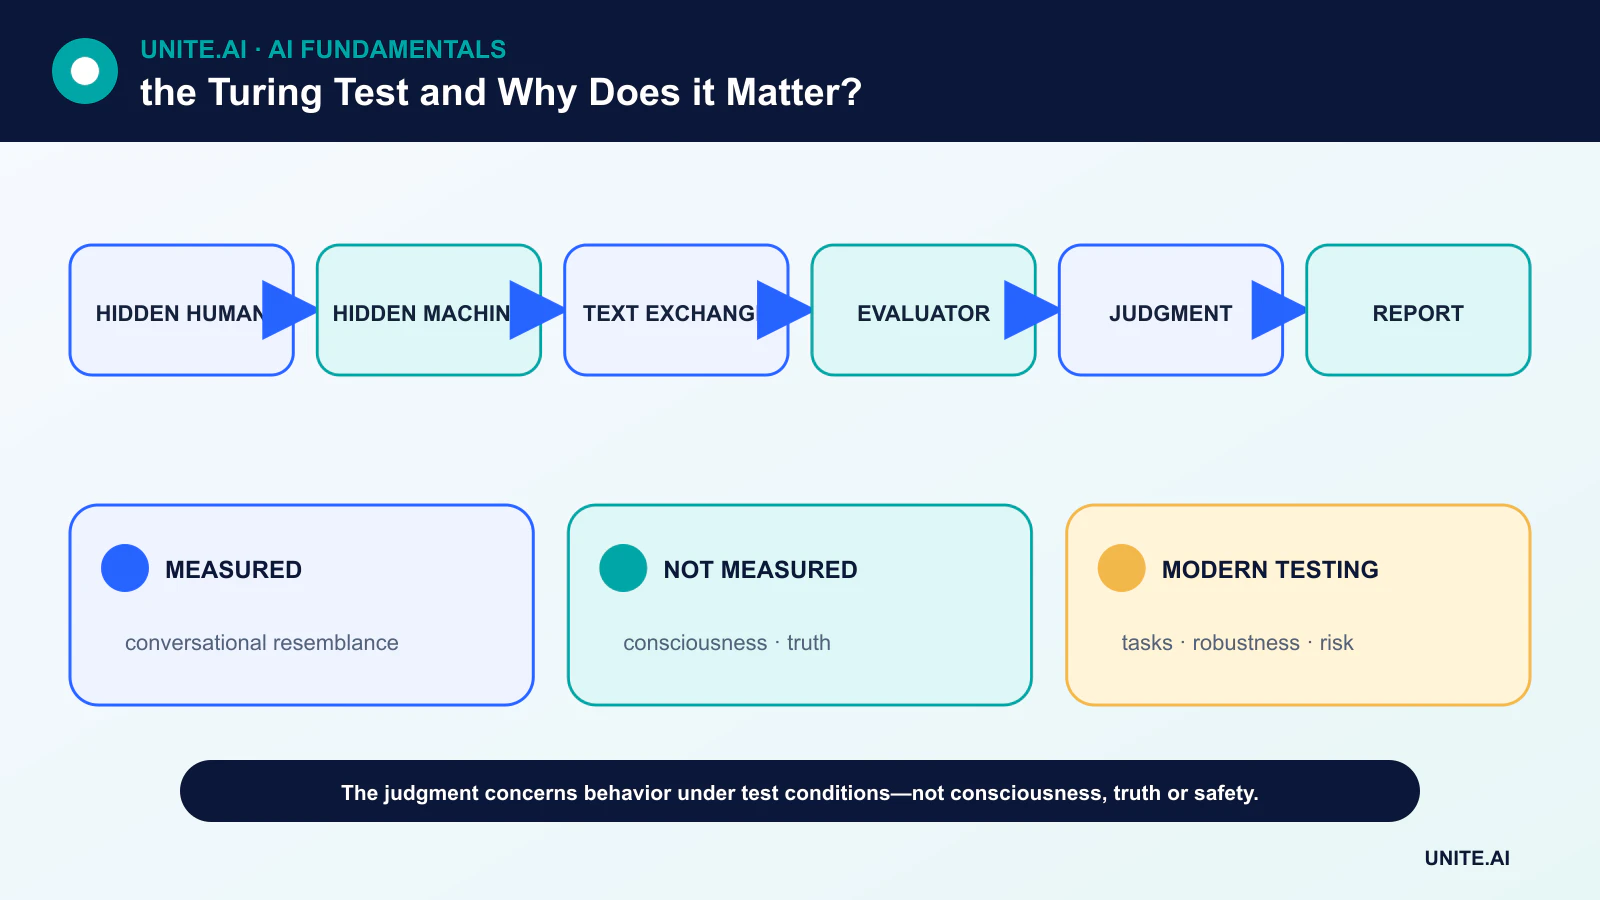
Turings Imitationsspiel
Im ursprünglichen Aufbau kommunizierte ein Prüfer aus der Ferne, sodass Stimme und Aussehen die Identität nicht preisgaben. Turing fragte, ob eine Maschine im Spiel gut genug performen könnte, dass ein Bewerter sie nicht zuverlässig von einer Person unterscheiden kann.
Diese operative Formulierung vermied die Notwendigkeit, eine einheitliche Definition von Denken festzulegen. Sie behauptete nicht, dass jeder überzeugende Austausch Intelligenz beweist, noch definierte sie eine universelle Bestehensgrenze, die für spätere Chatbot-Demonstrationen gilt.
Was ein Ergebnis tatsächlich misst
Ein Versuch misst die Verhaltensunterscheidbarkeit unter definierten Bedingungen. Kurze Gespräche, unerfahrene Juroren oder vom Systementwickler gewählte Prompts können die Aufgabe erleichtern. Ein rigoroser Bericht sollte die Auswahl der Transkripte, die Anzahl und den Hintergrund der Juroren, die Vergleichspersonen, das Zeitlimit und die statistische Methode offenlegen.
Ein System kann zudem Erwartungen ausnutzen: Ausweichverhalten, Humor, typografische Fehler und Rollenspiel können menschlich wirken, ohne zuverlässiges Schließen zu demonstrieren. Umgekehrt kann eine ungewöhnlich formelle menschliche Antwort fälschlich als maschinell erzeugt klassifiziert werden.
Was der Turing-Test nicht feststellt
Der Test misst nicht direkt Bewusstsein, subjektive Erfahrung, faktische Genauigkeit, kausales Verständnis oder moralisches Handeln. Er offenbart nicht die Trainingsdaten, die Modellarchitektur oder Fehlermodi außerhalb der Konversation. Außerdem sagt er wenig über nicht‑linguistische Intelligenz wie physische Manipulation aus.
Moderne Sprachsysteme basieren auf Transformer‑Neuronalen Netzen und Deep Learning, doch ihre flüssigen Ausgaben können weiterhin aus erlernten statistischen Strukturen erzeugt werden, anstatt aus einem verifizierten Weltmodell.
Wie moderne KI‑Bewertung die Frage erweitert
Zeitgenössische Bewertung nutzt zurückgehaltene Aufgabensätze, kalibrierte Unsicherheit, Robustheitstests, Red‑Teaming, Faktizitätsprüfungen und Studien zu menschlichen Präferenzen. Eine Text‑Klassifikations-Metrik kann ein definiertes Verhalten testen, während szenariobasierte Bewertung prüfen kann, ob ein System unter Druck Richtlinien folgt.
Kein einzelner Benchmark erfasst jede Einsatzsituation. Testkontamination kann Ergebnisse aufblähen, und statische Benchmarks fördern Overfitting. Bewertungen sollten wiederholt werden, wenn Modelle, Daten, Prompts, Werkzeuge und Nutzergruppen sich ändern.
Warum der Test weiterhin wichtig ist
Der Turing-Test antizipierte eine zentrale Lehre der KI‑Bewertung: beobachtbare Fähigkeiten zu beurteilen, anstatt sich auf Behauptungen über ein inneres Wesen zu stützen. Er zwingt uns zudem zu fragen, welche menschlichen Verhaltensweisen als Evidenz zählen und wie ein experimentelles Setup ein Ergebnis prägt.
Seine sinnvollste moderne Nutzung ist als historischer und konzeptioneller Ausgangspunkt. Ein Imitationsspiel zu bestehen kann interessant sein, doch Einsatzentscheidungen erfordern Evidenz, die mit der konkreten Aufgabe, den betroffenen Nutzern und vorhersehbaren Schäden verknüpft ist.
Was der Turing-Test misst
Alan Turings Imitationsspiel fragte, ob ein Prüfer, der über Text kommuniziert, zuverlässig eine Maschine von einer Person unterscheiden kann. Es stellte die abstrakte Debatte darüber, ob Maschinen denken, in ein beobachtbares Gesprächsexperiment um. Der Test hängt von Teilnehmenden, Dauer, Protokoll, Themen und Bewertungsregel ab; es gibt keine einheitliche universelle Punktzahl. Bestehen bedeutet, menschenähnliche Antworten unter diesem Aufbau zu erzeugen. Er misst nicht direkt faktische Genauigkeit, Schlussfolgerungsfähigkeit, Bewusstsein, Autonomie, Wahrnehmung, Verkörperung, Zuverlässigkeit oder nützliches Verhalten in der realen Welt.
Menschliche Imitation kann Ausweichverhalten, Rollen, Fehler, Humor oder Manipulation belohnen. Ein Juror kann einen Menschen für eine Maschine halten oder von Erwartungen, Sprache und kulturellem Kontext beeinflusst werden. Kurze Gespräche ermöglichen Tricks, die bei längerer Interaktion scheitern. Umgekehrt kann ein hochnützliches System für Mathematik, Übersetzung oder Proteinmodellierung scheitern, weil es nicht vorgibt, menschlich zu sein. Der Test misst daher eine soziale und sprachliche Fähigkeit, die vom Bewerter geformt wird, nicht eine vollständige Rangordnung der Intelligenz.
Moderne Sprachmodelle und strengere Bewertung
Große Sprachmodelle können flüssige Dialoge aufrechterhalten, indem sie Sequenzen aus umfangreichen Trainingsdaten vorhersagen und anschließend feinabgestimmt werden, doch Fluency ist ein schwaches Indiz für Wahrheit oder Verständnis. Ausgelernte Muster, Werkzeugzugriff, versteckte Prompts, Latenz und Sampling‑Einstellungen beeinflussen die Ergebnisse. Kontrollierte Bewertungen sollten Modell und Protokoll offenlegen, Informationslecks verhindern, adversarielle und domänenspezifische Fragen einbeziehen und Unsicherheit sowie Quellenangaben bewerten. Eine aus erfolgreichen Unterhaltungen ausgewählte Demonstration kann die Zuverlässigkeit über die gesamte Nutzung nicht abschätzen.
Moderne Bewertung ist multidimensional: Aufgabengenauigkeit, Kalibrierung, Robustheit, Langzeit‑Konsistenz, Sicherheit, Verzerrungen, Datenschutz, Sicherheit, Effizienz und menschliche Ergebnisse. Verhaltenstests sollten durch Prozessevidenz, Red‑Teaming, reproduzierbare Benchmarks und Monitoring in der realen Welt ergänzt werden. Benchmarks können gesättigt sein oder in Trainingsdaten auftauchen, daher werden private und aktualisierte Testsets benötigt. Für agierende Systeme sollten Werkzeugberechtigungen, Wiederherstellung und Konsequenzen separat von der Gesprächsqualität bewertet werden.
Warum der Test weiterhin wichtig ist
Der Turing-Test bleibt historisch bedeutsam, weil er das Verhalten in den Mittelpunkt stellt und die Schwierigkeit, Intelligenz zu definieren, aufzeigt. Er wirft zudem fortlaufende Fragen zu Anthropomorphismus und Täuschung auf. Schnittstellen sollten synthetische Agenten identifizieren, anstatt falsche Identität als Erfolg zu werten, besonders in kritischen Kontexten. Nutzen Sie den Test als philosophisches Prisma und als eine Gesprächsbewertung, nicht als Zertifizierung allgemeiner Intelligenz oder Personenstatus. Die zentrale Frage beim Einsatz ist, was das System zuverlässig leisten kann, unter welchen Evidenzen und Grenzen, und wer verantwortlich ist, wenn es versagt.
Praktisches Beispiel: eine kontrollierte konversationelle Bewertung
Bewertende vergleichen Menschen und mehrere KI‑Systeme in Textgesprächen mit fester Dauer, Themen, Sprache und anonymisierten Identitäten. Juroren notieren, ob sie jeden Teilnehmenden für menschlich halten, und bewerten zudem Faktizität, Konsistenz, Nützlichkeit, Unsicherheit und Manipulation. Mehrere Juroren und Unterhaltungen schätzen die Variation, und das Protokoll verhindert, dass Modellentwickler günstige Transkripte auswählen. Menschliche Fehlklassifizierung liefert eine notwendige Basis für die Interpretation des Ergebnisses.
Ein System, das Juroren täuscht, aber Fakten erfindet, wird nicht als allgemein intelligent eingestuft, während ein klar offengelegtes Spezialistenmodell trotz Fehlversuchs der Imitation sehr nützlich sein kann. Die Ergebnisse umfassen Prompt, Modell, Sampler, Werkzeugzugriff und Juroren‑Merkmale. Das Experiment wird als ein Test menschlicher Konversation dargestellt. Einsatzentscheidungen nutzen separate Evidenz für Aufgabenkorrektheit, Sicherheit, Datenschutz und Wiederherstellung, und die Schnittstelle identifiziert den Agenten, anstatt Täuschung zum Produktziel zu machen.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und ein versioniertes Evaluationsset vor dem Feintuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, sodass ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung festgelegt werden. Nutzen Sie eine gestufte Einführung, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingebrachten Fehlern. Operative Telemetrie sollte die Eingabequalität, das Ausgabeverhalten, Modell‑ oder Regelversion, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenbaren, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellenwerte und einen Verantwortlichen für die Reaktion, und prüfen Sie dann Evidenz aus der realen Welt nach dem Einsatz, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellung, Lernprozesse aus Vorfällen, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Zeitpunkt, zu dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Hat irgendeine KI den Turing-Test eindeutig bestanden?
Es gibt keine einzige offizielle Testbehörde oder allgemein anerkanntes Protokoll. Öffentliche Demonstrationen verwenden unterschiedliche Regeln, sodass „bestanden“-Behauptungen nicht direkt vergleichbar sind.
Beweist ein Nicht‑Bestehen des Tests, dass ein System unintelligent ist?
Nein. Ein spezialisiertes System kann hochfähig sein, ohne einen menschlichen Gesprächsstil zu imitieren.
Primärreferenzen












