Grundlagen der KI
Was ist agentische KI? Wie Systeme planen, Werkzeuge nutzen und Aufgaben erledigen
Agentische KI-Systeme tun mehr, als nur eine Antwort zu generieren: Sie verfolgen Ziele durch einen Loop aus Planung, Werkzeug‑Einsatz, Beobachtung und Anpassung. So funktioniert dieser Loop, wo Agenten Mehrwert schaffen und was sie unter Kontrolle hält.

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
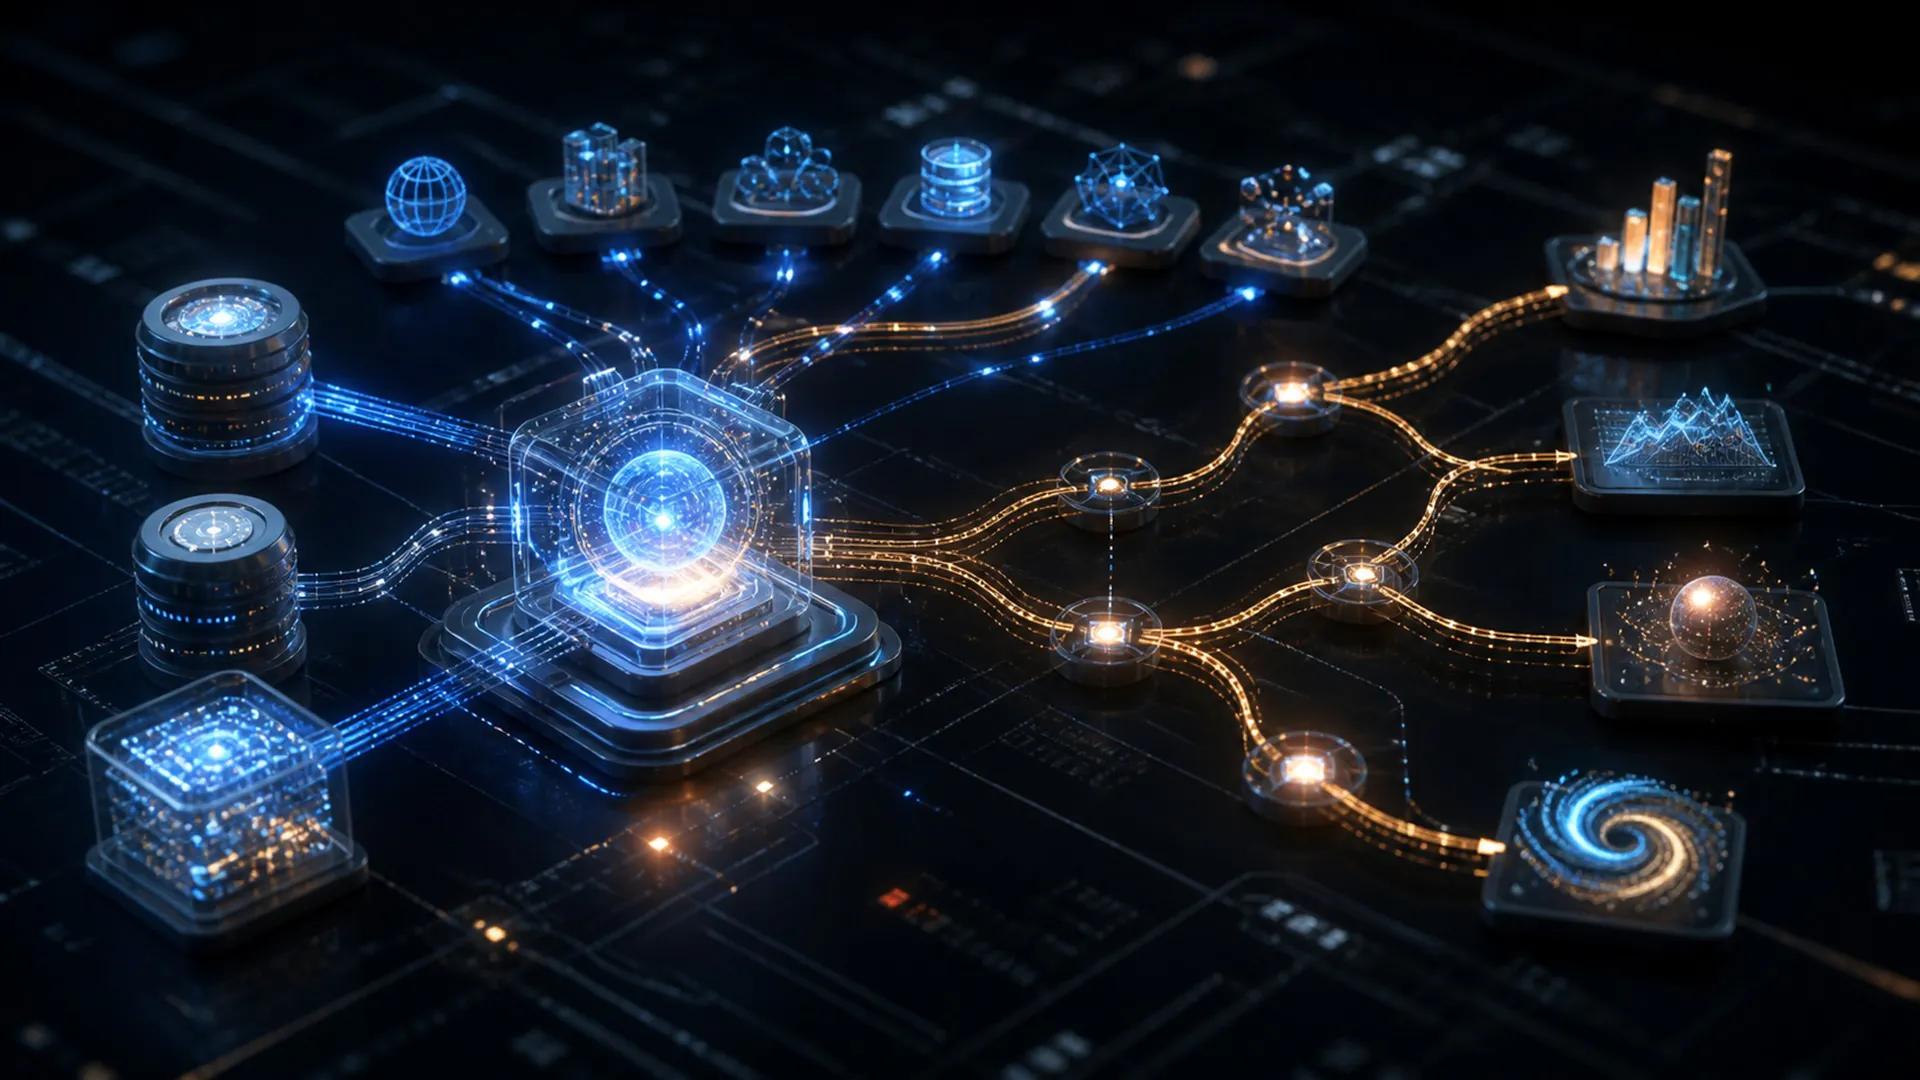
Agentische KI ist künstliche Intelligenz, die ein Ziel verfolgen kann, indem sie entscheidet, was als Nächstes zu tun ist, Werkzeuge einsetzt, das Ergebnis beobachtet und ihren Ansatz anpasst. Anstatt eine einzige Antwort zu erzeugen und zu stoppen, arbeitet ein Agent in einer Steuerungsschleife, bis er die Aufgabe erledigt, ein Limit erreicht oder die Arbeit an eine Person zurückgibt.
Diese Unterscheidung ist wichtig, weil die einflussreichsten KI‑Systeme über die reine Konversation hinausgehen. Sie können Quellen durchsuchen, Datenbanken abfragen, Code ausführen, Software bedienen, Geschäftssysteme aktualisieren und andere Agenten koordinieren. Größere Autonomie kann nützlichere Arbeit ermöglichen, erhöht aber zugleich die Bedeutung von Zuverlässigkeit, Berechtigungen, Überwachung und menschlicher Kontrolle.
Was macht ein KI‑System agentisch?
Es gibt keinen einzelnen Schwellenwert, der ein Modell zu einem Agenten macht. Agentur liegt auf einem Kontinuum. Am einen Ende beantwortet ein Sprachmodell eine Eingabe. Am anderen Ende erhält ein System ein breites Ziel, zerlegt es in Schritte, wählt Werkzeuge, reagiert auf neue Informationen und arbeitet über einen längeren Zeitraum hinweg.
Autonomie ist ebenfalls mehrdimensional. Ein Agent kann eigene Recherche‑Abfragen wählen, aber nichts veröffentlichen; ein anderer folgt einem festen Plan, hat aber die Berechtigung, ein Produktionssystem zu ändern. Die Bewertung, „wie agentisch“ ein System ist, erfordert daher eine getrennte Betrachtung von Planungsfreiheit, Werkzeugzugriff, Betriebsdauer, Umkehrbarkeit und den Folgen eines Fehlers.
Ein nützlicher Test ist die Frage, wer den Pfad bestimmt. In einem herkömmlichen Workflow definiert ein Entwickler die Reihenfolge im Voraus: Schritt A, dann B, dann C. In einem agentischen System hat das Modell ein gewisses Ermessen, welche Schritte nötig sind und in welcher Reihenfolge. Anthropics Leitfaden zum Aufbau effektiver Agenten zieht dieselbe praktische Unterscheidung zwischen vordefinierten Code‑Pfade‑Workflows und Agenten, die ihren Prozess und Werkzeuggebrauch dynamisch steuern.
Die meisten produktiven Agenten kombinieren fünf Elemente:
- Ein Modell: die Reasoning‑ und Sprach‑Engine, die das Ziel interpretiert und Aktionen wählt.
- Instruktionen: die Systemregeln, Aufgabenbeschreibung, Richtlinien und Erfolgskriterien.
- Werkzeuge: Funktionen, die dem Agenten das Suchen, Berechnen, Abrufen von Daten, Schreiben von Dateien, Aufrufen von APIs oder Bedienen von Schnittstellen ermöglichen.
- Zustand oder Speicher: die Informationen, die von einem Schritt zum nächsten (und manchmal über Sitzungen hinweg) getragen werden.
- Eine Steuerungsschleife: die Laufzeit, die Ergebnisse an das Modell zurückgibt und entscheidet, ob weitergemacht, erneut versucht, um Hilfe gebeten oder gestoppt wird.
Der Agenten‑Loop: Planen, Handeln, Beobachten und Anpassen
Obwohl Implementierungen variieren, folgt ein Agent typischerweise einem wiederkehrenden Vier‑Stufen‑Muster.
| Definition | Ein System, das ein Ziel interpretiert, Aktionen auswählt, Werkzeuge nutzt und aus den Ergebnissen lernt. |
|---|---|
| Informationsfluss | Ziel → Plan → Aktion → Beobachtung → überarbeitete Aktion oder Stopp. |
| Beweis | Ein Trace zeigt, warum jede Aktion gewählt wurde und ob sie das Ziel vorangebracht hat. |
| Fehler | Der Agent handelt weiter, obwohl Evidenz, Autorität oder Budget erschöpft sind. |
1. Ziel interpretieren
Der Agent ermittelt das gewünschte Ergebnis, relevante Einschränkungen und fehlende Informationen. Eine klare Aufgabenbeschreibung enthält nicht nur das „Was zu tun ist“, sondern auch das Kriterium für die Vollständigkeit. „Recherchiere dieses Unternehmen“ ist mehrdeutig; „Erstelle einen zitierten Vergleich der letzten drei Jahresberichte und markiere wesentliche Änderungen“ definiert ein prüfbares Ziel.
2. Aktion wählen
Das Modell kann direkt antworten, einen Plan erstellen, ein Werkzeug aufrufen, eine Teilaufgabe delegieren oder um Klarstellung bitten. Die Aktion wird meist in einem strukturierten Format ausgedrückt, damit die Software sie vor der Ausführung validieren kann. Hier wandelt das Agent‑Design die probabilistische Modellausgabe in eine kontrollierte Systemoperation um.
3. Ergebnis beobachten
Die Laufzeit liefert die Werkzeugausgabe, einen Fehler, eine geänderte Schnittstelle oder anderes Umgebungs‑Feedback. Der Agent fügt diese Beobachtung seinem Arbeitskontext hinzu. Gibt eine Suche schwache Evidenz zurück oder lehnt eine API einen Parameter ab, sollte die nächste Entscheidung diesen neuen Zustand berücksichtigen.
4. Anpassen oder stoppen
Der Agent bewertet den Fortschritt und wählt eine weitere Aktion. Er kann den Plan überarbeiten, ein anderes Werkzeug probieren, ein Ergebnis verifizieren oder feststellen, dass das Ziel erreicht ist. OpenAI beschreibt diese Interaktion als Schleife zwischen Modell, Werkzeugen und Umgebung in seiner Diskussion über den Übergang vom Modell zum Agenten.
Dieses Muster steht im Zusammenhang mit dem ReAct‑Ansatz, der Reasoning und Aktionen abwechselt, sodass externe Beobachtungen das nachfolgende Denken aktualisieren können. Das ursprüngliche ReAct‑Paper half, das Design als Alternative zu einem vollständigen Plan ohne Umwelt‑Feedback zu etablieren.
Agentische KI vs. generative KI
Generative KI beschreibt Systeme, die neue Inhalte erzeugen, etwa Text, Bilder, Audio, Video oder Code. Agentische KI beschreibt, wie ein System ein Ziel verfolgt. Die Kategorien überschneiden sich, sind aber nicht austauschbar.
Ein generatives Modell kann eine E‑Mail entwerfen, ohne ein Agent zu sein. Ein Agent kann ein generatives Modell nutzen, um die E‑Mail zu verfassen, den richtigen Empfänger zu ermitteln, Richtlinien zu prüfen, einen Anhang zu erstellen und die Nachricht in eine Prüf‑Warteschlange zu stellen. Das Modell liefert die Intelligenz; das umgebende Agentensystem liefert Werkzeuge, Zustand, Orchestrierung und Kontrollen.
Wo agentische Systeme nützlich sind
Agenten sind am wertvollsten, wenn der Weg zu einem Ziel nicht vollständig im Voraus spezifiziert werden kann, der Fortschritt jedoch beobachtet und geprüft werden kann. Häufige Anwendungsfälle sind:
- Recherche: mehrere Quellen durchsuchen, Lücken schließen, Evidenz vergleichen und einen zitierten Bericht zusammenstellen.
- Software‑Engineering: ein Repository navigieren, Code editieren, Tests ausführen, Fehler interpretieren und iterieren.
- Kunden‑Operationen: Kontokontext sammeln, Richtlinien anwenden, eine Lösung vorschlagen und Ausnahmen eskalieren.
- Datenanalyse: Datensätze auswählen, Abfragen schreiben, Anomalien prüfen, Visualisierungen erzeugen und Befunde erklären.
- IT‑Operationen: Alarme untersuchen, Diagnosen sammeln, Gegenmaßnahmen empfehlen und genehmigte Runbooks ausführen.
- Administrative Arbeit: Kalender, Dokumente, Formulare, Genehmigungen und Updates über Systeme hinweg koordinieren.
Ein fester Workflow ist oft besser, wenn der Prozess stabil ist und jeder Schritt bekannt ist. Einen Agenten dort hinzuzufügen, wo gewöhnliche Automatisierung ausreicht, kann Kosten und Variabilität erhöhen, ohne echten Mehrwert zu schaffen.
Wann sollte man einen Agenten statt Automatisierung einsetzen?
Die optimale Architektur hängt von zwei Fragen ab: Wie vorhersehbar ist der Pfad und wie kostspielig ist eine falsche Aktion? Ein System wird nicht automatisch fortschrittlicher, nur weil es einem Modell mehr Freiheit gibt. In vielen hochriskanten Szenarien kombiniert das stärkste Design bewusst deterministische Software mit einer engen agentischen Komponente.
Ein nützlicher Kompromiss ist begrenzte Agentur. Der Agent kann entscheiden, wie Informationen gesammelt, welches genehmigte Werkzeug aufgerufen oder ein Entwurf überarbeitet wird, während deterministischer Code Schemata, Zugriffsregeln, Budgets und finale Genehmigungen durchsetzt. Das bewahrt Anpassungsfähigkeit, ohne ein probabilistisches Modell seine eigene Autorität polizieren zu lassen.
Warum agentische KI schwierig ist
Ein Agent kann eine lokal plausible Entscheidung treffen, die die Gesamtaufgabe in die falsche Richtung führt. Kleine Fehler können sich über eine lange Trajektorie hinweg summieren, während eine überzeugende Endantwort einen falschen oder unsicheren Prozess verbergen kann.
Dieser kumulative Effekt ist ein Grund, warum die Bewertung von Agenten sich von der herkömmlichen Antwortbewertung unterscheidet. Eine fehlgeschlagene Aufgabe kann im Plan des Modells, einem irreführenden Werkzeug‑Ergebnis, einem falschen Zustands‑Update, einer zu frühen Stopp‑Entscheidung oder einer unsicheren Berechtigungsgrenze liegen. Umgekehrt kann eine korrekte Endantwort das Produkt eines fragilen Pfades sein, der beim nächsten Durchlauf scheitern würde. Teams benötigen daher sowohl Ergebnis‑Metriken als auch Evidenz auf Trajektorien‑Ebene.
Die größten Herausforderungen sind:
- Zuverlässigkeit: dieselbe Aufgabe kann bei wiederholten Durchläufen unterschiedliche Pfade und Ergebnisse erzeugen.
- Verankerung: das Modell kann Werkzeugausgaben, Schnittstellen‑Zustände oder die tatsächliche Nutzerintention missverstehen.
- Berechtigungen: ein nützlicher Agent benötigt sinnvollen Zugriff, doch breiter Zugriff vergrößert die Folgen eines Fehlers.
- Prompt‑Injection: unzuverlässiger Inhalt kann Anweisungen enthalten, die den Agenten umleiten oder Daten preisgeben.
- Kosten und Latenz: jeder zusätzliche Modellaufruf, Werkzeug‑Aufruf, Verifikationsschritt oder Sub‑Agent erhöht Ressourcenverbrauch und Zeit.
- Bewertung: die alleinige Beurteilung des Endergebnisses kann fragiles Denken, Richtlinienverstöße oder Glückserfolge übersehen.
Wie man einen KI‑Agenten unter Kontrolle hält
Sichere Autonomie ist gestaltet, nicht angenommen. Der Agent sollte nur die minimalen Werkzeuge und Daten erhalten, die für die Aufgabe nötig sind. Hoch‑impact‑Aktionen – wie das Senden einer Nachricht, das Bewegen von Geld, das Löschen von Daten oder das Ändern von Produktionssystemen – sollten explizite Genehmigung oder eine streng begrenzte Richtlinie erfordern.
Starke Systeme trennen zudem Planung von Ausführung. Werkzeug‑Argumente können gegen Schemata validiert werden; Aktionen können in Sandboxes laufen; sensible Vorgänge können auf einer Allow‑List stehen; und Ausgaben können geprüft werden, bevor sie als Eingaben in ein anderes System fließen. Zeit‑, Token‑ und Aktions‑Budgets verhindern, dass ein verwirrter Agent unendlich schleift.
Beobachtbarkeit ist ebenso wichtig. Teams benötigen ein Protokoll der Instruktionen, Werkzeug‑Aufrufe, Zwischenergebnisse, Genehmigungen, Fehler und des Endergebnisses. Diese Trajektorie ermöglicht Debugging und Bewertung. Anthropics Arbeit zu vertrauenswürdigen Agenten in der Praxis betont klare Autoritätsgrenzen und sinnvolle menschliche Kontrolle als Kernanforderungen.
Umkehrbarkeit sollte diese Kontrollen prägen. Das Lesen einer öffentlichen Webseite ist leicht rückgängig zu machen, weil nichts geändert wird; das Ausstellen einer Rückerstattung, das E‑Mailen eines Kunden oder das Löschen einer Cloud‑Ressource ist das nicht. Ein ausgereiftes Agentensystem klassifiziert Aktionen nach Konsequenz, verlangt stärkere Autorisierung für schwer umkehrbare Vorgänge und gibt der Laufzeit – nicht dem Modell – das letzte Wort darüber, ob die Ausführung erlaubt ist.
Was agentische KI nicht bedeutet
„Agentisch“ bedeutet nicht bewusst, selbst‑wahrnehmend oder eigenständig motiviert. Die scheinbare Initiative des Systems stammt von einem Modell, das in Software eingebettet ist und wiederholt aufgefordert wird, den nächsten Schritt zu wählen. Ziele, Werkzeuge, Berechtigungen, Stopp‑Bedingungen und Umgebung werden von Menschen entworfen.
Es garantiert auch nicht allgemeine Intelligenz. Ein Agent kann in einer engen Umgebung hochfähig sein und dabei spröde werden, wenn Schnittstelle, Daten oder Aufgabe sich ändern. Autonomie sollte daher an nachgewiesener Leistung ausgerichtet sein, nicht daran, wie flüssig das Modell klingt.
Was man über agentische KI wissen sollte
Agentische KI verwandelt ein Modell von einem reinen Antwort‑Generator in eine Komponente eines zielgerichteten Systems. Das entscheidende Merkmal ist nicht ein bestimmtes Modell oder Protokoll; es ist die geschlossene Schleife, in der das System Aktionen wählt, Werkzeuge nutzt, beobachtet, was passiert, und sich anpasst.
Die effektivsten Agenten verbinden diese Flexibilität mit engem Umfang, minimalen Rechten, sichtbaren Trajektorien, rigoroser Bewertung und menschlicher Kontrolle an kritischen Stellen. Die zentrale Frage lautet nicht mehr nur: „Kann das Modell die richtige Antwort liefern?“ – sondern auch: „Kann das gesamte System das richtige Ergebnis durch einen Prozess erreichen, dem wir vertrauen können?“