
Grundlagen der KI
Generative vs. diskriminative Modelle des maschinellen Lernens

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Generativ und diskriminativ beschreiben, was ein Modell über Daten und Zielvariablen lernt. Bei klassischer überwachter Klassifikation lernt ein generatives Modell eine gemeinsame Verteilung wie P(x, y) oder eine klassenbedingte Verteilung P(x|y), während ein diskriminatives Modell P(y|x) oder eine direkte Entscheidungsgrenze lernt.
Der Unterschied ist nützlich, doch moderne Systeme kombinieren häufig Ziele. Ein Modell kann generative Repräsentationen erlernen und später für diskriminative Vorhersagen feinabgestimmt werden, oder ein gemeinsames Backbone für Generierung und Klassifikation nutzen.
Wesentliche Erkenntnisse
- Generative Klassifikatoren modellieren, wie Eingaben und Labels entstehen; diskriminative Klassifikatoren modellieren das Label gegeben der Eingabe oder eine Grenze.
- Generative Annahmen können bei begrenzten gelabelten Daten helfen, können aber auch falsch sein.
- Diskriminative Methoden konzentrieren die Kapazität häufig auf die Vorhersageaufgabe und können einen geringeren asymptotischen Klassifikationsfehler erreichen.
- GANs, VAEs und Sprachmodelle sind generative Systeme, aber „generativ“ bedeutet nicht, dass jede Komponente ein generativer Klassifikator ist.
Die Wahrscheinlichkeitsfaktorisierung
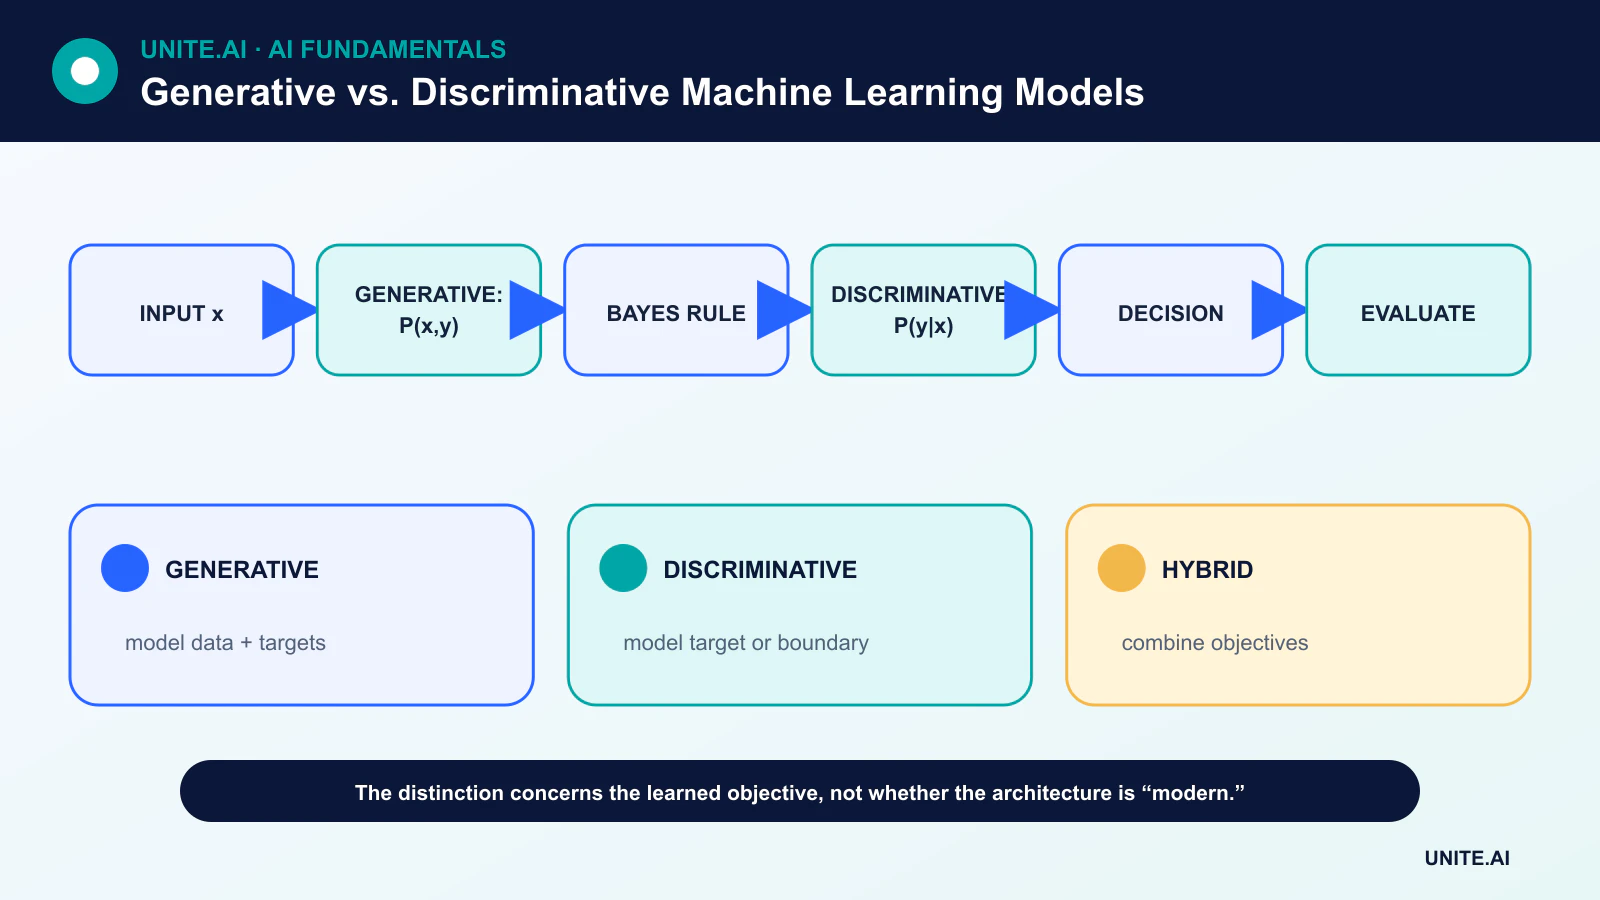
Ein generativer Klassifikator kann P(x|y) und P(y) schätzen und dann den Satz von Bayes nutzen, um P(y|x) abzuleiten. Naiver Bayes ist ein klassisches Beispiel. Ein diskriminativer Klassifikator wie die logistische Regression schätzt P(y|x) direkt; ein SVM lernt eine trennende Grenze.
Das Modellieren von P(x,y) ist eine umfassendere Aufgabe als das Vorhersagen von y aus x. Diese zusätzliche Struktur kann das Sampling oder das Schließen bei fehlenden Daten unterstützen, erfordert jedoch Annahmen über die Eingabeverteilung.
Dateneffizienz und asymptotisches Verhalten
Der Vergleich von Ng und Jordan zwischen Naivem Bayes und logistischer Regression zeigte einen nützlichen Kompromiss: unter ihren Annahmen kann das generative Modell mit weniger Beispielen seine Grenzleistung erreichen, während das diskriminative Modell einen geringeren asymptotischen Fehler erzielen kann.
Dies ist kein universelles Ranking. Die Ergebnisse hängen davon ab, ob die Modellfamilie zu den Daten passt, von der Dimensionalität, Regularisierung, Optimierung und der Qualität der Labels. Ein empirischer Vergleich anhand eines repräsentativen Validierungsdesigns bleibt unverzichtbar.
Repräsentative Modellfamilien
Generative Modelle umfassen klassenbedingte Verteilungen, versteckte Markov-Modelle, Mischmodelle, Variationale Autoencoder, autoregressive Sprachmodelle, Diffusionsmodelle und GANs.
Diskriminative Modelle umfassen logistische Regression, Entscheidungsbäume, bedingte Random Fields, Support‑Vector‑Machines und neuronale Klassifikatoren. Das gleiche neuronale Backbone kann je nach Trainingsziel und Ausgabe in beiden Kategorien eingesetzt werden.
Hybride und selbstüberwachte Systeme
Ein vortrainiertes Sprach‑ oder Vision‑Modell kann aus unlabeled Daten mit einem generativen oder selbstüberwachten Ziel lernen und anschließend einen diskriminativen Kopf für eine Zielaufgabe erhalten. Halbüberwachte Methoden können gleichzeitig die gelabelte Klassifikation und ein Ziel für unlabeled Daten optimieren.
Hybridisierung macht Architektur‑Labels weniger aussagekräftig als die gesamte Trainingspipeline. Die Dokumentation sollte das Ziel, die Daten, die Ausgaben und die beabsichtigte Inferenz angeben – nicht einfach ein Modell als generativ bezeichnen.
Auswahl zwischen Ansätzen
Lassen Sie die Aufgabe die Entscheidung treffen. Wenn das Ziel eine kalibrierte Grenze mit vielen Labels ist, ist ein diskriminatives Modell ein natürlicher Ausgangspunkt. Wenn Sampling, Dichteschätzung, fehlende Datenstrukturen oder unlabeled Daten zentral sind, kann eine generative Komponente helfen.
Vergleichen Sie Robustheit, Stichprobeneffizienz, Rechenaufwand, Likelihood oder Kalibrierung, je nach Bedarf. Ein gutes generiertes Sample beweist keinen guten Klassifikator, und ein hochgenauer Klassifikator impliziert kein realistisches Modell der Eingabeverteilung.
Richtungen der Wahrscheinlichkeit und Modellierungsziele
Ein diskriminatives Modell lernt eine Grenze oder eine bedingte Verteilung P(y|x): Gegeben Merkmale x, Vorhersage des Labels y. Logistische Regression, Support‑Vector‑Machines, bedingte Random Fields und viele Klassifikatoren sind diskriminativ. Ein generatives Modell lernt eine gemeinsame Verteilung P(x,y), eine klassenbedingte Verteilung P(x|y) oder eine unbedingte Datenverteilung, was Sampling oder likelihood‑bezogene Aufgaben ermöglicht. Naiver Bayes und lineare Diskriminanzanalyse sind generative Klassifikatoren; GANs, Variationale Autoencoder, Diffusionsmodelle und autoregressive Modelle erzeugen Daten durch unterschiedliche Ziele.
Der Unterschied bezieht sich darauf, welche Verteilung oder Entscheidungsregel modelliert wird, nicht darauf, ob ein neuronales Netzwerk verwendet wird. Ein generatives Sprachmodell kann zur Klassifikation aufgefordert werden, während ein diskriminativer Re‑Ranker die Generierung steuern kann. Generative Annahmen können die Dateneffizienz verbessern oder fehlende Variablen handhaben, bergen jedoch das Risiko einer Modellfehlanpassung. Diskriminative Methoden glänzen oft bei reichlich gelabelten Daten, weil sie sich direkt auf die Vorhersagegrenze konzentrieren. Vergleichen Sie die Familien bei gleichen Merkmalen, Daten, Tuning und Rechenaufwand, anstatt eine Kategorie als universell überlegen zu betrachten.
Training und Bewertung nach Anwendungsfall
Die Bewertung von Klassifikationen verwendet Präzision, Recall, Kalibrierung, Robustheit und Fehlkosten. Die Bewertung generativer Modelle muss Treue, Vielfalt, Abdeckung, Likelihood oder Aufgabennutzen, Memorierung und Sicherheit berücksichtigen. Ein Modell kann attraktive Samples erzeugen, dabei jedoch Modi verlieren, oder eine gute Likelihood bei schlechter perceptualer Ausgabe erzielen. Der Nutzen synthetischer Daten sollte durch das Training und die Bewertung nachgelagerter Modelle auf unabhängigen realen Daten, einschließlich seltener Gruppen, getestet werden. Halten Sie Testdaten aus Generierungs‑Prompts und -Auswahl heraus.
Im halbüberwachten Lernen kann ein generatives Modell unlabeled Strukturen ausnutzen; in der Anomalieerkennung kann die Likelihood versagen, wenn Out‑of‑Distribution‑Daten aus irrelevanten Gründen eine hohe Dichte erhalten. Bei Retrieval‑erweiterter Generierung bilden ein generatives Antwortmodell und ein diskriminativer Retriever bzw. Re‑Ranker ein Hybrid. Diagnostizieren Sie die Phasen getrennt, damit flüssige Ausgaben Retrieval‑Fehler nicht verbergen. Wählen Sie die Zerlegung, die Evidenz und Kontrolle sichtbar macht.
Bereitstellung und Governance
Generative Systeme bringen Risiken hinsichtlich Herkunft von Inhalten, geistigem Eigentum, Identitätsmissbrauch, Prompt‑Injection und Output‑Moderation mit sich; diskriminative Systeme fügen Risiken bezüglich Schwellenwerten, Ablehnung und ungleichen Fehlerraten hinzu. Beide benötigen Datenrechte, gesicherte Artefakte, Versionierung, repräsentative Tests, Monitoring und eine menschliche Autorität, die dem Konsequenzgrad entspricht. Dokumentieren Sie das genaue Ziel und die Semantik der Ausgabe. Generativ vs. diskriminativ ist eine nützliche statistische Unterscheidung, doch reale Systeme kombinieren sie häufig, und die Zuverlässigkeit hängt von der gesamten Daten‑ und Entscheidungspipeline ab.
Praktisches Beispiel: Klassifizierung und Generierung von Support‑Antworten
Eine Support‑Plattform nutzt einen diskriminativen Klassifikator, um den Problemtyp und die Dringlichkeit zu identifizieren, und ein generatives Modell, um anhand genehmigter Richtlinien eine Antwort zu entwerfen. Der Klassifikator wird mit klassenspezifischem Recall und Kalibrierung bewertet; der Retriever mit Evidenz‑Recall; der Generator mit Fundiertheit, Korrektheit und Verweigerung. Jede Stufe hat ein unbekanntes Ergebnis, und das generative Modell kann die Klassifikation oder das Kundenanspruchsrecht nicht durch überzeugenden Text verändern.
Agenten sehen die vorhergesagte Route, Quellen und den Entwurf und können diesen vor dem Versand genehmigen oder korrigieren. Berechtigung‑Filter werden vor dem Retrieval angewendet, und Prompt‑Injection im Kundentext kann keine Werkzeuge autorisieren. Das Monitoring trennt Routing‑Fehler, Retrieval‑Lücken, nicht unterstützte Aussagen und Agenten‑Edits. Eine Richtlinienänderung aktualisiert die Quellen sofort und löst Regressionstests aus; das Tuning ist für stabiles Verhalten reserviert. Das hybride Design nutzt die Stärken von diskriminativen und generativen Ansätzen, während Evidenz und menschliche Autorität erhalten bleiben.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluationsdatensatz vor dem Tuning. Testen Sie normale Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfälle von Abhängigkeiten, Missbrauch sowie die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt sind. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Start sollten Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollbacks und Stilllegung festgelegt werden. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingespielten Fehlfunktionen. Operative Telemetrie sollte die Eingabequalität, das Ausgabe‑Verhalten, Modell‑ oder Regel‑Version, den Zustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie anschließend reale Evidenz nach dem Deployment, anstatt anzunehmen, dass die Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist der Diskriminator eines GAN ein diskriminatives Modell?
Es führt während des Trainings Diskriminierung durch, aber das gesamte GAN ist ein generatives Framework, dessen Ausgabe vom Generator erzeugt wird.
Ist diskriminatives Lernen immer überwacht?
Nein. Der Begriff beschreibt die modellierte Beziehung oder Grenze, während Supervision das Trainingssignal bezeichnet. Moderne Ziele können die Kategorien verwischen.
Primärreferenzen












