
访谈
法比安娜·克莱门特,YData联合创始人兼首席数据官 – 采访系列

 将 Unite.AI 添加到您在 Google 上的首选来源
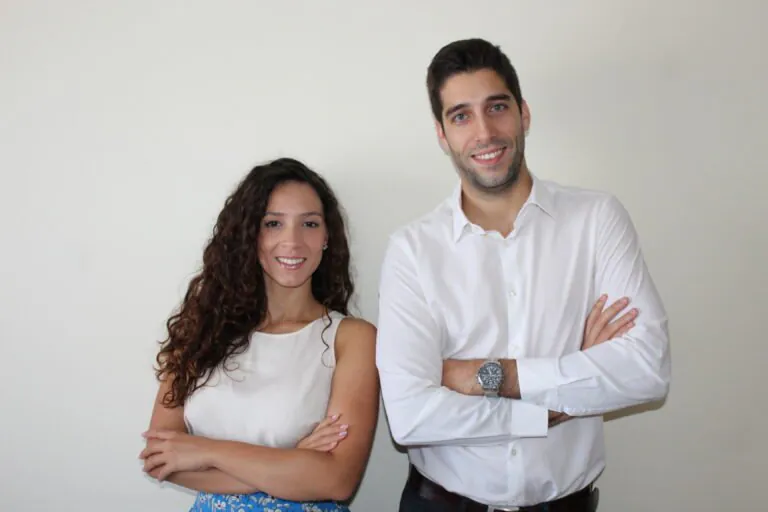
法比安娜·克莱门特是YData的联合创始人兼首席数据官。YData是一家人工智能初创公司,创建了第一个数据中心开发解决方案,将数据发现、改进和扩展结合在一个平台上。
最初是什么吸引你进入人工智能和机器学习领域?
我的背景是应用数学,我有机会学习和了解如何从数据中提取信息,并使用代码进行处理。当时,机器学习还不如现在这么流行,但它确实激发了我对这个领域的热情。
你能分享一下YData的创立故事吗?
作为一名曾在初创公司和企业工作过的数据科学家,我经历过很多困难——有时由于安全或隐私原因,无法访问数据;有时虽然可以访问数据,但数据质量不够好,无法用于构建基于人工智能的解决方案。知道这些困难在大多数组织中很常见,这激发了我们创立公司的想法,目标是帮助这些团队克服这些障碍,通过改进数据来加速人工智能开发。
你能为我们的读者描述一下什么是合成数据吗?
合成数据是指任何不在现实世界中生成的数据,因此,任何人工创建的数据都可以被认为是合成数据。有方法可以生成合成数据,从基于规则的策略到使用机器或深度学习模型来学习这些“规则”。在YData,我们采用并专门从事基于深度学习的策略来生成新的数据,这些数据保留了来自真实世界事件的行为,而不必担心隐私问题。
什么使得合成数据如此重要?
随着组织越来越意识到数据对于提升业务的重要性,合成数据的重要性和作用将会被更好地理解。收集真实数据不仅耗时且昂贵,有时甚至是不可能的。要构建人工智能应用程序,数据是一个硬性要求——这就是合成数据的作用。能够生成未见过的场景或简单地解锁数据访问对于在一个数据中心的世界中进步至关重要,就像安德鲁·恩格尔(Andrew Ng)等先驱者所说的,要想成功采用人工智能,成为数据中心是关键。
在自动驾驶汽车或其他机械自动化活动中,我们已经可以感受到合成数据的重要性,所以我认为这种理解会自然而然地扩展到所有行业垂直领域。
YData如何生成合成数据?
YData主要利用深度生成模型来学习原始数据中变量之间的统计属性和相关性。这使得模型能够生成一个在统计上相关的数据集,这个数据集具有与原始数据相同的商业价值,而不允许追踪到原始记录。
YData正在推动这项技术的发展,并是合成数据社区背后的公司——合成数据社区是一个由数据科学专家组成的团体,致力于传播和帮助任何想要学习和使用这项技术的人。
YData平台如何帮助发现和解锁新的数据源?
YData的平台包括内置连接器,可以连接到任何类型的数据库、数据仓库或数据湖,允许用户轻松访问相关元数据,并在不查看实际记录的情况下了解现有数据是否有助于回答他们当前的商业问题。
你能分享一些关于合成数据开源社区的细节吗?
合成数据仍处于早期阶段,因此,如何生成合成数据、其益处或局限性对更广泛的受众来说还不太清楚。因此,在YData,我们决定采取更教育性的方法,创建合成数据社区——除了是一个交流想法或从合成数据领域专家那里获取帮助的地方外,它也是数据科学家和其他技术人员开始合成数据之旅的地方,他们可以在这里找到来自文献中一些最有趣的算法。
此外,我们还提供了对数据质量的看法,这样数据科学家就可以在合成或改进数据之前首先了解他们正在处理的数据。我们致力于帮助数据团队变得更加数据中心化。
YData最近宣布获得270万美元的资金,以加速其国际扩张。你能分享一些关于这对公司未来和扩张策略的意义吗?
YData从一开始就是一个国际公司——我们知道这项技术需要早期采用者,这些采用者通常在最发达的国家。因此,我们的第一批客户已经在葡萄牙以外的欧洲各地,我们现在也正在北美建立存在。这笔资金将使我们能够在这两个大陆上加强我们的存在,不仅在商业上,还将扩大我们的团队——我们是一个完全分布式的团队,这使我们能够在任何地方聘用最好的人才。
你还想分享关于YData的其他信息吗?
YData正在突破数据中心人工智能的界限,创造一个新类别:数据准备操作——尽管这个名字不太好听,但这是大多数公司在数据科学开发中面临的痛点。数据质量趋势正在增长,在数据管道和数据可观察性之后,数据科学团队的数据质量仍处于初期阶段,YData正在数据准备方面崭露头角,成为一家领先的思想者。
感谢这次精彩的采访,希望了解更多的读者可以访问YData的网站。


