
访谈
开源起源的Mathilde Pavis博士,法律负责人 – 采访系列

 将 Unite.AI 添加到您在 Google 上的首选来源
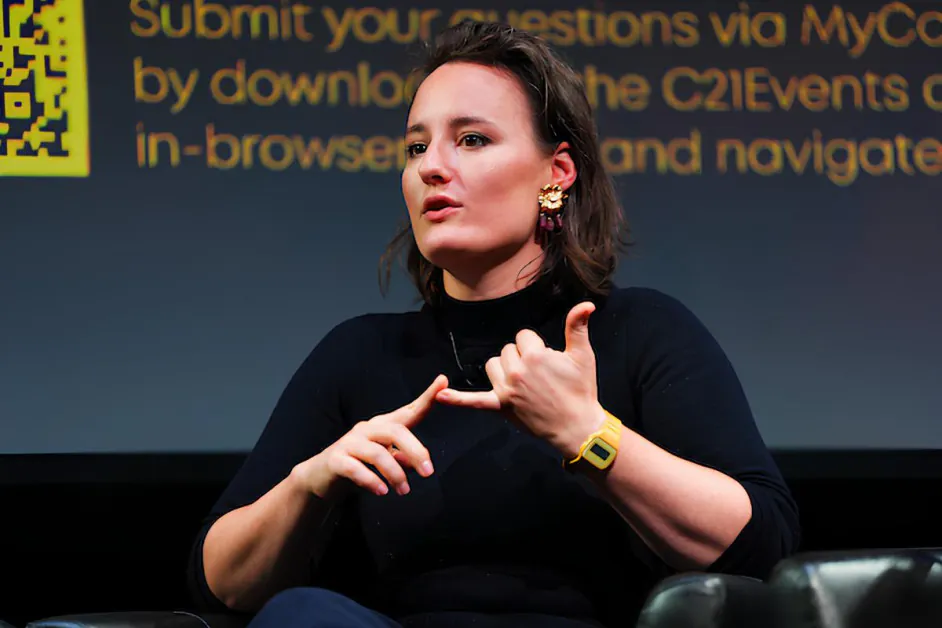
Mathilde Pavis博士,开源起源的法律负责人,是人工智能监管和数字媒体治理领域的领先专家,专门研究深度伪造、合成媒体和内容来源。 她为公司、政府和工会提供了关于生成性人工智能的合规性、许可和风险的建议,并曾与微软和ElevenLabs合作过人工智能政策和战略。 她还为联合国教科文组织提供了关于人工智能和知识产权的建议,并定期为英国政策制定者提供专家证词。
(MSFT )开源起源 开发技术以通过创建可验证、防篡改的数字内容记录来对抗虚假信息和深度伪造。其平台专注于建立明确的来源,允许媒体、创作者和平台证明内容的创建、编辑和分发时间和方式——这是一个越来越关键的功能,因为合成媒体变得更加先进,难以被检测到。
您曾为政府、全球机构如联合国教科文组织以及微软和ElevenLabs等公司提供了人工智能监管方面的建议。是什么让您专注于深度伪造、数字复制品和合成媒体,并且这段旅程如何影响您创立Replique的决定?
我的深度伪造研究并不是从技术开始的,而是从一个更古老的法律难题开始的。2013年,当我开始研究知识产权博士学位时,我被表演者与作者、作曲家或电影制片人相比所获得的保护程度之差所震惊。实际上,这意味着您的文字或音乐在法律上比您的脸、身体和声音更有保护。这一不平衡感觉很奇怪,这促使我问一个更深层次的问题:我们如何从文化和法律上看待那些通过脸、声音和身体为荧幕做出贡献的人的工作?
这个问题让我进入了表演者权利和数据的领域。当时,这被认为是一个利基领域,商业相关性不大。我被建议转到更“有利可图”的领域,如专利或传统版权。假设一个人的肖像或声音的问题主要通过行业规范或“好莱坞的绅士协议”来管理。但对我来说,这种缺乏正式保护的现象表明了一个差距,而不是我的研究的死胡同,所以我继续研究。
现在,几乎每个人都是表演者。我们的生活通过摄像头进行——在手机、笔记本电脑、视频通话和社交平台上。无论是工作还是个人使用,人们都在不断地录制和分享自己的版本。曾经主要适用于演员或音乐家的法律问题现在适用于任何拥有智能手机的人。
深度伪造并没有创造这些问题——它们暴露并加速了这些问题。从2013年开始的我的研究突然变得紧迫。2017年和2018年,神经网络的发展,特别是在麻省理工学院和加州大学伯克利分校等地方,开始展示如何令人信服地数字操纵一个人的脸、声音和身体。就在一年内,这种能力被广泛称为“深度伪造”,并首先通过深受伤害的方式获得了关注,特别是通过针对女性和儿童的非自愿性内容。
后来,商业影响出现了,因为创意产业开始采用合成媒体。那时我一直在研究的合同和经济问题变得突出。几乎一夜之间,曾经被视为理论或学说领域的法律成为一个非常实际、商业上重要和社会紧迫的领域。
在其核心,法律挑战并没有改变:人们希望分享自己的一部分,但仍然希望保持有意义的控制。现有的框架难以应对这种细微差别。它们倾向于将个人视为完全私人或完全公开——要么受到保护,要么成为公众的猎物。但大多数人处于两者之间。这种紧张关系现在不仅仅适用于专业表演者,也适用于任何参与数字生活的人。
我成为了研究和工作于此领域的专家,这让我有机会与政府合作,保护人们免受深度伪造的侵害,并与希望安全使用数字克隆产品的公司合作,如ElevenLabs。在Replique,我将我所学的一切带给了希望使用数字克隆或数字复制品技术负责和安全的人和公司。我基本上将我的“蓝天”研究转变为一家提供创意产业专家法律建议的咨询业务。
作为开源起源的法律负责人,开源起源是一家专注于通过创建数字内容的不可变记录来对抗深度伪造的公司,您如何看待基于来源的系统与传统的深度伪造检测方法的竞争或取代?
比较深度伪造检测工具可能很快就会变得像比较苹果和橙子一样,因为它们的有效性取决于上下文和目的。从政策角度来看,我们需要的是一系列互补工具——没有单一的“最佳”解决方案,开源起源只是更广泛生态系统的一部分。在开源起源的技术与其他深度伪造检测解决方案不同的方面是,当内容创作者或信息组织需要向合作伙伴、受众或公众证明他们分享的内容的真实性时,它脱颖而出。
通过在创建时提供可验证的来源和“收据”,它提供了一种强大的预防形式,证明内容不是深度伪造。然而,这种方法对于日常的互联网用户来说不太有用,他们希望快速评估他们在线遇到的内容。在这些情况下,检测更多地依赖于概率和内容分析方法,而不是基于来源的验证。我们需要不同工具来满足不同需求,我们需要接受没有银弹来对抗深度伪造的事实。
从法律角度来看,管辖区在处理人工智能生成或复制内容的同意和所有权方面存在哪些最大的差距?
哇,你有多少时间?答案取决于我们指的是什么样的人工智能生成或复制内容。问题会根据你是否正在查看人工智能生成的图像或数字重现的人的脸或声音而有所不同。让我们坚持讨论深度伪造和数字复制品,并回答你的问题以“数字克隆”的背景下。
关于同意,核心问题是大多数合同——无论是就业协议还是平台条款——都包含宽泛、模糊的条款,授予对用户内容的广泛权利。这些条款可以被解释为一种“后门同意”,即同意条款可能被视为同意使用,如克隆,即使大多数人会强烈反对这种解释。这在法律解释和用户期望之间创造了一个显著的差距,这一差距目前有利于公司,而监管滞后。
关于所有权,目前没有明确的法律答案来确定谁拥有数字克隆,因为现有的框架,如数据保护、版权和人格权,并不适用于这种技术。今天,大多数人在工作中被扫描和克隆,这是由雇主或客户要求和资助的。这些实体通常期望对此类资产拥有很高的控制权,这是可以理解的,但往往存在问题,因为该资产是您脸或声音的数字模仿,可以让您说出您从未说过的话或做出您从未做过的事情。
“谁拥有你的克隆?”这个问题在今天的法律中仍然没有答案。
您曾密切合作过语音克隆技术。语音合成中最容易被误解的法律风险是什么,既对于公司又对于个人?
最容易被误解的问题是公司在资助和开发数字克隆方面的商业利益与个人对隐私和数字尊严的权利之间的平衡。这一紧张关系跨越了多个法律制度(主要是知识产权、数据保护和隐私),这些制度从未被设计成一起运作,并以根本不同的方式解释克隆。因此,将其转化为可行的、适合业务的做法是复杂的,往往不清楚。公司因此要么忽略关键风险,要么为了正确地导航它们而承担重大成本。这导致了一个不合理的结果,即负责任的合规性成为更困难、更昂贵的道路,而不是默认路径。
企业在处理人工智能系统中的肖像、身份和训练数据时,应该如何思考同意架构?
公司应该围绕三个核心能力设计他们的系统。首先,他们需要在入职时获得明智的、有上下文的同意。其次,他们必须使用户能够轻松撤回同意并删除他们的部分或全部数据,这在技术上是具有挑战性的,往往被忽略,但对于遵守GDPR和类似法规至关重要。随着时间的推移,维持同意意味着建立系统,使撤回成为业务模式的一部分并且顺畅运行。
同意必须是细粒度的。第三,用户应该能够在单个文件级别管理权限、更新他们的肖像数据并了解其使用方式。这需要透明度和控制——允许用户监控、审查和管理其数字克隆的部署的工具。这种灵活性仍然很罕见,但它正变得越来越具有竞争优势。
在您为初创公司和政府提供建议的经验中,人工智能的建设和监管之间存在哪些最大的脱节?
人工智能的建设和监管之间的脱节归结为根本不同的使命。政府代表公众利益进行监管,而人工智能公司(通常由风险投资支持)主要由增长、收入和利润驱动。这些优先事项并不总是相互冲突,但它们经常朝着不同的方向拉扯,监管被视为一种限制,而不是支持。
这产生了一种结构性紧张:监管者和创新者在不同的激励、价值观和甚至语言下运作。这种紧张在实践中使得对齐变得困难,即使它并非不可能。我们开始看到一波新的科技公司更密切地与公共利益目标保持一致,但他们仍然是例外,而不是那些成功扩张的公司中的常规。
开源起源专注于使用加密来源验证内容。这种起源优先的方法与发布后保障相比有多重要?
这与我之前的回答有关。内容在创建时进行验证,或者说是在“上游”,比试图在分发或消费时验证内容(即在“下游”)要有效得多。内容在创建时进行验证,就像从农场开始追踪食物一样,而不是试图从盘子上的食物中推断出一切。如果你知道鸡从哪里养殖、如何处理以及如何通过供应链移动,你可以相信你吃的东西。如果你只是根据盘子上的食物来推断所有这些,你就依赖于猜测。同样,区分人工智能生成的内容和人类生成的内容:来源提供可验证的保证,而下游检测则固有不确定和被动。
您如何看待C2PA等标准在媒体未来的作用,它们是否足以独自恢复在线信任?
C2PA是一个受欢迎的举措,在许多方面,它支持与开源起源相同的内容真实性运动。他们是内容安全和内容真实性生态系统的重要组成部分。与每个网络安全工具一样,没有银弹。
对于电影、音乐和游戏等行业的创作者和人才,今天他们可以采取什么实际步骤来保护自己免受未经授权的数字复制?
艺术家今天面临两个不同的风险:他们作品的复制(例如音乐、图像或写作)和他们的肖像的复制,包括他们的脸、声音和身体。有了最少的输入,人工智能系统现在可以以很高的保真度复制这两者。在实践中,保护从故意分享在线内容开始,认识到任何发布的内容都可能被抓取并用于训练数据集,通常没有明确的同意或可见性。
这种风险现在是在线运营的基线现实。但更直接、更可控的风险通常在于合同中。艺术家与他们的合作者、发行商或平台签订的协议可能包括允许人工智能使用、重用或转售内容以进行培训的条款——通常没有对下游收入的有意义的参与。
对于艺术家来说,这使得合同审查变得至关重要。了解如何使用他们的作品和肖像以及如何许可或改用于其他用途至关重要。当前的辩论(在工会、行业机构和平台中)集中在纠正这种不平衡并确保创作者在控制和公平补偿方面保持领先地位。
因此,有两条关键建议:在网上分享内容时要小心,并在签署之前阅读合同中的人工智能条款。
展望未来三到五年,您是否认为我们会达到一个阶段,即每一份数字内容都必须携带可验证的来源,还是信任将在平台和管辖区之间保持分裂?
我想说是的,但现实地说,不——在五年内不会。从技术角度来看,五年感觉很长;从改变用户行为和习惯的角度来看,这是一个非常短的时间。大多数消费者不太可能根据内容是否带有经过验证的来源来做出决定。平台往往遵循用户需求,优化参与度而不是来源。
这可能会改变,如果监管介入。我们已经看到像加利福尼亚这样的地方出现了早期的举措,标签和审查要求正在出现,但将其扩大到全球可能需要更长的时间——可能更接近十年,而不是五年。
变化的另一个领域是特定于行业的:像新闻、金融、保险和医疗保健这样的行业可能会开始要求来源和验证,因为信任是他们运营的基本方面。
最后,消费者可能不会在短期内关心来源信息,但他们可能会关心内容质量和信息质量。如果人工智能生成的内容变得过于同质化或“平淡”,观众可能会开始更明显地重视人类创作的内容。这可能会推动市场的分割,一些平台优先考虑规模和人工智能生成的内容,而其他平台则注重真实性、来源和高信任度的人类主导内容——但这种转变仍然未知。
感谢您的精彩答案,希望了解更多的读者可以访问开源起源。


