

Моделі та платформи ШІ
Zero123++: базова дифузійна модель для узгоджених зображень із різних ракурсів за одним знімком

 Додайте Unite.AI до бажаних джерел у Google

Ключові моментиZero123++ об'єднує шість видів в одне зображення, щоб забезпечити тривимірну…
Показати більше
- Zero123++ об'єднує шість видів в одне зображення, щоб забезпечити тривимірну узгодженість при генерації багатопланових видів.
- Він впроваджує масштабовану референтну увагу для збереження локальної текстури з вихідного одиночного зображення.
- Модель використовує лінійний розклад шуму для покращення глобальної структури порівняно з масштабовано-лінійним підходом.
За останні кілька років ми стали свідками швидкого прогресу в роботі, ефективності та генерації нових генеративних моделей ШІ, які використовують великі набори даних та методи генерації 2D-дифузії. Сьогодні моделі генерації AI здатні генерувати різні форми 2D- та, до певної міри, 3D-медіа-контенту, включаючи текст, зображення, відео, GIF та інше.
У цій статті ми розглянемо фреймворк Zero123++, який є моделлю генерації AI, умовною на зображенні, з метою генерації 3D-узгодженого багаторакурсного зображення за допомогою одного виду входу. Для максимального використання переваг попередньо натренованих моделей генерації, фреймворк Zero123++ реалізує різні схеми навчання та умовлення, щоб мінімізувати кількість зусиль, необхідних для доопрацювання моделей дифузії зображень з коробки. Ми розглянемо архітектуру, роботу та результати фреймворк Zero123++ та проаналізуємо його можливості генерації узгодженого багаторакурсного зображення високої якості з одного зображення. Тому почнемо.
Zero123 і Zero123++: Введення
Фреймворк Zero123++ є моделлю генерації AI, умовною на зображенні, з метою генерації 3D-узгодженого багаторакурсного зображення за допомогою одного виду входу. Фреймворк Zero123++ є продовженням фреймворк Zero123 або Zero-1-to-3, який використовує техніку синтезу нових видів зображень без додаткового навчання на нових прикладах (zero-shot), щоб створити відкритий джерельний код для перетворення одного зображення в 3D. Хоча фреймворк Zero123++ демонструє перспективну продуктивність, зображення, згенеровані цим фреймворк, мають помітні геометричні несумісності, і це основна причина, чому розрив між 3D-сценами та багаторакурсними зображеннями ще існує.
Фреймворк Zero-1-to-3 служить основою для кількох інших фреймворк, включаючи SyncDreamer, One-2-3-45, Consistent123 та ін., які додають додаткові шари до фреймворк Zero123, щоб отримати більш узгоджені результати при генерації 3D-зображень. Інші фреймворк, такі як ProlificDreamer, DreamFusion, DreamGaussian та ін., використовують оптимізаційний підхід, щоб отримати 3D-зображення, витягуючи 3D-зображення з різних несумісних моделей. Хоча ці техніки ефективні та генерують задовільні 3D-зображення, результати можна поліпшити шляхом реалізації базової моделі дифузії, здатної генерувати багаторакурсні зображення узгоджено. Відповідно, фреймворк Zero123++ використовує фреймворк Zero-1-to-3 та доопрацьовує нову багаторакурсну базову модель дифузії з Stable Diffusion.
У фреймворк Zero-1-to-3 кожен новий вид генерується незалежно, і цей підхід призводить до несумісностей між згенерованими видами, оскільки моделі дифузії мають вибірковий характер. Для вирішення цієї проблеми фреймворк Zero123++ застосовує підхід плиткового компонування, коли об’єкт оточується шістьма видами в одному зображенні, забезпечуючи правильну модель спільного розподілу багаторакурсних зображень об’єкта.
Інша велика проблема, з якою стикаються розробники, які працюють над фреймворк Zero-1-to-3, полягає в тому, що він недостатньо використовує можливості Stable Diffusion, що в кінцевому підсумку призводить до неефективності та додаткових витрат. Є дві основні причини, чому фреймворк Zero-1-to-3 не може максимально використати можливості Stable Diffusion
- Під час навчання з умовами зображення фреймворк Zero-1-to-3 не включає локальні чи глобальні механізми умовлення, надані Stable Diffusion, ефективно.
- Під час навчання фреймворк Zero-1-to-3 використовує зменшену роздільність, підхід, при якому роздільність виходу зменшується нижче роздільності навчання, що може знижувати якість генерації зображень для моделей дифузії Stable Diffusion.
Для вирішення цих проблем фреймворк Zero123++ реалізує ряд технік умовлення, які максимізують використання ресурсів, наданих Stable Diffusion, та зберігають якість генерації зображень для моделей дифузії Stable Diffusion.
Поліпшення умовлення та узгодженості
У спробі поліпшити умовлення зображення та узгодженість багаторакурсних зображень фреймворк Zero123++ реалізував різні техніки, з основною метою повторного використання попередніх технік з попередньо натренованої моделі дифузії Stable Diffusion.
Багаторакурсна генерація
Неодмінною передумовою генерації узгоджених зображень із різних ракурсів є правильне моделювання їхнього спільного розподілу ймовірностей. У фреймворк Zero-1-to-3 кореляція між багаторакурсними зображеннями ігнорується, оскільки для кожного зображення фреймворк моделює умовний маргінальний розподіл незалежно та окремо. Однак у фреймворк Zero123++ розробники обрали підхід плиткового компонування, який укладає 6 зображень в одному кадрі/зображенні для узгодженого багаторакурсної генерації, і цей процес демонструється на наступному зображенні.
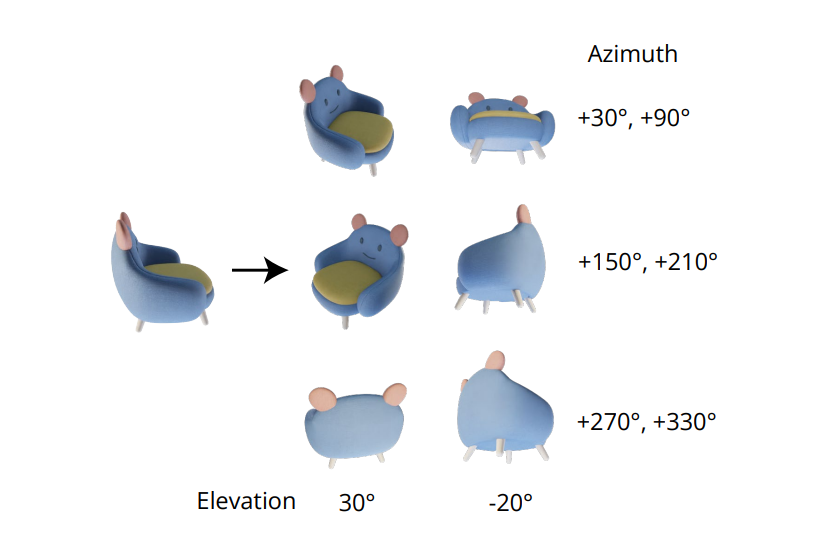

Крім того, було помічено, що орієнтації об’єктів мають тенденцію до розрізнення під час навчання моделі на камерних позах, і для запобігання цьому розрізненню фреймворк Zero-1-to-3 навчає на камерних позах з кутами висоти та відносними азимутами до входу. Для реалізації цього підходу необхідно знати кут висоти виду входу, який потім використовується для визначення відносної пози між новими видами входу. У спробі знайти цей кут висоти фреймворк часто додає модуль оцінки висоти, і цей підхід часто супроводжується додатковими помилками в конвеєрі обробки.
Графік шуму
Масштабований лінійний графік, оригінальний графік шуму для Stable Diffusion, фокусується в основному на локальних деталях, але, як можна побачити на наступному зображенні, він має дуже мало кроків з нижнім відношенням сигналу до шуму.


Ці кроки низького відношення сигналу до шуму відбуваються на ранній стадії денойзингу, стадії, яка визначає глобальну низькочастотну структуру. Зниження кількості кроків на стадії денойзингу, як під час інференсу, так і під час навчання, часто призводить до більшої структурної варіації. Хоча цей підхід ідеальний для генерації одного зображення, він обмежує можливість фреймворк забезпечити глобальну узгодженість між різними видами. Для подолання цього перепони фреймворк Zero123++ доопрацьовує модель LoRA на фреймворк Stable Diffusion 2 v-prediction для виконання спрощеного експериментального завдання, і результати демонструються нижче.

З графіком шуму, масштабованим лінійно, модель LoRA не переобучується, а лише трохи відбілює зображення. Навпаки, коли працюють з лінійним графіком шуму, фреймворк LoRA успішно генерує порожнє зображення незалежно від входового запиту, що свідчить про вплив графіка шуму на можливість фреймворк адаптуватися до нових вимог глобально.
Масштабована референс-увага для локальних умов
Одне зображення входу або умовні зображення у фреймворк Zero-1-to-3 конкатенуємо з шумними входами уздовж виміру ознак, щоб бути шумним для умовлення зображення.
Ця конкатенація призводить до неправильної піксельної просторової відповідності між цільовим зображенням та входом. Для забезпечення правильного локального умовного входу фреймворк Zero123++ використовує масштабовану референс-увагу, підхід, при якому запускається денойзинговий UNet-модель, посилається на додаткове референс-зображення, а потім додає матриці значень і ключів самоуваги з референс-зображення до відповідних шарів уваги, коли входи моделі денойзуються, і це демонструється на наступному зображенні.

Підхід референс-уваги здатний спрямовувати модель дифузії на генерацію зображень, які мають подібну текстуру з референс-зображенням, та семантичний зміст без будь-якого доопрацювання. З доопрацюванням підхід референс-уваги демонструє кращі результати з масштабованим латентом.

Глобальне умовлення: FlexDiffuse
У оригінальному підході Stable Diffusion текстові ембеддинги є єдиним джерелом глобальних ембеддингів, і підхід використовує фреймворк CLIP як текстовий кодувальник для застосування перехресної уваги (оригінал називає це cross-examinations, але в цьому контексті йдеться про увагу) між текстовими ембеддингами та латентними представленнями моделі. В результаті розробники можуть використовувати відповідність між текстовими просторами та отриманими зображеннями CLIP для глобального умовлення зображень.
Фреймворк Zero123++ пропонує використовувати навчуваний варіант лінійного механізму керування для включення глобального умовлення зображення в фреймворк з мінімальним донавчанням, необхідним, і результати демонструються на наступному зображенні. Як можна побачити, без глобального умовлення зображення, якість вмісту, згенерованого фреймворк, є задовільною для видимих регіонів, які відповідають входовому зображенню. Однак якість зображення, згенерованого фреймворк для невидимих регіонів, значно погіршується, що в основному пояснюється нездатністю моделі вивести глобальну семантику об’єкта.

Архітектура моделі
Фреймворк Zero123++ навчається з моделлю Stable Diffusion 2v як основою, використовуючи різні підходи та техніки, згадані в статті. Фреймворк Zero123++ попередньо навчається на наборі даних Objaverse, який відображається з випадковим освітленням HDRI. Фреймворк також застосовує фазований графік навчання, використовуваний у фреймворк Stable Diffusion Image Variations, у спробі додатково мінімізувати кількість доопрацювання, необхідного для збереження якомога більше попередньої інформації Stable Diffusion.
Робота або архітектура фреймворк Zero123++ можна далі розділити на послідовні кроки або фази. Перша фаза свідчить про те, що фреймворк доопрацьовує матриці KV шарів перехресної уваги та шарів самої уваги Stable Diffusion з оптимізатором AdamW, 1000 кроків розігріву та косинусним графіком навчання, який максимізується при 7×10⁻⁵. На другій фазі фреймворк використовує дуже консервативний постійний графік навчання з 2000 кроками розігріву та використовує підхід Min-SNR для максимізації ефективності під час навчання.
Zero123++: Результати та порівняння продуктивності
Якість виконання
Для оцінки продуктивності фреймворк Zero123++ на основі якості згенерованих зображень його порівнюють з SyncDreamer та Zero-1-to-3-XL, двома з найкращих фреймворк сучасного стану для генерації вмісту. Фреймворк порівнюються з чотирма входовими зображеннями з різним обсягом. Перше зображення – це іграшковий котик, взятий безпосередньо з набору даних Objaverse, і має велику невизначеність на задньому кінці об’єкта. Друге зображення – це вогнегасник, а третє – зображення собаки, яка сидить на ракеті, згенероване моделлю SDXL. Останнє зображення – це ілюстрація аніме. Необхідні кути піднесення для фреймворк досягаються за допомогою методу оцінки висоти фреймворк One-2-3-4-5, а видалення фону здійснюється за допомогою фреймворк SAM. Як можна побачити, фреймворк Zero123++ генерує високоякісні багаторакурсні зображення узгоджено та здатний узагальнювати до поза-доменних 2D-ілюстрацій та зображень, згенерованих AI, однаково добре.


Кількісний аналіз
Для кількісного порівняння фреймворк Zero123++ з сучасним станом фреймворк Zero-1-to-3 та Zero-1-to-3 XL розробники оцінюють метрику навченого перцептивної схожості фрагментів зображень (LPIPS), цих моделей на валідаційному розрізі даних, підмножині набору даних Objaverse. Для оцінки продуктивності моделі при генерації багаторакурсних зображень розробники укладають референс-зображення та 6 згенерованих зображень відповідно, а потім обчислюють метрику навченого перцептивної схожості фрагментів зображень (LPIPS). Результати демонструються нижче, і як можна побачити, фреймворк Zero123++ досягає кращої продуктивності на валідаційному розрізі.

Оцінка тексту до багаторакурсного зображення
Для оцінки можливостей фреймворк Zero123++ при генерації багаторакурсного вмісту розробники спочатку використовують фреймворк SDXL з текстовими запиту для генерації зображення, а потім використовують фреймворк Zero123++ для згенерованого зображення. Результати демонструються на наступному зображенні, і як можна побачити, у порівнянні з фреймворк Zero-1-to-3, який не може гарантувати узгоджену генерацію багаторакурсних зображень, фреймворк Zero123++ повертає узгоджені, реалістичні та високодеталізовані багаторакурсні зображення, реалізуючи підхід текст→зображення→зображення з кількох ракурсів.

Zero123++ Depth ControlNet
Крім базового фреймворк Zero123++, розробники також випустили Depth ControlNet Zero123++, глибинно-контрольовану версію оригінального фреймворк, побудовану за допомогою архітектури ControlNet. Нормалізовані лінійні зображення відображаються у відповідності з наступними RGB-зображеннями, а фреймворк ControlNet навчається контролювати геометрію фреймворк Zero123++ за допомогою глибинної перцепції.


Висновок
У цій статті ми розглянули фреймворк Zero123++, який є моделлю генерації AI, умовною на зображенні, з метою генерації 3D-узгодженого багаторакурсного зображення за допомогою одного виду входу. Для максимального використання переваг попередньо натренованих моделей генерації, фреймворк Zero123++ реалізує різні схеми навчання та умовлення, щоб мінімізувати кількість зусиль, необхідних для доопрацювання моделей дифузії зображень з коробки. Ми також розглянули різні підходи та покращення, реалізовані фреймворк Zero123++, які допомагають йому досягти результатів, порівнянних з результатами сучасного стану, та навіть перевершити їх.
Однак, незважаючи на свою ефективність та здатність генерувати високоякісні багаторакурсні зображення узгоджено, фреймворк Zero123++ все ще має певний потенціал для покращення, з можливими областями дослідження, такими як двостадійна модель рафінера, яка може вирішити нездатність фреймворк Zero123++ задовольняти глобальним вимогам узгодженості. Додаткові масштабування для подальшого покращення можливостей фреймворк Zero123++ щодо генерації зображень ще вищої якості.
- Двостадійна модель рафінера яка може вирішити нездатність фреймворк Zero123++ задовольняти глобальним вимогам узгодженості.
- Додаткові масштабування для подальшого покращення можливостей фреймворк Zero123++ щодо генерації зображень ще вищої якості.


