
AGI та майбутній ШІ
Що таке тест Тьюрінга і чому він важливий?

 Додайте Unite.AI до бажаних джерел у Google
Тест Тьюрінга виник з статті Алана Тьюрінга 1950 року “Computing Machinery and Intelligence”. Замість спроби визначити думку, Тьюринг запропонував гру‑імітацію: людський допитувач обмінюється письмовими повідомленнями з невидимими учасниками і визначає, хто з них — людина, а хто — машина.
Тест залишається впливовим, бо перетворює абстрактне філософське питання на спостережувальну взаємодію. Він також має обмеження: виглядати людиною у розмові не означає бути правдивим, обізнаним, безпечним, свідомим або загалом інтелектуальним.
Основні висновки
- Оригінальна гра‑імітація Тьюрінга — це текстовий поведінковий тест, а не перелік внутрішніх когнітивних властивостей.
- Результати залежать від оцінювача, підказки, тривалості, інструкцій учасників та правила оцінювання.
- Модель може імітувати людську розмову, водночас вигадуючи факти або провалюючись у простих тестах на стійкість.
- Сучасна оцінка потребує метрик завдань, адверсаріального тестування, людського перегляду та доказів, специфічних для ризиків, окрім розмови.
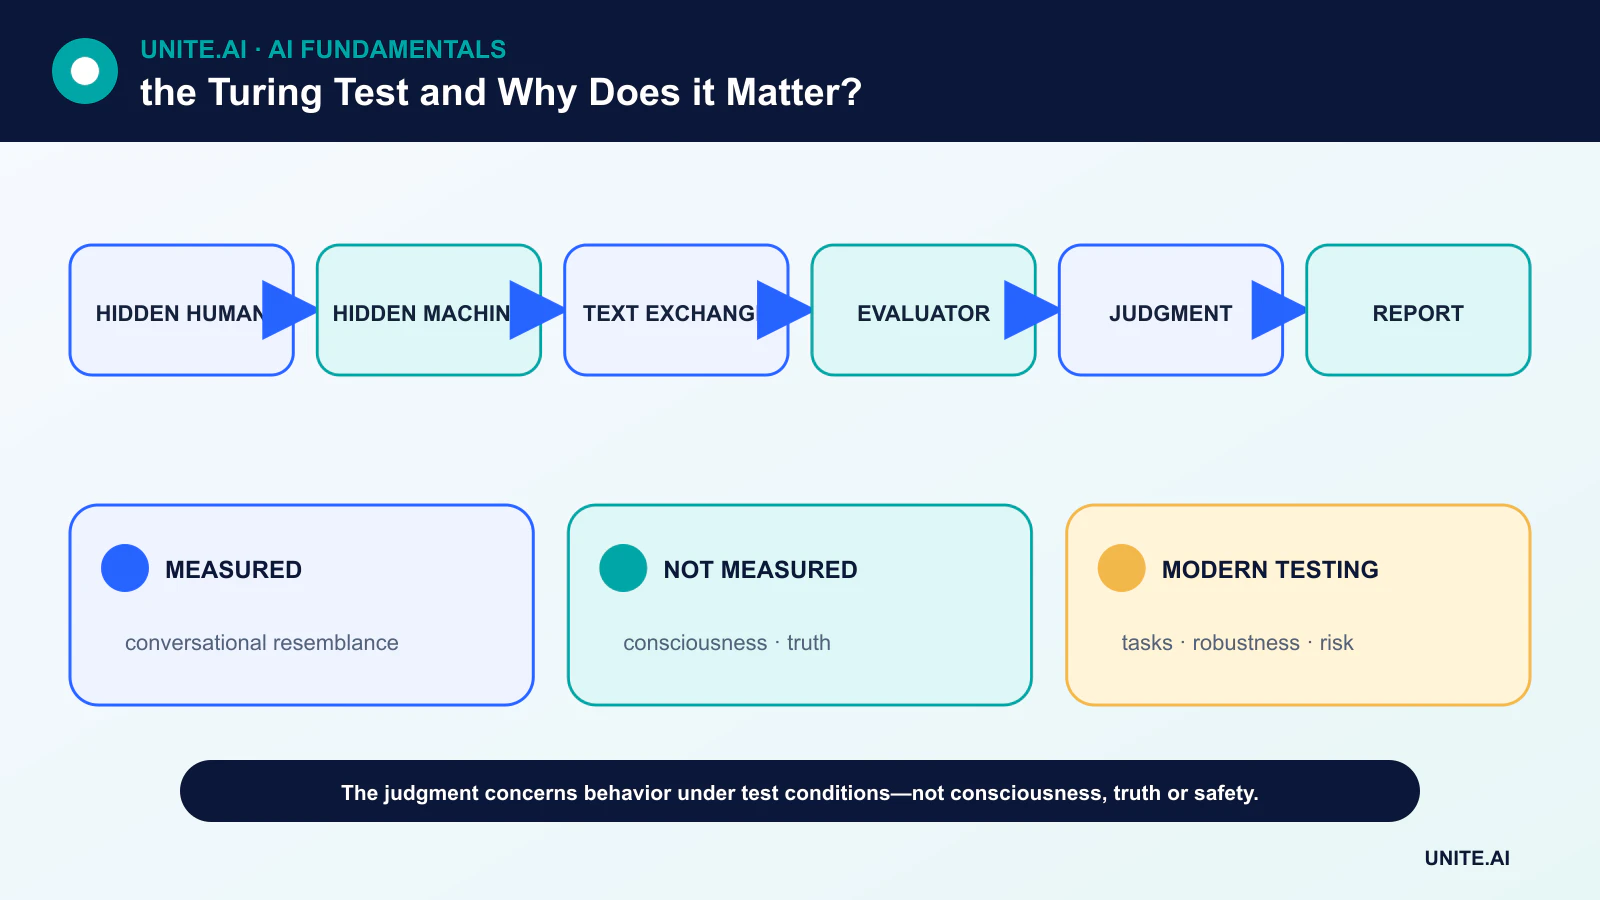
Гра‑імітація Тьюрінга
У первинному варіанті допитувач спілкувався на відстані, щоб голос і зовнішність не розкривали особу. Тьюринг запитав, чи може машина виступати достатньо добре в грі, щоб оцінювач не міг надійно відрізнити її від людини.
Таке практичне формулювання уникало потреби встановлювати єдине визначення мислення. Воно не стверджувало, що кожен переконливий обмін доводить інтелект, і не визначало універсального порогу проходження, який би застосовувався до будь‑яких подальших демонстрацій чат‑ботів.
Що насправді вимірює результат
Експеримент вимірює поведінкову незрізненість за визначених умов. Короткі розмови, недосвідчені судді або підказки, обрані розробником системи, можуть спростити завдання. Ретельний звіт має розкривати вибір транскриптів, кількість і бекграунд суддів, порівнюваних людей, обмеження часу та статистичний метод.
Система може також використовувати очікування: ухиляння, гумор, типографічні помилки та рольову гру можуть виглядати людськими, не демонструючи надійного мислення. Навпаки, надмірно формальна людська відповідь може бути помилково класифікована як згенерована машиною.
Чого тест Тьюрінга не встановлює
Тест безпосередньо не вимірює свідомість, суб’єктивний досвід, фактичну точність, причинне розуміння чи моральну дію. Він не розкриває дані навчання, архітектуру моделі чи режими відмов поза розмовою. Також він мало розповідає про нелінгвістичний інтелект, наприклад фізичну маніпуляцію.
Сучасні мовні системи створені за допомогою трансформерних нейронних мереж та глибокого навчання, проте їхні плавні відповіді можуть генеруватися лише на основі вивчених статистичних структур, а не перевіреної моделі світу.
Як сучасна оцінка ШІ розширює питання
Сучасна оцінка використовує відкладені набори завдань, калібровану невизначеність, тести на стійкість, червоне командування, перевірки фактичності та дослідження людських уподобань. Метрика класифікації тексту може тестувати визначену поведінку, тоді як оцінка на основі сценаріїв перевіряє, чи система дотримується політики під тиском.
Жоден окремий бенчмарк не охоплює всі варіанти впровадження. Забруднення тесту може підвищувати бали, а статичні бенчмарки сприяють перенавчанню. Оцінка повинна повторюватися у міру зміни моделей, даних, підказок, інструментів та користувацьких груп.
Чому тест і досі важливий
Тест Тьюрінга передбачив ключовий урок оцінки ШІ: оцінювати спостережувані можливості, а не покладатися на заяви про внутрішню сутність. Він також змушує нас запитати, які людські поведінки вважаються доказом і як експериментальне налаштування формує висновок.
Найкраще його сучасне використання — як історичну та концептуальну базу. Проходження гри‑імітації може бути цікавим, проте рішення про впровадження потребують доказів, пов’язаних з конкретним завданням, зацікавленими користувачами та передбачуваними шкодами.
Що вимірює тест Тьюрінга
Гра‑імітація Алана Тьюрінга ставила питання, чи може допитувач, що спілкується через текст, надійно розрізнити машину від людини. Вона перетворила абстрактну дискусію про те, чи мислять машини, на спостережуваний розмовний експеримент. Тест залежить від учасників, тривалості, протоколу, тем і правила оцінювання; не існує єдиного універсального балу. Проходження означає створення відповідей, схожих на людські, у цьому контексті. Він не вимірює безпосередньо фактичну точність, міркування, свідомість, автономність, сприйняття, втілення, надійність чи корисну поведінку у реальному світі.
Імітація людини може заохочувати ухиляння, персонаж, помилки, гумор або маніпуляції. Суддя може помилково прийняти людину за машину або бути під впливом очікувань, мови та культурного контексту. Короткі розмови дозволяють трюки, які провалюються при тривалішій взаємодії. Навпаки, надзвичайно корисна система для математики, перекладу чи моделювання білків може не пройти, бо не намагається виглядати людською. Тому тест вимірює соціальну та лінгвістичну здатність, сформовану оцінювачем, а не повний порядок інтелекту.
Сучасні мовні моделі та більш строгі оцінки
Великі мовні моделі можуть підтримувати плавний діалог, передбачаючи послідовності на основі широких навчальних даних і подальшого налаштування, проте плавність є слабким доказом правди чи розуміння. Запам’ятовані патерни, доступ до інструментів, приховані підказки, затримка та налаштування семплювання впливають на результати. Контрольовані оцінки мають розкривати модель і протокол, запобігати витоку інформації, включати адверсаріальні та доменні питання, а також оцінювати невизначеність і посилання. Демонстрація, вибрана з успішних розмов, не може оцінити надійність по всьому спектру використання.
Сучасна оцінка багатовимірна: точність завдання, калібрування, стійкість, довгострокова послідовність, безпека, упередженість, конфіденційність, безпека, ефективність та людські результати. Поведінкові тести мають доповнюватися доказами процесу, червоним командуванням, відтворюваними бенчмарками та моніторингом у реальному світі. Бенчмарки можуть насититися або потрапити до навчальних даних, тому потрібні приватні та оновлені тестові набори. Для систем, що діють, слід окремо оцінювати дозволи інструментів, відновлення та наслідки, не змішуючи їх із якістю розмови.
Чому тест і досі важливий
Тест Тьюрінга залишається історично важливим, бо зосереджується на поведінці та складності визначення інтелекту. Він також піднімає постійні питання про антропоморфізм та обман. Інтерфейси мають ідентифікувати синтетичних агентів, а не трактувати помилкову ідентифікацію як успіх, особливо у критичних умовах. Використовуйте тест як філософську призму та одну розмовну оцінку, а не як сертифікат загального інтелекту чи особистості. Важливе питання впровадження — що система може надійно робити, на підставі яких доказів і обмежень, і хто несе відповідальність у разі провалу.
Практичний приклад: контрольована розмовна оцінка
Оцінювачі порівнюють людей і кілька ШІ‑систем у текстових розмовах з фіксованою тривалістю, темами, мовою та анонімними ідентифікаторами. Судді реєструють, чи вважають вони кожного учасника людиною, а також оцінюють фактичність, послідовність, корисність, невизначеність і маніпуляцію. Кілька суддів і розмови дозволяють оцінити варіативність, а протокол запобігає розробникам моделей вибирати сприятливі транскрипти. Помилкова класифікація людей забезпечує необхідну базу для інтерпретації результату.
Система, яка обманює суддів, вигадуючи факти, не вважається загально інтелектуальною, тоді як чітко розкритий спеціалізований модель може бути надзвичайно корисною, незважаючи на провал імітації. Результати включають підказку, модель, семплер, доступ до інструментів та характеристики суддів. Експеримент подається як один тест людської розмови. Рішення про впровадження використовують окремі докази щодо правильності завдання, безпеки, конфіденційності та відновлення, а інтерфейс ідентифікує агента, а не перетворює обман у мету продукту.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базу та версійну оцінювальну вибірку до налаштування. Тестуйте звичайні випадки, граничні умови, пошкоджені чи відсутні вхідні дані, зсув розподілу, відсутність залежностей, зловживання та групи або середовища, які найчастіше залишаються без належної підтримки. Оцінюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожну трансформацію та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та вихід з експлуатації. Використовуйте поетапний випуск, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має показувати якість вхідних даних, поведінку вихідних, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих чутливих даних. Визначте пороги сповіщень і відповідального за реакцію, потім переглядайте докази реального світу після впровадження, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та збереження, а також чіткого моменту, коли її слід вимкнути або замінити.
Часто задавані питання
Чи пройшов якийсь ШІ остаточно тест Тьюрінга?
Не існує єдиного офіційного органу тестування чи універсально прийнятого протоколу. Публічні демонстрації використовують різні правила, тому заяви про «проходження» не можна безпосередньо порівнювати.
Чи доводить провал тесту, що система неінтелектуальна?
Ні. Спеціалізована система може бути надзвичайно здатною, не імітуючи людський розмовний стиль.
Основні джерела












