
Лідери думок
Три техніки машинного навчання, що зберігають приватність, які вирішують найважливішу проблему цього десятиліття

 Додайте Unite.AI до бажаних джерел у Google
Від Amogh Tarcar, дослідника машинного навчання та штучного інтелекту, Persistent Systems. (PERSISTENT.BO )
Приватність даних, згідно з думкою експертів з різних галузей, буде найважливішою проблемою цього десятиліття. Це особливо вірно для машинного навчання (ML), де алгоритми обробляють великі обсяги даних.
Традиційно техніки моделювання ML залежали від централізації даних з 여러 джерел в один центр даних. Адже моделі ML найпотужніші, коли вони мають доступ до великих обсягів даних. Однак існують численні проблеми з приватністю, пов’язані з цією технікою. Об’єднання даних з різних джерел стає менш реальним сьогодні через нормативні проблеми, такі як HIPAA, GDPR та CCPA. Крім того, централізація даних збільшує масштаб і сферу порушення приватності та загроз безпеки у вигляді витоків даних.
Щоб подолати ці проблеми, було розроблено кілька основ машинного навчання, що зберігають приватність (PPML), з конкретними техніками, які зменшують ризик порушення приватності та забезпечують розумну безпеку даних. Ось кілька найважливіших з них:
1. Федераційне навчання
Федераційне навчання – це техніка навчання ML, яка перевернула проблему агрегації даних з ніг на голову. Замість агрегації даних для створення однієї моделі ML федераційне навчання агрегує самі моделі ML. Це забезпечує, що дані ніколи не покидають свого джерела, і дозволяє кільком сторонам співпрацювати та будувати спільну модель ML без прямого обміну конфіденційними даними.
Це працює наступним чином. Ви починаєте з базової моделі ML, яку потім передають кожному клієнтському вузлу. Ці вузли потім проводять локальне навчання на цій моделі, використовуючи свої власні дані. Оновлення моделей періодично передаються координаторному вузлу, який обробляє ці оновлення та об’єднує їх, щоб отримати нову глобальну модель. Таким чином, ви отримуєте знання з різних наборів даних, не передаючи ці дані.

Джерело: Persistent Systems
У контексті охорони здоров’я це надзвичайно потужний і приватний інструмент для захисту даних пацієнтів, одночасно надаючи дослідникам мудрість натовпу. Не агрегуючи дані, федераційне навчання створює додатковий рівень безпеки. Однак самі моделі та оновлення моделей все ще представляють ризик безпеки, якщо вони залишаються вразливими.
2. Диференціальна приватність
Моделі ML часто стають мішенями для атак на членство. Наприклад, ви могли поділитися своїми даними охорони здоров’я з лікарнею, щоб допомогти розробити вакцину проти раку. Лікарня зберігає ваші дані в безпеці, але використовує федераційне навчання для навчання публічно доступної моделі ML. Через几个 місяців хакери використовують атаку на членство, щоб визначити, чи були ваші дані використані під час навчання моделі. Вони потім передають знання страховій компанії, яка, на основі вашого ризику захворювання на рак, могла б підвищити ваші страхові премії.
Диференціальна приватність забезпечує, що атаки на моделі ML не зможуть ідентифікувати конкретні дані, використані під час навчання, тим самим пом’якшуючи ризик порушення приватності під час навчання моделей ML. Це досягається шляхом застосування “статистичного шуму” для порушення даних або параметрів моделі ML під час навчання, що робить складним проведення атак та визначення, чи були дані конкретної особи використані під час навчання моделі.
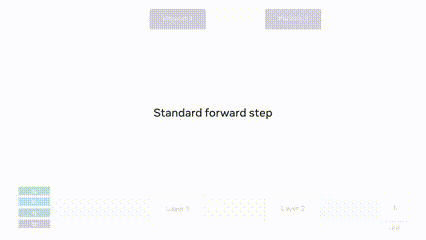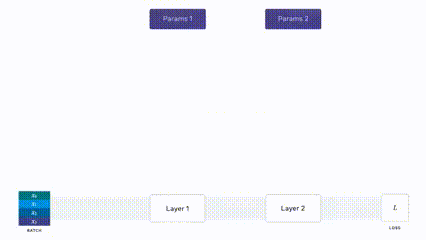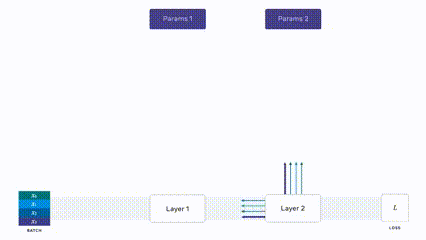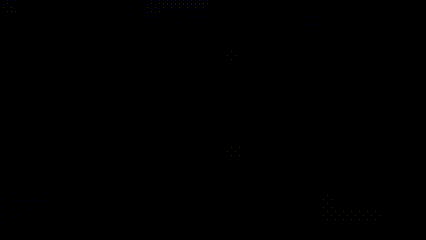
Наприклад, Facebook недавно випустив Opacus, бібліотеку високої швидкості для навчання моделей PyTorch з використанням алгоритму навчання ML з диференціальною приватністю під назвою Differentially Private Stochastic Gradient Descent (DP-SGD). Гіф нижче демонструє, як він використовує шум для маскування даних.
Джерело: Блог Opacus Facebook
Цей шум керується параметром під назвою Епсилон. Якщо значення Епсилон низьке, модель має ідеальну приватність даних, але погану корисність і точність. Навпаки, якщо у вас високе значення Епсилон, ваша приватність даних знижується, а точність зростає. Секрет полягає в тому, щоб знайти баланс для оптимізації обох.
3. Гомоморфне шифрування
Стандартне шифрування традиційно не сумісне з машинним навчанням, оскільки після шифрування даних вони вже не можуть бути зрозумілі алгоритмом ML. Однак гомоморфне шифрування – це спеціальний схем шифрування, який дозволяє нам продовжувати виконувати певні види обчислень.

Джерело: OpenMined
Сила цього полягає в тому, що навчання може відбуватися в цілком зашифрованому просторі. Це не тільки захищає власників даних, але також захищає власників моделей. Власник моделі може виконувати висновок на зашифрованних даних, не бачачи їх і не зловживає ними.
Коли його застосовують до федераційного навчання, об’єднання оновлень моделей відбувається безпечно, оскільки відбувається в цілком зашифрованому середовищі, що суттєво знижує ризик атак на членство.
Десятиліття приватності
Когда ми вступаємо в 2021 рік, машинне навчання, що зберігає приватність, – це нова галузь з надзвичайно активними дослідженнями. Якщо попереднє десятиліття було про розсилку даних, це десятиліття буде про розсилку моделей ML, зберігаючи приватність підлягаючих даних за допомогою федераційного навчання, диференціальної приватності та гомоморфного шифрування. Це представляє перспективний новий спосіб просування рішень машинного навчання в приватному порядку.


