
Погляд Anderson
Як Stable Diffusion міг би розвиватися як масовий споживчий продукт

 Додайте Unite.AI до бажаних джерел у Google
Ключові моментиОсновному застосунку Stable Diffusion необхідно вирішити проблеми складної установки…
Показати більше
- Основному застосунку Stable Diffusion необхідно вирішити проблеми складної установки через командний рядок та залежностей.
- Комерційні розробники стикаються з правовими ризиками через створення глибоких підробок та фільтри NSFW-контенту.
- Для використання споживачами такі розширені функції, як темпоральна узгодженість та текстове інвертування, потребують хмарної обробки.
Іронічно, Stable Diffusion, нова система синтезу зображень на основі штучного інтелекту, який завоював світ, не є ні стабільним, ні по-справжньому “розсіяним” – принаймні, поки що.
Повний діапазон можливостей системи розкиданий по різноманітному набору постійно мутуючих пропозицій від невеликої групи розробників, які гарячково обмінюються останніми відомостями та теоріями в різних дискусіях на Discord – і більшість процедур установки пакетів, які вони створюють або модифікують, дуже далекі від “підключи і працюй”.
Натомість вони схильні вимагати командної установки або інсталяції через BAT-файли за допомогою GIT, Conda, Python, Miniconda та інших передових розробницьких фреймворків – програмних пакетів, які рідко зустрічаються серед загальної маси споживачів, тому їхня установка часто помічається антивірусними та анти-шпигунськими програмами як ознака компрометованої системи.

Тільки невелика частина етапів, яких зараз потребує стандартна установка Stable Diffusion. Багато з цих розподілів також вимагають конкретних версій Python, які можуть конфліктувати з існуючими версіями, встановленими на машині користувача – хоча це можна обійти за допомогою інсталяцій на основі Docker і, до певної міри, за допомогою використання середовищ Conda.
Потоки повідомлень у спільнотах SFW і NSFW Stable Diffusion переповнені порадами та хитрощами, пов’язаними з хакінгом скриптів Python та стандартними інсталяціями, щоб забезпечити покращену функціональність або вирішити часті помилки залежностей та інші проблеми.
Це залишає середнього споживача, який цікавиться створенням неймовірних зображень з текстових підказок, майже повністю під владою зростаючої кількості монетизованих веб-інтерфейсів API, більшість з яких пропонує мінімальну кількість безкоштовних генерацій зображень перед тим, як вимагати покупки токенів.
Крім того, майже всі ці веб-орієнтовані пропозиції відмовляються виводити контент NSFW (багато з яких можуть стосуватися не-порнографічних предметів загального інтересу, таких як “війна”), який відрізняє Stable Diffusion від цензурованого сервісу OpenAI DALL-E 2.
‘Photoshop для Stable Diffusion’
Захоплені фантастичними, провокаційними або іншопланетними зображеннями, які щодня населяють хештег #stablediffusion у Twitter, те, чого очікує ширший світ, – це ‘Photoshop для Stable Diffusion’ – кросплатформна програма, яку можна встановити, яка включає найкращу та найпотужнішу функціональність архітектури Stability.ai, а також різні винахідливі інновації, що з’являються в спільноті розробників SD, без будь-яких спливаючих вікон командного рядка, загадкових та постійно мутуючих процедур установки та оновлення, або відсутніх функцій.
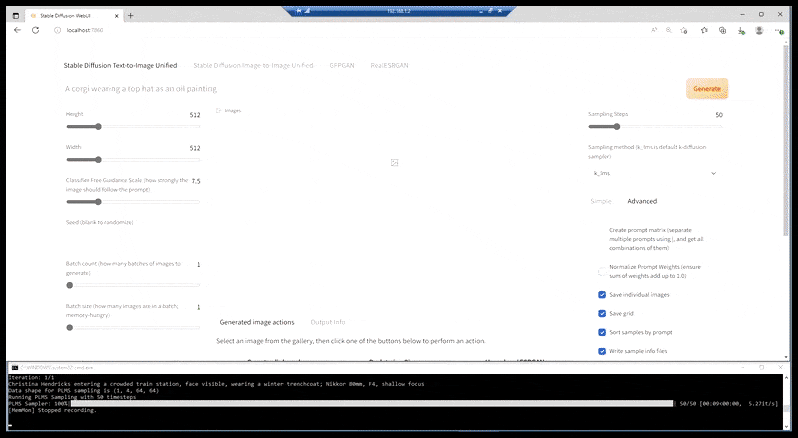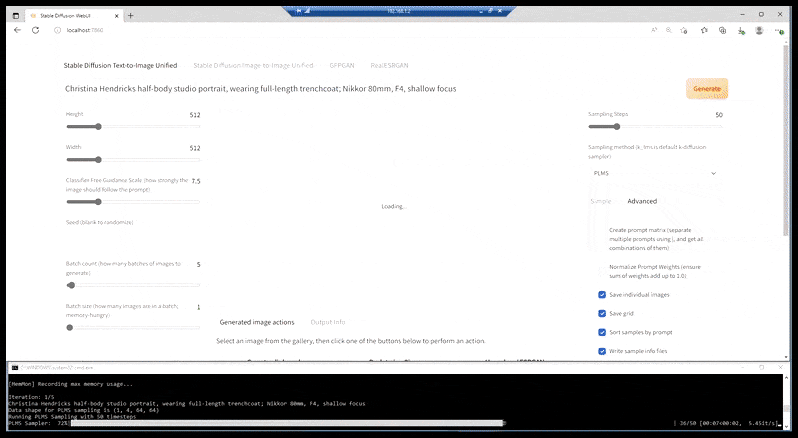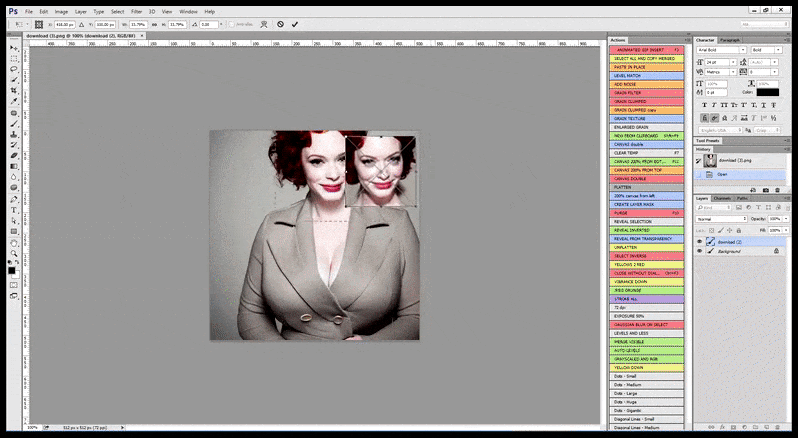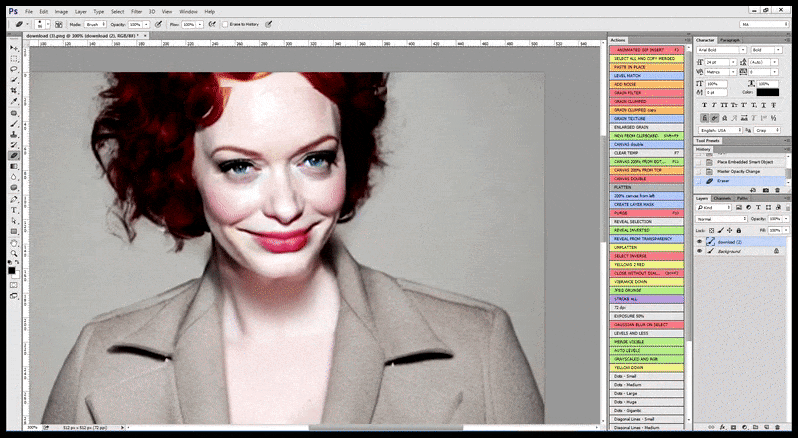
Те, що у нас зараз є в більшості здатних інсталяцій, – це різноманітна веб-сторінка, що межує з відокремленим вікном командної строки, а її URL – це порт localhost:

Аналогічно до застосунків синтезу, керованих командною строкою, таких як FaceSwap, і BAT-орієнтованому DeepFaceLab, інсталяція ‘prepack’ Stable Diffusion демонструє свої коріння командної строки, з інтерфейсом, доступним через порт localhost (див. верх зображення), який спілкується з функціональністю Stable Diffusion, заснованою на командній строкі.
Безумовно, зручніша програма вже на підході. Вже є кілька цілісних застосунків, доступних через Patreon, які можна завантажити, таких як GRisk і NMKD (див. нижче зображення) – але жоден з них ще не інтегрує повний діапазон функцій, який можуть пропонувати деякі з більш просунутих та менш доступних реалізацій Stable Diffusion.

Ранні пакети Stable Diffusion, доступні через Patreon, лише частково перетворені на повноцінні застосунки. NMKD – перший, який інтегрує вивід командної строки безпосередньо в GUI.
Давайте подивимось, яким може бути більш поліпшена та інтегральна реалізація цього чудового продукту з відкритим кодом – і які виклики вона може зустріти.
Правові питання для належно фінансованої комерційної програми Stable Diffusion
Фактор NSFW
Вихідний код Stable Diffusion випущений під дуже ліберальною ліцензією, яка не забороняє комерційних реімплементацій та похідних робіт, які суттєво використовують вихідний код.
Крім згаданих збірок, доступних через Patreon Stable Diffusion, а також великої кількості плагінів застосунків, які розробляються для Figma, Krita, Photoshop, GIMP і Blender (серед інших), немає практичної причини, чому добре профінансована компанія з розробки програмного забезпечення не могла б створити значно більш досконалу та потужну програму Stable Diffusion. З ринкової точки зору, є всі підстави вважати, що кілька таких ініціатив вже знаходяться в активній розробці.
Тут такі проєкти одразу стикаються з дилемою: чи дозволятиме застосунок, як і більшість веб-API Stable Diffusion, вимкнути вбудований фільтр NSFW — фрагмент коду.
‘Поховання’ перемикача NSFW
Хоча відкрита ліцензія Stability.ai для Stable Diffusion включає перелік способів використання, який можна широко тлумачити, для яких вона не може бути використана (можливо, включаючи порнографічний контент і дипфейки), єдиним способом, яким постачальник міг би ефективно заборонити такий використовування, було б скомпілювати фільтр NSFW у непрозорий виконуваний файл замість параметра у файлі Python, або ж примусити порівняння контрольної суми на файлі Python або DLL, який містить директиву NSFW, так що рендеринг не може відбутися, якщо користувачі змінюють цю налаштування.
Це залишило б застосунок “кастрованим” майже так само, як DALL-E 2 зараз, зменшуючи його комерційну привабливість. Крім того, неминуче, декомпільовані “шахрайські” версії цих компонентів (або оригінальних елементів часу виконання Python, або скомпільованих файлів DLL, як зараз використовуються в лінії інструментів Topaz для покращення зображень на основі штучного інтелекту) мали б з’явитися в спільноті торрентів/хакінгу, щоб обійти такі обмеження, просто замінивши перешкоджуючі елементи та анулювавши будь-які вимоги до контрольної суми.
У кінцевому підсумку постачальник міг би просто повторити попередження про неправильне використання, яке характеризує перший запуск багатьох поточних розподілів Stable Diffusion.
Однак маленькі відкриті розробники, які зараз використовують неформальні застереження таким чином, мають мало що втрачати у порівнянні з компанією програмного забезпечення, яка вклала значну кількість часу та грошей у створення повноцінної та доступної програми Stable Diffusion – що запрошує глибшу увагу.
Відповідальність за дипфейки
Як ми недавно відзначили, база даних LAION-естетики, частина 4,2 мільярдів зображень, на яких були треновані моделі Stable Diffusion, містить велику кількість зображень знаменитостей, що дозволяє користувачам ефективно створювати дипфейки, включаючи дипфейкові порнографічні зображення знаменитостей.

З нашої недавньої статті, чотири етапи Дженніфер Коннеллі за чотири десятиліття її кар’єри, виведені з Stable Diffusion.
Це окрема і більш суперечлива проблема, ніж генерація (зазвичай) законного “абстрактного” порно, яке не зображує “реальних” людей (хоча такі зображення виводяться з множини реальних фотографій у навчальних матеріалах).
Оскільки все більше штатів США та країн розробляють або прийняли закони проти порнографічних дипфейків, здатність Stable Diffusion створювати порнографічні зображення знаменитостей могла б означати, що комерційна програма, яка не цілком цензурується (тобто може створювати порнографічний матеріал), все ж могла б потребувати деякої здатності фільтрувати виявлені обличчя знаменитостей.
Одним із методів було б надання вбудованого “чорного списку” термінів, які не будуть прийняті в користувацькій підказці, що стосується імен знаменитостей та вигаданих персонажів, з якими вони можуть бути пов’язані. Ймовірно, такі налаштування мали б бути введені в більшій кількості мов, ніж лише англійська, оскільки початкові дані містять інші мови. Інший підхід міг би полягати у включенні систем розпізнавання знаменитостей, таких як ті, що розроблені компанією Clarifai.
Можливо, програмним виробникам доведеться включити такі методи, можливо, спочатку вимкнені, які могли б допомогти запобігти генерації облич знаменитостей повноцінною програмою Stable Diffusion, поки не з’явиться нове законодавство, яке могло б зробити таку функціональність незаконною.
Як і раніше, однак, така функціональність могла б бути декомпільована та обернена зацікавленими особами; однак програмний виробник міг би в такому випадку заявити, що це є ефективно несанкціонованим вандалізмом – поки така інженерія не робиться надмірно легкою.
Функції, які могли б бути включені
Базова функціональність будь-якого дистрибутива Stable Diffusion очікується будь-якої добре профінансованої комерційної програми. До них належать можливість використовувати текстові підказки для генерації відповідних зображень (text-to-image); можливість використовувати ескізи або інші зображення як орієнтири для нових згенерованих зображень (image-to-image); засоби регулювання того, наскільки творчо система має інтерпретувати підказку; спосіб обміну часу рендерингу на якість; та інші “базові” речі, такі як необов’язкова автоматична архівація зображень/підказок, і звичайна необов’язкова інтерполяція через RealESRGAN, і щонайменше базове “фіксування обличчя” з GFPGAN або CodeFormer.
Це досить “ванільна” інсталяція. Давайте подивимось на деякі з більш просунутих функцій, які зараз розробляються або розширюються, які могли б бути включені у повноцінну “традиційну” програму Stable Diffusion.
Стохастичне заморожування
Хоча ви повторно використовуєте початкове значення генератора (seed) з попередньої успішної генерації, це страшенно складно змусити Stable Diffusion точно повторити перетворення, якщо будь-яка частина підказки чи вихідного зображення (або обидва) змінені для наступної генерації.
Це проблема, якщо ви хочете використовувати EbSynth, щоб накласти перетворення Stable Diffusion на реальне відео узгодженим у часі способом – хоча техніка може бути дуже ефективною для простих кадрів з головою та плечима:
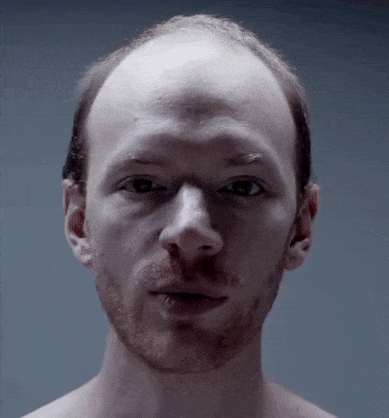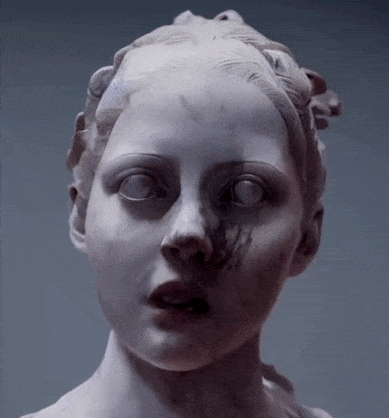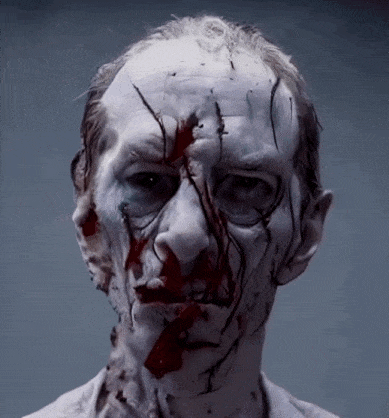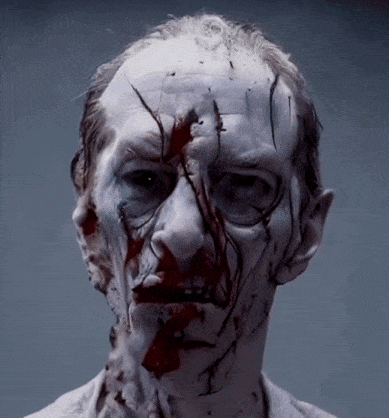
Незначний рух може зробити EbSynth ефективним засобом перетворення перетворень Stable Diffusion у реалістичне відео. Джерело: https://streamable.com/u0pgzd
EbSynth працює шляхом екстраполяції невеликої вибірки “змінених” ключових кадрів у відео, яке було відтворено у серію файлів зображень (і яке пізніше можна зібрати назад у відео).

У цьому прикладі з сайту EbSynth невелика кількість кадрів з відео була намальована художнім чином. EbSynth використовує ці кадри як стилеві орієнтири, щоб подібним чином змінити все відео, щоб воно відповідало намальованому стилю. Джерело: https://www.youtube.com/embed/eghGQtQhY38
У прикладі нижче, який показує майже жодного руху від (реальної) блондинки-інструкторки з йоги ліворуч, Stable Diffusion все ж має труднощі з підтриманням сталого обличчя, оскільки три зображення, які перетворюються як “ключові кадри”, не є абсолютно ідентичними, хоча вони всі мають однаковий числовий seed.

Тут, навіть з тією ж підказкою та значенням seed для всіх трьох перетворень, і дуже мало змін між вихідними кадрами, м’язи тіла різняться за розміром та формою, але що ще важливіше, обличчя є несталеним, що заважає часовій узгодженості у потенційному рендерингу EbSynth.
Хоча відео EbSynth/SD нижче дуже винахідливе, де пальці користувача перетворюються на (відповідно) ходячу пару штанів і качку, несталість штанів типіфікує проблему, з якою Stable Diffusion має справу при підтриманні сталості між різними ключовими кадрами, навіть коли вихідні кадри схожі один на одного, а seed залишається незмінним.
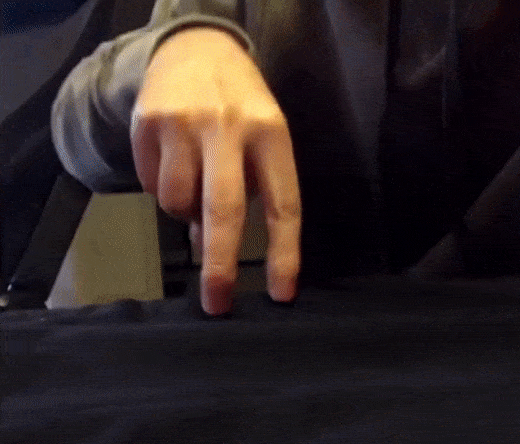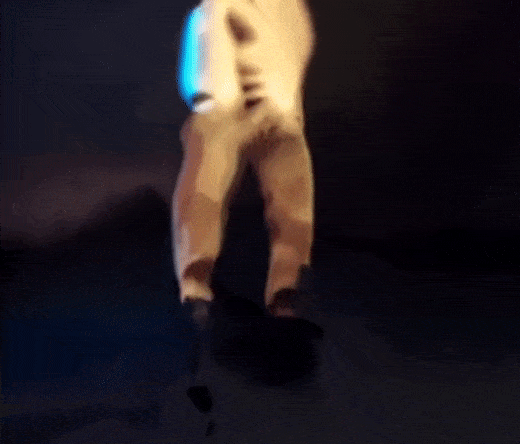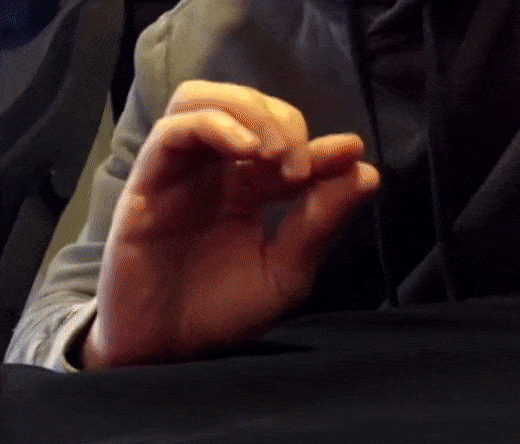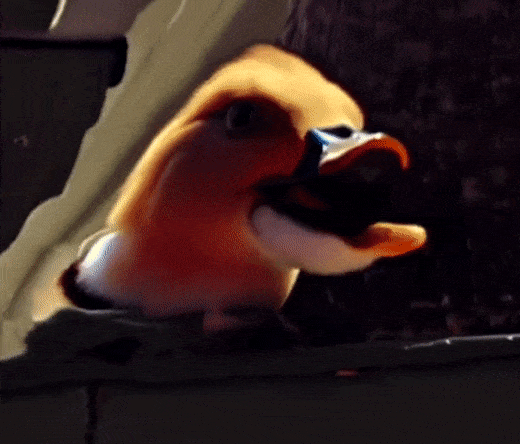
Пальці чоловіка перетворюються на ходячу людину та качку, завдяки Stable Diffusion та EbSynth. Джерело: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Користувач, який створив це відео відзначив, що перетворення качки, яке можна вважати більш ефективним, хоча й менш вражаючим та оригінальним, вимагало лише одного перетвореного ключового кадру, тоді як для створення ходячих штанів потрібно було згенерувати 50 зображень Stable Diffusion, які демонструють більшу неузгодженість у часі. Користувач також відзначив, що для досягнення сталості для кожного з 50 ключових кадрів потрібно було 5 спроб.
Отже, було б великою перевагою для повноцінної програми Stable Diffusion надати функціональність, яка зберігає характеристики до максимальної міри між ключовими кадрами.
Одна з можливостей полягає в тому, щоб дозволити користувачеві “заморозити” стохастичне кодування для перетворення на кожному кадрі, що зараз можна зробити лише шляхом модифікації вихідного коду вручну. Як приклад нижче показує, це сприяє часовій узгодженості, хоча це, безумовно, не вирішує її повністю:
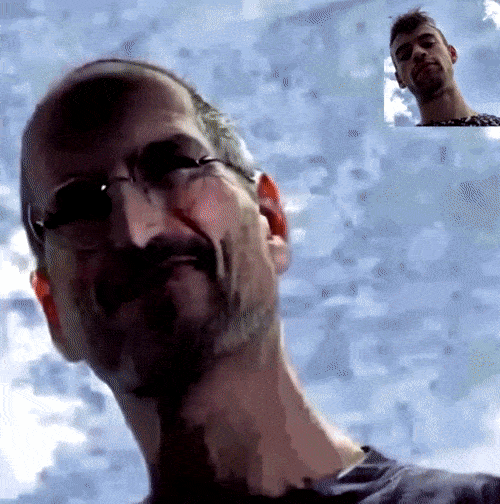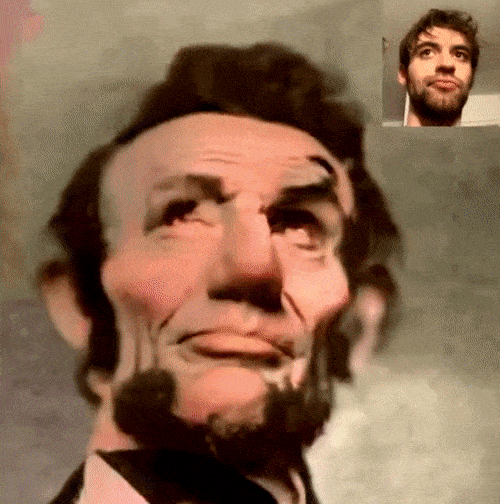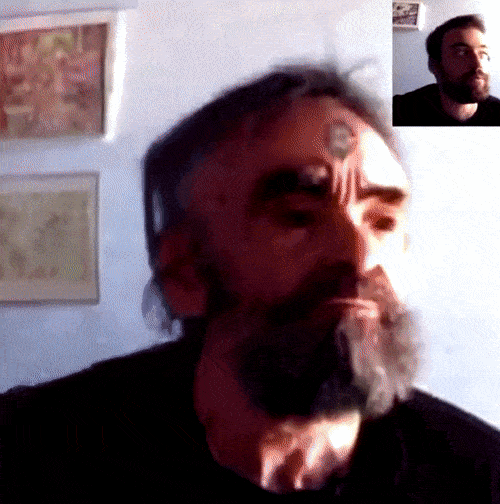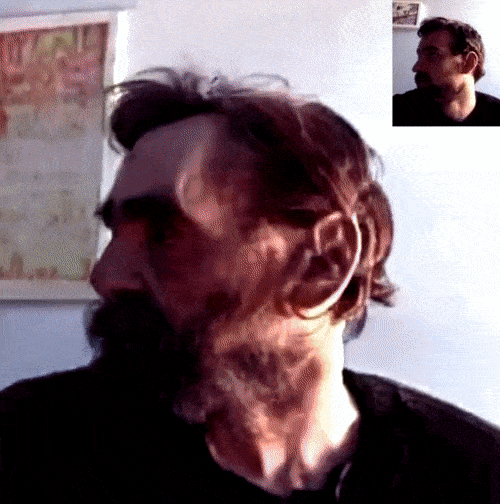
Один користувач Reddit перетворив відеозапис себе у різних знаменитих людей, не тільки зберігаючи значення seed (що може зробити будь-яка реалізація Stable Diffusion), але й забезпечуючи, щоб параметр stochastic_encode() був ідентичним у кожному перетворенні. Це було зроблено шляхом модифікації коду, але це могло б легко стати перемикачем, доступним для користувача. Чітко, однак, це не вирішує всі проблеми часової узгодженості. Джерело: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Хмарна текстова інверсія
Кращим рішенням для отримання узгоджених у часі персонажів та об’єктів є “запікання” їх у текстову інверсію – файл розміром 5 КБ, який можна натренувати за кілька годин на основі лише п’яти анотованих зображень, яке потім можна викликати спеціальною підказкою з “*“, що дозволяє, наприклад, постійний вигляд нових персонажів для включення в розповідь.

Зображення, пов’язані з відповідними тегами, можна перетворити на окремі сутності через текстову інверсію, і викликати їх без двозначності, і в правильному контексті та стилі, спеціальними токен-словами. Джерело: https://huggingface.co/docs/diffusers/training/text_inversion
Текстові інверсії – це додаткові файли до великої та повністю натренованої моделі, яку використовує Stable Diffusion, і фактично “запускаються” у процес виклику/підказки, так що вони можуть брати участь у сценах, виведених моделлю, і користуватися величезною базою знань моделі про об’єкти, стилі, середовища та взаємодії.
Однак, хоча текстову інверсію не займає багато часу для тренування, воно вимагає великої кількості відеопам’яті; згідно з різними поточними навчальними матеріалами, від 12, 20 і навіть 40 ГБ.
Оскільки більшість звичайних користувачів малоймовірно мають такий обсяг відеопам’яті, хмарні служби вже з’являються, які будуть виконувати цю операцію, включаючи версію Hugging Face. Хоча є реалізація Google Colab, яка може створювати текстові інверсії для Stable Diffusion, необхідні вимоги до відеопам’яті та часу можуть зробити це складним для користувачів безкоштовного рівня Colab.
Для потенційної повноцінної та добре інвестованої програми Stable Diffusion (інстальованої) здається очевидною стратегією монетизації передача цього важкого завдання на хмарні сервери компанії (припускаючи, що недорога або безкоштовна програма Stable Diffusion міститиме такі платні функції, що здається ймовірним у багатьох можливих застосуваннях, які виникнуть з цієї технології протягом наступних 6-9 місяців).
Крім того, досить складний процес анотації та форматування наданих зображень та тексту міг би виграти від автоматизації в інтегрованому середовищі. Потенційний “залежний фактор” створення унікальних елементів, які можуть досліджувати та взаємодіяти з величезними світами Stable Diffusion, міг би бути потенційно компульсивним, як для загальних ентузіастів, так і для молодих користувачів.
Гнучке вагове підсилювання підказок
Є багато поточних реалізацій, які дозволяють користувачеві призначити більшу вагу розділу довгої текстової підказки, але інструментарій варіюється досить сильно між ними, і часто є незручним або неінтуїтивним.
Наприклад, дуже популярний форк Stable Diffusion від AUTOMATIC1111 може знижувати або підвищувати значення слова підказки, оточуючи його однією або кількома парами круглих дужок (для зниження ваги) або квадратними дужками для додаткового підсилювання.

Квадратні дужки та/або дужки можуть перетворити ваш сніданок у цій версії вагових підсилювань Stable Diffusion, але це кошмар щодо холестерину в будь-якому разі.
Інші ітерації Stable Diffusion використовують знаки оклику для підсилювання, тоді як найбільш гнучкі дозволяють користувачеві призначати ваги кожному слову підказки через інтерфейс.
Система також мала б дозволяти від’ємні ваги підказок – не тільки для фанатів жахів, але тому, що можуть бути менш тривожні та більш освітні загадки в латентному просторі Stable Diffusion, ніж наша обмежена мова може викликати.
Розширення зображення за межі кадру
Відразу після сенсаційної відкриття джерел Stable Diffusion OpenAI спробувала – в основному марно – відновити частину свого блиску DALL-E 2, оголошуючи “розширення зображення за межі кадру”, які дозволяють користувачеві розширити зображення за його межами з семантичною логікою та візуальною узгодженністю.
Природно, це вже було реалізовано у різних формах для Stable Diffusion, а також у Krita, і повинно бути включено у повноцінну, подібну до Photoshop, версію Stable Diffusion.
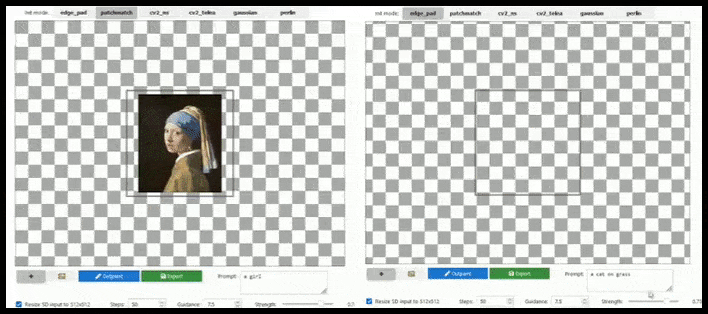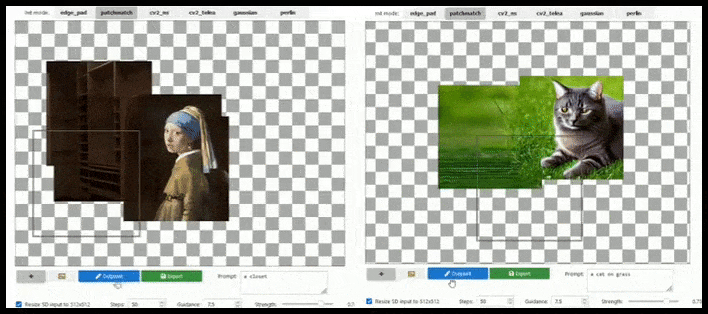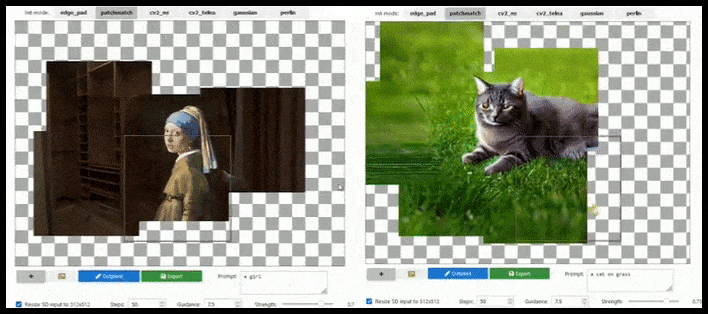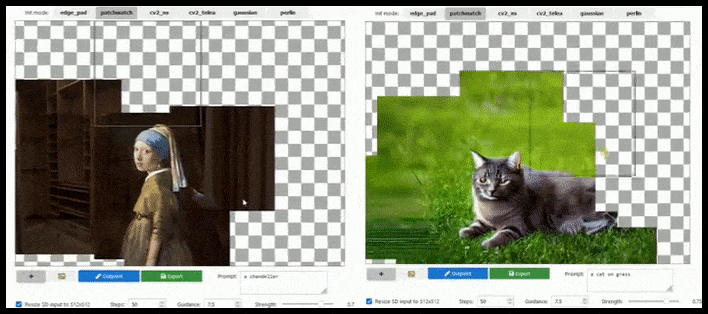
Тайлове розширення може розширити стандартну генерацію 512×512 пікселів майже нескінченно, поки підказки, існуюче зображення та семантична логіка допускають це. Джерело: https://github.com/lkwq007/stablediffusion-infinity
Оскільки Stable Diffusion тренується на зображеннях 512×512 пікселів (і з ряду інших причин), вона часто відрубує голови (або інші важливі частини тіла) людей, навіть коли підказка явно вказувала на “акцент на голові” тощо.

Типові приклади “обезголовлення” Stable Diffusion; але розширення зображення за межі кадру могли б повернути Джорджа у зображення.
Будь-яка реалізація розширення зображення за межі кадру такого типу, як показано на анімованому зображенні вище (яке засноване виключно на бібліотеках Unix, але повинно бути здатним бути відтвореним у Windows), також мала б бути засобом виправлення цієї проблеми одним натисканням або однією підказкою.
Наразі кілька користувачів розширюють полотно “обезголовлених” зображень вгору, приблизно заповнюють область голови, і використовують img2img, щоб завершити пошкоджену генерацію.
Ефективне маскування, яке розуміє контекст
Маскування може бути вкрай непередбачуваним у Stable Diffusion, залежно від форку або версії, яка використовується. Часто, де можливо створити суцільну маску, вказана область закінчується заповненою контентом, який не бере до уваги весь контекст зображення.
Одного разу я замаскував рогівки очей у зображенні обличчя, і надав підказку ‘сині очі’ як маску для заповнення – тільки щоб виявити, що я, здавалося, дивлюся через два вирізані людські очі на віддалений зображення неземного вовка. Гадаю, я щасливий, що це не був Френк Сінатра.
Семантичне редагування також можливе шляхом визначення шуму, який створив зображення спочатку, що дозволяє користувачеві звернутися до конкретних структурних елементів у рендерингу без втручання у решту зображення:

Зміна одного елемента у зображенні без традиційного маскування та без зміни сусіднього контенту, шляхом визначення шуму, який спочатку створив зображення, і звернення до частин, які внесли свій внесок у цільову область. Джерело: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Цей метод заснований на семплері K-Diffusion.
Семантичні фільтри для фізіологічних помилок
Як ми вже згадували раніше, Stable Diffusion часто може додати або видалити кінцівки, в основному через проблеми з даними та недоліки в анотаціях, які супроводжують зображення, на яких вона була тренована.

Як той неслухняний школяр, який висунув свій язик у шкільному груповому фото, біологічні звірства Stable Diffusion не завжди одразу помітні, і ви могли опублікувати свій останній ШІ-шедевр у Instagram, перш ніж ви помітите додаткові руки чи розтоплені кінцівки.
Це настільки складно виправити такі помилки, що було б корисно, якщо повноцінна програма Stable Diffusion містила б систему розпізнавання анатомічних структур, який використовував би семантичну сегментацію для розрахунку того, чи містить вхідне зображення серйозні анатомічні дефекти (як на зображенні вище), і відкидав би його на користь нового рендерингу, перш ніж показати його користувачеві.

Очевидно, ви могли б бажати згенерувати богиню Калі, або Доктора Восьминога, або навіть врятувати неушкоджену частину зображення з помилками в кінцівках. Тому така функція мала б бути опціональним перемикачем.
Якщо користувачі могли б терпіти аспект телеметрії, такі промахи могли б бути передані анонімно в колективній спробі федеративного навчання, яке могло б допомогти майбутнім моделям покращити своє розуміння анатомічної логіки.
Автоматичне покращення обличчя на основі LAION
Як я відзначав у своїй попередній статті про три речі, які Stable Diffusion міг би покращити в майбутньому, не повинно бути залишено винятково на GFPGAN спроби “поліпшити” згенеровані обличчя під час початкової генерації.
Покращення GFPGAN дуже загальні, часто підірвають ідентичність зображеного індивідуума та діють лише на обличчі, яке зазвичай уже згенеровано невдало, оскільки воно отримало не більше часу обробки чи уваги, ніж будь-яка інша частина зображення.
Отже, професійна програма для Stable Diffusion мала б бути здатною розпізнати обличчя (із стандартною та відносно легкою бібліотекою, такою як YOLO), застосувати повну силу доступної потужності GPU до пере-рендерингу його, і або об’єднати поліпшене обличчя з оригінальним рендерингом у повному контексті, або ж зберегти його окремо для ручної рекомпозиції. Наразі це досить операція, яка потребує значної ручної роботи.
У випадках, коли Stable Diffusion була тренована на достатній кількості зображень знаменитості, можливо зосередити всю потужність GPU на наступному рендерингу лише обличчя згенерованого зображення, яке зазвичай є помітним покращенням – і, на відміну від GFPGAN, це черпає інформацію з даних, тренованих на LAION, а не просто регулює згенеровані пікселі.
Пошуки LAION у програмі
Відразу після того, як користувачі почали розуміти, що пошук у базі даних LAION концепцій, людей та тем міг би допомогти у кращому використанні Stable Diffusion, було створено кілька онлайн-експлорерів LAION, включаючи haveibeentrained.com.

Функція пошуку на haveibeentrained.com дозволяє користувачам досліджувати зображення, які живлять Stable Diffusion, і виявити, чи були об’єкти, люди чи ідеї, які вони могли б хотіти викликати з системи, ймовірно, були в її навчальних даних. Такі системи також допомагають знаходити суміжні сутності, наприклад групи знаменитостей або «наступну ідею», до якої веде поточна. Джерело: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Хоча такі веб-базовані бази даних часто показують деякі теги, які супроводжують зображення, процес генералізації, який відбувається під час тренування моделі, означає, що малоймовірно, що будь-яке окреме зображення могло б бути викликано, використовуючи його тег як підказку.
Крім того, видалення ‘стоп-слів’ і практика стеммінгу та лемматизації у обробці природної мови означають, що багато фраз, показаних тут, були розбиті або опущені перед тим, як бути тренованими у Stable Diffusion.
Однак спосіб, яким естетичних групування зв’язуються в цих інтерфейсах, може навчити кінцевого користувача багато чого про логіку (або, можливо, “особистість”) Stable Diffusion і стати допоміжним засобом для кращої генерації зображень.
Висновок
Є багато інших функцій, які я хотів би бачити у повноцінній настільній реалізації Stable Diffusion, таких як вбудований аналіз зображень на основі CLIP, який обертає стандартний процес Stable Diffusion і дозволяє користувачеві викликати фрази та слова, які система природно асоціює з вихідним зображенням, або рендерингом.
Крім того, справжнє тайлове масштабування було б бажаним доповненням, оскільки ESRGAN майже так же тупий інструмент, як і GFPGAN. На щастя, плани інтегрувати реалізацію GOBIG — txt2imghd швидко роблять це реальністю по всім розподілам, і це здається очевидним вибором для настільної ітерації.
Деякі інші популярні прохання з спільнот Discord мене менше цікавлять, такі як інтегровані словники підказок та переліки художників та стилів, хоча вбудований блокнот або настраїваний лексикон фраз здається логічним доповненням.
Однак поточні обмеження людської анімації у Stable Diffusion, хоча й запущені CogVideo та іншими проектами, залишаються неймовірно молодими, і залежать від досліджень у сфері апріорних закономірностей справжнього руху людини в часі.
Наразі відео Stable Diffusion суворо психоделічне, хоча воно може мати яскраве найближче майбутнє у дипфейковому ляльководі через EbSynth та інші відносно молоді текст-відео-ініціативи (і варто відзначити відсутність синтезованих чи “змінених” людей у останньому промо-відео Runway).
Інша цінна функціональність була б прозорим проходом Photoshop, який вже давно встановлений у редакторі текстур Cinema4D, серед інших подібних реалізацій. З цим ви можете легко перекидувати зображення між застосунками та використовувати кожну програму для виконання перетворень, які вона виконує найкраще.
Нарешті, і, можливо, найважливіше, повноцінна програма Stable Diffusion мала б бути здатною не тільки легко перемикатися між контрольними точками (тобто версіями моделі, яка живить систему), але й оновлювати спеціальні текстові інверсії, які працювали з попередніми офіційними випусками моделі, але можуть бути зламані пізнішими версіями моделі (як вказали розробники на офіційному Discord).
Іронічно, організація, яка знаходиться у найкращій позиції для створення такої потужної та інтегральної матриці інструментів для Stable Diffusion, Adobe, так сильно пов’язана з ініціативою Content Authenticity, що це могло б здатися ретроградним кроком PR для компанії – якщо тільки вони не збираються суттєво обмежити генеративні сили Stable Diffusion, як це зробила OpenAI з DALL-E 2, і позиціонувати її як природну еволюцію своїх великої колекції стокових фотографій.
Перша публікація 15 вересня 2022 року.


