
Погляд Anderson
Три виклики, які стоять перед Stable Diffusion

 Додайте Unite.AI до бажаних джерел у Google
Ключові моментиStable Diffusion має проблеми з відтворенням людських кінцівок через недостатньо…
Показати більше
- Stable Diffusion має проблеми з відтворенням людських кінцівок через недостатньо детальні анотації в навчальних даних.
- Поблочні методи збільшення роздільної здатності ризикують створювати розрізнені зображення через відсутність ширшого контекстуального охоплення.
- Власна роздільна здатність моделі 512x512 обмежує якість результату та вимагає складних обхідних рішень.
Випуск моделі синтезу зображень Stable Diffusion компанії stability.ai на основі латентної дифузії кілька тижнів тому може бути одним з найважливіших технологічних відкриттів з часів DeCSS у 1999 році; це, безумовно, найбільша подія в галузі генерації зображень за допомогою штучного інтелекту з 2017 року, коли код глибоких фейків був скопійований на GitHub і розгалужений у те, що стало DeepFaceLab і FaceSwap, а також програмне забезпечення для стрімінгу глибоких фейків у реальному часі DeepFaceLive.
Відразу ж розчарування користувачів через обмеження контенту в API синтезу зображень DALL-E 2 було усунено, оскільки виявилося, що фільтр NSFW у Stable Diffusion можна вимкнути, змінивши один рядок коду. Появилися порно-орієнтовані спільноти Stable Diffusion на Reddit, але їх швидко закрили, тоді як розробники та користувачі розділилися на офіційні та NSFW-спільноти на Discord, а Twitter почав заповнюватися фантастичними творами Stable Diffusion.
На даний момент кожен день приносить якісь нововведення від розробників, які прийняли систему, із плагінами та сторонніми доповненнями, які швидко написані для Krita, Photoshop, Cinema4D, Blender та багатьох інших платформ.
Тим часом promptcraft – тепер професійне мистецтво «шептання штучному інтелекту», яке може стати найкоротшим варіантом кар’єри після «Filofax binder» – вже комерціалізується, тоді як перша монетизація Stable Diffusion відбувається на рівні Patreon, з певністю майбутніх більш складних пропозицій для тих, хто не хоче орієнтуватися в Conda-інсталляціях вихідного коду або обмежувальних фільтрах NSFW веб-орієнтованих реалізації.
Темп розвитку та вільне дослідження з боку користувачів відбувається з такою дезорієнтуючою швидкістю, що важко бачити далеко вперед. Насправді, ми ще не знаємо, з чим ми справляємося, або які обмеження чи можливості можуть бути.
Відтак, давайте розглянемо три з найбільш цікавих і складних перешкод для спільноти Stable Diffusion, яка швидко утворилася та швидко зростає, щоб подолати їх.
1: Оптимізація процесів обробки на основі тайлів
При обмежених апаратних ресурсах та жорстких обмеженнях на роздільну здатність тренувальних зображень, ймовірно, розробники знайдуть обходи для покращення якості та роздільної здатності виходу Stable Diffusion. Багато цих проектів будуть включати в себе використання обмежень системи, таких як її вбудована роздільна здатність всього 512×512 пікселів.
Як завжди буває у випадках комп’ютерного бачення та ініціатив синтезу зображень, Stable Diffusion була тренована на квадратних зображеннях, у цьому випадку повторно дискретизованих до 512×512 пікселів, щоб джерельні зображення могли бути регуляризовані та вміщені у обмеження GPU, які тренували модель.
Отже, Stable Diffusion «думає» (якщо вона думає взагалі) у термінах 512×512, і, безумовно, у квадратних термінах. Багато користувачів, які зараз досліджують межі системи, повідомляють, що Stable Diffusion дає найбільш надійні та найменш глючеві результати при цій досить обмеженій пропорції сторін (див. «вирішення проблем із кінцівками» нижче).
Хоча різні реалізації включають апскейлінг через RealESRGAN (і можуть виправити погано відтворені обличчя через GFPGAN), декілька користувачів зараз розробляють методи для розбиття зображень на секції 512×512 пікселів та зшивання зображень разом для формування більших композитних робіт.

Це зображення 1024×576, роздільна здатність, яка зазвичай неможлива в одному рендерінгу Stable Diffusion, було створено шляхом копіювання та вставлення файлу attention.py з форку DoggettX Stable Diffusion (версії, яка реалізує тайлове апскейлінг) у інший форк. Джерело: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Хоча деякі ініціативи цього типу використовують оригінальний код або інші бібліотеки, порт txt2imghd GOBIG (режим у ProgRockDiffusion, який голодний до VRAM) має надати цю функціональність основній гілці незабаром. Хоча txt2imghd є спеціальним портом GOBIG, інші зусилля спільноти розробників включають різні реалізації GOBIG.

Зручно абстрактне зображення в оригінальному рендерінгу 512×512 пікселів (ліворуч і другий зліва); апскейлінг через ESGRAN, який тепер більш-менш рідний для всіх розподілів Stable Diffusion; і наданий «спеціальна увага» через реалізацію GOBIG, який дає деталі, які, принаймні в межах секції зображення, здаються краще апскейленими. Джерело: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Такий абстрактний приклад, представлений вище, має багато «маленьких королівств» деталей, які підходять для цього соліпсистичного підходу до апскейлінгу, але які можуть потребувати більш складних кодових рішень для отримання неповторюваного, цілісного збільшення, яке не виглядатиме так, як якщо б він був зібраний з багатьох частин. Не в останню чергу, у випадку з людськими обличчями, де ми надзвичайно чутливі до аномалій або помітно неприродних артефактів. Отже, обличчя можуть потребувати спеціального рішення.
Stable Diffusion зараз не має механізму для фокусування уваги на обличчі під час рендерінгу так само, як люди пріоритезують інформацію про обличчя. Хоча деякі розробники у спільнотах Discord розглядають методи реалізації цього типу «підвищеної уваги», зараз це значно легше вручну (та, врешті-решт, автоматично) покращити обличчя після першого рендерінгу.
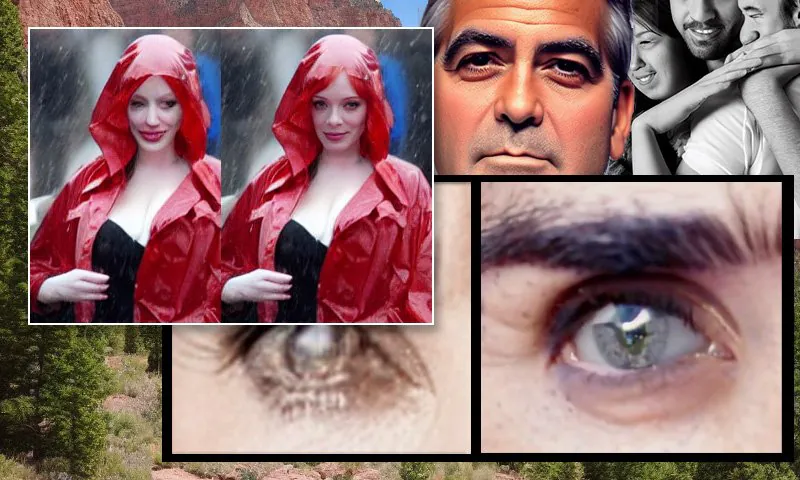
Людське обличчя має внутрішню та повну семантичну логіку, якої не буде у «тайлі» нижнього кута, наприклад, будівлі, і тому зараз це можливо дуже ефективно «зумувати» та повторно рендерити схематичне обличчя у виводі Stable Diffusion.

Ліворуч, перша спроба Stable Diffusion з промптом «Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail». Праворуч, покращене обличчя, отримане шляхом введення розмитого та «скіцюватого» обличчя з першого рендерингу назад у повну увагу Stable Diffusion за допомогою Img2Img (див. анімовані зображення нижче).
У відсутності спеціального рішення Textual Inversion (див. нижче), це працюватиме лише для знаменитих осіб, які вже добре представлені у підмножинах даних LAION, які тренували Stable Diffusion. Отже, це працюватиме для таких осіб, як Том Круз, Бред Пітт, Дженніфер Лоуренс, та обмеженого діапазону справжніх медійних знаменитостей, які присутні у великій кількості зображень у джерельних даних.
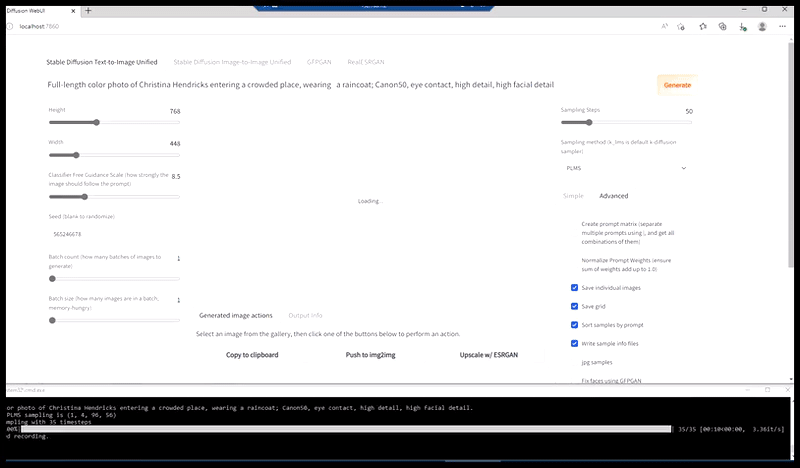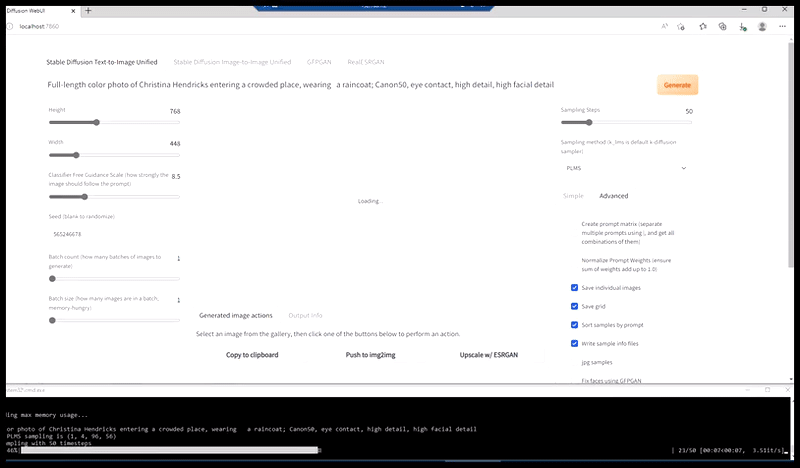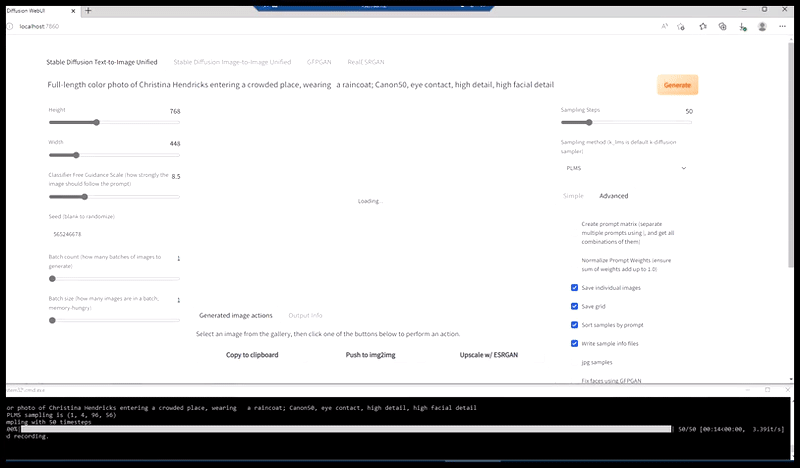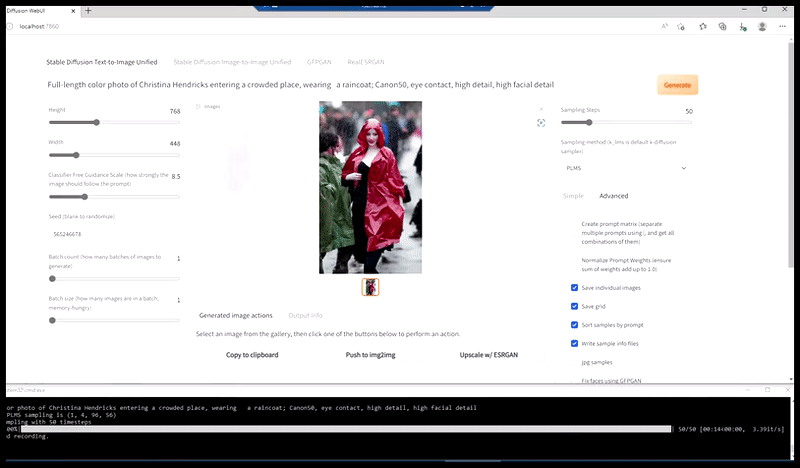
Генерація правдоподібного прес-фото з промптом «Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail».
Для знаменитостей з довгими та тривалими кар’єрами Stable Diffusion зазвичай генерує зображення особи у більш пізньому (тобто старшому) віці, і буде необхідно додати промпт-додатки, такі як ‘young’ або ‘in the year [YEAR]’, щоб отримати молодші зображення.

З акторкою Дженніфер Коннеллі, яка має видатну, добре сфотографовану та послідовну кар’єру майже 40 років, Stable Diffusion може представити діапазон віків. Джерело: попередня версія Stable Diffusion, локальна, v1.4 чекпойнт; промпти, пов’язані з віком.
Це в основному через поширення цифрової (а не дорогої, емульсійної) прес-фотографії з середини 2000-х років та пізнішнього зростання обсягу зображень через збільшення швидкості широкосмугового доступу до Інтернету.
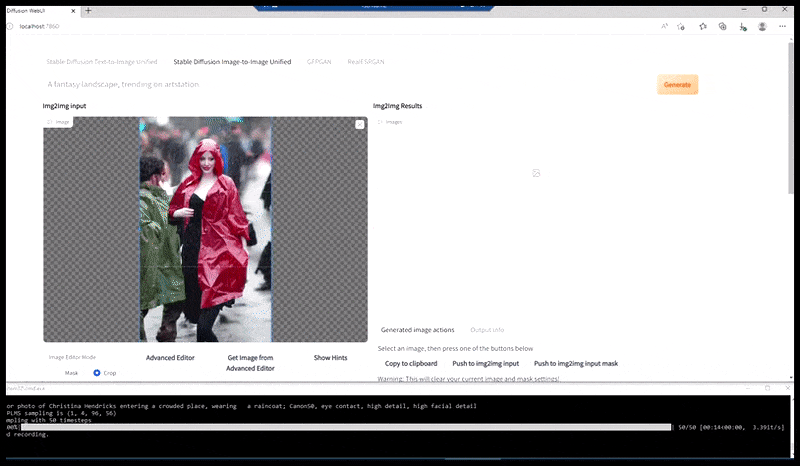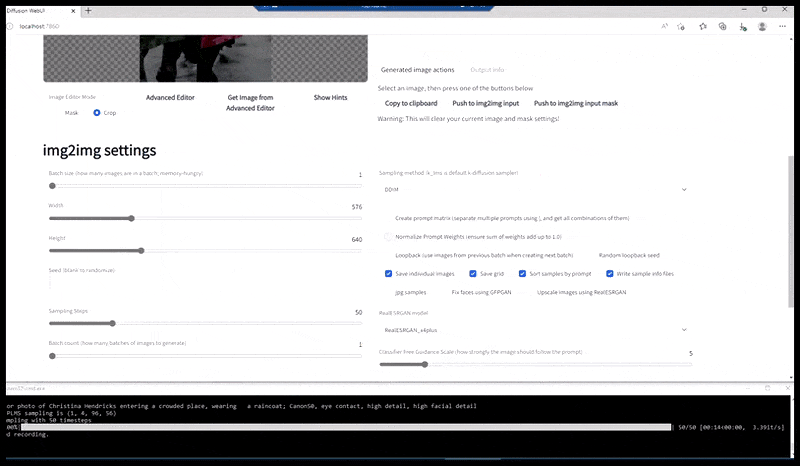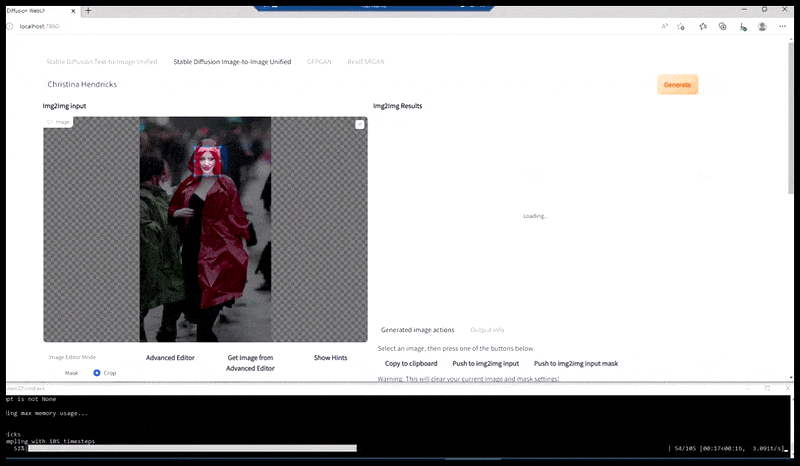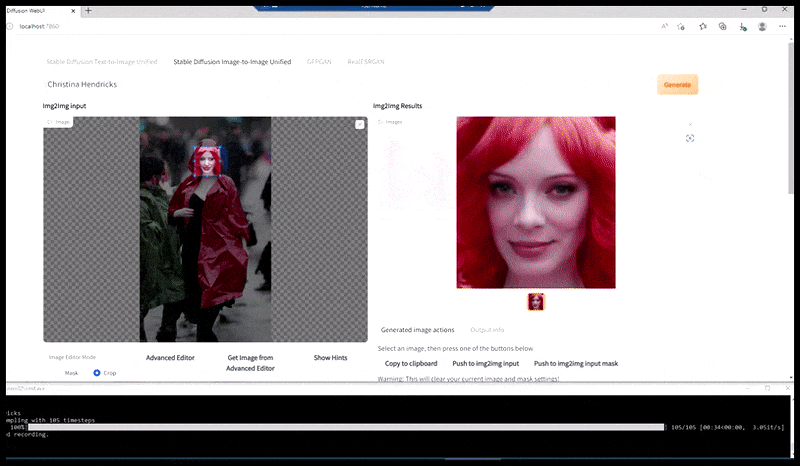
Відтворене зображення передається до Img2Img у Stable Diffusion, де вибирається «область фокусу», і створюється новий рендер максимального розміру лише цієї області, що дозволяє Stable Diffusion зосередити всі доступні ресурси на відновленні обличчя.
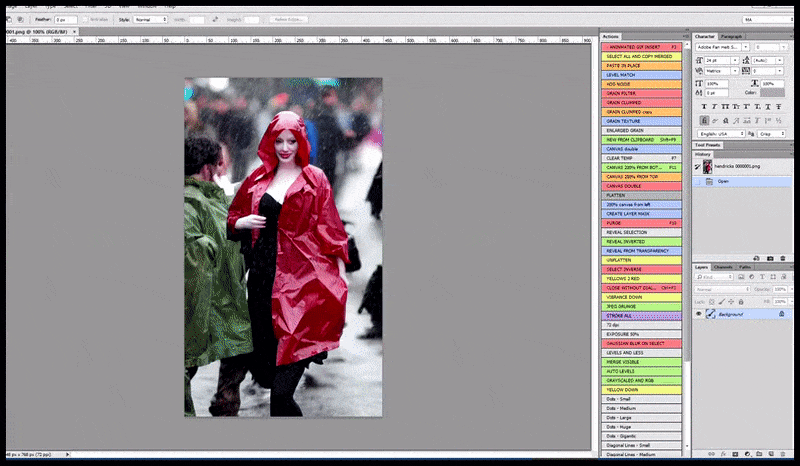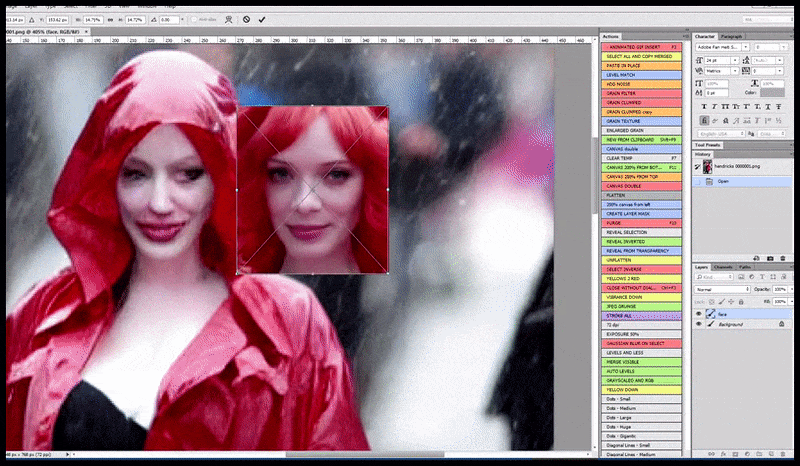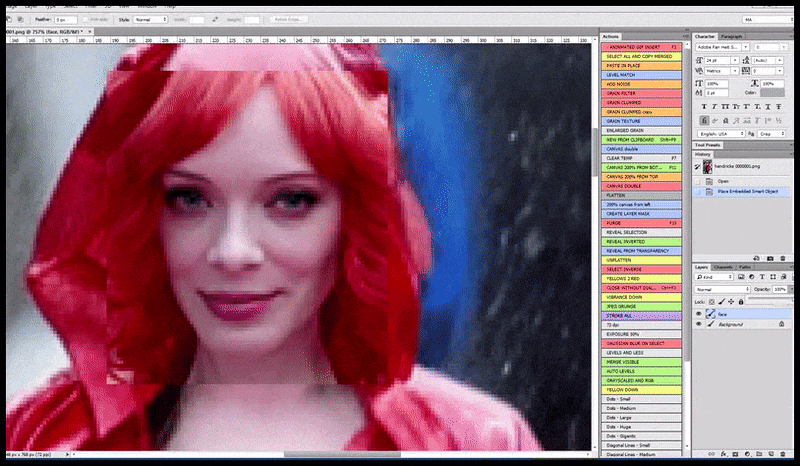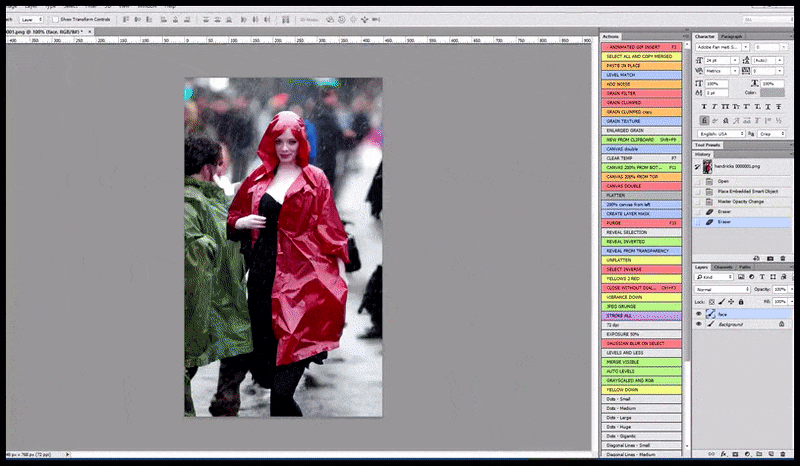
Композит «високої уваги» обличчя назад у оригінальний рендер. Окрім обличчя, цей процес працюватиме лише з об’єктами, які мають потенційно відомий, цілісний та інтегральний вигляд, такий як частина оригінальної фотографії, яка має відмінний об’єкт, такий як годинник або автомобіль. Апскейлінг секції, наприклад, стіни, призведе до дуже дивного відновленого вигляду стіни, оскільки тайлові рендеринги не мали ширшого контексту для цієї «пазли» під час рендерингу.
Деякі знаменитості у базі даних приходять «замороженими» у часі, або через те, що вони померли рано (наприклад, Мерилін Монро), або через те, що вони досягли лише короткочасної широкої популярності, виробивши велику кількість зображень за обмежений період часу. Опитування Stable Diffusion можна вважати певним видом «поточної» популярності для сучасних та старих зірок. Для деяких старих та сучасних знаменитостей немає достатньої кількості зображень у джерельних даних, щоб отримати дуже хорошу схожість, тоді як тривала популярність певних давно померлих зірок або тих, хто зник із публічного поля забезпечує можливість отримання їхньої розумної схожості з системи.

Рендеринги Stable Diffusion швидко показують, які відомі обличчя добре представлені у тренувальних даних. Незважаючи на її величезну популярність як старшої підлітка на момент написання, Міллі Боббі Браун була молодшою та менш відомою, коли джерельні дані LAION були зібрані з Інтернету, що робить отримання високоякісної схожості з Stable Diffusion проблематичним на даний момент.
Коли дані доступні, тайлові апскейл-рішення у Stable Diffusion можуть піти далі, ніж зосередження уваги на обличчі: вони можуть потенційно дозволити отримання ще більш точних та детальних облич, розбиваючи особливості обличчя та зосереджуючи всю силу локальних GPU-ресурсів на окремих особливостях окремо, перед зібранням – процес, який зараз знову є ручним.

Це не обмежується обличчями, але обмежується частинами об’єктів, які принаймні так само передбачувано розміщені у ширшому контексті вихідного об’єкта, і які відповідають високорівневим вкладенням, які можна розумно очікувати знайти у гіпермасштабній базі даних.
Реальна межа полягає у кількості доступних джерельних даних у базі даних, оскільки, врешті-решт, глибоко ітеровані деталі стають повністю «галюцинованими» (тобто вигаданими) та менш автентичними.
Такі високорівневі гранульовані збільшення працюють у випадку Дженніфер Коннеллі, оскільки вона добре представлена у різних віках у LAION-aesthetics (основній підмножині LAION 5B, яку використовує Stable Diffusion), і загалом у LAION; у багатьох інших випадках точність буде страждати через нестачу даних, що потребуватиме або тонкого налаштування (додаткового навчання, див. «Кастомізація» нижче), або Textual Inversion (див. нижче).
Тайли — потужний і відносно дешевий спосіб для отримання від Stable Diffusion результатів високої роздільної здатності, але алгоритмічне тайлове апскейлінг цього типу, якщо воно не має певного виду вищого рівня уваги, може не досягти бажаних стандартів у діапазоні типів контенту.
2: Вирішення проблем з людськими кінцівками
Stable Diffusion не виправдовує свого імені при зображенні складності людських кінцівок. Руки можуть множитися випадково, пальці зливаються, з’являються треті ноги без попередження, а існуючі кінцівки зникають без сліду. У свою захист, Stable Diffusion поділяє цю проблему з іншими подібними моделями, і, безумовно, з DALL-E 2.

Нередактовані результати DALL-E 2 та Stable Diffusion (1.4) на кінці серпня 2022 року, обидва показують проблеми з кінцівками. Промпт: ‘A woman embracing a man’
Фани Stable Diffusion, які сподіваються, що майбутня точка контролю 1.5 (більш інтенсивно тренована версія моделі з покращеними параметрами) вирішить проблему кінцівок, ймовірно, будуть розчаровані. Нова модель, яка буде випущена через близько двох тижнів, зараз представляється на комерційному порталі DreamStudio stability.ai, який використовує 1.5 за замовчуванням, і де користувачі можуть порівняти новий вивід з рендерами з їхніх локальних або інших 1.4 систем:

Джерело: локальна 1.4 prepack та https://beta.dreamstudio.ai/

Джерело: локальна 1.4 prepack та https://beta.dreamstudio.ai/

Джерело: локальна 1.4 prepack та https://beta.dreamstudio.ai/
Як часто буває, якість даних може бути основною причиною.
Відкриті бази даних, які живлять системи синтезу зображень, такі як Stable Diffusion та DALL-E 2, можуть надавати багато міток для окремих людей та міжлюдських дій. Ці мітки тренуються разом з їхніми пов’язаними зображеннями або сегментами зображень.

Користувачі Stable Diffusion можуть досліджувати концепції, треновані у моделі, запитуючи набір LAION-aesthetics, підмножину більшого набору LAION 5B, що забезпечує систему даними. Зображення впорядковані не за алфавітними мітками, а за «естетичним баллом». Джерело: https://rom1504.github.io/clip-retrieval/
Хороша ієрархія індивідуальних міток та класів, які сприяють зображенню людської руки, буде щось на зразок тіло>рука>кисть>пальці> [підпальці + великий палець] > [сегменти пальців] > Нігті.

Гранульована семантична сегментація частин руки. Навіть ця незвичайно детальна деконструкція залишає кожний «палець» як єдину сутність, не беручи до уваги три секції пальця та дві секції великого пальця. Джерело: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
На ділі джерельні зображення малоймовірно будуть так само послідовно анотовані по всій базі даних, і алгоритми анотації без нагляду, ймовірно, зупиняться на вищому рівні – наприклад, «рука», і залишать внутрішні пікселі (які технічно містять інформацію про «пальці») як неназвану масу пікселів, з якої будуть довільно виводитися особливості, які можуть проявитися у пізніших рендерах як помітно неприродний елемент.

Як повинно бути (праворуч зверху, якщо це не аперкот), і як воно схильне бути (праворуч знизу), через обмежені ресурси для анотації або архітектурне використання таких міток, якщо вони існують у базі даних.
Отже, якщо модель латентної дифузії досягає рівня рендерингу руки, вона майже напевно спробує рендерити кисть на кінці цієї руки, оскільки рука>кисть — це мінімальна необхідна ієрархія, досить високо у тому, що архітектура знає про «людську анатомію».
Після цього «пальці» можуть бути найменшим угрупованням, хоча існує ще 14 додаткових частин пальців і великого пальця, які потрібно враховувати при зображенні людських рук.
Якщо ця теорія тримається, то немає реального засобу, через галузеву нестачу бюджету на ручну анотацію, і нестачу достатньо ефективних алгоритмів, які могли б автоматизувати анотацію при низьких рівнях помилок. Насправді, модель може зараз покладатися на людську анатомічну послідовність, щоб прикрити недоліки бази даних, на якій вона була тренована.
Одна з можливих причин, чому вона не може покладатися на це, недавно пропонована на Discord Stable Diffusion, полягає в тому, що модель могла стати плутаною щодо правильної кількості пальців у людській руці, оскільки база даних LAION, яка живить її, містить мультяшні персонажі, яким можуть бути менше пальців (що є самим по собі способом заощадити працю).

Два потенційних винуватців «синдрому відсутнього пальця» у Stable Diffusion та подібних моделях. Нижче, приклади мультяшних рук з бази даних LAION-aesthetics, яку живить Stable Diffusion. Джерело: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Якщо це правда, то єдиним очевидним рішенням є повторна тренування моделі, виключивши нереалістичний контент, засвідчуючи, що справжні випадки пропуску (тобто ампутанти) будуть належним чином помічені як винятки. З точки зору кураторства даних це буде досить складним завданням, особливо для спільнот з обмеженими ресурсами.
Другий підхід полягає у застосуванні фільтрів, які виключають такий контент (наприклад, «рука з трьома/п’ятьма пальцями») з прояву під час рендерингу, так само, як OpenAI, до певної міри, фільтрує GPT-3 та DALL-E 2, щоб їхній вивід міг бути регулюємим без потреби повторної тренування вихідних моделей.

Для Stable Diffusion семантична відмінність між пальцями та навіть кінцівками може стати жахливо розмитою, нагадуючи напрям «боді-горор» у фільмах жахів 1980-х років від таких режисерів, як Девід Кроненберг. Джерело: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Однак знову ж таки, це буде вимагати міток, яких може не існувати для всіх відповідних зображень, залишаючи нас із тією ж логістичною та бюджетною проблемою.
Можна сказати, що залишаються два шляхи вперед: кидання ще більше даних на проблему та застосування сторонніх інтерпретативних систем, які можуть втрутитися, коли фізичні помилки типу, описаних тут, представляються кінцевому користувачеві (хоча б це дало б OpenAI метод для надання повернень за рендери в стилі «боді-горор», якщо компанія була мотивована зробити це).
3: Кастомізація
Одна з найбільш цікавих можливостей для майбутнього Stable Diffusion — це перспектива розробки користувачами чи організаціями змінених систем; модифікацій, які дозволяють інтегрувати контент поза попередньо тренованою сферою LAION — ідеально без непідконтрольної витрати повторної тренування всієї моделі знову, або ризику, пов’язаного з тренуванням великої кількості нових зображень у вже сформовану та здатну модель.
За аналогією: якщо два менш талановиті учні вступають до класу з 30 учнів, вони або асімілюються та доганяють, або провалюються як аутсайдери; у будь-якому випадку середній рівень виконання класу, ймовірно, не буде суттєво порушений. Якщо 15 менш талановитих учнів вступають, проте, крива оцінок для всього класу, ймовірно, буде страждати.
Аналогічно, синергетична та досить делікатна мережа відносин, які будуються протягом тривалої та дорогої тренування моделі, можуть бути скомпрометовані, у деяких випадках фактично знищені, надмірними новими даними, знижуючи якість виводу моделі в цілому.
Виникає випадок для здійснення цього, перш за все, коли ваш інтерес полягає у повному викраденні концептуального розуміння моделі відносин та речей, і привласненні її виключно для виробництва контенту, подібного до додаткового матеріалу, який ви додали.
Отже, тренування 500 000 кадрів «Сімпсонів» у існуючий чекпойнт Stable Diffusion, ймовірно, дасть вам кращий «сімпсонівський» симулятор, ніж оригінальна збірка могла б запропонувати, припускаючи, що достатньо широких семантичних відносин виживе під час цього процесу (тобто Гомер Сімпсон їсть хот-дог, який може потребувати матеріалу про хот-доги, яких не було у вашому додатковому матеріалі, але вони вже існували у чекпойнті), і припускаючи, що ви не хочете раптово перейти від контенту «Сімпсонів» до створення «фантастичних пейзажів Ґреґа Рутковського» — оскільки ваша післятренувальна модель мала свою увагу масивно відвернуту, і не буде такою хорошою у створенні такого типу контенту, як раніше.
Одним з помітних прикладів цього є waifu-diffusion, який успішно післятренував 56 000 аніме-зображень у завершений та тренований чекпойнт Stable Diffusion. Це складна перспектива для хобіста, проте, оскільки модель вимагає мінімум 30 ГБ VRAM, що значно перевищує те, що, ймовірно, буде доступно на споживчому рівні у майбутніх випусках серії 40XX від NVIDIA.

Тренування користувальницького контенту у Stable Diffusion через waifu-diffusion: модель зайняла дві тижні післятренування, щоб вивести цей рівень ілюстрації. Шість зображень ліворуч показують прогрес моделі у створенні предметно-співвідносних виводів на основі нових тренувальних даних. Джерело: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Багато зусиль можуть бути витрачені на такі «форки» чекпойнтів Stable Diffusion, лише щоб бути зупиненими технічним боргом. Розробники на офіційному Discord вже зазначили, що пізніші випуски чекпойнтів можуть не бути сумісними навіть з логікою промптів, яка працювала з попередньою версією, оскільки їхній основний інтерес полягає у отриманні найкращої моделі, а не у підтримці спадкових застосунків та процесів.
Отже, компанія чи особа, яка вирішує відгалужити чекпойнт у комерційний продукт, фактично не має шляху назад; їхня версія моделі є «жорстким форком», і не зможе отримати вигоди з пізніших випусків від stability.ai — що є досить серйозним зобов’язанням.
Поточна, і більша, надія на кастомізацію Stable Diffusion полягає у Textual Inversion, де користувач тренує кілька узгоджених із CLIP зображень.

Спільна робота Тель-Авівського університету та NVIDIA, текстова інверсія дозволяє тренувати окремі та нові сутності, не знищуючи можливостей вихідної моделі. Джерело: https://textual-inversion.github.io/
Основне очевидне обмеження текстової інверсії полягає у тому, що рекомендується дуже мала кількість зображень — можливо лише п’ять. Це фактично створює обмежену сутність, яка може бути більш корисною для завдань стильового переносу, ніж для вставки фотореалістичних об’єктів.
Однак експерименти зараз проводяться у різних спільнотах Stable Diffusion, які використовують значно більшу кількість тренувальних зображень, і залишається побачити, наскільки продуктивним цей метод може бути. Знову ж таки, ця техніка вимагає великої кількості VRAM, часу та терпіння.
Через ці обмежувальні фактори нам, можливо, доведеться чекати деякий час, щоб побачити деякі з більш складних експериментів з текстовою інверсією від ентузіастів Stable Diffusion — і чи зможе цей підхід «помістіти вас у зображення» у спосіб, який виглядатиме краще, ніж вирізання у Photoshop, зберігаючи при цьому неймовірну функціональність офіційних чекпойнтів.
Перша публікація 6 вересня 2022 року.


