
มุมมองของ Anderson
สามความท้าทายที่รออยู่ข้างหน้าสำหรับ Stable Diffusion

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ประเด็นสำคัญStable Diffusion มีข้อจำกัดในการสร้างอวัยวะมนุษย์…
ดูเพิ่มเติม
- Stable Diffusion มีข้อจำกัดในการสร้างอวัยวะมนุษย์ เนื่องจากข้อมูลฝึกฝนมีคำอธิบายรายละเอียดไม่ละเอียดเพียงพอ
- วิธีการขยายภาพแบบแบ่งส่วนเสี่ยงทำให้ภาพขาดความต่อเนื่อง เนื่องจากโมเดลขาดความเข้าใจบริบทโดยรวม
- ความละเอียดพื้นฐาน 512x512 ของโมเดลจำกัดคุณภาพผลลัพธ์ และต้องใช้เทคนิคแก้ไขที่ซับซ้อน
การ เปิดตัว โมเดลสังเคราะห์ภาพ Stable Diffusion ของ stability.ai ซึ่งใช้เทคนิค latent diffusion เมื่อสองสามสัปดาห์ก่อน อาจเป็นหนึ่งในการเปิดเผยเทคโนโลยีครั้งสำคัญที่สุด นับตั้งแต่ DeCSS ในปี 1999 และแน่นอนว่าเป็นเหตุการณ์ใหญ่ที่สุดในวงการภาพที่สร้างด้วย AI นับตั้งแต่ โค้ด deepfakes ถูกคัดลอกไปยัง GitHub ในปี 2017 และแยกพัฒนาเป็นซอฟต์แวร์ที่ต่อมากลายเป็น DeepFaceLab และ FaceSwapรวมถึงซอฟต์แวร์ deepfake สำหรับการสตรีมแบบเรียลไทม์ DeepFaceLive.
ในพริบตาเดียว ความหงุดหงิดของผู้ใช้ เกี่ยวกับ ข้อจำกัดด้านเนื้อหา ของ API สังเคราะห์ภาพ DALL-E 2 ก็หมดไป เมื่อพบว่าปิดตัวกรองเนื้อหา NSFW ของ Stable Diffusion ได้โดยแก้ไขโค้ดเพียง บรรทัดเดียว. ชุมชน Reddit เกี่ยวกับ Stable Diffusion ที่เน้นสื่อลามกเกิดขึ้นแทบจะทันทีและถูกปิดลงอย่างรวดเร็ว ขณะที่นักพัฒนาและผู้ใช้บน Discord แบ่งออกเป็นชุมชนอย่างเป็นทางการและชุมชน NSFW และ Twitter เริ่มเต็มไปด้วยผลงานจินตนาการอันน่าทึ่งจาก Stable Diffusion
ขณะนี้แทบทุกวันดูเหมือนจะมีนวัตกรรมที่น่าทึ่งจากนักพัฒนาที่นำระบบนี้ไปใช้ มีการเร่งเขียนปลั๊กอินและส่วนเสริมจากบุคคลภายนอกสำหรับ Krita, Photoshop, Cinema4D, Blender, และแพลตฟอร์มแอปพลิเคชันอื่น ๆ อีกมากมาย
ในขณะเดียวกัน ศิลปะการเขียนพรอมต์ หรือศิลปะการเป็น “ผู้กระซิบกับ AI” ซึ่งขณะนี้กลายเป็นอาชีพแล้ว และอาจเป็นทางเลือกอาชีพที่มีอายุสั้นที่สุดนับตั้งแต่อาชีพ “ผู้จัดแฟ้ม Filofax” ก็กำลังถูก นำไปทำธุรกิจแล้ว ขณะที่การหารายได้จาก Stable Diffusion ในระยะแรกเกิดขึ้นใน ระดับ Patreon โดยแน่นอนว่าจะมีบริการที่ซับซ้อนยิ่งขึ้นตามมา สำหรับผู้ที่ไม่ต้องการจัดการ การติดตั้งผ่าน Conda จากซอร์สโค้ด หรือตัวกรอง NSFW ที่เข้มงวดของบริการผ่านเว็บ
การพัฒนาและการสำรวจอย่างอิสระของผู้ใช้กำลังเดินหน้าอย่างรวดเร็วจนมองอนาคตได้ไม่ไกลนัก โดยพื้นฐานแล้ว เรายังไม่ทราบแน่ชัดว่ากำลังเผชิญกับอะไร หรือข้อจำกัดและความเป็นไปได้ทั้งหมดคืออะไร
อย่างไรก็ตาม มาดูอุปสรรคสามประการที่อาจน่าสนใจและท้าทายที่สุด ซึ่งชุมชน Stable Diffusion ที่ก่อตัวและเติบโตอย่างรวดเร็วจะต้องเผชิญและหวังว่าจะเอาชนะได้
1: การปรับปรุงกระบวนการประมวลผลภาพแบบแบ่งไทล์
เมื่อทรัพยากรฮาร์ดแวร์มีจำกัด และความละเอียดของภาพฝึกมีเพดานที่แน่นอน นักพัฒนาน่าจะหาวิธีอ้อมเพื่อปรับปรุงทั้งคุณภาพและความละเอียดของผลลัพธ์จาก Stable Diffusion ได้ หลายโครงการมุ่งใช้ประโยชน์จากข้อจำกัดของระบบ เช่น ความละเอียดพื้นฐานเพียง 512×512 พิกเซล
เช่นเดียวกับโครงการคอมพิวเตอร์วิทัศน์และสังเคราะห์ภาพโดยทั่วไป Stable Diffusion ได้รับการฝึกด้วยภาพอัตราส่วนสี่เหลี่ยมจัตุรัส ในกรณีนี้คือภาพที่ผ่านการสุ่มตัวอย่างใหม่เป็น 512×512 พิกเซล เพื่อให้ภาพต้นทางมีรูปแบบสม่ำเสมอและอยู่ภายในข้อจำกัดของ GPU ที่ใช้ฝึกโมเดล
ดังนั้น Stable Diffusion จึง “คิด” (หากมันคิดได้) ในกรอบ 512×512 และแน่นอนว่าเป็นกรอบสี่เหลี่ยมจัตุรัส ผู้ใช้จำนวนมากที่กำลังสำรวจขีดจำกัดของระบบรายงานว่า Stable Diffusion ให้ผลลัพธ์ที่เชื่อถือได้ที่สุดและมีข้อผิดพลาดน้อยที่สุดที่อัตราส่วนค่อนข้างจำกัดนี้ (ดูหัวข้อปัญหาแขนขาด้านล่าง)
แม้ระบบหลายรูปแบบจะมีการเพิ่มความละเอียดผ่าน RealESRGAN (และแก้ใบหน้าที่สร้างได้ไม่ดีผ่าน GFPGAN) ผู้ใช้หลายรายก็กำลังพัฒนาวิธีแบ่งภาพเป็นส่วนขนาด 512×512 พิกเซล แล้วต่อกลับเข้าด้วยกันเป็นผลงานขนาดใหญ่กว่า

ภาพขนาด 1024×576 นี้ ซึ่งปกติเป็นความละเอียดที่ไม่สามารถสร้างได้ในการประมวลผล Stable Diffusion ครั้งเดียว เกิดจากการคัดลอกไฟล์ Python ชื่อ attention.py จาก DoggettX ซึ่งเป็นรุ่นแยกพัฒนาของ Stable Diffusion ที่รองรับการเพิ่มความละเอียดแบบแบ่งไทล์ ไปวางในอีกรุ่นแยกหนึ่ง ที่มา: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
แม้บางโครงการลักษณะนี้จะใช้โค้ดที่เขียนขึ้นเองหรือไลบรารีอื่น แต่ การพอร์ต txt2imghd ของ GOBIG ซึ่งเป็นโหมดหนึ่งใน ProgRockDiffusion ที่ใช้ VRAM มาก มีแผนจะนำความสามารถนี้เข้าสู่สาขาหลักในเร็ว ๆ นี้ แม้ txt2imghd จะเป็นการพอร์ต GOBIG โดยเฉพาะ แต่นักพัฒนาในชุมชนรายอื่นก็กำลังนำ GOBIG ไปใช้ในรูปแบบที่ต่างกัน

ภาพนามธรรมซึ่งเหมาะกับการสาธิตนี้ สร้างครั้งแรกที่ 512×512 พิกเซล (ซ้ายและภาพถัดจากซ้าย) จากนั้นเพิ่มความละเอียดด้วย ESGRAN ซึ่งขณะนี้แทบจะเป็นส่วนหนึ่งของ Stable Diffusion ทุกรุ่น และได้รับ “ความสนใจเป็นพิเศษ” ผ่านการใช้ GOBIG ทำให้เกิดรายละเอียดที่อย่างน้อยภายในขอบเขตของภาพส่วนนั้นดูเหมือนได้รับการขยายอย่างดีกว่า ที่มา: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
ตัวอย่างภาพนามธรรมข้างต้นมี “อาณาจักรเล็ก ๆ” ของรายละเอียดมากมายที่เหมาะกับวิธีขยายภาพซึ่งมองแต่ส่วนของตนเองเช่นนี้ แต่การสร้างภาพขยายที่ไม่ซ้ำซ้อนและกลมกลืนกันโดยไม่ ดู เหมือนประกอบขึ้นจากชิ้นส่วนจำนวนมาก อาจต้องอาศัยวิธีแก้ด้วยโค้ดที่ท้าทายกว่า โดยเฉพาะใบหน้ามนุษย์ที่เราสังเกตเห็นความผิดปกติหรือสิ่งแปลกปลอมที่สะดุดตาได้ไวเป็นพิเศษ ดังนั้นท้ายที่สุดใบหน้าอาจต้องมีวิธีแก้เฉพาะ
ปัจจุบัน Stable Diffusion ยังไม่มีกลไกเพ่งความสนใจไปยังใบหน้าระหว่างสร้างภาพเหมือนที่มนุษย์ให้ความสำคัญกับข้อมูลใบหน้า แม้นักพัฒนาบางรายในชุมชน Discord กำลังพิจารณาวิธีเพิ่ม “ความสนใจ” แบบนี้ แต่ขณะนี้การปรับปรุงใบหน้าด้วยมือหลังสร้างภาพครั้งแรกนั้นง่ายกว่ามาก และในอนาคตอาจทำได้อัตโนมัติ
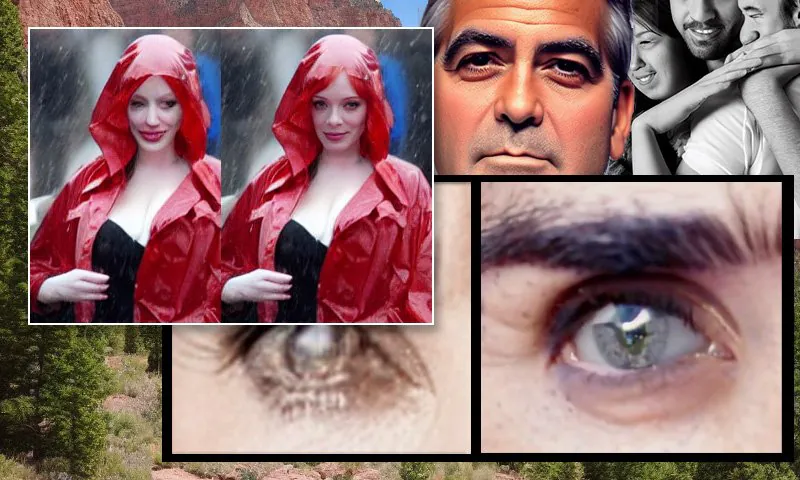
ใบหน้ามนุษย์มีตรรกะเชิงความหมายที่สมบูรณ์อยู่ภายใน ซึ่งไม่พบใน “ไทล์” ของมุมล่างอาคาร เป็นต้น ด้วยเหตุนี้ปัจจุบันจึงสามารถ “ซูมเข้า” และสร้างใบหน้าที่ดูหยาบในผลลัพธ์ Stable Diffusion ใหม่ได้อย่างมีประสิทธิภาพ

ซ้าย: ความพยายามครั้งแรกของ Stable Diffusion ด้วยพรอมต์ ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ ขวา: ใบหน้าที่ดีขึ้นจากการนำใบหน้าเบลอและหยาบจากภาพแรกกลับเข้าไปให้ Stable Diffusion ทุ่มความสนใจทั้งหมดผ่าน Img2Img (ดูภาพเคลื่อนไหวด้านล่าง)
หากไม่มีวิธี Textual Inversion โดยเฉพาะ (ดูด้านล่าง) วิธีนี้จะใช้ได้เฉพาะภาพคนดังที่มีภาพของบุคคลนั้นอยู่เป็นจำนวนมากแล้วในชุดย่อยของ LAION ที่ใช้ฝึก Stable Diffusion ดังนั้นจึงใช้ได้กับคนอย่าง Tom Cruise, Brad Pitt, Jennifer Lawrence และคนดังในสื่ออีกจำนวนจำกัดที่มีภาพในข้อมูลต้นทางจำนวนมาก
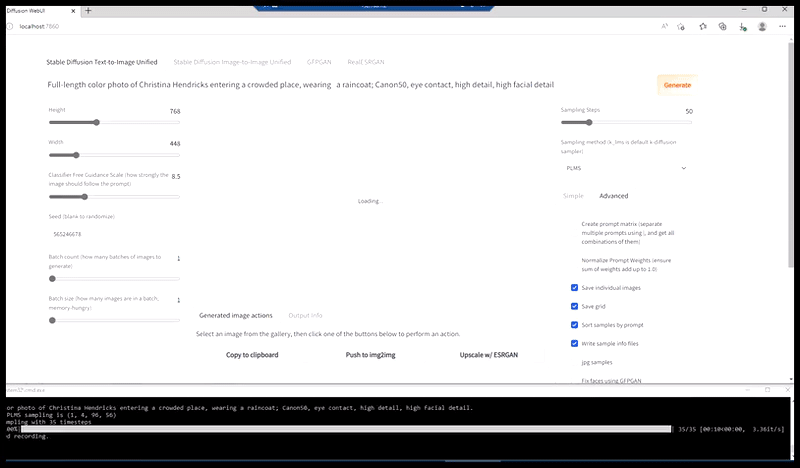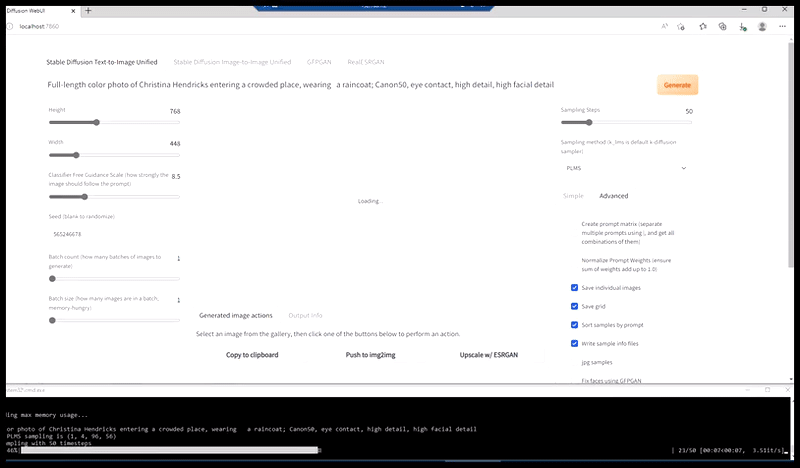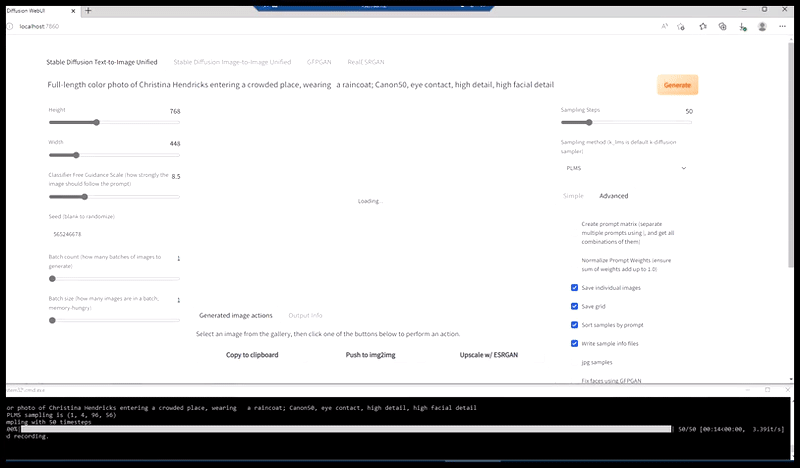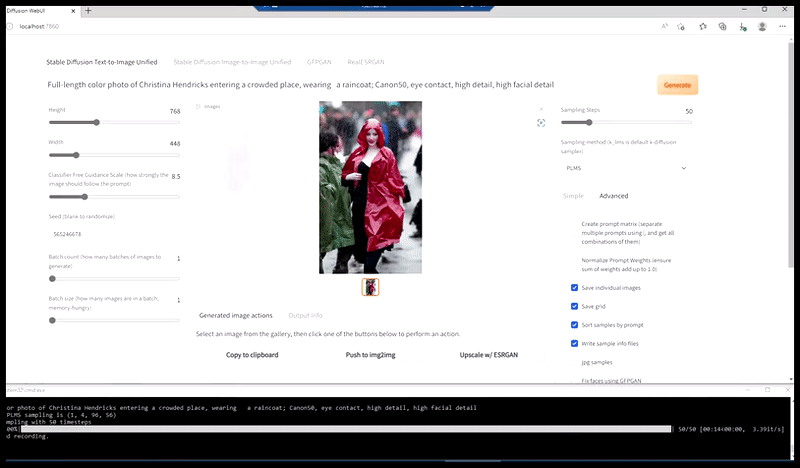
การสร้างภาพที่ดูเป็นภาพถ่ายสำหรับสื่อด้วยพรอมต์ ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’
สำหรับคนดังที่มีอาชีพยาวนานต่อเนื่อง Stable Diffusion มักสร้างภาพบุคคลนั้นในวัยปัจจุบัน กล่าวคือวัยที่สูงขึ้น จึงต้องเติมคำในพรอมต์ เช่น ‘young’ หรือ ‘in the year [YEAR]’ เพื่อสร้างภาพที่ดูอ่อนวัยกว่า

ด้วยอาชีพที่โดดเด่น มีภาพถ่ายมากมาย และต่อเนื่องเกือบ 40 ปี นักแสดง Jennifer Connelly เป็นหนึ่งในคนดังไม่กี่รายใน LAION ที่ทำให้ Stable Diffusion แสดงภาพได้หลายช่วงอายุ ที่มา: Stable Diffusion ชุดสำเร็จรูป ใช้งานในเครื่อง เช็กพอยต์ v1.4 พร้อมพรอมต์ระบุอายุ
สาเหตุสำคัญคือการแพร่หลายของภาพถ่ายสื่อแบบดิจิทัล แทนภาพที่ใช้ฟิล์มราคาแพง ตั้งแต่กลางทศวรรษ 2000 เป็นต้นมา และปริมาณภาพที่เพิ่มขึ้นในเวลาต่อมาเนื่องจากบรอดแบนด์มีความเร็วสูงขึ้น
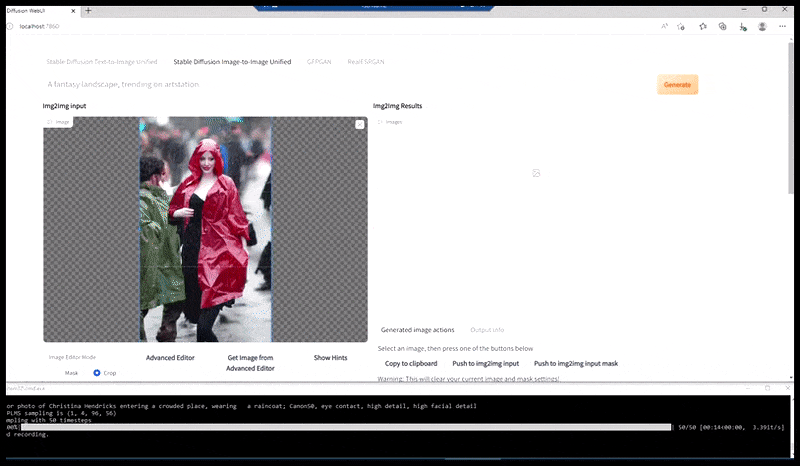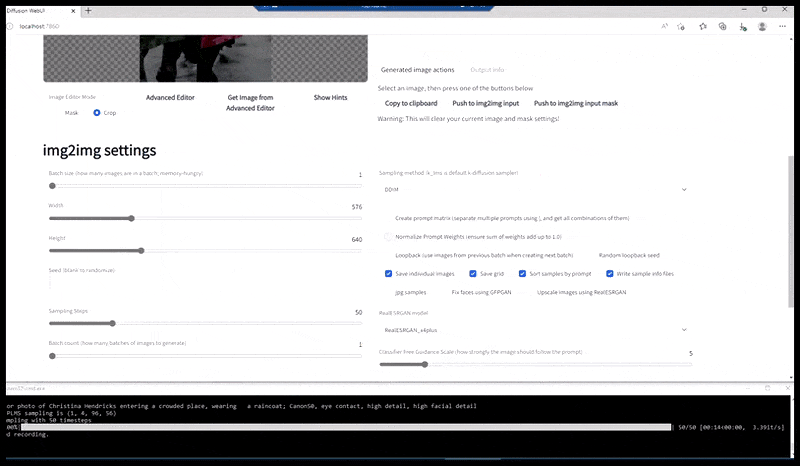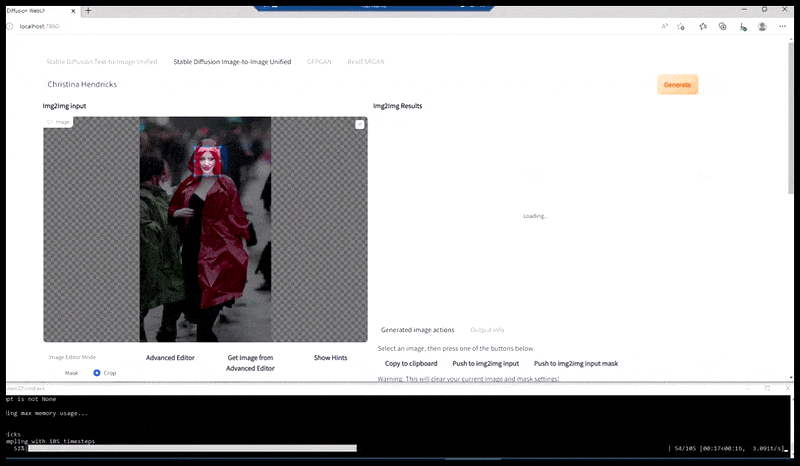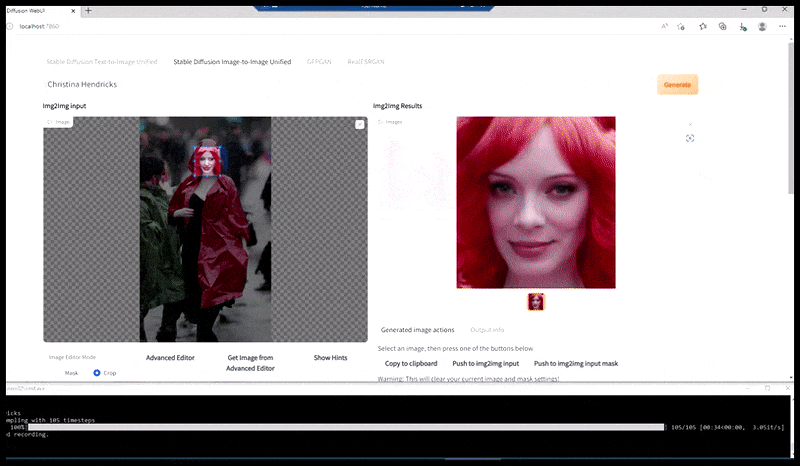
นำภาพที่สร้างแล้วเข้า Img2Img ใน Stable Diffusion เลือก “บริเวณที่ต้องการเน้น” แล้วสร้างเฉพาะบริเวณนั้นใหม่ด้วยขนาดสูงสุด ทำให้ Stable Diffusion ทุ่มทรัพยากรทั้งหมดไปกับการสร้างใบหน้าใหม่ได้
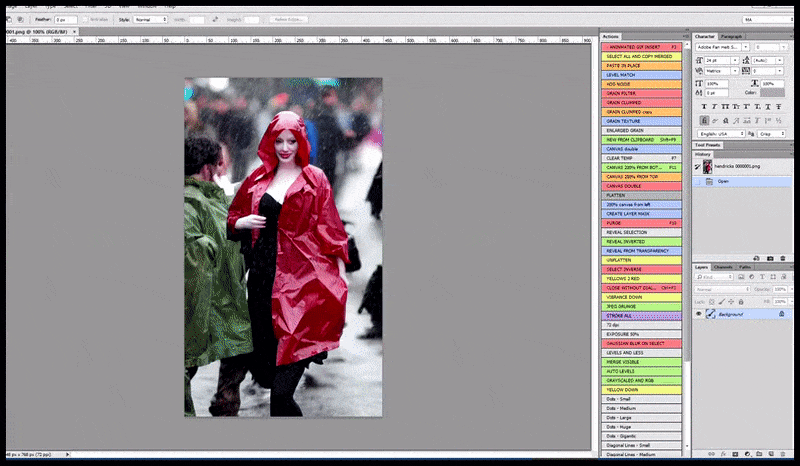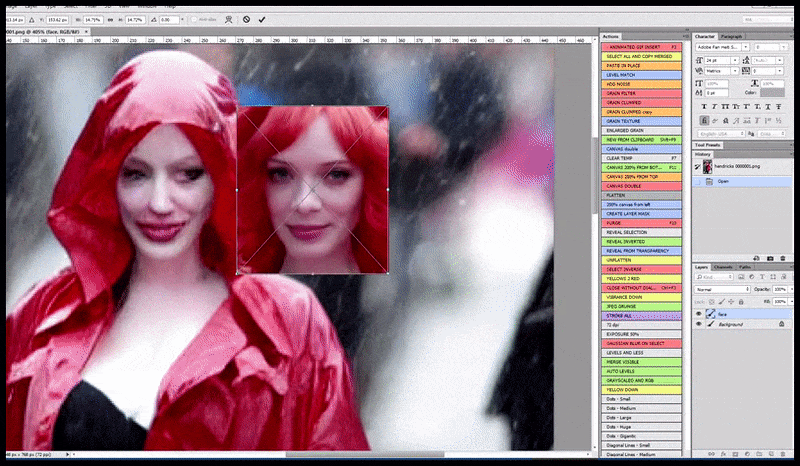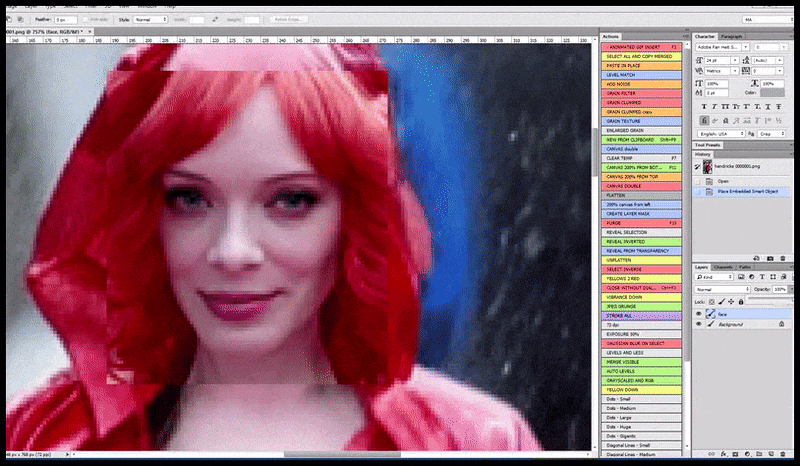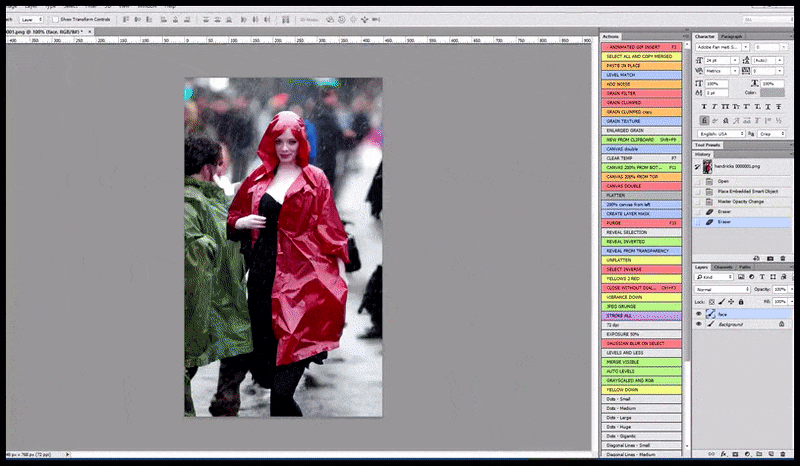
นำใบหน้าที่ได้รับ “ความสนใจสูง” กลับไปประกอบในภาพเดิม นอกเหนือจากใบหน้า วิธีนี้ใช้ได้เฉพาะสิ่งที่มีลักษณะโดยรวมซึ่งรู้จักและสอดคล้องกัน เช่น ส่วนของภาพต้นฉบับที่มีวัตถุเฉพาะอย่างนาฬิกาหรือรถยนต์ การขยายส่วนหนึ่งของกำแพง เป็นต้น จะทำให้กำแพงที่ประกอบกลับมาดูแปลกมาก เพราะระหว่างสร้างแต่ละไทล์ไม่มีบริบทที่กว้างกว่าสำหรับ “จิ๊กซอว์ชิ้นนี้”
คนดังบางรายในฐานข้อมูลเหมือนถูก “แช่แข็ง” ไว้ในช่วงเวลาหนึ่งแล้ว อาจเพราะเสียชีวิตตั้งแต่อายุยังน้อย เช่น Marilyn Monroe หรือมีชื่อเสียงในวงกว้างเพียงช่วงสั้น ๆ ทำให้มีภาพจำนวนมากในระยะเวลาจำกัด การสอบถาม Stable Diffusion อาจมองได้ว่าเป็นดัชนีความนิยมแบบ “ปัจจุบัน” สำหรับดาราทั้งรุ่นใหม่และรุ่นเก่า คนดังบางรายทั้งในอดีตและปัจจุบันมีภาพในข้อมูลต้นทางไม่มากพอให้สร้างภาพที่เหมือนได้ดี ขณะที่ความนิยมอันยืนยาวของดาราบางรายที่เสียชีวิตไปนานแล้วหรือเลือนหายจากวงการทำให้ระบบยังสร้างภาพที่คล้ายได้พอสมควร

ผลลัพธ์จาก Stable Diffusion แสดงให้เห็นได้อย่างรวดเร็วว่ามีใบหน้าคนดังคนใดอยู่มากในข้อมูลฝึก แม้ Millie Bobby Brown จะมีชื่อเสียงมากในฐานะวัยรุ่นตอนปลายในขณะที่เขียนบทความนี้ แต่เมื่อมีการรวบรวมชุดข้อมูลต้นทาง LAION จากเว็บ เธอยังอายุน้อยกว่าและเป็นที่รู้จักน้อยกว่า ทำให้การสร้างภาพที่เหมือนเธออย่างมีคุณภาพด้วย Stable Diffusion ยังเป็นปัญหาอยู่ในขณะนี้
หากมีข้อมูลรองรับ วิธีเพิ่มความละเอียดแบบแบ่งไทล์ของ Stable Diffusion อาจไปได้ไกลกว่าการเน้นใบหน้า โดยอาจสร้างใบหน้าที่ถูกต้องและละเอียดขึ้นด้วยการแยกองค์ประกอบใบหน้าออก แล้วทุ่มพลัง GPU ในเครื่องทั้งหมดให้กับลักษณะสำคัญทีละส่วนก่อนประกอบกลับ ซึ่งขณะนี้ก็ยังเป็นกระบวนการที่ทำด้วยมือ

แนวทางนี้ไม่ได้จำกัดเฉพาะใบหน้า แต่จำกัดอยู่ที่ส่วนของวัตถุซึ่งมีตำแหน่งที่คาดเดาได้ในบริบทกว้างของวัตถุนั้น และสอดคล้องกับตัวแทนเชิงความหมายระดับสูงที่คาดได้อย่างสมเหตุผลว่าจะพบในชุดข้อมูลขนาดมหาศาล
ข้อจำกัดที่แท้จริงคือปริมาณข้อมูลอ้างอิงในชุดข้อมูล เพราะท้ายที่สุดรายละเอียดที่สร้างซ้ำลงไปลึกมากจะกลายเป็นสิ่งที่ “หลอนขึ้นมา” ทั้งหมด กล่าวคือเป็นสิ่งสมมติ และสมจริงน้อยลง
การขยายลงถึงรายละเอียดระดับนี้ได้ผลกับ Jennifer Connelly เพราะมีภาพเธออยู่มากในหลายช่วงอายุใน LAION-aesthetics ซึ่งเป็นชุดย่อยหลักของ LAION 5B ที่ Stable Diffusion ใช้ และใน LAION โดยรวม ในกรณีอื่นอีกมาก ความถูกต้องจะลดลงเพราะขาดข้อมูล จึงจำเป็นต้องปรับจูนเพิ่มเติม (ฝึกเพิ่ม ดู “การปรับแต่ง” ด้านล่าง) หรือใช้ Textual Inversion (ดูด้านล่าง)
ไทล์เป็นวิธีที่ทรงพลังและมีต้นทุนค่อนข้างต่ำในการทำให้ Stable Diffusion สร้างผลลัพธ์ความละเอียดสูงได้ แต่การเพิ่มความละเอียดด้วยอัลกอริทึมแบบแบ่งไทล์เช่นนี้ หากไม่มีกลไกความสนใจในระดับสูงที่มองบริบทกว้างขึ้น อาจยังไม่ถึงมาตรฐานที่คาดหวังสำหรับเนื้อหาหลายประเภท
2: การแก้ปัญหาแขนขาของมนุษย์
Stable Diffusion ไม่ได้สมชื่อเรื่องความเสถียรเมื่อถ่ายทอดความซับซ้อนของอวัยวะส่วนปลายมนุษย์ มืออาจเพิ่มจำนวนแบบสุ่ม นิ้วอาจหลอมรวมกัน ขาที่สามอาจปรากฏโดยไม่คาดคิด และแขนขาที่มีอยู่อาจหายไปโดยไร้ร่องรอย แต่ก็ต้องให้ความเป็นธรรมว่า Stable Diffusion มีปัญหานี้ร่วมกับโมเดลอื่นประเภทเดียวกัน และแน่นอนว่ารวมถึง DALL-E 2

ผลลัพธ์ที่ไม่ได้แก้ไขจาก DALL-E 2 และ Stable Diffusion (1.4) เมื่อปลายเดือนสิงหาคม 2022 ทั้งคู่มีปัญหาเรื่องแขนขา พรอมต์คือ ‘A woman embracing a man’
ผู้ชื่นชอบ Stable Diffusion ที่หวังว่าเช็กพอยต์ 1.5 ซึ่งกำลังจะมาถึง เป็นรุ่นที่ฝึกเข้มข้นขึ้นและปรับปรุงพารามิเตอร์แล้ว จะยุติความสับสนเรื่องแขนขา อาจต้องผิดหวัง โมเดลใหม่ที่จะเปิดตัวใน อีกประมาณสองสัปดาห์ขณะนี้กำลังให้ทดลองก่อนที่พอร์ทัลเชิงพาณิชย์ของ stability.ai ชื่อ DreamStudioซึ่งใช้ 1.5 เป็นค่าเริ่มต้น และผู้ใช้สามารถเปรียบเทียบผลลัพธ์ใหม่กับภาพที่สร้างจากระบบ 1.4 ในเครื่องหรือที่อื่นได้:

ที่มา: ชุดสำเร็จรูป 1.4 ในเครื่อง และ https://beta.dreamstudio.ai/

ที่มา: ชุดสำเร็จรูป 1.4 ในเครื่อง และ https://beta.dreamstudio.ai/

ที่มา: ชุดสำเร็จรูป 1.4 ในเครื่อง และ https://beta.dreamstudio.ai/
เช่นเดียวกับที่พบกันบ่อย คุณภาพข้อมูลอาจเป็นสาเหตุหลักที่มีส่วนทำให้เกิดปัญหา
ฐานข้อมูลเปิดที่ป้อนให้ระบบสังเคราะห์ภาพอย่าง Stable Diffusion และ DALL-E 2 สามารถให้ป้ายกำกับจำนวนมากทั้งสำหรับบุคคลแต่ละคนและปฏิสัมพันธ์ระหว่างคน ป้ายกำกับเหล่านี้ถูกฝึกควบคู่กับภาพหรือส่วนของภาพที่เกี่ยวข้อง

ผู้ใช้ Stable Diffusion สำรวจแนวคิดที่ถูกฝึกเข้าไปในโมเดลได้โดยค้นชุดข้อมูล LAION-aesthetics ซึ่งเป็นชุดย่อยของ LAION 5B ที่ใหญ่กว่าและใช้ขับเคลื่อนระบบ ภาพไม่ได้เรียงตามตัวอักษรของป้ายกำกับ แต่เรียงตาม “คะแนนความงาม” ที่มา: https://rom1504.github.io/clip-retrieval/
ลำดับชั้นที่ดี ของป้ายกำกับและหมวดหมู่แต่ละส่วนที่ช่วยอธิบายแขนมนุษย์จะมีลักษณะประมาณนี้ body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

การแบ่งส่วนเชิงความหมายของมืออย่างละเอียด แม้การแยกส่วนที่ละเอียดผิดปกติขนาดนี้ก็ยังถือว่า “นิ้ว” แต่ละนิ้วเป็นหน่วยเดียว โดยไม่ได้นับสามปล้องของนิ้วทั่วไปและสองปล้องของนิ้วหัวแม่มือ ที่มา: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
ในความเป็นจริง ภาพต้นทางไม่น่าจะถูกกำกับข้อมูลอย่างสม่ำเสมอเช่นนี้ตลอดทั้งชุดข้อมูล และอัลกอริทึมติดป้ายกำกับแบบไม่มีผู้สอนก็น่าจะหยุดอยู่ที่ระดับที่ สูงกว่า เช่น “มือ” และปล่อยพิกเซลภายใน ซึ่งในทางเทคนิคมีข้อมูล “นิ้ว” อยู่ ให้เป็นกลุ่มพิกเซลที่ไม่มีป้ายกำกับ แล้วสกัดคุณลักษณะออกมาตามอำเภอใจ ซึ่งอาจปรากฏเป็นสิ่งผิดปกติที่สะดุดตาในภาพที่สร้างภายหลัง

สิ่งที่ควรเป็น (ขวาบน หากไม่ใช่หมัดอัปเปอร์คัต) และสิ่งที่มักเป็น (ขวาล่าง) เนื่องจากทรัพยากรสำหรับติดป้ายกำกับมีจำกัด หรือข้อจำกัดของสถาปัตยกรรมในการใช้ป้ายกำกับเหล่านั้นหากมีอยู่ในชุดข้อมูล
ดังนั้น หากโมเดล latent diffusion สร้างภาพไปถึงแขนได้ ก็แทบแน่นอนว่าจะพยายามสร้างมือที่ปลายแขนนั้นอย่างน้อยหนึ่งครั้ง เพราะ arm>hand คือลำดับชั้นขั้นต่ำที่ต้องมี และอยู่ค่อนข้างสูงในสิ่งที่สถาปัตยกรรมรู้เกี่ยวกับ “กายวิภาคมนุษย์”
หลังจากนั้น “นิ้ว” อาจเป็นหน่วยกลุ่มที่เล็กที่สุด แม้การวาดมือมนุษย์จะยังมีส่วนย่อยของนิ้วและนิ้วหัวแม่มืออีก 14 ส่วนที่ต้องคำนึงถึง
หากทฤษฎีนี้ถูกต้อง ก็ไม่มีทางแก้ที่แท้จริง เนื่องจากทั้งวงการขาดงบสำหรับให้มนุษย์กำกับข้อมูล และยังไม่มีอัลกอริทึมที่มีประสิทธิภาพเพียงพอจะติดป้ายกำกับอัตโนมัติด้วยอัตราผิดพลาดต่ำ ในทางปฏิบัติ โมเดลอาจกำลังอาศัยความสม่ำเสมอของกายวิภาคมนุษย์เพื่อกลบข้อบกพร่องของชุดข้อมูลที่ใช้ฝึก
เหตุผลหนึ่งที่อาจทำให้โมเดล ไม่สามารถ พึ่งพาสิ่งนี้ได้ ซึ่งเพิ่งมีผู้ เสนอ ใน Discord ของ Stable Diffusion คือโมเดลอาจสับสนว่ามือมนุษย์ที่สมจริงควรมีนิ้วกี่นิ้ว เพราะฐานข้อมูลจาก LAION ที่ป้อนให้ระบบมีตัวการ์ตูนที่อาจมีนิ้วน้อยกว่า (ซึ่งตัวมันเองก็เป็น วิธีลัดเพื่อลดงาน)

สองผู้ต้องสงสัยที่อาจมีส่วนทำให้เกิดอาการ “นิ้วหาย” ใน Stable Diffusion และโมเดลคล้ายกัน ด้านล่างเป็นตัวอย่างมือการ์ตูนจากชุดข้อมูล LAION-aesthetics ที่ใช้ขับเคลื่อน Stable Diffusion ที่มา: https://www.youtube.com/watch?v=0QZFQ3gbd6I
หากเรื่องนี้เป็นจริง ทางออกที่เห็นได้ชัดเพียงอย่างเดียวคือฝึกโมเดลใหม่ โดยไม่นำเนื้อหาที่อิงรูปร่างมนุษย์แต่ไม่สมจริงมาใช้ และทำให้แน่ใจว่ากรณีที่อวัยวะหายจริง เช่น ผู้สูญเสียอวัยวะ ถูกติดป้ายกำกับว่าเป็นข้อยกเว้นอย่างเหมาะสม แค่ในแง่การคัดสรรข้อมูล นี่ก็เป็นความท้าทายอย่างมาก โดยเฉพาะสำหรับชุมชนที่มีทรัพยากรจำกัด
อีกแนวทางหนึ่งคือใช้ตัวกรองไม่ให้เนื้อหาลักษณะนี้ เช่น “มือที่มีสาม/ห้านิ้ว” ปรากฏระหว่างสร้างภาพ คล้ายกับที่ OpenAI ได้ กรอง GPT-3 และ DALL-E 2ในระดับหนึ่ง เพื่อควบคุมผลลัพธ์ได้โดยไม่จำเป็นต้องฝึกโมเดลต้นทางใหม่

สำหรับ Stable Diffusion ความแตกต่างเชิงความหมายระหว่างนิ้ว หรือแม้กระทั่งแขนขา อาจพร่าเลือนจนน่าสยอง ชวนให้นึกถึงภาพยนตร์สยองขวัญแนว “body horror” ในทศวรรษ 1980 ของผู้กำกับอย่าง David Cronenberg ที่มา: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
อย่างไรก็ตาม อีกครั้งที่ต้องมีป้ายกำกับซึ่งอาจไม่มีอยู่ในภาพที่ได้รับผลกระทบทั้งหมด จึงกลับมาเจอความท้าทายด้านการจัดการและงบประมาณเหมือนเดิม
อาจกล่าวได้ว่าเหลือทางไปต่อสองทาง คือเพิ่มข้อมูลเข้าไปเพื่อแก้ปัญหา และใช้ระบบตีความจากบุคคลภายนอกที่สามารถแทรกแซงเมื่อความผิดพลาดทางกายภาพตามที่กล่าวมาจะถูกนำเสนอแก่ผู้ใช้ปลายทาง อย่างน้อยแนวทางหลังจะทำให้ OpenAI มีวิธีคืนเงินสำหรับภาพแนว “body horror” หากบริษัทต้องการทำเช่นนั้น
3: การปรับแต่ง
ความเป็นไปได้ที่น่าตื่นเต้นที่สุดอย่างหนึ่งสำหรับอนาคตของ Stable Diffusion คือผู้ใช้หรือองค์กรอาจพัฒนาระบบฉบับดัดแปลง ซึ่งทำให้ผสานเนื้อหานอกขอบเขต LAION ที่ใช้ฝึกไว้ล่วงหน้าเข้าไปในระบบได้ โดยอุดมคติคือไม่ต้องเสียค่าใช้จ่ายที่ควบคุมไม่ได้เพื่อฝึกทั้งโมเดลใหม่ หรือรับความเสี่ยงจากการฝึกภาพใหม่จำนวนมากเข้าไปในโมเดลที่พัฒนาเต็มที่และมีความสามารถอยู่แล้ว
เปรียบได้กับนักเรียนที่เรียนอ่อนกว่าสองคนย้ายเข้าห้องเรียนขั้นสูงที่มีนักเรียนสามสิบคน ทั้งสองอาจปรับตัวและตามทัน หรือไม่ผ่านอยู่เพียงสองคน ไม่ว่ากรณีใด ผลการเรียนเฉลี่ยของห้องก็คงไม่เปลี่ยน แต่หากมีนักเรียนที่เรียนอ่อนกว่าย้ายเข้าไป 15 คน การกระจายผลการเรียนของทั้งห้องก็น่าจะแย่ลง
ในทำนองเดียวกัน เครือข่ายความสัมพันธ์ที่ทำงานประสานกันและค่อนข้างละเอียดอ่อน ซึ่งก่อตัวขึ้นจากการฝึกโมเดลอย่างต่อเนื่องและมีราคาแพง อาจเสียหาย หรือบางกรณีถูกทำลายอย่างแท้จริง เพราะข้อมูลใหม่ที่มากเกินไป ทำให้คุณภาพผลลัพธ์ของโมเดลลดลงโดยรวม
เหตุผลหลักที่จะทำเช่นนี้คือเมื่อคุณต้องการยึดความเข้าใจเชิงแนวคิดของโมเดลเกี่ยวกับความสัมพันธ์และสิ่งต่าง ๆ มาใช้ทั้งหมด เพื่อสร้างเฉพาะเนื้อหาที่คล้ายกับข้อมูลเพิ่มเติมที่คุณใส่เข้าไป
ดังนั้น การฝึกเฟรมจำนวน 500,000 เฟรมจาก Simpsons เข้าไปในเช็กพอยต์ Stable Diffusion ที่มีอยู่ ในที่สุดก็น่าจะทำให้ได้ตัวจำลอง Simpsons ที่ดีกว่ารุ่นต้นฉบับ โดยมีเงื่อนไขว่าความสัมพันธ์เชิงความหมายในวงกว้างยังคงเหลือรอดจากกระบวนการนี้มากพอ เช่น Homer Simpson eating a hotdogซึ่งอาจต้องอาศัยข้อมูลเกี่ยวกับฮอตดอกที่ไม่ได้อยู่ในเนื้อหาที่คุณเพิ่ม แต่มีอยู่ในเช็กพอยต์เดิมแล้ว และมีเงื่อนไขว่าคุณไม่ต้องการเปลี่ยนจากเนื้อหา Simpsons ไปสร้าง fabulous landscape by Greg Rutkowski อย่างฉับพลัน เพราะโมเดลที่ฝึกเพิ่มเติมแล้วถูกเบี่ยงเบนความสนใจอย่างมาก และจะทำสิ่งนั้นได้ไม่ดีเหมือนเดิม
ตัวอย่างที่น่าสังเกตคือ waifu-diffusionซึ่งประสบความสำเร็จในการ ฝึกเพิ่มเติมด้วยภาพอนิเมะ 56,000 ภาพ เข้าไปในเช็กพอยต์ Stable Diffusion ที่ฝึกเสร็จแล้ว อย่างไรก็ตาม นี่เป็นเรื่องยากสำหรับผู้ทำเป็นงานอดิเรก เพราะโมเดลต้องใช้ VRAM ขั้นต่ำถึง 30GB สูงกว่าที่คาดว่าจะมีในระดับผู้บริโภคของซีรีส์ NVIDIA 40XX ที่กำลังจะเปิดตัวอย่างมาก

การฝึกเนื้อหาที่ปรับแต่งเข้าไปใน Stable Diffusion ผ่าน waifu-diffusion: โมเดลใช้เวลาฝึกเพิ่มเติมสองสัปดาห์เพื่อสร้างภาพประกอบได้ในระดับนี้ ภาพทั้งหกด้านซ้ายแสดงความก้าวหน้าระหว่างฝึกในการสร้างผลลัพธ์ที่สอดคล้องกับตัวแบบตามข้อมูลฝึกใหม่ ที่มา: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
อาจต้องทุ่มเทความพยายามอย่างมากให้กับรุ่นแยกพัฒนาของเช็กพอยต์ Stable Diffusion เหล่านี้ แล้วกลับติดขัดด้วยหนี้ทางเทคนิค นักพัฒนาใน Discord อย่างเป็นทางการระบุแล้วว่าเช็กพอยต์รุ่นถัดไปไม่จำเป็นต้องเข้ากันได้กับรุ่นก่อน แม้แต่ตรรกะของพรอมต์ที่เคยใช้ได้ในรุ่นก่อน เพราะเป้าหมายหลักคือได้โมเดลที่ดีที่สุดเท่าที่เป็นไปได้ แทนการรองรับแอปพลิเคชันและกระบวนการแบบเก่า
ดังนั้น บริษัทหรือบุคคลที่ตัดสินใจแยกเช็กพอยต์ไปทำผลิตภัณฑ์เชิงพาณิชย์จึงแทบไม่มีทางย้อนกลับ รุ่นโมเดลของตนในจุดนั้นจะเป็น “hard fork” และไม่สามารถรับประโยชน์จากการพัฒนาต้นน้ำในรุ่นถัดไปของ stability.ai ได้ ซึ่งเป็นการตัดสินใจผูกมัดที่สำคัญมาก
ความหวังในปัจจุบันที่ดูมีโอกาสมากกว่าสำหรับการปรับแต่ง Stable Diffusion คือ Textual Inversionซึ่งผู้ใช้ฝึกด้วยภาพเพียงไม่กี่ภาพที่จัดแนวสอดคล้องกับ CLIP.

Textual Inversion ซึ่งเป็นผลงานความร่วมมือระหว่างมหาวิทยาลัยเทลอาวีฟกับ NVIDIA ทำให้ฝึกสิ่งใหม่ที่เฉพาะเจาะจงเข้าไปได้ โดยไม่ทำลายความสามารถของโมเดลต้นทาง ที่มา: https://textual-inversion.github.io/
ข้อจำกัดหลักที่เห็นได้ของ Textual Inversion คือคำแนะนำให้ใช้ภาพจำนวนน้อยมาก อาจเพียงห้าภาพ ซึ่งให้ตัวแทนของสิ่งนั้นที่มีขอบเขตจำกัด และอาจเหมาะกับงานถ่ายทอดสไตล์มากกว่าการแทรกวัตถุที่เหมือนภาพถ่ายจริง
อย่างไรก็ตาม ขณะนี้กำลังมีการทดลองในชุมชน Discord ของ Stable Diffusion หลายแห่งโดยใช้ภาพฝึกจำนวนมากกว่านั้นมาก และยังต้องรอดูว่าวิธีนี้จะได้ผลเพียงใด เช่นเดิม เทคนิคนี้ต้องใช้ VRAM เวลา และความอดทนอย่างมาก
ด้วยข้อจำกัดเหล่านี้ เราอาจต้องรออีกระยะจึงจะได้เห็นการทดลอง Textual Inversion ที่ซับซ้อนกว่าจากผู้ชื่นชอบ Stable Diffusion และได้เห็นว่าแนวทางนี้จะ “ใส่คุณลงไปในภาพ” ได้ดีกว่าการตัดแปะด้วย Photoshop หรือไม่ โดยยังคงความสามารถอันน่าทึ่งของเช็กพอยต์อย่างเป็นทางการไว้
เผยแพร่ครั้งแรกวันที่ 6 กันยายน 2022


