
มุมมองของ Anderson
ST-NeRF: การตัดต่อและแก้ไขสำหรับการสังเคราะห์วิดีโอ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

กลุ่มวิจัยของจีนได้พัฒนาเทคนิคในการนำการตัดต่อและแก้ไขมาใช้กับหนึ่งในสาขาวิจัยการสังเคราะห์ภาพที่ร้อนแรงที่สุดของปีที่แล้ว – Neural Radiance Fields (NeRF) ระบบนี้เรียกว่า ST-NeRF (Spatio-Temporal Coherent Neural Radiance Field)
สิ่งที่ดูเหมือนจะเป็นการเคลื่อนไหวของกล้องจริงในภาพด้านล่างเป็นเพียงผู้ใช้ ‘เลื่อน’ ผ่านมุมมองในเนื้อหาวิดีโอที่มีอยู่ในพื้นที่ 4 มิติ มุมมองไม่ได้ถูกล็อกไว้กับการแสดงของคนในวิดีโอ ซึ่งสามารถมองเห็นได้จากทุกมุมของระยะ 180 องศา
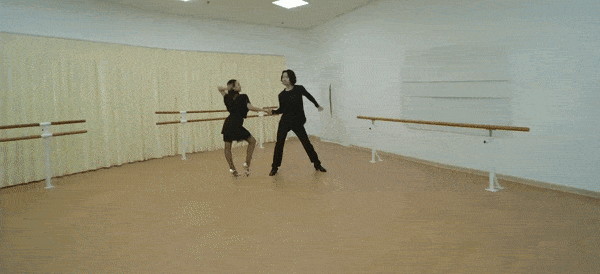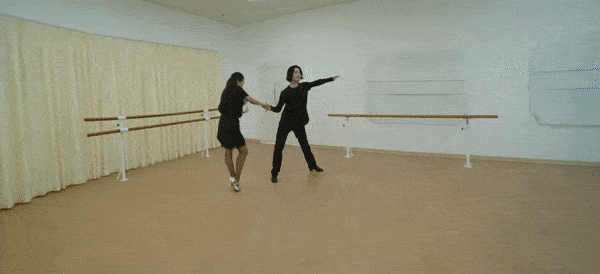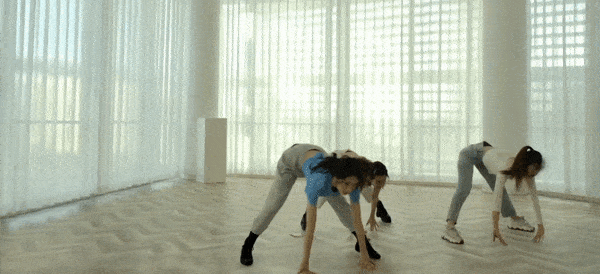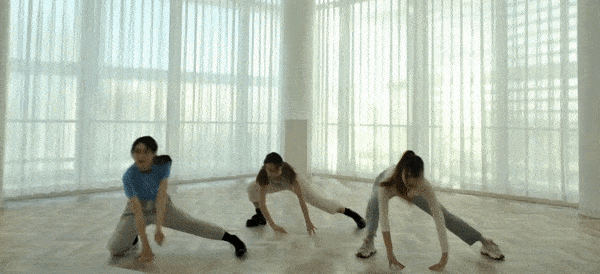
แต่ละด้านในวิดีโอคือองค์ประกอบที่ถูกจับภาพแยกกัน และประกอบเข้าด้วยกันเป็นฉากที่สอดคล้องกันซึ่งสามารถสำรวจได้อย่างมีพลัง
ด้านสามารถถูกดูปล่อยได้ภายในฉากหรือปรับขนาด:
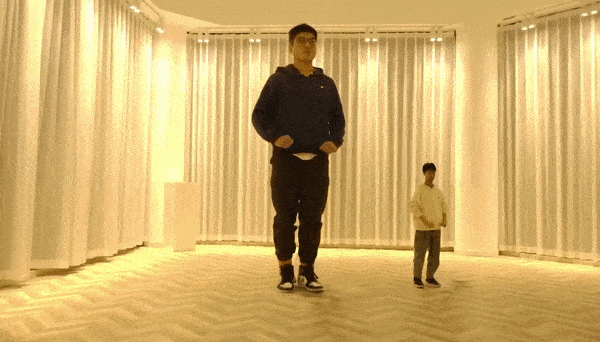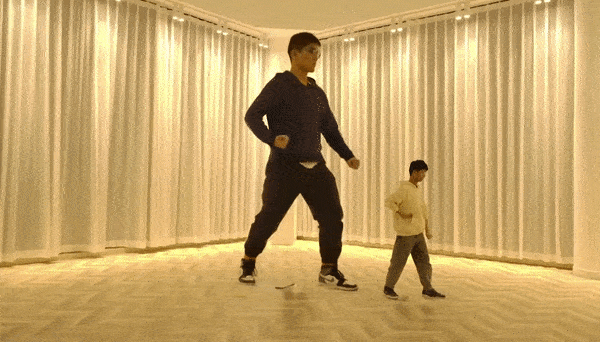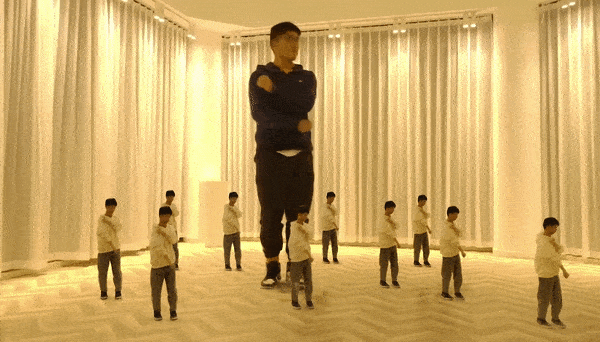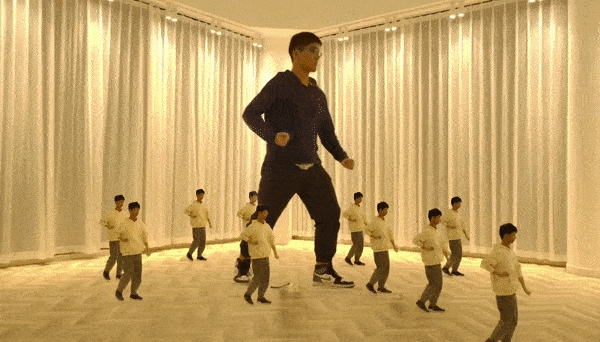
นอกจากนี้ พฤติกรรมเชิงเวลาของแต่ละด้านสามารถเปลี่ยนแปลงได้ง่ายๆ ช้าลง วิ่งย้อนกลับ หรือจัดการในหลายวิธี ซึ่งเปิดทางให้กับการออกแบบตัวกรองและความสามารถในการตีความในระดับสูงมาก
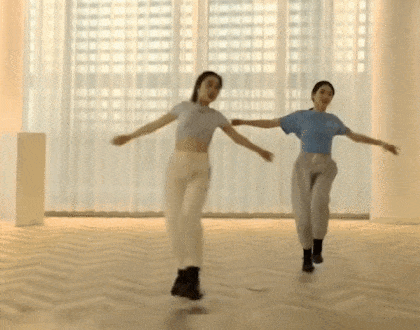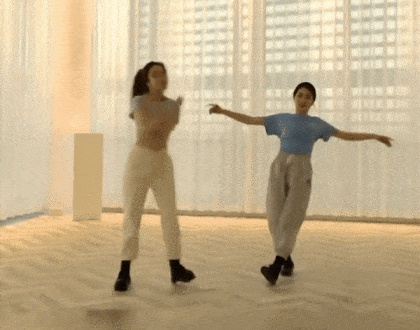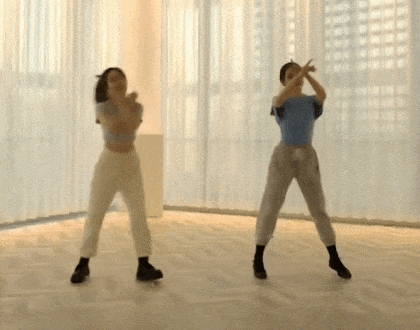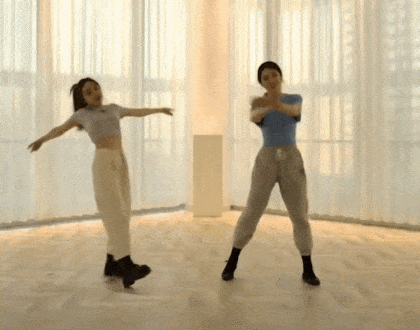
สองด้านของ NeRF ที่แตกต่างกันทำงานที่ความเร็วต่างกันในฉากเดียวกัน Source: https://www.youtube.com/watch?v=Wp4HfOwFGP4

ไม่มีความจำเป็นที่จะต้อง rotoscope ผู้แสดงหรือสภาพแวดล้อม หรือให้ผู้แสดงดำเนินการเคลื่อนไหวของตนเองโดยไม่มีส่วนร่วมในฉากที่ตั้งใจไว้ แทนที่จะจับภาพวิดีโอตามธรรมชาติผ่านกล้องวิดีโอ 16 ตัวที่ครอบคลุม 180 องศา:


สามองค์ประกอบที่แสดงด้านบน คือคนสองคนและสภาพแวดล้อมเป็นองค์ประกอบที่แตกต่างกันและถูกขีดเส้นใต้เพียงเพื่อวัตถุประสงค์ในการอธิบายเท่านั้น แต่ละองค์ประกอบสามารถถูกเปลี่ยนหรือแทรกเข้าไปในฉากได้ที่จุดใดก็ตามในเส้นเวลาในการจับภาพของแต่ละองค์ประกอบ
ST-NeRF เป็นนวัตกรรมในการวิจัย Neural Radiance Fields (NeRF) ซึ่งเป็นเฟรมเวิร์กการเรียนรู้ของเครื่องจักรที่มีการจับภาพหลายมุมมองและรวมเข้าด้วยกันเป็นพื้นที่เสมือนจริงที่สามารถสำรวจได้โดยการฝึกอบรมอย่างกว้างขวาง (แม้ว่าการจับภาพมุมมองเดียวจะเป็นส่วนหนึ่งของการวิจัย NeRF)

Neural Radiance Fields ทำงานโดยการรวบรวมมุมมองการจับภาพหลายมุมมองเข้าด้วยกันเป็นพื้นที่เสมือนจริงที่สอดคล้องกันและสามารถสำรวจได้ โดยมีช่องว่างระหว่างการครอบคลุมที่ถูกประมาณการและแสดงผลโดยเครือข่ายประสาทเทียม Where video (มากกว่าภาพนิ่ง) ถูกใช้ทรัพยากรการแสดงผลที่ต้องการมักจะมาก Source: https://www.matthewtancik.com/nerf
ความสนใจใน NeRF ได้กลายเป็นเรื่องที่ร้อนแรงในช่วง 9 เดือนที่ผ่านมา และรายการ Reddit ที่ดูแลโดย รายการ ของเอกสาร NeRF ที่ได้รับอนุมัติหรือสำรวจอยู่ในปัจจุบัน มี 60 โครงการ

เพียงไม่กี่สาขาของเอกสาร NeRF เดิม Source: https://crossminds.ai/graphlist/nerf-neural-radiance-fields-ai-research-graph-60708936c8663c4cfa875fc2/
การฝึกอบรมที่มีราคาไม่แพง
เอกสารนี้เป็นผลงานร่วมกันระหว่างนักวิจัยจาก Shanghai Tech University และ DGene Digital Technology และได้รับการยอมรับอย่างกระตือรือร้น ที่ Open Review
ST-NeRF มีนวัตกรรมหลายอย่างเหนือกว่าโครงการก่อนหน้านี้ในพื้นที่วิดีโอที่สามารถสำรวจได้จาก ML ไม่น้อยที่สุด คือ มันบรรลุระดับความสมจริงสูงด้วยกล้องเพียง 16 ตัว แม้ว่า Facebook’s DyNeRF ใช้กล้องเพียงสองตัวมากกว่านี้ แต่ก็มีการเคลื่อนไหวที่จำกัดมากขึ้น
ตัวอย่างของสภาพแวดล้อม DyNeRF ของ Facebook โดยมีการเคลื่อนไหวที่จำกัดมากขึ้น และต้องการกล้องมากกว่าต่อตารางฟุตเพื่อสร้างฉาก Source: https://neural-3d-video.github.io
นอกจากไม่สามารถแก้ไขและตัดต่อองค์ประกอบแต่ละด้านแล้ว DyNeRF ยังต้องใช้ทรัพยากรการคำนวณที่มีราคาแพงมาก โดยตรงกันข้าม นักวิจัยชาวจีนระบุว่าค่าใช้จ่ายในการฝึกอบรมข้อมูลของพวกเขาออกมาอยู่ที่ประมาณ 900-3,000 ดอลลาร์ เมื่อเปรียบเทียบกับ 30,000 ดอลลาร์สำหรับโมเดลการสร้างวิดีโอที่มีคุณภาพสูงสุด DVDGAN และระบบที่เข้มข้น เช่น DyNeRF
ผู้ทบทวนวิจัยยังระบุด้วยว่า ST-NeRF เป็นนวัตกรรมที่สำคัญในการแยกกระบวนการเรียนรู้การเคลื่อนไหวออกจากกระบวนการสังเคราะห์ภาพ ซึ่งเป็นสิ่งที่ทำให้สามารถแก้ไขและตัดต่อได้ โดยมีการเข้าถึงที่จำกัดและเชิงเส้นในแนวทางก่อนหน้านี้
แม้ว่ากล้อง 16 ตัวจะเป็นจำนวนกล้องที่จำกัดมากสำหรับการมองเห็นครึ่งวงกลม แต่นักวิจัยก็หวังว่าจะสามารถลดจำนวนกล้องลงได้ในงานในอนาคตโดยใช้พื้นหลังที่ถูกสแกนล่วงหน้าและวิธีการสร้างแบบจำลองฉากที่ขับเคลื่อนด้วยข้อมูลมากขึ้น พวกเขายังต้องการที่จะรวมความสามารถในการเปลี่ยนแสงใหม่ ซึ่งเป็นนวัตกรรมล่าสุดในงานวิจัย NeRF
การแก้ไขข้อจำกัดของ ST-NeRF
ในบริบทของเอกสารวิจัยทางวิชาการ CS ที่มักจะทิ้งความสามารถในการใช้งานจริงของระบบใหม่ในย่อหน้าสุดท้าย แม้ว่าข้อจำกัดที่นักวิจัยยอมรับสำหรับ ST-NeRF จะไม่ธรรมดา
พวกเขาสังเกตเห็นว่าระบบไม่สามารถแยกและแสดงผลวัตถุเฉพาะในฉากได้ เนื่องจากคนในคลิปถูกแบ่งออกเป็นหน่วยที่แยกจากกันโดยระบบที่ออกแบบมาเพื่อระบุคนและไม่ใช่วัตถุ – ปัญหาที่ดูเหมือนจะแก้ไขได้ง่ายๆ ด้วยเฟรมเวิร์กเช่น YOLO และที่ทำงานที่ยากกว่านั้นคือการดึงคลิปวิดีโอของมนุษย์ออกมา
แม้ว่านักวิจัยจะระบุว่าปัจจุบันไม่สามารถสร้างภาพช้าได้ แต่ก็มีไม่มีอะไรที่จะขัดขวางการนำไปใช้ของนวัตกรรมที่มีอยู่แล้ว เช่น DAIN และ RIFE ในการแทรกเฟรม
เช่นเดียวกับการใช้งาน NeRF ทั้งหมด และในหลายสาขาของการวิจัยการมองเห็นของคอมพิวเตอร์ ST-NeRF อาจล้มเหลวในกรณีที่มีการบดบังอย่างรุนแรง โดยที่วัตถุถูกบดบังโดยคนอื่นหรือวัตถุ และอาจยากต่อการติดตามหรือรับกลับหลังจากนั้น ในทางกลับกัน นักวิจัยยอมรับว่าการแทรกแซงด้วยมือเป็นเรื่องจำเป็นในเฟรมที่บดบัง
สุดท้าย นักวิจัยสังเกตเห็นว่าขั้นตอนการแบ่งส่วนของมนุษย์ในปัจจุบันขึ้นอยู่กับความแตกต่างของสี ซึ่งอาจทำให้เกิดการรวมกันของคนสองคนเข้าด้วยกันเป็นบล็อกการแบ่งส่วน – อุปสรรคที่ไม่จำกัดเฉพาะ ST-NeRF แต่เป็นส่วนหนึ่งของไลบรารีที่ใช้ และอาจแก้ไขได้ด้วยการวิเคราะห์กระแส光และเทคนิคที่เกิดขึ้นใหม่อื่นๆ
เผยแพร่ครั้งแรกเมื่อวันที่ 7 พฤษภาคม 2021


