
มุมมองของ Anderson
RigNeRF: วิธีการสร้าง Deepfakes ใหม่ที่ใช้ Neural Radiance Fields

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญRigNeRF เป็นวิธีการสร้างดีปเฟคที่ใช้งานได้จริงเป็นวิธีแรกที่ใช้ Neural Radiance Fields…
ดูเพิ่มเติม
- RigNeRF เป็นวิธีการสร้างดีปเฟคที่ใช้งานได้จริงเป็นวิธีแรกที่ใช้ Neural Radiance Fields ร่วมกับการควบคุมด้วย 3DMM
- ระบบนี้ต้องการเพียงวิดีโอจากสมาร์ทโฟนความยาว 70 วินาทีสำหรับการฝึกอบรม แตกต่างจากชุดข้อมูลของออโต้เอนโคเดอร์ที่ต้องใช้ความพยายามมาก
- RigNeRF ช่วยให้สามารถสังเคราะห์ฉากทั้งหมดได้ รวมถึงร่างกายและพื้นหลัง ไม่ใช่แค่การสลับใบหน้าเท่านั้น
การวิจัยใหม่ที่พัฒนาโดย Adobe (ADBE ) เป็นการนำเสนอวิธีการสร้าง Deepfakes ที่มีประสิทธิภาพและเป็นไปได้ครั้งแรกโดยใช้ Neural Radiance Fields (NeRF) – อาจเป็นนวัตกรรมแรกในด้านสถาปัตยกรรมหรือแนวทางในรอบ 5 ปีนับตั้งแต่การเกิดขึ้นของ Deepfakes ในปี 2017
วิธีการชื่อ RigNeRF ใช้ แบบจำลองใบหน้าสามมิติที่ปรับรูปร่างได้ (3DMM) เป็นชั้นควบคุมระหว่างข้อมูลเข้าที่ต้องการ เช่น อัตลักษณ์ที่จะนำไปแสดงใน NeRF กับปริภูมิประสาท วิธีนี้มีการใช้อย่างแพร่หลายในช่วงหลายปีที่ผ่านมาในแนวทางสังเคราะห์ใบหน้าด้วยเครือข่ายปฏิปักษ์เชิงกำเนิด (GAN) แต่จนถึงเวลาที่บทความนี้เผยแพร่ ยังไม่มีแนวทางใดสร้างเฟรมเวิร์กสลับใบหน้าสำหรับวิดีโอที่ใช้งานได้จริงและเป็นประโยชน์
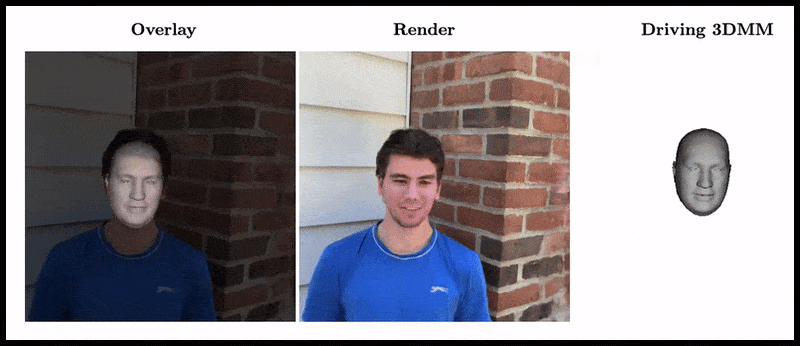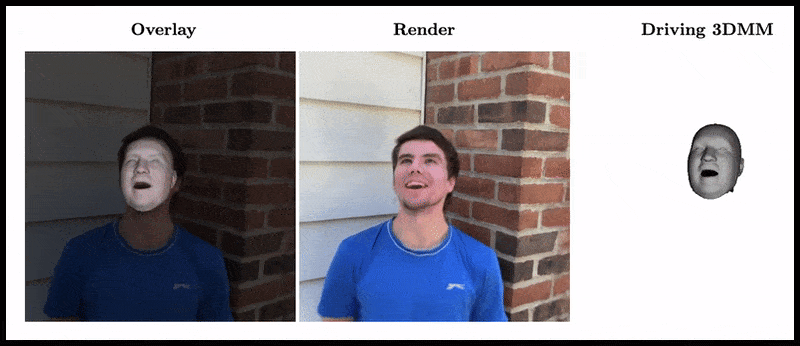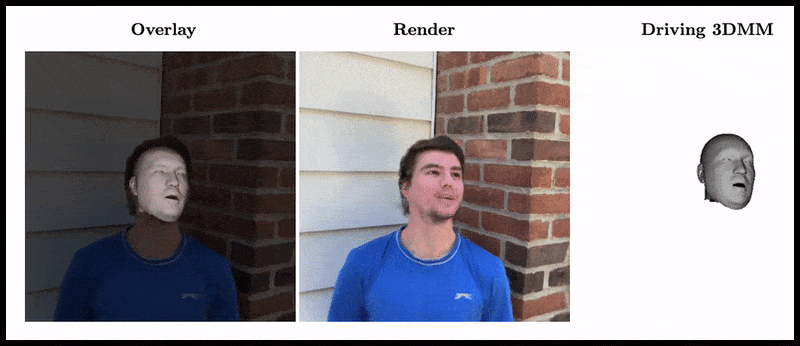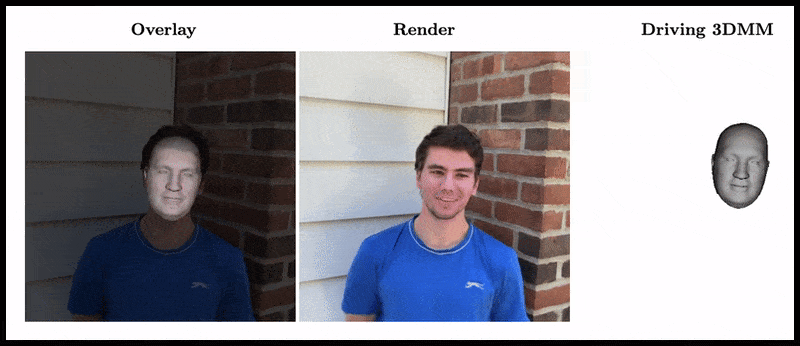
ต่างจากวิดีโอ deepfake แบบดั้งเดิม เนื้อหาที่เคลื่อนไหวทั้งหมดในภาพนี้ไม่ใช่ของจริง แต่เป็นปริภูมิประสาทที่สำรวจได้และฝึกด้วยวิดีโอสั้น ทางขวา 3DMM ทำหน้าที่เป็นตัวกลางระหว่างการควบคุมที่ต้องการ เช่น ยิ้ม มองซ้าย หรือมองขึ้น กับพารามิเตอร์ที่มักควบคุมได้ยากของ Neural Radiance Field ดูคลิปความละเอียดสูงและตัวอย่างอื่นได้ที่หน้าโครงการหรือวิดีโอท้ายบทความ แหล่งที่มา: https://shahrukhathar.github.io/2022/06/06/RigNeRF.html
3DMMs เป็นแบบจำลอง CGI ของใบหน้า ซึ่งพารามิเตอร์ของแบบจำลองสามารถปรับให้เหมาะสมกับระบบสังเคราะห์ภาพที่เป็นนามธรรม เช่น NeRF และ GAN ซึ่งโดยทั่วไปแล้วจะยากต่อการควบคุม
สิ่งที่คุณเห็นในภาพด้านบน (ภาพกลาง ชายใส่เสื้อเชิ้ตสีฟ้า) เช่นเดียวกับภาพด้านล่าง (ภาพซ้าย ชายใส่เสื้อเชิ้ตสีฟ้า) ไม่ใช่วิดีโอ ‘จริง’ ที่มีจุด ‘ปลอม’ ใบหน้าซ้อนทับ แต่เป็นฉากที่สังเคราะห์ขึ้นทั้งหมด ซึ่งมีอยู่เพียงในฐานะการแสดงผล Volumetric Neural – รวมทั้งร่างกายและพื้นหลัง:
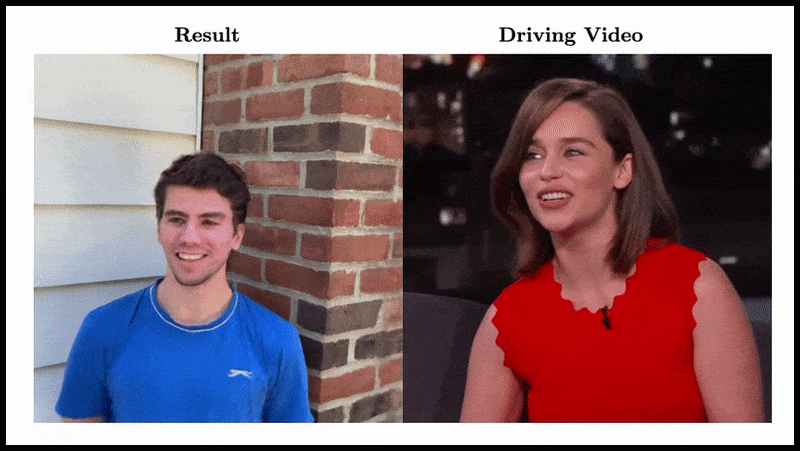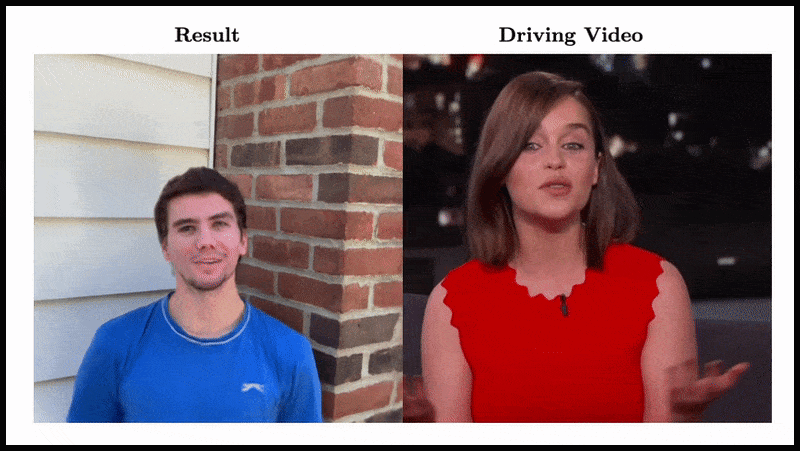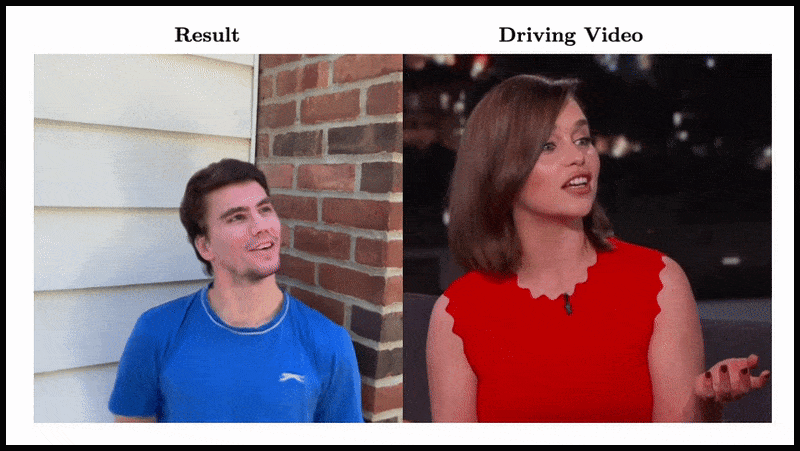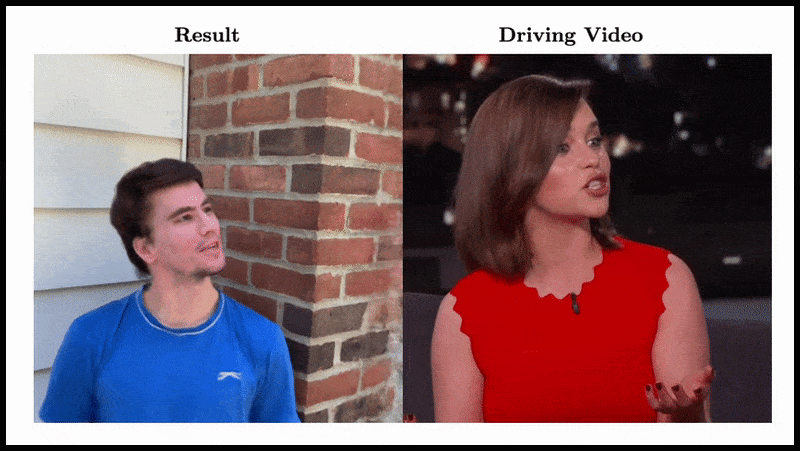
ในตัวอย่างด้านบน วิดีโอที่แท้จริงทางด้านขวามือ (หญิงใส่ชุดแดง) ถูกใช้ควบคุมอัตลักษณ์ที่บันทึกไว้เสมือนหุ่นเชิด (ชายใส่เสื้อเชิ้ตสีฟ้า) ทางด้านซ้ายผ่าน RigNeRF ซึ่ง (ผู้เขียนอ้างว่า) เป็นระบบ NeRF แรกที่สามารถแยกท่าทางและสีหน้าออกจากกัน ในขณะเดียวกันก็สามารถสังเคราะห์มุมมองที่ใหม่และไม่ซ้ำกัน
ตัวชายทางด้านซ้ายในภาพด้านบนถูก ‘จับ’ มาจากวิดีโอสมาร์ทโฟน 70 วินาที และข้อมูลเข้า (รวมทั้งข้อมูลฉาก) ถูกฝึกอบรมข้าม 4 V100 GPUs เพื่อให้ได้ฉาก
เนื่องจากโครงควบคุมเชิงพารามิเตอร์แบบ 3DMM ยังมีในรูปของแบบจำลองตัวแทน CGI เชิงพารามิเตอร์สำหรับทั้งร่างกาย ไม่ใช่เพียงใบหน้า RigNeRF จึงอาจเปิดทางสู่ deepfake ทั้งร่างกาย โดยส่งการเคลื่อนไหว พื้นผิว และสีหน้าของมนุษย์จริงไปยังชั้นพารามิเตอร์ CGI แล้วแปลงเป็นการกระทำและการแสดงออกในสภาพแวดล้อมและวิดีโอ NeRF
สำหรับ RigNeRF – มันคือวิธีการสร้าง Deepfakes ในความหมายที่เข้าใจกันในปัจจุบันหรือไม่? หรือเป็นเพียงอีกวิธีหนึ่งที่ไม่สมบูรณ์แบบเหมือนกับ DeepFaceLab และระบบ Autoencoder Deepfakes อื่นๆ ในปี 2017?
ผู้วิจัยระบุเรื่องนี้ไว้อย่างชัดเจน:
‘การเป็นวิธีการที่สามารถสร้างการเคลื่อนไหวของใบหน้าได้ RigNeRF มีแนวโน้มที่จะถูกใช้ในทางที่ผิดโดยผู้กระทำผิดเพื่อสร้าง Deepfakes.’
เอกสารใหม่ เอกสาร มีชื่อว่า RigNeRF: Fully Controllable Neural 3D Portraits และมาจาก ShahRukh Atha ของ Stonybrook University ผู้ฝึกงานที่ Adobe ในระหว่างการพัฒนา RigNeRF และผู้เขียนร่วมอีก 4 คนจาก Adobe Research
ก้าวพ้น deepfake ที่ใช้ตัวเข้ารหัสอัตโนมัติ
deepfake ที่แพร่หลายและเป็นข่าวส่วนใหญ่ในช่วงหลายปีก่อนบทความนี้สร้างด้วยระบบตัวเข้ารหัสอัตโนมัติ ซึ่งพัฒนาจากโค้ดที่เผยแพร่ใน subreddit r/deepfakes เมื่อปี 2017 ก่อนชุมชนดังกล่าวจะถูกแบนอย่างรวดเร็ว โค้ดถูกคัดลอกไปยัง GitHub ก่อนหน้านั้น และถูกแยกพัฒนามากกว่าหนึ่งพันครั้ง รวมถึงเป็นที่มาของซอฟต์แวร์ยอดนิยมที่มีข้อถกเถียงอย่าง DeepFaceLab และโครงการ FaceSwap
นอกจาก GAN และ NeRF แล้ว ระบบ Autoencoder ยังทดลองใช้ 3DMMs เป็น ‘แนวทาง’ สำหรับการสังเคราะห์ใบหน้าที่ดีขึ้น ตัวอย่างเช่น HifiFace project ในเดือนกรกฎาคม 2021 แต่จนถึงเวลาที่บทความนี้เผยแพร่ ยังไม่ปรากฏโครงการที่ใช้งานได้หรือได้รับความนิยมจากแนวทางนี้
ข้อมูลสำหรับ RigNeRF scenes จะได้มาจากการบันทึกวิดีโอสั้นๆ จากสมาร์ทโฟน สำหรับโครงการนี้ นักวิจัยของ RigNeRF ใช้ iPhone XR หรือ iPhone 12 สำหรับทุกๆ การทดลอง สำหรับครึ่งแรกของการบันทึก ผู้เข้าร่วมจะถูกขอให้แสดงสีหน้าและพูดคุยในขณะที่หัวไม่ขยับ และกล้องถูกย้ายไปรอบๆ
สำหรับครึ่งหลังของการบันทึก กล้องจะอยู่ในตำแหน่งคงที่ ในขณะที่ผู้เข้าร่วมต้องขยับหัวไปรอบๆ ในขณะที่แสดงสีหน้าต่างๆ ผลลัพธ์คือวิดีโอ 40-70 วินาที (ประมาณ 1200-2100 เฟรม) ซึ่งเป็นชุดข้อมูลทั้งหมดที่จะใช้ในการฝึกอบรมแบบจำลอง
ลดภาระการรวบรวมข้อมูล
ในทางตรงกันข้าม ระบบ Autoencoder เช่น DeepFaceLab ต้องการการรวบรวมและคัดเลือกภาพถ่ายหลายพันภาพ ซึ่งมักจะถูกนำมาจากวิดีโอใน YouTube และช่องทางสื่อโซเชียลอื่นๆ รวมทั้งจากภาพยนตร์ (ในกรณีของ Deepfakes ของคนดัง)
แบบจำลอง Autoencoder ที่ได้รับการฝึกอบรมมักจะถูกใช้ในหลายๆ สถานการณ์ อย่างไรก็ตาม ‘นักสร้าง Deepfakes’ ที่ตั้งใจจริงอาจฝึกอบรมแบบจำลองใหม่สำหรับวิดีโอเดียว แม้ว่าการฝึกอบรมจะใช้เวลาหนึ่งสัปดาห์หรือมากกว่านั้นก็ตาม
แม้มีคำเตือนจากนักวิจัยของเอกสารใหม่ ชุดข้อมูลที่ประกอบกันและถูกนำมารวมกันที่ใช้สร้างสื่อลามกด้วย AIและ ‘การนำ Deepfakes มาใช้ใหม่’ ใน YouTube/TikTok ที่ได้รับความนิยมดูเหมือนจะไม่น่าจะให้ผลลัพธ์ที่ยอมรับได้และสม่ำเสมอในระบบ Deepfakes เช่น RigNeRF ซึ่งมีวิธีการเฉพาะสำหรับฉาก การจำกัดข้อมูลที่ให้ไว้ในงานใหม่นี้อาจเป็นการป้องกันการนำอัตลักษณ์ไปใช้ในทางที่ผิดโดยผู้กระทำผิด
ปรับ NeRF สำหรับวิดีโอ deepfake
NeRF เป็นวิธีการ photogrammetry ที่ใช้ภาพหลายๆ ภาพที่ถูกถ่ายจากมุมมองที่แตกต่างกันเพื่อสร้างพื้นที่ประสาท 3 มิติที่สามารถสำรวจได้ วิธีการนี้ได้รับความสนใจเมื่อ NVIDIA (NVDA ) เปิดตัว Instant NeRF ซึ่งสามารถลดเวลาในการฝึกอบรม NeRF ลงเหลือเพียงไม่กี่นาทีหรือแม้กระทั่งวินาที:
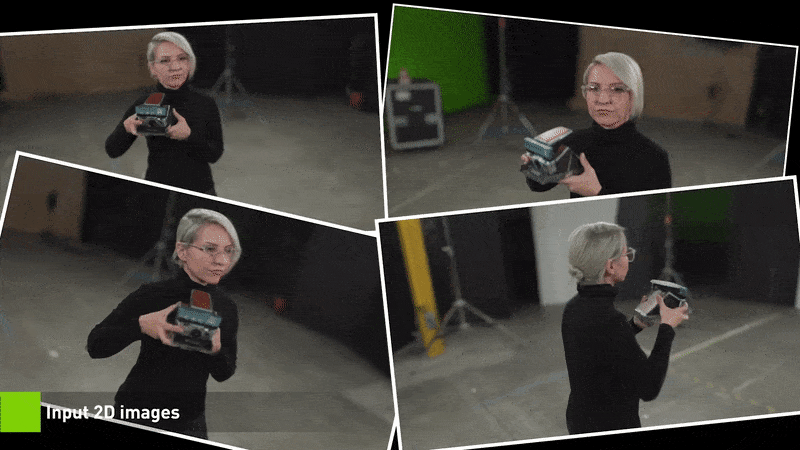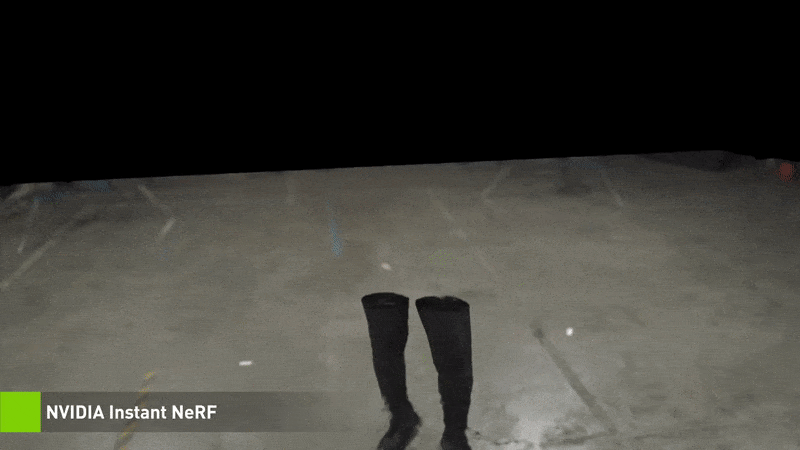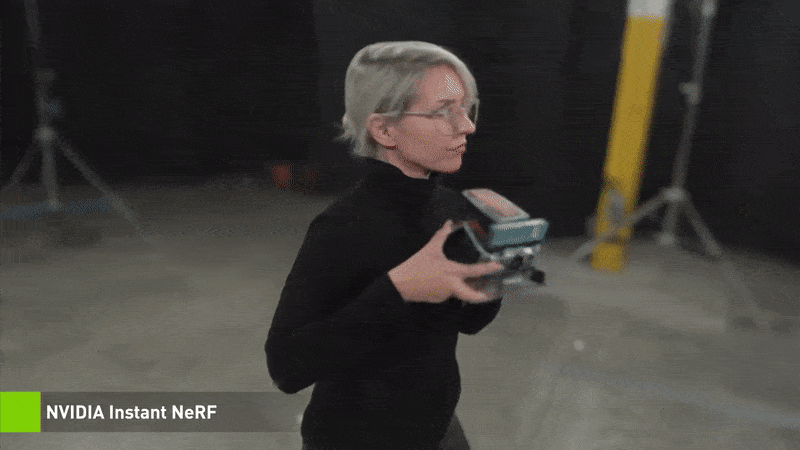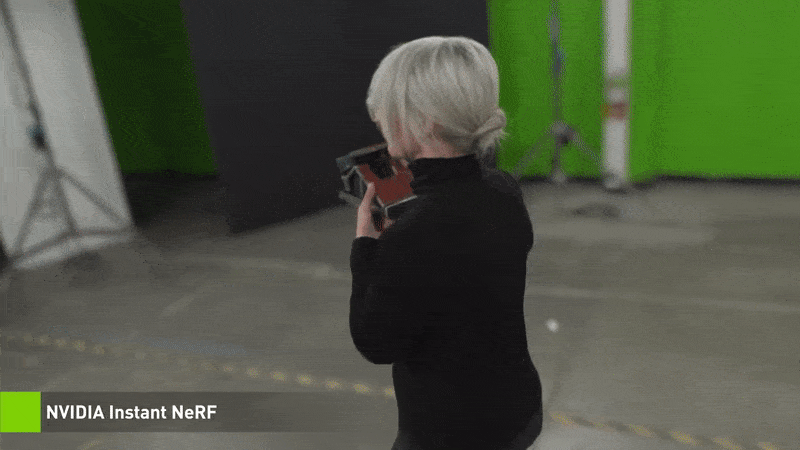
Instant NeRF. Source: https://www.youtube.com/watch?v=DJ2hcC1orc4
ฉาก Neural Radiance Field ที่ได้รับเป็นเพียงสภาพแวดล้อมที่คงที่ซึ่งสามารถสำรวจได้ แต่แก้ไขได้ยาก
นักวิจัยระบุว่ามี 2 โครงการก่อนหน้านี้ – HyperNeRF + E/P และ NerFACE – ที่ได้พยายามสังเคราะห์ใบหน้าใน NeRF และ (ดูเหมือนจะเพื่อความสมบูรณ์และความพิถีพิถัน) ได้ตั้งค่า RigNeRF เพื่อแข่งขันกับ 2 โครงการนี้:
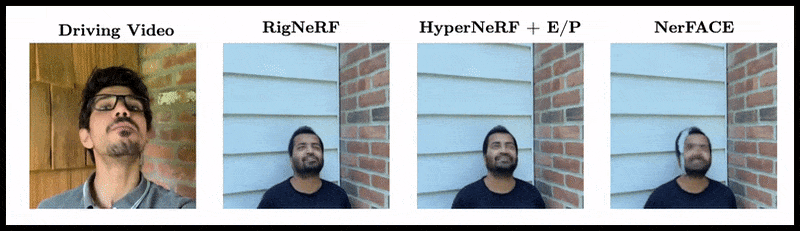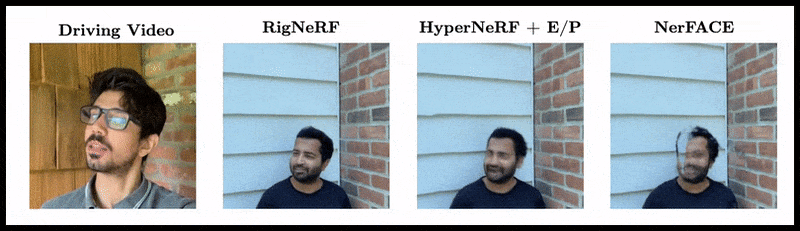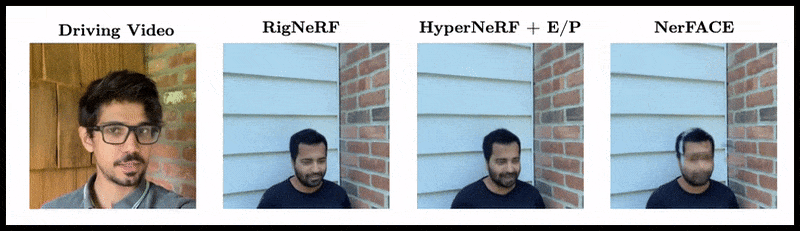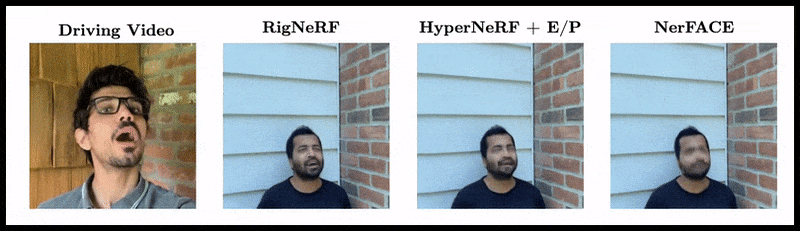
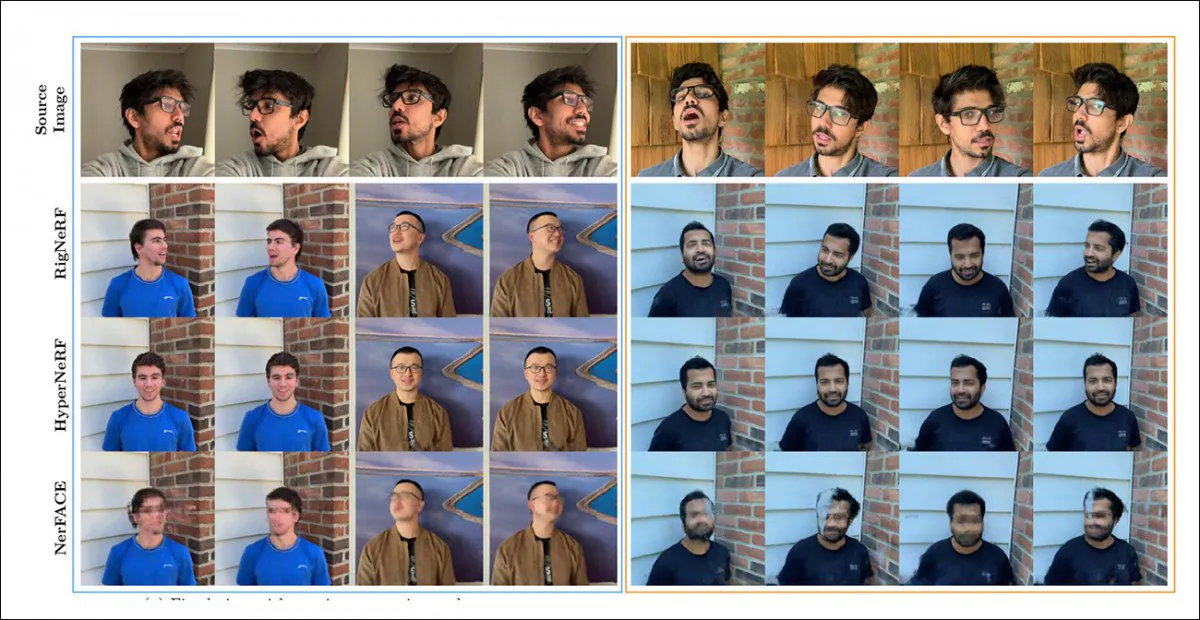
การเปรียบเทียบคุณภาพระหว่าง RigNeRF, HyperNeRF และ NerFACE ดูวิดีโอที่เชื่อมโยงและ PDF สำหรับเวอร์ชันที่มีคุณภาพสูงกว่า Static image source: https://arxiv.org/pdf/2012.03065.pdf
อย่างไรก็ตาม ผลลัพธ์ ซึ่งสนับสนุน RigNeRF นั้นไม่ปกติเนื่องจาก 2 เหตุผล: ประการแรก ผู้เขียนสังเกตว่า ‘ไม่มีการเปรียบเทียบที่เหมาะสม’; ประการที่สอง สิ่งนี้ทำให้จำเป็นต้องจำกัดความสามารถของ RigNeRF เพื่อให้ตรงกับฟังก์ชันการทำงานที่จำกัดของระบบก่อนหน้า
เนื่องจากผลลัพธ์ไม่ใช่การปรับปรุงที่ดีขึ้นของงานก่อนหน้า แต่เป็นความก้าวหน้าครั้งสำคัญด้านความสามารถในการแก้ไขและประโยชน์ใช้สอยของ NeRF เราจะไม่พิจารณาการทดสอบรอบนี้ แต่จะดูว่า RigNeRF ทำอะไรที่แตกต่างจากโครงการก่อนหน้า
ผสานจุดแข็ง
ข้อจำกัดหลักของ NerFACE ซึ่งควบคุมท่าศีรษะและสีหน้าในสภาพแวดล้อม NeRF ได้ คือสมมติว่าบันทึกวิดีโอต้นฉบับด้วยกล้องคงที่ จึงสร้างมุมมองใหม่ที่เกินขอบเขตการบันทึกไม่ได้ ระบบจึงสร้างภาพบุคคลเคลื่อนไหวได้ แต่ยังไม่เหมาะกับวิดีโอแบบ deepfake
HyperNeRF ในทางกลับกัน สามารถสร้างมุมมองที่ใหม่และสมจริงได้ แต่ไม่มีเครื่องมือที่ช่วยให้สามารถเปลี่ยนท่าทางหรือสีหน้าได้ ซึ่งไม่ได้สร้างระบบที่สามารถแข่งขันกับ Deepfakes ที่ใช้ Autoencoder ได้
RigNeRF สามารถรวมฟังก์ชันการทำงานที่แยกจากกันเหล่านี้ได้โดยการสร้าง ‘canonical space’ ซึ่งเป็นพื้นฐานมาตรฐานที่สามารถเปลี่ยนแปลงและบิดเบือนได้ผ่านการนำเข้าจากโมดูล 3DMM

การสร้าง ‘canonical space’ (ไม่มีท่าทาง ไม่มีสีหน้า) ซึ่งการบิดเบือน (เช่น ท่าทางและสีหน้า) ที่สร้างโดย 3DMM สามารถกระทำได้
เนื่องจากระบบ 3DMM จะไม่ตรงกับบุคคลที่บันทึกไว้อย่างสมบูรณ์ จึงจำเป็นต้องชดเชยในกระบวนการนี้ RigNeRF ประสานงานสิ่งนี้ด้วยข้อมูลก่อนหน้าของฟิลด์การเปลี่ยนรูป ซึ่งคำนวณจากเพอร์เซปตรอนหลายชั้น (MLP) ที่ได้รับจากภาพถ่ายต้นฉบับ

พารามิเตอร์ของกล้องที่จำเป็นในการคำนวณการบิดเบือนจะได้มาจาก COLMAP ในขณะที่พารามิเตอร์ของสีหน้าและรูปร่างสำหรับแต่ละเฟรมจะได้มาจาก DECA
การวางตำแหน่งจะถูกปรับให้เหมาะสมโดยใช้การปรับให้ตรงกับจุดอ้างอิง และพารามิเตอร์ของกล้อง COLMAP และเนื่องจากข้อจำกัดของทรัพยากรการคำนวณ ผลลัพธ์วิดีโอจะถูกย่อขนาดลงเหลือ 256×256 สำหรับการฝึกอบรม (กระบวนการย่อขนาดที่จำกัดด้วยฮาร์ดแวร์ซึ่งยังพบในระบบ Deepfakes ที่ใช้ Autoencoder)
หลังจากนั้น เครือข่ายการบิดเบือนจะถูกฝึกอบรมบน 4 V100s – ฮาร์ดแวร์ที่มีประสิทธิภาพสูงซึ่งไม่น่าจะอยู่ในความสามารถของนักสนใจทั่วไป (อย่างไรก็ตาม ในด้านการฝึกอบรม Machine Learning มักจะสามารถใช้พลังประมวลผลน้อยลงโดยยอมให้ใช้เวลาฝึกนานขึ้น และสามารถยอมรับได้ว่าการฝึกอบรมแบบจำลองจะใช้เวลาเป็นวันหรือแม้กระทั่งสัปดาห์)
สรุป นักวิจัยระบุว่า:
‘ไม่เหมือนกับวิธีการอื่นๆ RigNeRF ใช้โมดูลการเปลี่ยนรูปที่นำทางด้วย 3DMM จึงสร้างแบบจำลองท่าศีรษะ สีหน้า และฉากภาพบุคคลสามมิติทั้งหมดได้อย่างเที่ยงตรงสูง ทำให้ได้การสร้างภาพที่มีรายละเอียดชัดเจน’
ดูวิดีโอที่ฝังตัวอยู่ด้านล่างสำหรับรายละเอียดเพิ่มเติมและผลลัพธ์ของการสร้างภาพ
เผยแพร่ครั้งแรกเมื่อวันที่ 15 มิถุนายน 2022.


