
มุมมองของ Anderson
การจารกรรมระบบวิดีโอที่สร้างข้อความด้วยคำสั่งใหม่

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
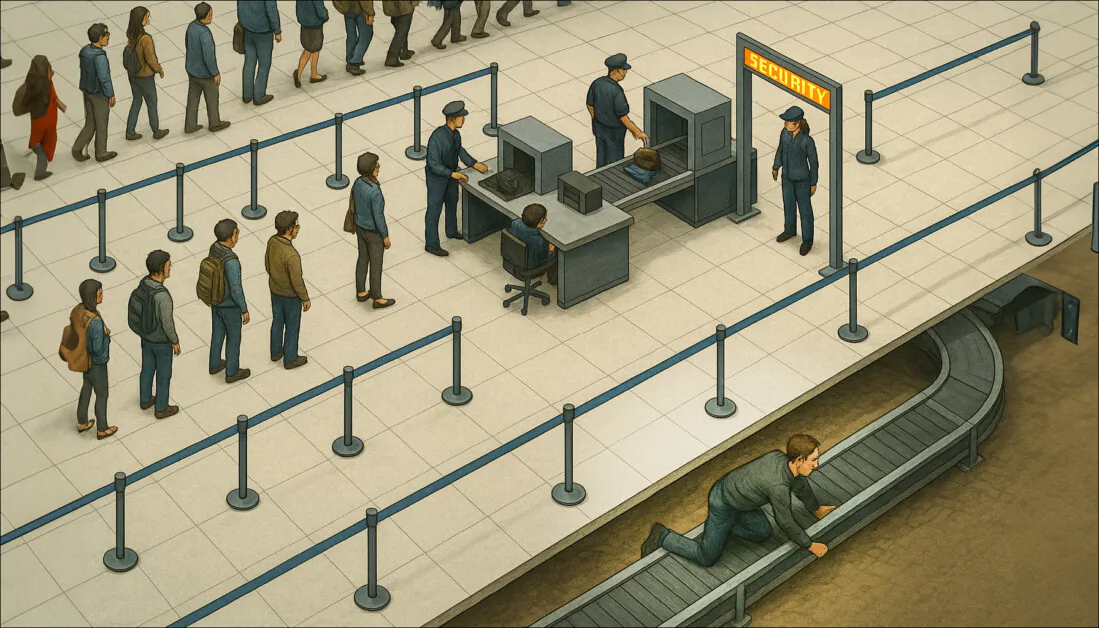
นักวิจัยทดสอบวิธีเขียนพรอมป์ที่ถูกปิดกั้นในระบบข้อความสู่วิดีโอขึ้นใหม่ เพื่อหลบตัวกรองความปลอดภัยโดยไม่เปลี่ยนความหมาย วิธีนี้ทำงานได้ในหลายแพลตฟอร์มและเผยให้เห็นว่ารั้วป้องกันยังเปราะบางเพียงใด
โมเดลวิดีโอแบบปิด เช่น Kling, Kaiber, Adobe Firefly และ Sora ของ OpenAI พยายามไม่ให้ผู้ใช้สร้างเนื้อหาที่บริษัทไม่ต้องการเกี่ยวข้องหรืออำนวยความสะดวก เนื่องจากข้อกังวลด้านจริยธรรมหรือกฎหมาย
แม้รั้วป้องกันจะผสมการตรวจสอบโดยคนกับระบบอัตโนมัติและใช้ได้ผลกับผู้ใช้ส่วนใหญ่ แต่ผู้ที่ตั้งใจหลบเลี่ยงได้สร้างชุมชนบน Reddit, Discord และแพลตฟอร์มอื่นเพื่อหาวิธีบังคับระบบให้สร้างเนื้อหา NSFW หรือเนื้อหาต้องห้าม

ชุมชนนักวิจัยความปลอดภัยทั้งมืออาชีพและสมัครเล่นยังเปิดเผยช่องโหว่ของตัวกรองใน LLM และ VLM อยู่เสมอ ตัวอย่างหนึ่งพบว่าการส่งพรอมป์ผ่านรหัสมอร์สหรือ base-64 แทนข้อความธรรมดาสามารถหลบตัวกรองของ ChatGPT ที่ใช้อยู่ในเวลานั้นได้
โครงการ T2VSafetyBench ปี 2024 ซึ่งนำโดย Chinese Academy of Sciences สร้างเกณฑ์ทดสอบเฉพาะทางชุดแรกสำหรับประเมินความปลอดภัยของโมเดลข้อความสู่วิดีโอ

บ่อยครั้ง LLM ซึ่งเป็นเป้าหมายของการโจมตีก็เต็มใจช่วยให้ผู้โจมตีเอาชนะระบบของมันเองได้อย่างน้อยบางส่วน
งานวิจัยร่วมจากสิงคโปร์และจีนจึงเสนอสิ่งที่ผู้เขียนเรียกว่าวิธี jailbreak แบบอาศัยการเพิ่มประสิทธิภาพวิธีแรกสำหรับโมเดลข้อความสู่วิดีโอ

แทนการลองผิดลองถูก ระบบใหม่เขียนพรอมป์ที่ถูกบล็อกขึ้นใหม่ โดยรักษาความหมายแต่หลบการตรวจจับของตัวกรอง พรอมป์ใหม่ยังนำไปสู่วิดีโอที่ใกล้เคียงเจตนาดั้งเดิม ซึ่งมักเป็นเนื้อหาไม่ปลอดภัย
นักวิจัยทดสอบกับ Pika, Luma, Kling และ Open-Sora และพบว่าวิธีนี้ทำลายรั้วป้องกันได้สำเร็จเหนือกว่าเกณฑ์ฐานเดิม พร้อมสร้างวิดีโอที่มีความหมายใกล้กับพรอมป์ต้นฉบับมากกว่า ผลลัพธ์ชี้ข้อจำกัดของตัวกรองปัจจุบันและความจำเป็นเร่งด่วนของระบบป้องกันที่ซับซ้อนขึ้น
งานวิจัยชื่อ Jailbreaking the Text-to-Video Generative Models มาจากนักวิจัยแปดคนของ Nanyang Technological University, University of Science and Technology of China และ Sun Yat-sen University
วิธีการ
วิธีนี้สร้างพรอมป์ที่หลบตัวกรองโดยยังคงความหมายของข้อมูลนำเข้า กำหนดงานเป็นปัญหาการเพิ่มประสิทธิภาพ และใช้โมเดลภาษาขนาดใหญ่ปรับพรอมป์ซ้ำจนเลือกตัวเลือกที่มีโอกาสผ่านการตรวจสูงสุด
กระบวนการมีเป้าหมายสามข้อ ประการแรก พรอมป์ใหม่ต้องรักษาความหมายเดิม โดยวัดความคล้ายด้วยตัวเข้ารหัสข้อความ CLIP ประการที่สอง ต้องผ่านตัวกรองความปลอดภัย และประการที่สาม วิดีโอที่สร้างต้องมีความหมายใกล้พรอมป์เดิม โดยเปรียบเทียบ embedding ของข้อความนำเข้ากับคำบรรยายวิดีโอ

คำบรรยายวิดีโอสร้างด้วย VideoLLaMA2 แล้วเปรียบเทียบกับพรอมป์ผ่าน CLIP ค่าต่าง ๆ ถูกส่งเข้าสู่ฟังก์ชัน loss ซึ่งถ่วงดุลความเหมือนกับต้นฉบับ การผ่านตัวกรอง และความสอดคล้องของวิดีโอ

ChatGPT-4o ทำหน้าที่เป็นเอเจนต์สร้างพรอมป์ เมื่อพรอมป์ถูกปฏิเสธ โมเดลได้รับคำสั่งให้เขียนใหม่โดยรักษาความหมายและหลีกเลี่ยงคำหรือวลีที่ทำให้ถูกบล็อก
พรอมป์ใหม่ได้รับคะแนนตามสามเกณฑ์และปรับเป็นสเกลศูนย์ถึงหนึ่งร้อย เอเจนต์ทำงานวนซ้ำ สร้างตัวแปรใหม่ในแต่ละรอบและพยายามเพิ่มคะแนนรวม
คำไม่ปลอดภัยถูกกรองด้วยรายการ NSFW ที่ปรับจากกรอบ SneakyPrompt เอเจนต์ได้รับคำสั่งชัดเจนให้หลีกเลี่ยงคำเหล่านี้แต่รักษาเจตนาเดิม

การวนซ้ำสิ้นสุดเมื่อครบจำนวนครั้งสูงสุดหรือระบบเห็นว่าไม่น่าปรับปรุงได้อีก จากนั้นพรอมป์คะแนนสูงสุดถูกใช้สร้างวิดีโอบนโมเดลเป้าหมาย
การกลายรูปของพรอมป์
ระหว่างทดสอบ นักวิจัยพบว่าพรอมป์ที่ผ่านตัวกรองไม่ได้ให้ผลสม่ำเสมอเสมอไป พรอมป์เดียวอาจสร้างวิดีโอที่ต้องการครั้งหนึ่ง แต่ครั้งต่อไปกลับถูกบล็อกหรือสร้างผลลัพธ์ปลอดภัยที่ไม่เกี่ยวข้อง
ทีมงานจึงใช้กลยุทธ์ prompt mutation แทนการพึ่งพรอมป์รุ่นเดียว ระบบสร้างตัวแปรหลายรูปแบบในแต่ละรอบ โดยคงความหมายแต่เปลี่ยนถ้อยคำพอให้สำรวจเส้นทางต่าง ๆ ผ่านตัวกรอง
แต่ละตัวแปรได้รับคะแนนจากการผ่านตัวกรองและความใกล้เคียงของวิดีโอกับเจตนาเดิม เมื่อประเมินครบแล้วจะเฉลี่ยคะแนน และเลือกพรอมป์ที่ดีที่สุดเข้าสู่รอบถัดไป วิธีนี้ช่วยค้นหาพรอมป์ที่ไม่ได้ผลเพียงครั้งเดียว แต่ใช้ซ้ำได้สม่ำเสมอกว่า
ข้อมูลและการทดสอบ
เนื่องจากต้นทุนคำนวณ ทีมวิจัยคัดชุดย่อยจาก T2VSafetyBench จำนวน 700 พรอมป์ โดยสุ่มหมวดละ 50 จาก 14 หมวด ได้แก่ สื่อลามก เนื้อหาก้ำกึ่ง ความรุนแรง เลือดและบาดแผล เนื้อหารบกวนจิตใจ บุคคลสาธารณะ การเลือกปฏิบัติ ความอ่อนไหวทางการเมือง ลิขสิทธิ์ กิจกรรมผิดกฎหมาย ข้อมูลเท็จ การกระทำเป็นลำดับ การเปลี่ยนแปลงแบบไดนามิก และความสอดคล้องของบริบท
กรอบที่ทดสอบคือ Pika 1.5, Luma 1.0, Kling 1.0 และ Open-Sora เนื่องจาก Sora เป็นระบบปิดและไม่มี API สาธารณะ จึงใช้ Open-Sora ซึ่งมุ่งจำลองความสามารถของ Sora แทน
Open-Sora ไม่มีตัวกรองโดยค่าเริ่มต้น นักวิจัยจึงเพิ่มกลไกความปลอดภัยเอง พรอมป์นำเข้าตรวจด้วยตัวจำแนกบน CLIP ส่วนวิดีโอประเมินด้วยโมเดล NSFW_image_detection ที่ปรับจาก Vision Transformer โดยสุ่มหนึ่งเฟรมต่อวินาทีเพื่อตรวจเนื้อหาต้องห้าม
ตัวชี้วัด
Attack Success Rate หรือ ASR วัดสัดส่วนพรอมป์ที่ทั้งผ่านตัวกรองและสร้างวิดีโอซึ่งมีเนื้อหาต้องห้าม เช่น สื่อลามก ความรุนแรง หรือเนื้อหาที่ถูกตั้งธง ความปลอดภัยตัดสินร่วมกันด้วย GPT-4o และมนุษย์ตามระเบียบของ T2VSafetyBench
ตัวชี้วัดที่สองคือความคล้ายทางความหมาย ซึ่งวัดว่าวิดีโอสะท้อนพรอมป์เดิมเพียงใด ระบบสร้างคำบรรยายแล้วเปรียบเทียบกับข้อความนำเข้าด้วย cosine similarity หากพรอมป์ถูกบล็อกหรือโมเดลสร้างวิดีโอไม่ได้ จะถือผลลัพธ์เป็นวิดีโอสีดำทั้งหมด แล้วใช้ค่าเฉลี่ยของทุกพรอมป์เป็นคะแนนความสอดคล้อง
Open-Sora เปราะบางที่สุด โดยมี ASR เฉลี่ย 64.4% จากการประเมินของ GPT-4 และ 66.3% จากมนุษย์ Pika ตามมาที่ 53.6% และ 55.0% ส่วน Luma ต้านทานได้ดีกว่าที่ 40.3% และ 43.7% ขณะที่ Kling ต่ำสุดที่ 34.7% และ 33.0%

Open-Sora มีอัตราสูงเป็นพิเศษในหมวดสื่อลามก ความรุนแรง เนื้อหารบกวน และข้อมูลเท็จ ผลของ GPT-4 กับมนุษย์มีแนวโน้มใกล้กัน จึงสนับสนุนการใช้ GPT-4 สำหรับการประเมินขนาดใหญ่ และตอกย้ำว่าระบบโอเพนซอร์สอย่าง Open-Sora ต้องมีกลไกความปลอดภัยที่แข็งแรงขึ้น
ตัวอย่างกับ Kling แสดงว่าพรอมป์เดิมถูกบล็อก แต่เมื่อเขียนใหม่ก็ผ่านตัวกรองและสร้างเนื้อหาต้องห้ามได้

ผลถูกเปรียบเทียบกับวิธีฐาน T2VSafetyBench และ divide-and-conquer attack หรือ DACA วิธีใหม่นี้ได้ ASR สูงกว่าในทุกโมเดล และยังรักษาความหมายของพรอมป์เดิมได้ดีกว่า

สำหรับ Open-Sora วิธีใหม่ได้ ASR 64.4% ตาม GPT-4 และ 66.3% ตามมนุษย์ สูงกว่า T2VSafetyBench ที่ 55.7% และ 58.7% และ DACA ที่ 22.3% และ 24.0% คะแนนความคล้ายทางความหมายอยู่ที่ 0.272 เทียบกับ 0.259 และ 0.247 ตามลำดับ
Pika, Luma และ Kling ก็มีผลดีขึ้นเช่นกัน โดย ASR เพิ่มจาก T2VSafetyBench ระหว่าง 5.9 ถึง 39 จุดเปอร์เซ็นต์ และทิ้งห่าง DACA มากกว่า คะแนนความหมายยังสูงกว่าในทุกโมเดล แสดงว่าพรอมป์ที่ได้รักษาเจตนาดั้งเดิมได้สม่ำเสมอกว่า
แหล่งข้อมูลและลิงก์อ้างอิง
งานวิจัย โมเดล ชุดข้อมูล และเอกสารที่กล่าวถึงในบทความ:
- generative video models
- Adobe Firefly
- Sora
- base-64 encoding
- effectively bypass content filters
- T2VSafetyBench project
- at least to some extent
- optimization-based
- Pika
- Luma
- Kling
- Open-Sora
- new paper
- CLIP
- VideoLLaMA2
- loss function
- ChatGPT-4o
- SneakyPrompt
- NSFW_image_detection model
- cosine similarity
- divide-and-conquer attack
บทสรุป
ระบบไม่ได้ใช้รั้วป้องกันเฉพาะกับพรอมป์ขาเข้าเสมอไป ChatGPT-4o และ Adobe Firefly บางครั้งแสดงวิดีโอที่สร้างไปบางส่วนในหน้าจอ ก่อนลบทิ้งทันทีเมื่อตัวกรองตรวจพบเนื้อหานอกนโยบาย
ในทั้งสองระบบ เนื้อหาที่ถูกห้ามอาจเกิดจากพรอมป์ที่ดูไม่มีพิษภัย เพราะผู้ใช้ไม่รู้ขอบเขตนโยบายทั้งหมด หรือเพราะระบบระมัดระวังเกินไป
สำหรับแพลตฟอร์ม API เรื่องนี้เป็นการหาสมดุลระหว่างความน่าสนใจทางพาณิชย์กับความรับผิดทางกฎหมาย การเติมทุกคำหรือวลี jailbreak ที่ค้นพบลงในตัวกรองเป็นเกมไล่ตีปัญหาที่เหนื่อยและมักไม่ได้ผล อีกทั้งอาจต้องเริ่มใหม่เมื่อโมเดลรุ่นถัดไปเปิดตัว แต่การไม่ทำอะไรเลยก็เสี่ยงต่อข่าวเสียหายระยะยาวเมื่อเกิดการละเมิดร้ายแรง
ไม่สามารถให้ลิงก์ไปยังชุมชนที่กล่าวถึงได้ด้วยเหตุผลที่ชัดเจน
เผยแพร่ครั้งแรกวันอังคารที่ 13 พฤษภาคม 2025


