
มุมมองของ Anderson
ฮุนยวนคัสตอมนำเสนอวิดีโอดีปแฟกส์แบบซิงเกิลอิมเมจ พร้อมเสียงและซิงค์ลิป

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
บทความนี้กล่าวถึง HunyuanCustom ซึ่งเป็นเวิลด์โมเดลวิดีโอแบบหลายสื่อรุ่นใหม่ในตระกูล Hunyuan Video เนื่องจากงานวิจัยฉบับใหม่ครอบคลุมเนื้อหากว้างมาก และวิดีโอตัวอย่างหลายรายการในหน้าโครงการต้องผ่านการตัดต่อหรือประมวลผลเพิ่มเติมจึงจะอ่านรูปแบบการเปรียบเทียบได้ง่าย บทความนี้จึงนำเสนอภาพรวมและยกตัวอย่างจากคลังวิดีโอขนาดใหญ่เพียงบางส่วน
งานวิจัยเรียกระบบสร้างสื่อผ่าน API อย่าง Kling ว่า “Keling” แต่เพื่อความชัดเจน บทความนี้ใช้ชื่อ Kling ตลอดทั้งเรื่อง
Tencent กำลังเปิดตัว HunyuanCustom ซึ่งเป็นรุ่นใหม่ของ Hunyuan Video ระบบนี้มุ่งลดความจำเป็นของโมเดล Hunyuan LoRA ด้วยการสร้างวิดีโอปรับแต่งเฉพาะบุคคลในลักษณะคล้ายดีปเฟกจากภาพอ้างอิงเพียงภาพเดียว
วิดีโอเปรียบเทียบแรกแสดงภาพต้นฉบับที่ป้อนให้ HunyuanCustom ในคอลัมน์ซ้ายสุด และผลจากการตีความพรอมป์ของระบบใหม่ในคอลัมน์ถัดไป ส่วนคอลัมน์ที่เหลือเป็นผลจากระบบเชิงพาณิชย์และโอเพนซอร์สหลายชนิด ได้แก่ Kling, Vidu, Pika, Hailuo และ SkyReels-A2 ที่พัฒนาบน Wan
วิดีโอที่สองแสดงสามสถานการณ์สำคัญของรุ่นนี้ ได้แก่ บุคคลร่วมกับวัตถุ การเลียนแบบตัวละครคนเดียว และการลองสวมเสื้อผ้าเสมือนจริงที่รวมบุคคลกับเครื่องแต่งกาย
ตัวอย่างเหล่านี้เผยข้อจำกัดของระบบที่อาศัยภาพต้นฉบับเพียงภาพเดียว แทนที่จะใช้ภาพหลายมุมของบุคคลหรือวัตถุเดียวกัน
ในคลิปแรก ผู้ชายหันหน้าเข้ากล้องเกือบตลอดเวลา เขาก้มและหันศีรษะเพียงประมาณ 20–25 องศา หากหมุนมากกว่านั้น ระบบต้องเดารูปลักษณ์ด้านข้างจากภาพหน้าตรงเพียงภาพเดียว ซึ่งเป็นเรื่องยากมากและแทบเป็นไปไม่ได้ที่จะทำได้อย่างแม่นยำ
ตัวอย่างที่สองแสดงเด็กหญิงยิ้มในวิดีโอที่สร้างขึ้น เช่นเดียวกับภาพอ้างอิงนิ่ง เมื่อมีภาพเดียว HunyuanCustom ต้องเดาใบหน้าขณะพักโดยแทบไม่มีข้อมูลเพิ่มเติม และมุมใบหน้าก็ไม่ได้เบนออกจากกล้องมากกว่าตัวอย่างชายกินขนมก่อนหน้า
ในตัวอย่างสุดท้าย ภาพต้นฉบับของผู้หญิงและเสื้อผ้าที่กำหนดให้สวมไม่สมบูรณ์ ระบบจึงครอปฉากให้พอดีกับข้อมูลที่มี ซึ่งเป็นทางแก้ปัญหาข้อมูลนำเข้าที่ค่อนข้างเหมาะสม
แม้ระบบใหม่จะรับภาพหลายภาพได้ เช่น บุคคลกับขนม หรือบุคคลกับเสื้อผ้า แต่ดูเหมือนจะไม่รองรับภาพหลายมุมหรือมุมมองทางเลือกของตัวละครเดียวกัน จึงอาจจัดการสีหน้าหลากหลายหรือมุมผิดปกติได้ยาก ด้วยเหตุนี้ HunyuanCustom อาจยังแทนที่ระบบนิเวศ LoRA ที่เติบโตขึ้นหลัง HunyuanVideo เปิดตัวเมื่อเดือนธันวาคมไม่ได้ทั้งหมด เพราะ LoRA เหล่านั้นมักใช้ภาพฝึก 20–60 ภาพเพื่อสร้างตัวละครที่สม่ำเสมอจากหลายมุมและหลายสีหน้า
เชื่อมโยงกับเสียง
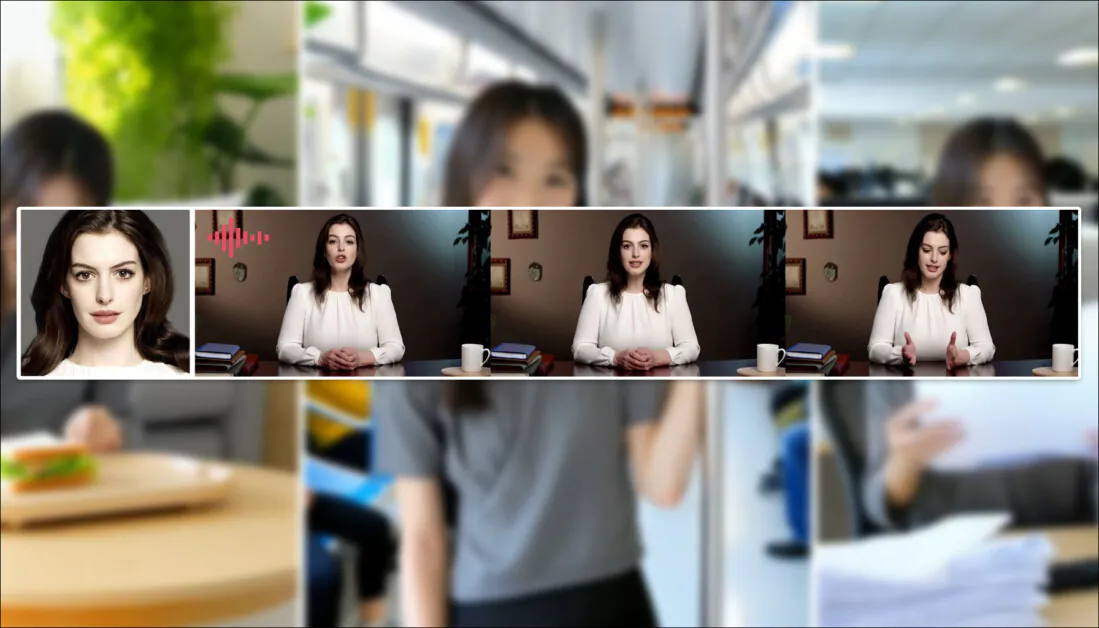
การประมวลผลเสียงใช้ LatentSync ซึ่งขึ้นชื่อว่าติดตั้งและปรับแต่งให้ได้ผลดีได้ยากสำหรับผู้ใช้ทั่วไป ระบบนี้สร้างการเคลื่อนไหวของริมฝีปากให้ตรงกับเสียงและข้อความที่ผู้ใช้ป้อน
ในขณะที่เขียนยังไม่มีตัวอย่างภาษาอังกฤษ แต่ผลที่เผยแพร่ดูดีทีเดียว โดยเฉพาะหากวิธีสร้างสามารถติดตั้งง่ายและเข้าถึงได้ทั่วไป
การแก้ไขวิดีโอที่มีอยู่
ระบบใหม่แสดงผลลัพธ์ที่น่าประทับใจสำหรับการตัดต่อแบบวิดีโอสู่วิดีโอ หรือ V2V/Vid2Vid โดยมาสก์ส่วนหนึ่งของวิดีโอจริงที่มีอยู่ แล้วแทนที่อย่างชาญฉลาดด้วยบุคคลหรือวัตถุจากภาพอ้างอิงเพียงภาพเดียว
ตามลักษณะทั่วไปของการประมวลผล Vid2Vid วิดีโอทั้งชิ้นเปลี่ยนไปในระดับหนึ่ง แม้บริเวณที่กำหนด เช่น ตุ๊กตาตรงกลาง จะเปลี่ยนมากที่สุด ในอนาคตอาจพัฒนาเวิร์กโฟลว์แบบ garbage matte เพื่อคงเนื้อหาส่วนใหญ่ให้เหมือนต้นฉบับ Adobe Firefly ใช้แนวทางลักษณะนี้เบื้องหลังได้ค่อนข้างดี แต่ยังมีการศึกษาน้อยในวงการสร้างสื่อโอเพนซอร์ส
ตัวอย่างอื่นทำงานผสานวัตถุเป้าหมายได้แม่นยำกว่า และรักษาส่วนที่ไม่ได้กำหนดให้แก้ไขไว้ได้อย่างชัดเจน
จุดเริ่มต้นใหม่หรือไม่
โครงการนี้เป็นการต่อยอด Hunyuan Video ไม่ใช่การเปลี่ยนทิศทางออกจากสายการพัฒนาเดิม ระบบเพิ่มองค์ประกอบทางสถาปัตยกรรมเป็นส่วน ๆ แทนการรื้อโครงสร้างทั้งหมด เพื่อรักษาอัตลักษณ์ข้ามเฟรมโดยไม่ต้องปรับแต่งเฉพาะวัตถุแบบ LoRA หรือ textual inversion
HunyuanCustom จึงไม่ได้ฝึกใหม่ตั้งแต่ต้น แต่เป็นการปรับละเอียดจากโมเดลฐาน HunyuanVideo ที่เปิดตัวในเดือนธันวาคม 2024
ผู้พัฒนา LoRA สำหรับ HunyuanVideo อาจสงสัยว่า LoRA เดิมจะยังทำงานกับรุ่นใหม่นี้หรือไม่ หรือจะต้องสร้างใหม่อีกครั้งหากต้องการความสามารถในการปรับแต่งที่เกินกว่าระบบมีมาให้
โดยทั่วไป การปรับละเอียดโมเดลขนาดใหญ่อย่างหนักจะเปลี่ยนน้ำหนักของโมเดลมากพอที่ LoRA สำหรับรุ่นก่อนทำงานผิดปกติหรือไม่ทำงานเลยกับรุ่นใหม่
อย่างไรก็ตาม บางครั้งโมเดลที่ผ่านการปรับละเอียดได้รับความนิยมจนกลายเป็นสายแยกของตัวเอง Pony Diffusion ซึ่งปรับจาก Stable Diffusion XL เป็นตัวอย่างหนึ่ง โดยมียอดดาวน์โหลดมากกว่า 592,000 ครั้งบน CivitAI และมี LoRA จำนวนมากที่ใช้ Pony แทน SDXL เป็นฐาน จึงต้องใช้ Pony ในขั้นอนุมาน
การเปิดตัว
หน้าโครงการของงานวิจัย HunyuanCustom: A Multimodal-Driven Architecture for Customized Video Generation เชื่อมไปยังที่เก็บ GitHub ซึ่งเพิ่งใช้งานได้ในเวลาที่เขียน และดูเหมือนมีโค้ด น้ำหนักโมเดล และกำหนดการสำหรับการติดตั้งในเครื่องครบถ้วน รายการสำคัญที่ยังรออยู่คือการเชื่อมต่อกับ ComfyUI
ขณะเดียวกัน หน้าบน Hugging Face ยังแสดงข้อผิดพลาด 404 แต่มีรุ่นผ่าน API ให้ทดลองได้หากผู้ใช้สามารถสแกนรหัสผ่าน WeChat
แทบไม่เคยมีโครงการใดนำองค์ประกอบจากงานหลากหลายมาประกอบกันอย่างกว้างขวางเท่า HunyuanCustom และเงื่อนไขสิทธิ์ใช้งานบางรายการก็น่าจะกำหนดให้ต้องเปิดเผยโครงการเต็มรูปแบบ
หน้า GitHub ระบุโมเดลสองรุ่น ได้แก่ 720×1280 ที่ต้องใช้หน่วยความจำ GPU สูงสุด 80GB และ 512×896 ที่ต้องใช้สูงสุด 60GB ที่เก็บโค้ดอธิบายว่าการสร้างภาพขนาด 720×1280 จำนวน 129 เฟรมต้องใช้หน่วยความจำ GPU อย่างน้อย 24GB แต่จะช้ามาก และแนะนำ GPU 80GB เพื่อคุณภาพที่ดีกว่า ปัจจุบันทดสอบเฉพาะบน Linux
Hunyuan Video รุ่นก่อนถูกควอนไทซ์หลังการเปิดตัวอย่างเป็นทางการให้ทำงานบน VRAM ต่ำกว่า 24GB ได้ จึงมีเหตุผลที่จะคาดว่าชุมชนจะปรับรุ่นใหม่ให้เหมาะกับฮาร์ดแวร์ผู้บริโภคและใช้งานบน Windows ได้อย่างรวดเร็วเช่นกัน
เนื่องจากข้อมูลที่มากับการเปิดตัวมีจำนวนมหาศาล บทความนี้จึงให้ภาพรวมแทนการวิเคราะห์เชิงลึก ต่อไปจะเปิดดูโครงสร้างภายในของ HunyuanCustom โดยย่อ
ดูภายในงานวิจัย
กระบวนการข้อมูลของ HunyuanCustom ระบุว่าสอดคล้องกับกรอบ GDPR และรวมทั้งวิดีโอสังเคราะห์กับชุดข้อมูลวิดีโอโอเพนซอร์ส เช่น OpenHumanVid โดยแบ่งเป็นแปดหมวดหลัก ได้แก่ มนุษย์ สัตว์ พืช ภูมิประเทศ ยานพาหนะ วัตถุ สถาปัตยกรรม และแอนิเมชัน

การกรองขั้นต้นใช้ PySceneDetect แบ่งวิดีโอออกเป็นคลิปช็อตเดียว จากนั้นใช้ TextBPN-Plus-Plus ตัดวิดีโอที่มีข้อความบนหน้าจอ คำบรรยาย ลายน้ำ หรือโลโก้มากเกินไป
เพื่อแก้ความไม่สม่ำเสมอด้านความละเอียดและระยะเวลา คลิปถูกปรับให้ยาวห้าวินาที และปรับด้านสั้นเป็น 512 หรือ 720 พิกเซล การกรองความสวยงามใช้ Koala-36M พร้อมเกณฑ์เฉพาะ 0.06 สำหรับชุดข้อมูลที่ทีมวิจัยคัดสรร
การแยกวัตถุใช้โมเดลภาษาขนาดใหญ่ Qwen7B กรอบตรวจจับวัตถุ YOLO11X และ InsightFace ร่วมกันเพื่อระบุและตรวจสอบอัตลักษณ์บุคคล ส่วนวัตถุที่ไม่ใช่มนุษย์ใช้ QwenVL กับ Grounded SAM 2 เพื่อดึงกรอบล้อมรอบ และทิ้งกรอบที่เล็กเกินไป

เมื่อมีหลายวัตถุ ระบบใช้ Florence2 ทำคำอธิบายกรอบ ใช้ Grounded SAM 2 แบ่งส่วน แล้วจัดกลุ่มและแบ่งเฟรมฝึกตามเวลา
คลิปที่ผ่านการประมวลผลจะได้รับคำอธิบายประกอบด้วยระบบติดป้ายแบบมีโครงสร้างของทีม Hunyuan ซึ่งเพิ่มข้อมูลหลายชั้น เช่น คำบรรยายและทิศทางกล้อง นอกจากนี้ยังเพิ่มความหลากหลายของมาสก์ รวมถึงแปลงเป็นกรอบล้อมรอบ เพื่อลดการเรียนรู้เกินพอดีและให้โมเดลปรับตามรูปร่างวัตถุที่หลากหลาย
เสียงซิงก์ด้วย LatentSync และคลิปที่มีคะแนนการซิงก์ต่ำกว่าเกณฑ์จะถูกคัดออก วิดีโอที่ได้คะแนนประเมินคุณภาพ HyperIQA ต่ำกว่า 40 ก็ถูกตัดออกเช่นกัน จากนั้นใช้ Whisper ดึงคุณลักษณะจากแทร็กเสียงที่ผ่านการตรวจสอบเพื่อใช้ในงานขั้นต่อไป
ในขั้นคำอธิบายประกอบ โมเดลผู้ช่วยภาษา LLaVA มีบทบาทสำคัญ LLaVA สร้างคำบรรยายภาพและช่วยจัดแนวเนื้อหาภาพกับพรอมป์ข้อความ ทำให้เกิดสัญญาณการฝึกที่สอดคล้องกันในหลายสื่อ ความสามารถด้านการจัดแนวภาพกับภาษาช่วยเพิ่มความสม่ำเสมอทางความหมาย โดยเฉพาะฉากที่มีหลายวัตถุหรือมีความซับซ้อน

วิดีโอแบบกำหนดเอง
ทีมงานสร้างโมดูลสองตัวที่มี LLaVA เป็นศูนย์กลาง เพื่อสร้างวิดีโอจากภาพอ้างอิงและพรอมป์ ขั้นแรกคือปรับโครงสร้างอินพุตของ HunyuanVideo ให้รับภาพร่วมกับข้อความได้
พรอมป์ถูกจัดรูปแบบให้ฝังภาพโดยตรงหรือกำกับด้วยคำอธิบายอัตลักษณ์สั้น ๆ และใช้โทเคนคั่นเพื่อไม่ให้เวกเตอร์แทนภาพกลบเนื้อหาของพรอมป์
ตัวเข้ารหัสภาพของ LLaVA มีแนวโน้มบีบอัดหรือทิ้งรายละเอียดเชิงพื้นที่ขนาดเล็กระหว่างจัดแนวคุณลักษณะภาพและข้อความ โดยเฉพาะเมื่อแปลงภาพอ้างอิงภาพเดียวเป็นตัวแทนความหมายทั่วไป จึงมีการเพิ่มโมดูลเสริมอัตลักษณ์ โมเดลวิดีโอแบบ latent diffusion ส่วนใหญ่รักษาอัตลักษณ์โดยไม่มี LoRA ได้ยากแม้ในคลิปห้าวินาที ผลการใช้งานจริงของโมดูลนี้จึงมีความสำคัญ
ภาพอ้างอิงถูกปรับขนาดและเข้ารหัสด้วย causal 3D-VAE จาก HunyuanVideo เดิม แล้วแทรก latent ลงในพื้นที่ latent ของวิดีโอตลอดแกนเวลา พร้อมออฟเซ็ตเชิงพื้นที่เพื่อป้องกันไม่ให้ระบบคัดลอกภาพตรง ๆ ขณะยังใช้ภาพนั้นนำทางการสร้าง
โมเดลฝึกด้วย Flow Matching โดยสุ่มสัญญาณรบกวนจากการแจกแจง logit-normal เครือข่ายเรียนรู้การกู้วิดีโอที่ถูกต้องจาก latent ที่มีสัญญาณรบกวน และปรับละเอียด LLaVA กับตัวสร้างวิดีโอร่วมกันเพื่อให้ภาพกับพรอมป์นำทางผลลัพธ์ได้ลื่นไหลและรักษาอัตลักษณ์
สำหรับพรอมป์ที่มีหลายวัตถุ ระบบฝังคู่ภาพและข้อความแต่ละคู่แยกกันและกำหนดตำแหน่งเวลาต่างกัน จึงแยกอัตลักษณ์ออกจากกันและสร้างฉากที่มีหลายวัตถุโต้ตอบกันได้
เสียงและภาพ
HunyuanCustom ใช้ทั้งเสียงจากผู้ใช้และพรอมป์ข้อความเป็นเงื่อนไข เพื่อสร้างฉากที่ตัวละครพูดอยู่ในสภาพแวดล้อมตามคำอธิบาย
โมดูล Identity-disentangled AudioNet เพิ่มคุณลักษณะเสียงโดยไม่รบกวนสัญญาณอัตลักษณ์จากภาพอ้างอิงและพรอมป์ คุณลักษณะเหล่านี้ถูกจัดแนวกับไทม์ไลน์วิดีโอที่บีบอัด แบ่งเป็นช่วงระดับเฟรม และแทรกด้วย spatial cross-attention ที่แยกแต่ละเฟรมออกจากกัน จึงรักษาความสม่ำเสมอของวัตถุและหลีกเลี่ยงการรบกวนข้ามเวลา
โมดูลแทรกตามเวลาอีกตัวทำงานร่วมกับ AudioNet เพื่อควบคุมจังหวะและการเคลื่อนไหวอย่างละเอียด โดยจับคู่คุณลักษณะเสียงกับบริเวณเฉพาะของลำดับ latent และใช้ Multi-Layer Perceptron แปลงเป็นออฟเซ็ตการเคลื่อนไหวระดับโทเคน ทำให้ท่าทางและสีหน้าตามจังหวะและน้ำหนักเสียงพูดได้แม่นยำขึ้น
HunyuanCustom แก้ไขวัตถุในวิดีโอเดิมได้โดยตรง ทั้งการแทนหรือแทรกบุคคลและสิ่งของ โดยไม่ต้องสร้างคลิปใหม่ทั้งหมด จึงเหมาะกับงานที่ต้องเปลี่ยนรูปลักษณ์หรือการเคลื่อนไหวเฉพาะส่วน
ระบบหลีกเลี่ยงแนวทางที่ใช้ทรัพยากรมากอย่าง VACE หรือวิธีที่รวมลำดับวิดีโอทั้งชุด โดยบีบอัดวิดีโออ้างอิงด้วย causal 3D-VAE ที่ฝึกไว้ จัดแนวกับ latent ภายในของกระบวนการสร้าง แล้วบวกสองส่วนเข้าด้วยกัน วิธีนี้ค่อนข้างเบาแต่ยังใช้วิดีโอภายนอกชี้นำผลลัพธ์ได้
โครงข่ายประสาทขนาดเล็กจัดแนววิดีโอต้นฉบับที่สะอาดกับ latent ที่มีสัญญาณรบกวน ทีมวิจัยทดสอบทั้งการรวมคุณลักษณะสองชุดก่อนบีบอัดใหม่ และการบวกคุณลักษณะทีละเฟรม วิธีหลังให้ผลดีกว่า หลีกเลี่ยงการสูญเสียคุณภาพ และไม่เพิ่มภาระการคำนวณ
ข้อมูลและการทดสอบ
การประเมินใช้ตัวชี้วัดหลายชนิด โมดูลความสม่ำเสมอของอัตลักษณ์ ArcFace ดึงเวกเตอร์ใบหน้าจากภาพอ้างอิงและแต่ละเฟรมของวิดีโอที่สร้าง แล้วคำนวณค่า cosine similarity เฉลี่ย ส่วนความคล้ายของวัตถุวัดโดยส่งส่วนที่ YOLO11X ตัดไปเปรียบเทียบด้วย DINO 2
CLIP-B-T วัดความสอดคล้องระหว่างพรอมป์กับวิดีโอ อีกตัวชี้วัดจาก CLIP-B เปรียบเทียบแต่ละเฟรมกับเฟรมข้างเคียงและเฟรมแรกเพื่อวัดความต่อเนื่องตามเวลา ส่วนระดับการเคลื่อนไหวใช้คำจำกัดความของ VBench
คู่แข่งเชิงพาณิชย์ที่ใช้เป็นฐานเปรียบเทียบ ได้แก่ Hailuo, Vidu 2.0, Kling 1.6 และ Pika ส่วนกรอบโอเพนซอร์ส ได้แก่ VACE และ SkyReels-A2
ผู้เขียนระบุว่า HunyuanCustom ได้ผลดีที่สุดด้านความสม่ำเสมอของอัตลักษณ์และวัตถุ พร้อมผลใกล้เคียงคู่แข่งด้านการทำตามพรอมป์และความต่อเนื่องตามเวลา Hailuo ได้คะแนน CLIP สูงสุดเพราะทำตามข้อความได้ดี แต่แลกด้วยความสม่ำเสมอของวัตถุที่ไม่ใช่มนุษย์ จึงมี DINO-Sim ต่ำที่สุด ส่วน Vidu และ VACE มีระดับการเคลื่อนไหวต่ำ ซึ่งอาจเกิดจากขนาดโมเดลที่เล็ก

หน้าโครงการเต็มไปด้วยวิดีโอเปรียบเทียบ แต่การจัดวางเน้นความสวยงามของเว็บไซต์มากกว่าการเปรียบเทียบอย่างง่าย และยังไม่มีวิดีโอที่จัดตรงกับผลลัพธ์นิ่งใน PDF ผู้อ่านจึงควรตรวจทั้งวิดีโอต้นฉบับในหน้าโครงการและ PDF อย่างละเอียด
ในการปรับแต่งวิดีโอแบบเน้นวัตถุ ทีมวิจัยพบว่า Vidu, SkyReels-A2 และ HunyuanCustom ทำได้ค่อนข้างดีด้านการจัดแนวพรอมป์และความสม่ำเสมอของวัตถุ แต่ HunyuanCustom ให้คุณภาพวิดีโอดีกว่าเพราะใช้สมรรถนะของโมเดลฐาน HunyuanVideo-13B

Kling มีคุณภาพวิดีโอดี แต่บางครั้งเฟรมแรกดูเหมือนคัดลอกแล้ววาง และวัตถุเคลื่อนเร็วเกินจนเบลอ ทำให้ประสบการณ์รับชมแย่ลง Pika มีความต่อเนื่องตามเวลาต่ำและสร้างสิ่งรบกวนคล้ายคำบรรยาย Hailuo รักษาใบหน้าได้แต่รักษาร่างกายทั้งตัวไม่ดี ส่วน VACE รักษาอัตลักษณ์ไม่ได้ ขณะที่ผู้เขียนอ้างว่า HunyuanCustom รักษาอัตลักษณ์ได้ดีพร้อมคงคุณภาพและความหลากหลาย
ในการปรับแต่งหลายวัตถุ Pika สร้างวัตถุที่กำหนดได้แต่เฟรมไม่เสถียร บางฉากผู้ชายหายไป และอีกฉากผู้หญิงไม่เปิดประตูตามพรอมป์ Vidu กับ VACE จับอัตลักษณ์มนุษย์ได้บางส่วนแต่สูญเสียรายละเอียดสำคัญของวัตถุที่ไม่ใช่มนุษย์ ส่วน SkyReels-A2 มีเฟรมไม่เสถียรและสิ่งรบกวนจำนวนมาก

ในทางกลับกัน ทีมวิจัยกล่าวว่า HunyuanCustom จับอัตลักษณ์ทั้งมนุษย์และวัตถุอื่นได้ ทำตามพรอมป์ และรักษาคุณภาพภาพกับความเสถียรในระดับสูง
การทดลองโฆษณามนุษย์เสมือนให้ระบบผสานผลิตภัณฑ์กับบุคคล HunyuanCustom รักษาอัตลักษณ์ของบุคคลพร้อมรายละเอียดของผลิตภัณฑ์ รวมถึงข้อความบนสินค้า ปฏิสัมพันธ์ระหว่างคนกับผลิตภัณฑ์ดูเป็นธรรมชาติและสอดคล้องกับพรอมป์ แสดงศักยภาพในการสร้างวิดีโอโฆษณา

การปรับแต่งวัตถุด้วยเสียงเปรียบเทียบกับวิธีเดิมที่รับเพียงภาพบุคคลและเสียง ทำให้ท่าทาง เสื้อผ้า และสภาพแวดล้อมถูกจำกัดตามภาพต้นฉบับ HunyuanCustom ให้ตัวละครพูดเสียงที่กำหนดในฉากและท่าทางที่อธิบายด้วยข้อความ จึงยืดหยุ่นและควบคุมได้มากกว่า

ในการทดสอบแทนวัตถุในวิดีโอ VACE เกิดสิ่งรบกวนตามขอบเพราะยึดมาสก์อินพุตมากเกินไป ทำให้รูปร่างไม่เป็นธรรมชาติและการเคลื่อนไหวขาดความต่อเนื่อง Kling ให้ผลคล้ายวางวัตถุทับบนวิดีโอ จึงกลืนกับฉากหลังได้ไม่ดี ขณะที่ผู้วิจัยประเมินว่า HunyuanCustom หลีกเลี่ยงปัญหาขอบ ผสานกับฉากหลังได้แนบเนียน และรักษาอัตลักษณ์ได้ดี

แหล่งข้อมูลและลิงก์อ้างอิง
งานวิจัย โครงการ โมเดล และเอกสารทางเทคนิคที่กล่าวถึงในบทความ:
- project page
- Hunyuan Video model
- Hunyuan LoRA models
- Kling
- Vidu
- Pika
- Hailuo
- Wan
- SkyReels-A2
- sprung up
- LatentSync
- garbage matte
- Hunyuan Video project
- fine-tuning
- yet again
- model weights
- Pony Diffusion
- Stable Diffusion XL
- ever-changing
- project page
- new paper
- GitHub site
- Hugging Face presence
- API-based version
- quantized
- GDPR
- OpenHumanVid
- PySceneDetect
- TextBPN-Plus-Plus
- Koala-36M
- Qwen7B
- YOLO11X
- InsightFace
- QwenVL
- Grounded SAM 2
- Florence2
- Mask augmentation
- overfitting
- HyperIQA
- Whisper
- LLaVA
- latent
- Flow Matching
- logit-normal
- cross-attention
- Multi-Layer Perceptron
- token-wise
- VACE
- ArcFace
- Dino 2
- CLIP-B
- VBench
บทสรุป
การเปิดตัวนี้น่าสนใจเพราะแก้ปัญหาที่ชุมชนผู้ใช้กล่าวถึงมากขึ้น คือการขาดลิปซิงก์ ซึ่งจะเพิ่มความสมจริงอีกระดับให้ระบบอย่าง Hunyuan Video และ Wan 2.1
รูปแบบวิดีโอเปรียบเทียบในหน้าโครงการทำให้ประเมิน HunyuanCustom กับรุ่นก่อนหน้าโดยตรงได้ยาก อย่างไรก็ตาม มีโครงการสังเคราะห์วิดีโอน้อยมากที่กล้าทดสอบตนเองกับ Kling ซึ่งเป็น API วิดีโอเชิงพาณิชย์ที่มักอยู่ใกล้อันดับสูงสุด Tencent ดูเหมือนทำความก้าวหน้าที่น่าประทับใจเมื่อต้องแข่งขันกับระบบดังกล่าว
วิดีโอบางรายการกว้างมาก มีความสูงน้อย และความละเอียดสูง จนไม่สามารถเล่นในเครื่องเล่นทั่วไปอย่าง VLC หรือ Windows Media Player และแสดงเพียงหน้าจอดำ
เผยแพร่ครั้งแรกวันพฤหัสบดีที่ 8 พฤษภาคม 2025


