
มุมมองของ Anderson
ออกไปจากสายตา ออกไปจากใจ: การแก้ปัญหาที่ยิ่งใหญ่ที่สุดใน AI วิดีโอ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
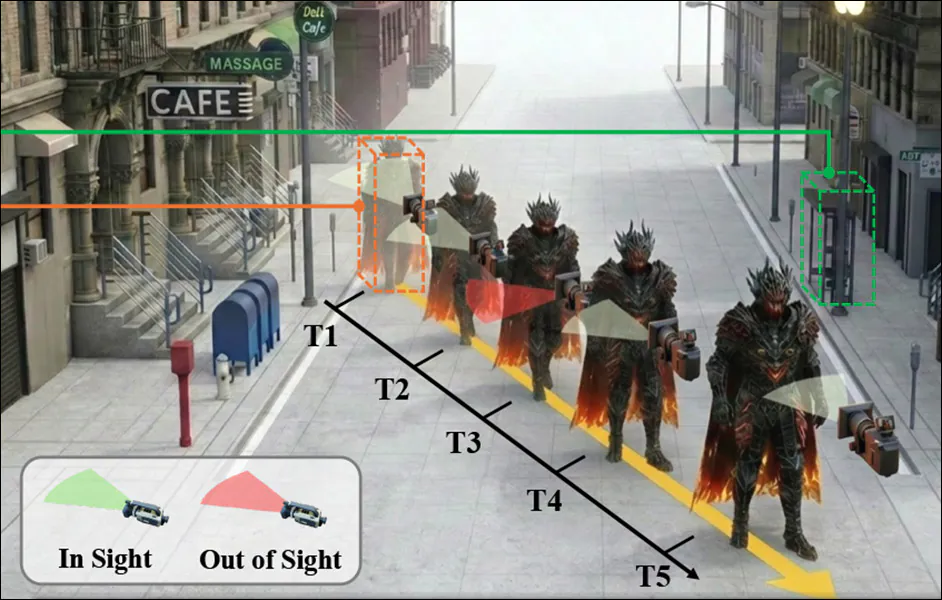
ปัญหาใหญ่ที่สุดของแม้แต่เครื่องมือสร้างวิดีโอ AI ที่ดีที่สุดก็คืออาการความจำเสื่อมเรื้อรัง ซึ่งงานวิจัยใหม่จากจีนกำลังพยายามแก้ไข
ปัญหาใหญ่ที่สุดของแม้แต่ระบบสร้างวิดีโอ AI ที่ดีที่สุดและล้ำสมัยที่สุดก็คือทุกระบบมีอาการความจำเสื่อมเรื้อรัง: หากกล้องแพนออกจากสิ่งที่กำลังจับภาพแล้วแพนกลับมา จะไม่พบสิ่งที่เคยอยู่ตรงนั้นเหมือนเดิม ตัวละครจะหายไป เปลี่ยนรูปลักษณ์และ/หรือรูปแบบการเคลื่อนไหว และฉากหลังก็น่าจะเปลี่ยนไปด้วย
สาเหตุคือระบบสร้างภาพที่อาศัยการแพร่มีหน้าต่างความสนใจแบบเลื่อนไปเรื่อยๆ ที่มีขนาดจำกัด และระบบประมวลผลอยู่เสมอเฉพาะสิ่งที่มองเห็นในขณะนั้น จึงเหมือนการแสดงออกอย่างแท้จริงของอัตตาเอกนิยม กล่าวคือสิ่งที่อยู่นอกเฟรมไม่มีอยู่สำหรับ AI เชิงกำเนิด เพราะถูกทิ้งออกจากหน่วยความจำไปจริงๆ
เรื่องนี้ไม่เคยเป็นปัญหาสำหรับ CGI แบบดั้งเดิม ซึ่งสามารถอ้างอิงและสร้างตัวละครหรือวัตถุเดิมได้อย่างแม่นยำเสมอ ทั้งรูปลักษณ์และการเคลื่อนไหว ณ จุดใดก็ตามในวิดีโอที่เรนเดอร์เมื่อจำเป็นต้องใช้อีกครั้ง:

โครงตาข่าย CGI และพื้นผิวบิตแมปแบบดั้งเดิมสามารถนำกลับมาเรนเดอร์ได้เสมอ จึงรักษารูปลักษณ์ให้สม่ำเสมอ แต่วิธีนี้ทำได้ยากกว่ามากในแนวทาง AI เพราะไม่มีไฟล์อ้างอิงแยกต่างหากแบบเดียวกันหรือชุดไฟล์ที่เกี่ยวข้องกัน
เหตุผลคือองค์ประกอบของ CGI เช่น โครงตาข่ายและพื้นผิวในภาพด้านบน รวมถึงไฟล์การเคลื่อนไหวและพฤติกรรมพลวัตอื่นๆ สามารถเก็บแยกไว้บนดิสก์และนำเข้าการประกอบภาพได้ทุกเมื่อ
AI สร้างวิดีโอไม่มีคลังข้อมูลอ้างอิงแยกเช่นนี้ สิ่งที่ใกล้เคียงที่สุดคือ LoRA ซึ่งเป็นไฟล์เสริมที่ฝึกมาเฉพาะและสามารถฝึกบนอุปกรณ์ระดับผู้บริโภคได้ ทำให้ตัวละครใหม่และเสื้อผ้าเฉพาะแบบ ถูกบังคับให้ปรากฏในวิดีโอได้:
คลิกเพื่อเล่น การใช้ LoRA ช่วยบรรเทาปัญหาอัตตาเอกนิยมของวิดีโอ AI ได้ระดับหนึ่ง แต่ผลลัพธ์อาจมีอิทธิพลรุนแรงเกินไป
อย่างไรก็ตาม นี่ยังไม่ใช่ทางออกที่เหมาะสม ประการแรก LoRA ผูกกับเวอร์ชันที่เฉพาะเจาะจงของโมเดลพื้นฐาน เช่น Wan2+ หรือ Hunyuan Video และ ต้องสร้างขึ้นใหม่ทุกครั้งที่โมเดลพื้นฐานเปลี่ยนไป ประการที่สอง LoRA มีแนวโน้มทำให้น้ำหนักของโมเดลพื้นฐานบิดเบือน จนอัตลักษณ์ที่ฝึกให้ LoRA ถูกนำไปใช้กับตัวละครทุกตัวในฉาก นอกจากนี้ วิธีปรับแต่งอย่างละเอียดประเภทนี้ยังไวอย่างมากต่อชุดข้อมูลที่คัดสรรมาไม่ดี
การกลับมาอย่างแม่นยำ
ขณะนี้ ความร่วมมือครั้งใหม่ระหว่างสถาบันการศึกษาและอุตสาหกรรมจากจีนเสนอวิธีแก้ไขที่มีนัยสำคัญเป็นครั้งแรกเท่าที่ผู้เขียนพบตลอดเวลากว่าสามปีที่รายงานปัญหานี้ วิธีดังกล่าวใช้สิ่งที่นักวิจัยเรียกว่า หน่วยความจำแบบไฮบริด เพื่อรักษาตัวละครที่อยู่นอกจอและสภาพแวดล้อมใกล้ตัวให้ยังคงทำงานและมีความแม่นยำอยู่ใน ปริภูมิแฝง ของโมเดล เมื่อมุมมองของเรากลับมาจึงได้ผลลัพธ์ที่สอดคล้องกัน:
คลิกเพื่อเล่น ตัวอย่างสองรายการจากเว็บไซต์โครงการของบทความใหม่ แสดงตัวละครที่สร้างด้วย AI (WAN) ออกจากเฟรมแล้วกลับเข้ามาอย่างแม่นยำ ที่มา
ต้องเน้นว่าสิ่งนี้ไม่ใช่เรื่องเดียวกับการรักษาความสม่ำเสมอของตัวละครข้ามช็อตต่างๆ ซึ่งมีการอ้างว่าทำได้แล้วเมื่อหนึ่งปีก่อนในการเปิดตัว Gen 4 ของ Runway และยังคงเป็น การ แสวงหา ที่ดำเนินต่อไป ในวรรณกรรมวิจัย
สิ่งที่แก้ไขได้ในงานนี้คือสิ่งที่ผู้เขียนยังไม่เคยเห็นเฟรมเวิร์กเชิงพาณิชย์หรือเชิงทดลองใดทำได้ นั่นคือ การกลับมาปรากฏอย่างสอดคล้องทางภาพของรูปลักษณ์ การเคลื่อนไหว และสภาพแวดล้อมเดิมของตัวละครที่อยู่นอกจอ:
คลิกเพื่อเล่น ตัวอย่างหลักอีกสองรายการจากเว็บไซต์โครงการของงานใหม่นี้
หลักการเดียวกันนี้ย่อมนำไปใช้ได้กับด้านอื่น เช่น การสำรวจเมือง การขับรถจากมุมมองบุคคลที่หนึ่ง หรือการเรนเดอร์ประเภทอื่นที่ไม่ได้เน้นตัวละคร
ต้องเน้นด้วยว่าแนวทางใหม่นี้ไม่ได้แก้ไขหรือพิจารณาปัญหาที่ Runway Gen4 และแพลตฟอร์มปิดซอร์สอื่นอ้างว่าแก้ไขแล้ว นั่นคือการสร้างตัวละครเดิมขึ้นใหม่ข้ามช็อตต่างๆ แต่ทำสิ่งที่แพลตฟอร์มเหล่านั้นยังไม่เคยสำเร็จ คือรักษาตัวละครและสภาพแวดล้อมไว้ในหน่วยความจำ โดยไม่จำเป็นต้องให้สิ่งเหล่านั้นอยู่ในสายตาผู้ชมตลอดเวลา
งานใหม่นี้ประกอบด้วยชุดข้อมูลเฉพาะที่สร้างด้วย Unreal Engine ตัวชี้วัดที่พัฒนาขึ้นสำหรับปัญหาอัตตาเอกนิยม* และเฟรมเวิร์กเชิงกำเนิดที่สร้างขึ้นเฉพาะบน WAN ในการทดสอบกับระบบที่คล้ายกันจำนวนไม่มากที่มีอยู่ ผู้เขียนอ้างว่าได้ผลลัพธ์ระดับแนวหน้า และแสดงความคิดเห็นว่า:
‘กลไก [ความจำ] กลายเป็นแนวหน้าสำคัญของการพัฒนาโมเดลโลก เพราะความจุของหน่วยความจำกำหนดความสม่ำเสมอเชิงพื้นที่และเวลาของเนื้อหาที่สร้างขึ้น
‘โดยเฉพาะอย่างยิ่ง ความจำเป็นเสมือนสมอทางการรับรู้ที่ทำให้โมเดลเก็บบริบทในอดีตไว้ได้ระหว่างการเปลี่ยนมุมมองหรือการคาดการณ์ต่อเนื่องระยะยาว
‘หากไม่มีหน่วยความจำที่แข็งแกร่ง โลกจำลองจะสลายอย่างรวดเร็วเป็นเฟรมที่ขาดการเชื่อมโยงและสับสนวุ่นวาย’
บทความใหม่ มีชื่อว่า Out of Sight but Not Out of Mind: Hybrid Memory for Dynamic Video World Models และมาจากนักวิจัยเจ็ดคนจาก Huazhong University of Science and Technology และทีม Kling ของ Kuaishou Technology
วิธีการ
แกนกลางของงานใหม่นี้คือ หน่วยความจำแบบไฮบริด ซึ่งช่วยให้เกิดการคาดการณ์นอกมุมมอง กล่าวคือรักษาตัวละครและบริบทไว้ขณะที่ผู้ชมมองไปทางอื่น หรือขณะที่ตัวละครเองออกจากมุมมอง ในสถานการณ์เช่นนี้ เฟรมเวิร์กต้องทำ การแยกการประมวลผลเชิงพื้นที่และเวลา โดยมุ่งทั้งการสร้างภาพที่ผู้ชมมองเห็นและการดำรงอยู่ของตัวละครที่อยู่นอกจอพร้อมกัน

ตัวอย่างการเคลื่อนกล้องที่ทำให้เกิดการเข้าและออกจากภาพ ในกรณีเหล่านี้ การเคลื่อนกล้องเป็นเหตุให้ตัวละครออกจากเฟรม แต่ในตัวอย่างอื่นๆ ยังเห็นตัวละครเคลื่อนตัวออกนอกจอชั่วคราวได้ด้วย ที่มา
ผู้เขียนระบุว่าใน เอมเบดดิง แฝงของระบบการแพร่ คุณลักษณะที่ต้องดึงออกมาใช้จะ พัวพันกันอย่างมาก กับคุณลักษณะและคุณสมบัติอื่น และการพยายามดึงคุณลักษณะเหล่านี้มักทำให้ตัวละครหยุดนิ่งติดกับฉากหลัง จึงออกแบบและคัดสรรชุดข้อมูล HM-World** ขึ้นมาเพื่อฝึกหน่วยความจำแบบไฮบริดโดยเฉพาะ:

ตัวอย่างจากบทความ แสดงสี่หมวดหมู่ที่มีอยู่ในชุดข้อมูล HM-World
ชุดข้อมูลสร้างขึ้นตามสี่มิติ ได้แก่ วิถีของตัวละครหรือวัตถุ, วิถีของกล้อง, ฉาก และ ตัวละครหรือวัตถุ
ข้อมูลสังเคราะห์ ใน HM-World ประกอบด้วย 17 ฉากและตัวละครหรือวัตถุ 49 แบบ รวมทั้งคนที่มีรูปลักษณ์หลากหลายและสัตว์หลายชนิด องค์ประกอบเหล่านี้ถูกนำมาจัดวางในฉากด้วยกระบวนการเชิงขั้นตอนผ่าน Unreal Engine แต่ละรายการมีแอนิเมชันการเคลื่อนไหวเฉพาะ แล้วเคลื่อนตามวิถีที่สุ่มเลือก
ผู้เขียนระบุว่าชุดข้อมูลแสดงเหตุการณ์ ออกจากภาพแล้วกลับเข้ามา ที่หลากหลาย โดยมีวิถีกล้อง 28 แบบ แต่ละแบบมีจุดเริ่มต้นหลายตำแหน่ง
ชุดข้อมูลสุดท้ายมีวิดีโอ 59,225 คลิป แต่ละคลิปได้รับการใส่คำอธิบายประกอบโดย MiniCPM-V ซึ่งเป็นโมเดลภาษาขนาดใหญ่หลายรูปแบบ (MLLM)
นักวิจัยชี้ให้เห็นข้อได้เปรียบเชิงสถิติของชุดข้อมูลนี้เมื่อเทียบกับชุดข้อมูลก่อนหน้า ได้แก่ WorldScore; Context-As-Memory; Multi-Cam Video และ 360° Motion:

การเปรียบเทียบชุดข้อมูลเดิมกับ HM-World โดย Dynamic Subject หมายถึงการมีตัวละครหรือวัตถุที่เคลื่อนไหว Subject Exit-Enter หมายถึงคลิปที่ตัวละครหรือวัตถุออกจากเฟรมแล้วกลับเข้ามา และ Subject Pose หมายถึงการมีคำอธิบายประกอบท่าทางสามมิติ
เส้นทางที่มีผู้เดินน้อยกว่า
เมื่อกำหนดเฟรมในอดีตหลายเฟรมและเส้นทางกล้องที่ทราบแล้ว งานคือการทำนายมุมมองในอนาคตขณะที่มุมมองผู้ชมเปลี่ยนไป โดยคำนึงถึงตัวละครหรือวัตถุที่เคลื่อนไหวอย่างอิสระและอาจออกจากเฟรมก่อนกลับเข้ามา งานนี้ต้องทำมากกว่ารักษาฉากหลังให้นิ่ง เพราะโมเดลต้องเก็บบันทึกภายในที่สอดคล้องกันว่าตัวละครหรือวัตถุที่เคลื่อนไหวแต่ละรายการมีรูปลักษณ์และพฤติกรรมอย่างไร แม้ในช่วงที่มองไม่เห็น
วิธี Hybrid Dynamic Retrieval Attention (HyDRA) ของผู้เขียนแก้ปัญหานี้ด้วยเส้นทางหน่วยความจำเฉพาะที่แยกตัวละครหรือวัตถุเคลื่อนไหวออกจากตัวแทนฉากคงที่ ทำให้ยังดำรงอยู่เมื่อเวลาผ่านไป และกลับมาด้วยรูปลักษณ์กับการเคลื่อนไหวที่สม่ำเสมอ:

แผนผังแนวคิดของโมเดล HyDRA
HyDRA สร้างขึ้นบน Wan2.1-T2V-1.3B โดยคงกระบวนการแพร่หลักไว้เกือบทั้งหมด แต่เพิ่มบล็อก ทรานส์ฟอร์เมอร์ ที่ปรับให้มีความสนใจแบบค้นคืนเชิงพลวัต ทำให้โมเดลเลือกเรียกคืนข้อมูลบ่งชี้การเคลื่อนไหวและรูปลักษณ์จากเฟรมในอดีต แทนที่จะพึ่งบริบทตายตัวหรือเฉพาะบริเวณใกล้เคียง
กระบวนการนี้ใช้เป้าหมายการฝึกแบบ Flow Matching ที่ปรับแล้ว แทน ค่าความสูญเสียการแพร่ มาตรฐาน
เพื่อให้ฉากสอดคล้องกับการเคลื่อนกล้อง ระบบใส่วิถีกล้องเป็นสัญญาณเงื่อนไขโดยตรง ท่าทางของกล้องในแต่ละเฟรมกำหนดด้วยการหมุนและการเลื่อนตำแหน่ง แล้วแปลงเป็นตัวแทนขนาดกะทัดรัดที่บันทึกว่ามุมมองเปลี่ยนอย่างไรตามเวลา
เช่นเดียวกับโครงการ ReCamMaster ของ Kling ก่อนหน้านี้ ผลลัพธ์จะผ่านตัวเข้ารหัสกล้องที่สร้างเป็น เพอร์เซปตรอนหลายชั้น จากนั้นกระจายและบวกเข้าในคุณลักษณะของ Diffusion Transformer ทำให้โมเดลรักษาตำแหน่งวัตถุให้สอดคล้องกันได้ขณะที่กล้องเคลื่อน
การสร้างโทเคน
ตัวแทนแฝงดิบของการแพร่ผสมการเคลื่อนไหว รูปลักษณ์ และฉากหลังไว้ในตัวแทนเดียวที่พัวพันกัน การค้นคืนโดยตรงจากปริภูมินี้เสี่ยงนำบริบทที่ไม่เกี่ยวข้องเข้ามา หรือทำให้ตัวละครที่เคลื่อนไหวกลืนเข้ากับฉาก
HyDRA แก้ปัญหานี้ด้วย Memory Tokenizer ที่อาศัยคอนโวลูชันสามมิติและประมวลผลพื้นที่กับเวลาร่วมกัน แทนที่จะส่งต่อประวัติตัวแทนแฝงทั้งหมด ระบบบีบอัดเป็นโทเคนหน่วยความจำขนาดกะทัดรัดที่รับรู้การเคลื่อนไหวและรักษารูปลักษณ์กับการเคลื่อนไหวของตัวละครไว้:

ภาพรวมของ HyDRA ด้านซ้าย Memory Tokenizer แปลงเฟรมก่อนหน้าเป็นโทเคนหน่วยความจำขนาดกะทัดรัดที่รับรู้การเคลื่อนไหว ด้านขวา Dynamic Retrieval Attention ประเมินคำค้นปัจจุบันเทียบกับโทเคนเหล่านี้ ดึงโทเคนที่เกี่ยวข้องมากที่สุด และใช้คืนรูปลักษณ์กับการเคลื่อนไหวที่สอดคล้องกันในเฟรมที่สร้างขึ้น
โทเคนเหล่านี้สร้างหน่วยความจำแบบไฮบริดที่มีโครงสร้าง ซึ่งกรองสัญญาณรบกวนแต่เก็บพลวัตระยะยาวไว้ เมื่อส่งไปยังโมดูล Dynamic Retrieval Attention จะช่วยให้โมเดลเลือกเรียกคืนตัวละครนอกจอ เพื่อให้กลับมาด้วยรูปลักษณ์ การเคลื่อนไหว และบริบทที่สอดคล้องกัน
ความสนใจแบบค้นคืนเชิงพลวัต
กลไกหน่วยความจำสองส่วนของ HyDRA ยังใช้ ความสนใจแบบค้นคืนเชิงพลวัต ในบทบาทที่แตกต่างแต่เสริมกันภายในเฟรมเวิร์ก
การสร้างโทเคนหน่วยความจำบีบอัดตัวแทนแฝงในอดีตเป็นโทเคนที่มีโครงสร้างและรับรู้การเคลื่อนไหว ซึ่งแยกตัวละครหรือวัตถุเคลื่อนไหวออกจากเนื้อหาฉากคงที่ ลดการพัวพันที่มักทำให้ตัวละครกลืนเข้ากับฉากหลัง โทเคนเหล่านี้สร้างคลังหน่วยความจำที่คงอยู่ แทนประวัติเฟรมทั้งหมด
จากนั้น Dynamic Retrieval Attention ทำงานกับคลังนี้ระหว่างการสร้างภาพ โดยเทียบคำค้นปัจจุบันกับโทเคนที่เก็บไว้และเลือกเรียกคืนส่วนที่เกี่ยวข้องที่สุดกับเฟรมที่กำลังพัฒนา ทำให้ตัวละครนอกจอยังพัฒนาสถานะแฝงต่อไป เช่น เดินหรือวิ่งต่อแม้มองไม่เห็น และกลับมาด้วยรูปลักษณ์กับการเคลื่อนไหวที่สอดคล้องกัน แทนการเริ่มใหม่หรือเสื่อมสภาพ
ข้อมูลและการทดสอบ
ในการทดสอบ ระบบ HyDRA ที่สร้างบน Wan เข้ารหัสและลดความละเอียดเฟรมบริบท 77 เฟรม ก่อนประมวลผลด้วยออโตเอนโคเดอร์แปรผันสามมิติ (VAE) ขณะที่ตัวสร้างโทเคนหน่วยความจำที่กล่าวถึงใช้ คอนโวลูชันสามมิติ ที่มี ขนาดเคอร์เนล 2x4x4
โมเดลฝึกบน HW-World จำนวน 10,000 รอบด้วย GPU 32 ตัวที่ไม่ได้ระบุชนิด โดยใช้ ขนาดแบตช์ 32
การทดสอบใช้ตัวชี้วัดจำนวนมากผิดปกติ นอกจากอัตราส่วนสัญญาณสูงสุดต่อสัญญาณรบกวน (PSNR) ดัชนีความคล้ายคลึงเชิงโครงสร้าง (SSIM) และตัวชี้วัดความคล้ายคลึงเชิงการรับรู้ที่เรียนรู้ (LPIPS) ตามปกติ ผู้เขียนยังใช้ ความสม่ำเสมอของตัวละครหรือวัตถุ และ ความสม่ำเสมอของฉากหลัง จากชุด VBench เพื่อประเมินความสอดคล้องระดับเฟรม
นอกจากนี้ ยังพัฒนาตัวชี้วัดเฉพาะชื่อ Dynamic Subject Consistency (DSC) ซึ่งใช้กรอบล้อมวัตถุจาก YOLO V11 สร้างบริเวณภาพตัดที่มีตัวละครหรือวัตถุเคลื่อนไหว แล้วดึงคุณลักษณะเชิงความหมายและคำนวณความคล้ายคลึง
HyDRA ถูกนำไปเปรียบเทียบกับ Diffusion Forcing Transformer (DFoT) และ Context-As-Memory โดยใช้โมเดลพื้นฐาน Wan2.1-T2V-1.3B ที่ติดตั้งตัวเข้ารหัสกล้องเพื่อแทนมุมมองผู้ชมซึ่งมีร่วมกันในทุกคลิป ทุกโมเดลฝึกบน HW-World และยังใช้ WorldPlay เป็นชุดทดสอบรองแบบ zero-shot ด้วย:
ในการเปรียบเทียบเชิงปริมาณเบื้องต้น HyDRA ทำได้ดีกว่าโมเดลพื้นฐานทุกตัว เพิ่ม PSNR จาก 18.696 เป็น 20.357 และ SSIM จาก 0.517 เป็น 0.606 อีกทั้งได้คะแนน Dice อ้างอิงบริบทและข้อมูลจริงสูงที่สุดที่ 0.827 และ 0.849 โดยความสม่ำเสมอของตัวละครหรือวัตถุและฉากหลังอยู่ที่ 0.926 และ 0.932:

ผลการเปรียบเทียบเชิงปริมาณเบื้องต้นกับแนวทางก่อนหน้า
DFoT ได้ PSNR 17.693 และ Context as Memory ได้ 18.921 โดยผู้เขียนระบุว่าผลที่ดีขึ้นมาจากการสร้างโทเคนหน่วยความจำร่วมกับความสนใจแบบค้นคืนเชิงพลวัต:

การเปรียบเทียบเชิงปริมาณระหว่าง HyDRA กับแนวทางระดับแนวหน้าในปัจจุบัน
เกี่ยวกับการทดสอบกับ WorldPlay ผู้เขียนระบุว่า:
‘วิธีของเราทำได้ดีกว่า WorldPlay ในทุกตัวชี้วัด โดยมีช่องว่าง PSNR ที่เด่นชัดถึง 5.502 แม้ WorldPlay ทำได้ต่ำกว่าในตัวชี้วัดอ้างอิงข้อมูลจริง เช่น PSNR 14.855 และ DSCGT 0.832 เพราะความต่างของการกระจายข้อมูลระหว่างโดเมนและการไม่ได้ปรับแต่งอย่างละเอียดเฉพาะงาน แต่ยังแสดงความทนทานอย่างโดดเด่นในตัวชี้วัดอ้างอิงบริบท โดยได้ DSCctx 0.822
‘ข้อสังเกตนี้ไม่เพียงยืนยันว่าโมเดลที่ฝึกมาอย่างกว้างขวางมีความสม่ำเสมอแบบไฮบริดในระดับพอใช้ แต่ยังยืนยันทางอ้อมถึงความสมเหตุสมผลของตัวชี้วัด DSC ที่เราเสนอในการสะท้อนความสม่ำเสมอของตัวละครหรือวัตถุเคลื่อนไหว
‘ท้ายที่สุด ผลลัพธ์ที่น่าประทับใจเหล่านี้เน้นย้ำศักยภาพอันโดดเด่นของโมเดลเรา และแสดงความเหนือกว่าแม้เมื่อเทียบกับโมเดลเชิงพาณิชย์ที่เป็นที่ยอมรับแล้ว’
บทความแสดงภาพนิ่งของการเปรียบเทียบเชิงคุณภาพที่ทำในการทดสอบ:

การเปรียบเทียบเชิงคุณภาพของการออกจากภาพและกลับเข้ามาขณะกล้องเคลื่อน ผู้เขียนระบุว่า HyDRA รักษาอัตลักษณ์ ท่าทาง และความต่อเนื่องของการเคลื่อนไหวหลังออกจากเฟรมและกลับมาได้ใกล้เคียงข้อมูลจริง ขณะที่วิธีคู่แข่งมีความคลาดเคลื่อน การเคลื่อนไหวไม่สอดคล้อง หรือรูปลักษณ์เสื่อมสภาพ ซึ่งทำเครื่องหมายสีแดง ส่วนการกลับมาที่สอดคล้องกันทำเครื่องหมายสีเขียว
ผู้เขียนแสดงความคิดเห็นต่อผลเหล่านี้ว่า:
‘ในเหตุการณ์ออกจากภาพและกลับเข้ามาที่ซับซ้อน โมเดลพื้นฐานและ Context-as-Memory มีการบิดเบือนของตัวละครอย่างรุนแรงและการเคลื่อนไหวไม่สอดคล้อง DFoT รักษาความสมบูรณ์ของตัวละครไม่ได้จนหายไปทั้งหมด ส่วน WorldPlay แม้รักษาความสม่ำเสมอของรูปลักษณ์ได้ แต่มีการเคลื่อนไหวสะดุดและการกระทำที่ไม่เป็นธรรมชาติ
‘ในทางกลับกัน วิธีของเรารักษาความสม่ำเสมอแบบไฮบริดได้สำเร็จ โดยรักษาทั้งอัตลักษณ์และความสอดคล้องของการเคลื่อนไหวหลังตัวละครกลับเข้าเฟรม’
ดูผลเพิ่มเติมในรูปแบบวิดีโอได้ที่ เว็บไซต์ประกอบ โดยเราได้นำสี่ตัวอย่างแรกมารวมเป็นวิดีโอด้านล่าง:
คลิกเพื่อเล่น ผลทดสอบสี่รายการจากทั้งหมดหกรายการบนเว็บไซต์โครงการ ที่มา
สรุป
แม้ความพยายามแก้ปัญหาที่น่ารำคาญที่สุดอย่างหนึ่งของการสร้างวิดีโอ AI ย่อมเป็นเรื่องน่ายินดี แต่ผู้เขียนเห็นว่าทางออกที่เหมาะสมที่สุดสำหรับปัญหาออกจากภาพและกลับเข้ามาเช่นนี้น่าจะหลีกเลี่ยงไม่ได้ที่จะเป็นเช่นเดียวกับ CGI คือวัสดุอ้างอิงแยกต่างหากที่แก้ไขได้อย่างเป็นอิสระแล้วนำเข้าสู่พื้นที่ประกอบภาพ
การพยายามรักษาเอมเบดดิงให้ยังทำงานอยู่ด้วยวิธี เฉพาะกิจ และดำเนินการสดขณะใช้งานดูเหน็ดเหนื่อย อีกทั้งยังไม่มีเส้นทางชัดเจนไปสู่ความสม่ำเสมอภายในช็อตที่มีให้แล้วบนแพลตฟอร์มกล่องดำหลายแห่ง เช่น Runway หากปรากฏว่าช็อตถัดไปต้องเข้าถึงปริภูมิแฝงของช็อตก่อนหน้า เหตุใดจึงไม่ให้ทั้งสองอินสแตนซ์จัดเก็บเอมเบดดิงตัวละครที่แยกออกมาเป็นอิสระ?
* ยังไม่มีใครตั้งชื่อให้ปัญหานี้ และการอภิปรายทำได้ยากหากไม่มีคำศัพท์ร่วมกัน
** ขณะนี้หน้าโครงการระบุว่ายังอยู่ในสถานะ ‘เร็วๆ นี้’
เผยแพร่ครั้งแรกวันศุกร์ที่ 27 มีนาคม 2026


