
มุมมองของ Anderson
Stable Diffusion อาจพัฒนาเป็นผลิตภัณฑ์สำหรับผู้บริโภคทั่วไปได้อย่างไร

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ประเด็นสำคัญแอปพลิเคชัน Stable Diffusion แบบกระแสหลักต้องแก้ไขปัญหาการติดตั้งผ่าน command line…
ดูเพิ่มเติม
- แอปพลิเคชัน Stable Diffusion แบบกระแสหลักต้องแก้ไขปัญหาการติดตั้งผ่าน command line ที่ซับซ้อนและข้อจำกัดด้าน dependencies
- นักพัฒนาเชิงพาณิชย์เผชิญความเสี่ยงทางกฎหมายจากการสร้าง deepfake และตัวกรองเนื้อหา NSFW
- คุณสมบัติขั้นสูง เช่น ความสม่ำเสมอเชิงเวลา (temporal consistency) และการปรับเปลี่ยนด้วยข้อความ (textual inversion) ต้องอาศัยการประมวลผลบนคลาวด์สำหรับผู้ใช้ทั่วไป
น่าแปลกที่ Stable Diffusion ซึ่งเป็นเฟรมเวิร์กสังเคราะห์ภาพด้วย AI ตัวใหม่ที่สร้างกระแสไปทั่วโลก กลับยังไม่เสถียรและไม่ได้แพร่กระจายอย่างทั่วถึงนัก อย่างน้อยก็ในขณะนี้
ความสามารถทั้งหมดของระบบกระจายอยู่ในชุดซอฟต์แวร์หลายรูปแบบที่เปลี่ยนแปลงตลอดเวลา จากนักพัฒนาเพียงไม่กี่รายที่เร่งแลกเปลี่ยนข้อมูลและทฤษฎีล่าสุดในวงสนทนาต่างๆ บน Discord ขั้นตอนติดตั้งแพ็กเกจที่พวกเขาสร้างหรือแก้ไขส่วนใหญ่ยังห่างไกลจากการติดตั้งแล้วใช้งานได้ทันที
โดยทั่วไปต้องติดตั้งผ่านบรรทัดคำสั่งหรือ ไฟล์ BAT โดยใช้ GIT, Conda, Python, Miniconda และสภาพแวดล้อมพัฒนาซอฟต์แวร์ล้ำสมัยอื่นๆ แพ็กเกจเหล่านี้พบได้น้อยมากในคอมพิวเตอร์ของผู้บริโภคทั่วไป จนการติดตั้ง มักถูกแจ้งเตือน โดยโปรแกรมป้องกันไวรัสและมัลแวร์ว่าเป็นหลักฐานว่าคอมพิวเตอร์ถูกบุกรุก

เพียงส่วนเล็กๆ ของขั้นตอนยุ่งยากที่การติดตั้ง Stable Diffusion แบบมาตรฐานต้องทำในปัจจุบัน หลายดิสทริบิวชันต้องใช้ Python รุ่นเฉพาะ ซึ่งอาจขัดแย้งกับรุ่นที่มีอยู่ในเครื่อง แต่หลีกเลี่ยงได้ด้วยการติดตั้งผ่าน Docker และในระดับหนึ่งด้วยสภาพแวดล้อม Conda
กระทู้ในชุมชน Stable Diffusion ทั้งแบบ SFW และ NSFW เต็มไปด้วยเคล็ดลับเกี่ยวกับการแก้สคริปต์ Python และการติดตั้งมาตรฐาน เพื่อเพิ่มความสามารถ แก้ข้อผิดพลาดเรื่องซอฟต์แวร์ที่ต้องพึ่งพา และปัญหาอื่นๆ
ผู้บริโภคทั่วไปที่สนใจ สร้างภาพอันน่าทึ่ง จากพรอมต์ข้อความจึงแทบต้องพึ่งอินเทอร์เฟซเว็บ API แบบหารายได้ที่มีจำนวนเพิ่มขึ้น ส่วนใหญ่ให้สร้างภาพฟรีเพียงเล็กน้อยก่อนต้องซื้อโทเค็น
นอกจากนี้บริการเว็บเกือบทั้งหมดปฏิเสธการสร้างเนื้อหา NSFW ซึ่งหลายกรณีเป็นหัวข้อทั่วไปที่ไม่ใช่สื่อลามก เช่น สงคราม ความสามารถนี้เป็นสิ่งที่แยก Stable Diffusion ออกจากบริการ DALL-E 2 ของ OpenAI ที่ผ่านการตัดทอนเนื้อหา
Photoshop สำหรับ Stable Diffusion
ภาพที่งดงาม วาบหวิว หรือเหนือโลกซึ่งปรากฏในแฮชแท็ก #stablediffusion บน Twitter ทุกวันทำให้ผู้คนสนใจ สิ่งที่คนทั่วไปอาจกำลังรอคือ Photoshop สำหรับ Stable Diffusion — แอปพลิเคชันติดตั้งได้บนหลายแพลตฟอร์มที่รวมความสามารถที่ดีที่สุดและทรงพลังที่สุดของสถาปัตยกรรม Stability.ai กับนวัตกรรมอันชาญฉลาดของชุมชนนักพัฒนา SD โดยไม่มีหน้าต่างบรรทัดคำสั่งลอยแยก ขั้นตอนติดตั้งและอัปเดตที่ซับซ้อนเปลี่ยนตลอดเวลา หรือคุณสมบัติที่ขาดหาย
สิ่งที่เรามีในขณะนี้สำหรับการติดตั้งที่ทำงานได้มากกว่าส่วนใหญ่ คือหน้าเว็บที่ดูดีมากน้อยต่างกัน เชื่อมกับหน้าต่างบรรทัดคำสั่งแยก และมี URL เป็นพอร์ต localhost:

เช่นเดียวกับแอปสังเคราะห์ที่ขับเคลื่อนด้วย CLI อย่าง FaceSwap และ DeepFaceLab ที่อาศัย BAT การติดตั้ง Stable Diffusion แบบแพ็กสำเร็จยังแสดงรากฐานบรรทัดคำสั่ง อินเทอร์เฟซเข้าถึงผ่านพอร์ต localhost ด้านบนของภาพ ซึ่งสื่อสารกับความสามารถ Stable Diffusion ใน CLI
แอปที่ใช้งานราบรื่นกว่าย่อมกำลังมา มีแอปแบบรวมชุดที่อาศัย Patreon ให้ดาวน์โหลดแล้วหลายตัว เช่น GRisk และ NMKD (ดูภาพด้านล่าง) แต่ยังไม่มีตัวใดรวมความสามารถครบถ้วนเท่าการใช้งาน Stable Diffusion บางแบบที่ก้าวหน้ากว่าแต่เข้าถึงได้ยากกว่า

แพ็กเกจ Stable Diffusion ยุคแรกที่อาศัย Patreon และปรับให้คล้ายแอปเล็กน้อย NMKD เป็นตัวแรกที่นำผลลัพธ์จาก CLI มารวมใน GUI โดยตรง
มาดูกันว่าการใช้งานโครงการโอเพนซอร์สอันน่าทึ่งนี้ในรูปแบบที่ขัดเกลาและรวมเป็นหนึ่งมากขึ้นอาจเป็นอย่างไร และอาจเผชิญความท้าทายใด
ข้อพิจารณาทางกฎหมายสำหรับแอป Stable Diffusion เชิงพาณิชย์ที่มีเงินทุนพร้อม
ปัจจัย NSFW
ซอร์สโค้ด Stable Diffusion เผยแพร่ภายใต้ ใบอนุญาตที่เปิดกว้างมาก ซึ่งไม่ห้ามการนำไปพัฒนาใหม่เชิงพาณิชย์หรือผลงานดัดแปลงที่อาศัยซอร์สโค้ดอย่างมาก
นอกจากชุด Stable Diffusion ที่อาศัย Patreon ซึ่งเพิ่มขึ้นดังกล่าวแล้ว ยังมีปลั๊กอินจำนวนมากที่กำลังพัฒนาสำหรับ Figma, Krita, Photoshop, GIMP และ Blender เป็นต้น จึงไม่มีเหตุผลในทาง ปฏิบัติ ที่บริษัทพัฒนาซอฟต์แวร์ซึ่งมีเงินทุนเพียงพอจะสร้างแอป Stable Diffusion ที่ซับซ้อนและมีความสามารถสูงกว่ามากไม่ได้ ในแง่ตลาดมีเหตุผลทุกประการให้เชื่อว่าโครงการลักษณะนี้หลายโครงการกำลังคืบหน้าไปมากแล้ว
โครงการเหล่านี้ต้องเผชิญคำถามทันทีว่า เช่นเดียวกับเว็บ API ส่วนใหญ่สำหรับ Stable Diffusion แอปจะอนุญาตให้ปิดตัวกรอง NSFW ที่มีมาในระบบ ซึ่งเป็น โค้ดส่วนหนึ่ง ได้หรือไม่
การซ่อนสวิตช์ NSFW
แม้ใบอนุญาตโอเพนซอร์สของ Stability.ai สำหรับ Stable Diffusion จะมีรายการการใช้งานที่ตีความได้กว้างว่า ไม่อนุญาตให้ใช้ ซึ่งอาจครอบคลุม เนื้อหาลามกอนาจาร และ ดีพเฟก แต่วิธีเดียวที่ผู้ขายจะห้ามการใช้งานนั้นได้จริงคือคอมไพล์ตัวกรอง NSFW เป็นไฟล์ปฏิบัติการที่ตรวจดูภายในไม่ได้ แทนการใช้พารามิเตอร์ในไฟล์ Python หรือบังคับเปรียบเทียบผลรวมตรวจสอบของไฟล์ Python หรือ DLL ที่มีคำสั่ง NSFW เพื่อไม่ให้เรนเดอร์ได้หากผู้ใช้เปลี่ยนการตั้งค่านี้
นั่นจะทำให้แอปถูกจำกัดความสามารถคล้ายกับที่ DALL-E 2 เป็นอยู่ในปัจจุบัน และลดความน่าสนใจเชิงพาณิชย์ อีกทั้งเวอร์ชันที่ถอดคอมไพล์และแก้ไของค์ประกอบเหล่านี้ ไม่ว่าจะเป็นส่วนรันไทม์ Python เดิมหรือ DLL ที่คอมไพล์แล้วเช่นในเครื่องมือปรับปรุงภาพ AI ของ Topaz ก็น่าจะปรากฏในชุมชนทอร์เรนต์และแฮ็กเพื่อปลดข้อจำกัด โดยแทนที่ส่วนที่ขัดขวางและลบข้อกำหนดผลรวมตรวจสอบ
ท้ายที่สุดผู้ขายอาจเลือกเพียงย้ำคำเตือนห้ามใช้งานผิดวัตถุประสงค์ของ Stability.ai ซึ่งปรากฏเมื่อเปิด Stable Diffusion หลายดิสทริบิวชันครั้งแรก
แต่นักพัฒนาโอเพนซอร์สรายเล็กที่ใช้ข้อสงวนความรับผิดอย่างไม่เป็นทางการเช่นนี้มีสิ่งที่ต้องเสี่ยงน้อยกว่าบริษัทซอฟต์แวร์ที่ลงทุนเวลาและเงินมหาศาลเพื่อให้ Stable Diffusion มีความสามารถครบและเข้าถึงง่าย จึงต้องพิจารณาให้ลึกขึ้น
ความรับผิดจากดีพเฟก
ดังที่เรา กล่าวถึงเมื่อไม่นานมานี้ ฐานข้อมูล LAION-aesthetics ซึ่งเป็นส่วนหนึ่งของภาพ 4.2 พันล้านภาพที่ใช้ฝึกโมเดล Stable Diffusion ที่กำลังพัฒนา มีภาพคนดังจำนวนมาก จึงให้ผู้ใช้สร้างดีพเฟกได้ รวมถึงสื่อลามกดีพเฟกของคนดัง

จากบทความล่าสุดของเรา: Jennifer Connelly ในสี่ช่วงของอาชีพตลอดสี่ทศวรรษที่สร้างจาก Stable Diffusion
เรื่องนี้แยกต่างหากและเป็นที่โต้แย้งมากกว่าการสร้างสื่อลามกแบบนามธรรมที่โดยปกติถูกกฎหมายและไม่ได้แสดงบุคคลจริง แม้ภาพเหล่านั้นอนุมานจากภาพจริงหลายภาพในข้อมูลฝึกก็ตาม
เมื่อรัฐต่างๆ ในสหรัฐฯ และประเทศต่างๆ ออกหรือกำลังพัฒนากฎหมายต่อต้านสื่อลามกดีพเฟกมากขึ้น ความสามารถสร้างสื่อลามกคนดังของ Stable Diffusion อาจหมายความว่าแอปเชิงพาณิชย์ที่ไม่ได้เซ็นเซอร์ทั้งหมด กล่าวคือยังสร้างสื่อลามกได้ อาจต้องกรองใบหน้าที่ตรวจพบว่าเป็นคนดัง
วิธีหนึ่งคือรายการคำต้องห้ามในพรอมต์ที่เกี่ยวข้องกับชื่อคนดังและตัวละครสมมติที่เกี่ยวข้องกับบุคคลนั้น การตั้งค่านี้น่าจะต้องมีหลายภาษา ไม่ใช่แค่ภาษาอังกฤษ เพราะข้อมูลต้นทางมีภาษาอื่นด้วย อีกแนวทางคือระบบรู้จำคนดัง เช่น ระบบของ Clarifai
ผู้ผลิตซอฟต์แวร์อาจจำเป็นต้องใส่วิธีเหล่านี้ไว้ แม้เริ่มต้นอาจปิดอยู่ เพื่อช่วยป้องกันแอป Stable Diffusion แบบสแตนด์อโลนที่สมบูรณ์ไม่ให้สร้างใบหน้าคนดัง ระหว่างรอกฎหมายใหม่ที่อาจทำให้ความสามารถดังกล่าวผิดกฎหมาย
อย่างไรก็ตาม ผู้สนใจย่อมอาจถอดคอมไพล์และย้อนข้อจำกัดเหล่านี้ได้อีก ผู้ผลิตอาจอ้างได้ว่ากรณีนั้นเป็นการดัดแปลงทำลายโดยไม่ได้รับอนุญาต ตราบใดที่ไม่ได้ทำให้การทำวิศวกรรมย้อนกลับง่ายเกินไป
คุณสมบัติที่อาจรวมไว้
แอปเชิงพาณิชย์ที่มีเงินทุนพร้อมควรมีความสามารถพื้นฐานที่มีใน Stable Diffusion ทุกดิสทริบิวชัน ได้แก่การใช้พรอมต์ข้อความสร้างภาพที่เหมาะสม (ข้อความเป็นภาพ); การใช้ภาพร่างหรือภาพอื่นเป็นแนวทางสำหรับภาพใหม่ (ภาพเป็นภาพ); การปรับระดับจินตนาการของระบบ การเลือกระหว่างเวลาเรนเดอร์กับคุณภาพ และความสามารถพื้นฐานอื่น เช่น เก็บภาพและพรอมต์อัตโนมัติแบบเลือกได้ เพิ่มความละเอียดตามปกติแบบเลือกได้ด้วย RealESRGAN และแก้ไขใบหน้าขั้นพื้นฐานเป็นอย่างน้อยด้วย GFPGAN หรือ CodeFormer
นี่เป็นเพียงการติดตั้งพื้นฐาน มาดูคุณสมบัติขั้นสูงที่กำลังพัฒนาหรือขยายเพิ่มเติม ซึ่งอาจนำมารวมในแอป Stable Diffusion แบบดั้งเดิมที่ครบถ้วนได้
การตรึงการเข้ารหัสแบบสุ่ม
แม้คุณจะ ใช้ค่า seed เดิม จากการเรนเดอร์ที่สำเร็จก่อนหน้านี้ ก็ยังยากมากที่ Stable Diffusion จะทำการแปลงเดิมได้ตรงกันทุกประการหาก ส่วนใดส่วนหนึ่ง ของพรอมต์หรือภาพต้นทาง หรือทั้งสองอย่าง เปลี่ยนไปในการเรนเดอร์ครั้งถัดไป
นี่เป็นปัญหาหากต้องการใช้ EbSynth ถ่ายทอดการแปลงของ Stable Diffusion ลงในวิดีโอจริงอย่างต่อเนื่องสอดคล้องกันในเชิงเวลา แม้เทคนิคนี้จะมีประสิทธิภาพมากสำหรับภาพศีรษะและไหล่ที่เรียบง่าย:
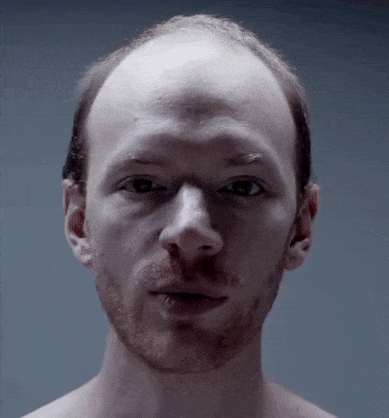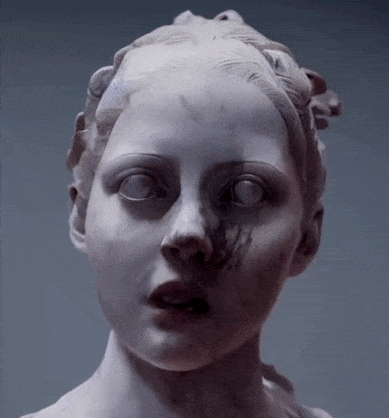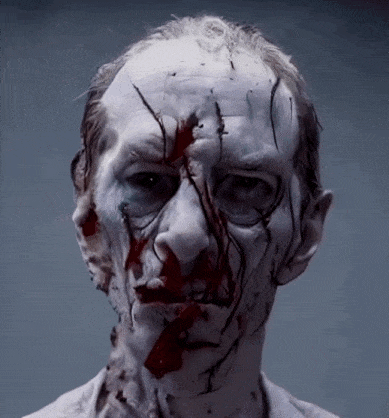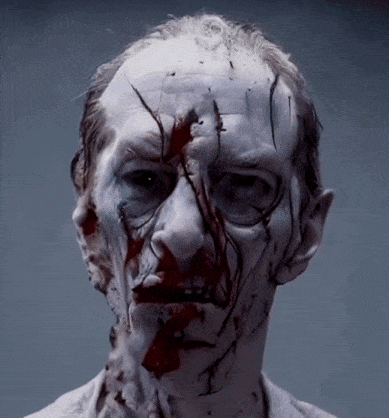
การเคลื่อนไหวที่จำกัดทำให้ EbSynth เป็นเครื่องมือที่มีประสิทธิภาพในการเปลี่ยนผลการแปลงของ Stable Diffusion ให้เป็นวิดีโอสมจริง ที่มา: https://streamable.com/u0pgzd
EbSynth นำคีย์เฟรมที่ปรับเปลี่ยนแล้วเพียงเล็กน้อยมาขยายผลไปยังวิดีโอที่ส่งออกเป็นไฟล์ภาพต่อเนื่อง และภายหลังนำไฟล์เหล่านั้นมาประกอบกลับเป็นวิดีโอได้

ในตัวอย่างจากเว็บไซต์ EbSynth เฟรมวิดีโอไม่กี่เฟรมถูกระบายสีเชิงศิลปะ EbSynth ใช้เฟรมเหล่านี้เป็นแนวทางด้านสไตล์เพื่อปรับวิดีโอทั้งหมดให้มีลักษณะเหมือนภาพวาดนั้น ที่มา: https://www.youtube.com/embed/eghGQtQhY38
ตัวอย่างด้านล่างมีครูโยคะหญิงผมบลอนด์จริงทางซ้ายที่แทบไม่เคลื่อนไหว แต่ Stable Diffusion ยังรักษาใบหน้าให้คงที่ได้ยาก เพราะภาพสามภาพที่ใช้แปลงเป็นคีย์เฟรมไม่เหมือนกันทุกประการ แม้จะใช้ seed ตัวเลขเดียวกัน

แม้ทั้งสามการแปลงใช้พรอมต์และ seed เดียวกัน และภาพต้นทางเปลี่ยนเพียงเล็กน้อย กล้ามเนื้อก็ยังเปลี่ยนขนาดและรูปร่าง ที่สำคัญกว่า ใบหน้าไม่คงที่ จึงขัดขวางความต่อเนื่องตามเวลาในการเรนเดอร์ EbSynth ที่อาจทำต่อ
วิดีโอ SD/EbSynth ด้านล่างสร้างสรรค์มาก โดยนิ้วผู้ใช้เปลี่ยนเป็นขาที่สวมกางเกงกำลังเดินและเป็ดตามลำดับ แต่กางเกงที่ไม่คงที่สะท้อนปัญหาที่ Stable Diffusion รักษาความต่อเนื่องระหว่างคีย์เฟรมไม่ได้ แม้ภาพต้นทางคล้ายกันและใช้ seed เดิม
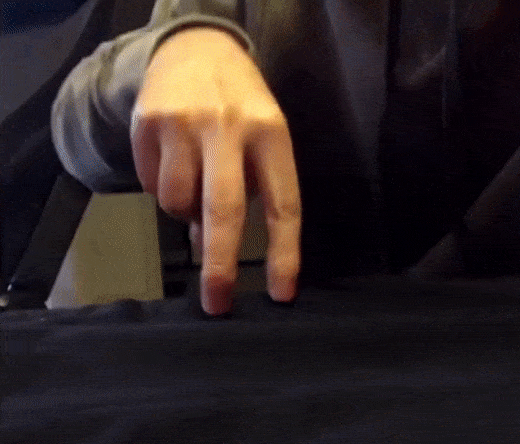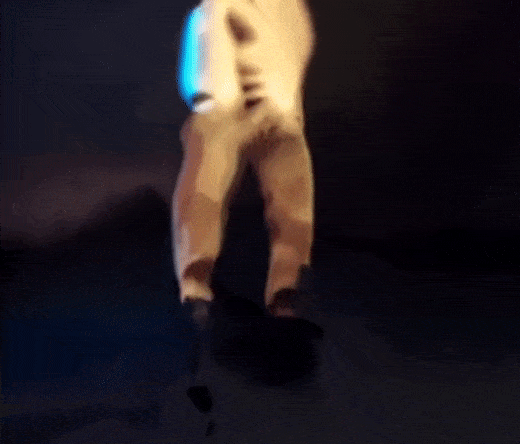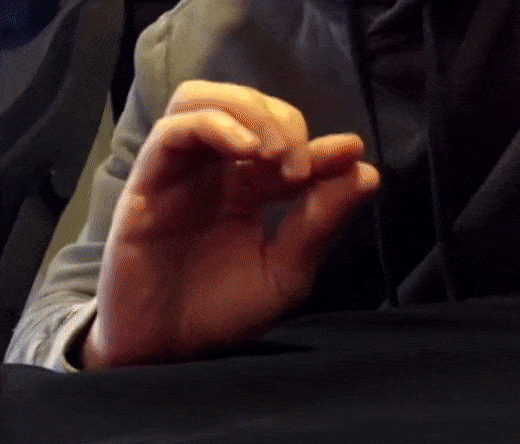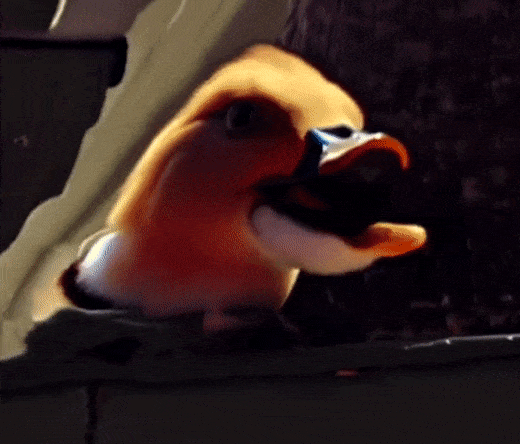
นิ้วของชายคนหนึ่งกลายเป็นคนเดินและเป็ดผ่าน Stable Diffusion กับ EbSynth ที่มา: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
ผู้ใช้ที่สร้างวิดีโอ แสดงความคิดเห็น ว่าการแปลงเป็นเป็ดซึ่งอาจดูสำเร็จกว่า แม้ไม่โดดเด่นและแปลกใหม่เท่าอีกแบบ ใช้คีย์เฟรมที่แปลงแล้วเพียงเฟรมเดียว ขณะที่กางเกงเดินได้ต้องเรนเดอร์ภาพ Stable Diffusion ถึง 50 ภาพ และยังมีความไม่ต่อเนื่องตามเวลามากกว่า ผู้ใช้ยังบอกว่าต้องลองห้าครั้งเพื่อให้คีย์เฟรมแต่ละเฟรมจากทั้งหมด 50 เฟรมสอดคล้องกัน
แอป Stable Diffusion ที่ครอบคลุมจริงจึงควรมีความสามารถรักษาคุณลักษณะระหว่างคีย์เฟรมให้ได้มากที่สุด
ทางหนึ่งคือให้ผู้ใช้ตรึงการเข้ารหัสแบบสุ่มสำหรับการแปลงในแต่ละเฟรม ซึ่งปัจจุบันทำได้โดยแก้ซอร์สโค้ดด้วยตนเองเท่านั้น ตัวอย่างด้านล่างช่วยให้สอดคล้องตามเวลาขึ้น แต่ไม่ได้แก้ปัญหาได้หมด:
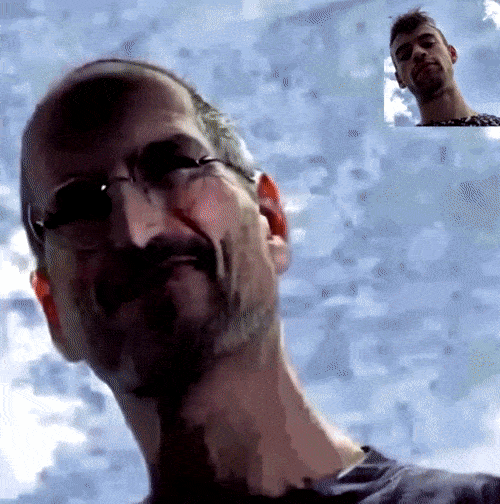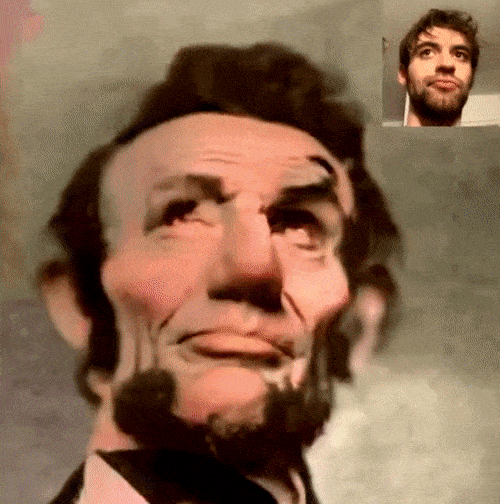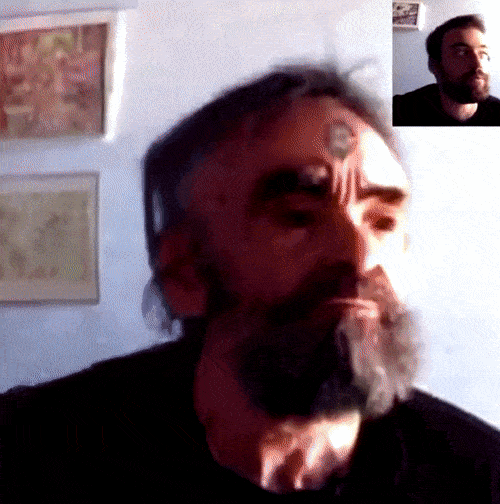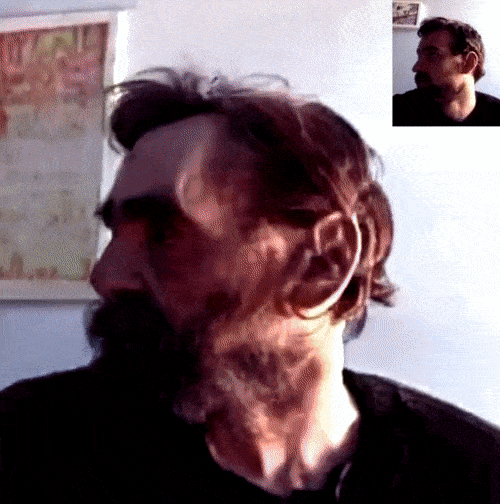
ผู้ใช้ Reddit คนหนึ่งเปลี่ยนวิดีโอเว็บแคมของตนเป็นคนดังหลายคน โดยไม่เพียงคง seed เดิมซึ่ง Stable Diffusion ทุกแบบทำได้ แต่ยังทำให้พารามิเตอร์ stochastic_encode() เหมือนกันทุกครั้งด้วย วิธีนี้ใช้การแก้โค้ด แต่ทำเป็นสวิตช์สำหรับผู้ใช้ได้ง่าย อย่างไรก็ตาม เห็นชัดว่ายังแก้ปัญหาด้านเวลาไม่ได้ทั้งหมด ที่มา: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Textual Inversion บนคลาวด์
วิธีที่ดีกว่าในการสร้างตัวละครและวัตถุให้คงที่ตามเวลาคือการฝังสิ่งนั้นลงใน Textual Inversion — ไฟล์ขนาด 5 KB ที่ฝึกได้ในไม่กี่ชั่วโมงด้วยภาพพร้อมคำกำกับเพียงห้าภาพ แล้วเรียกใช้ด้วยพรอมต์พิเศษ * เช่น เพื่อให้ตัวละครใหม่มีรูปลักษณ์เดิมอย่างต่อเนื่องในเรื่องเล่า

ภาพที่ผูกกับแท็กเหมาะสมเปลี่ยนเป็นหน่วยเฉพาะด้วย Textual Inversion และเรียกอย่างไม่กำกวมในบริบทและสไตล์ที่ถูกต้องผ่านคำโทเค็นพิเศษได้ ที่มา: https://huggingface.co/docs/diffusers/training/text_inversion
Textual Inversion เป็นไฟล์เสริมของโมเดลขนาดใหญ่มากที่ฝึกเสร็จแล้วซึ่ง Stable Diffusion ใช้ โดยนำมาแทรกในกระบวนการเรียกภาพหรือพรอมต์เพื่อให้ เข้าร่วม ในฉากที่โมเดลสร้างและอาศัยความรู้มหาศาลของโมเดลเกี่ยวกับวัตถุ สไตล์ สภาพแวดล้อม และปฏิสัมพันธ์ได้
แม้ฝึก Textual Inversion ใช้เวลาไม่นาน แต่ต้องใช้ VRAM มาก คู่มือปัจจุบันหลายแห่งระบุประมาณ 12, 20 หรือถึง 40 GB
ผู้ใช้ทั่วไปส่วนใหญ่ไม่น่าจะมี GPU ทรงพลังขนาดนั้น จึงเริ่มมีบริการคลาวด์รับทำงานนี้ รวมถึงเวอร์ชันของ Hugging Face แม้มี การใช้งานผ่าน Google Colab ที่สร้าง Textual Inversion สำหรับ Stable Diffusion ได้ แต่ข้อกำหนด VRAM และเวลาอาจเป็นอุปสรรคสำหรับผู้ใช้ Colab แบบฟรี
สำหรับแอป Stable Diffusion แบบติดตั้งที่ครบถ้วนและมีการลงทุนเพียงพอ การส่งงานหนักนี้ไปยังเซิร์ฟเวอร์คลาวด์ของบริษัทเป็นกลยุทธ์หารายได้ที่ชัดเจน โดยสมมติว่าแอปต้นทุนต่ำหรือฟรีจะมีฟังก์ชันที่ต้องจ่ายเช่นนี้แทรกอยู่ ซึ่งดูเป็นไปได้ในหลายแอปที่อาจเกิดจากเทคโนโลยีนี้ในอีก 6–9 เดือน
การกำกับและจัดรูปแบบภาพกับข้อความที่ส่งเข้ามาซึ่งค่อนข้างซับซ้อนอาจทำอัตโนมัติได้ในสภาพแวดล้อมรวมศูนย์ การสร้างองค์ประกอบเฉพาะที่ไปสำรวจและโต้ตอบกับโลกกว้างของ Stable Diffusion อาจชวนให้หมกมุ่น ทั้งสำหรับผู้สนใจทั่วไปและผู้ใช้อายุน้อย
การกำหนดน้ำหนักพรอมต์อย่างยืดหยุ่น
ปัจจุบันมีหลายการใช้งานที่ให้ผู้ใช้เพิ่มความสำคัญแก่ข้อความส่วนหนึ่งในพรอมต์ยาว แต่วิธีทำแตกต่างกันมากและมักเทอะทะหรือไม่เป็นธรรมชาติ
ตัวอย่างเช่น Stable Diffusion ฉบับแยกที่ได้รับความนิยมสูง จาก AUTOMATIC1111 ลดหรือเพิ่มค่าของคำในพรอมต์ได้ด้วยวงเล็บกลมหนึ่งหรือหลายชั้นเพื่อลดความสำคัญ หรือวงเล็บเหลี่ยมเพื่อเพิ่มความสำคัญ

วงเล็บเหลี่ยมหรือวงเล็บกลมเปลี่ยนอาหารเช้าของคุณได้ในระบบน้ำหนักพรอมต์ของ Stable Diffusion รุ่นนี้ แต่ไม่ว่าแบบใดก็เป็นฝันร้ายด้านคอเลสเตอรอล
Stable Diffusion บางแบบใช้เครื่องหมายอัศเจรีย์เพื่อเน้น ส่วนแบบที่ยืดหยุ่นที่สุดให้กำหนดน้ำหนักแต่ละคำผ่าน GUI
ระบบควรรองรับ น้ำหนักพรอมต์เชิงลบ ด้วย ไม่ใช่เฉพาะสำหรับ แฟนเรื่องสยองขวัญ เพราะในปริภูมิแฝงของ Stable Diffusion อาจมีความลึกลับที่ไม่น่ากลัวและให้ความรู้มากกว่าสิ่งที่ภาษาจำกัดของเราเรียกขึ้นมาได้
การขยายภาพนอกกรอบ (outpainting)
ไม่นานหลัง Stable Diffusion เปิดซอร์สอย่างเป็นกระแส OpenAI พยายามเรียกความสนใจบางส่วนกลับมายัง DALL-E 2 ซึ่งส่วนใหญ่ไม่สำเร็จ ด้วยการ ประกาศ outpainting ที่ให้ขยายภาพออกนอกขอบโดยยังมีตรรกะเชิงความหมายและความกลมกลืนทางสายตา
แน่นอนว่าภายหลังมีการ นำไปใช้ ใน Stable Diffusion หลายรูปแบบ รวมทั้ง ใน Krita และควรมีใน Stable Diffusion ฉบับครบถ้วนแบบ Photoshop อย่างแน่นอน
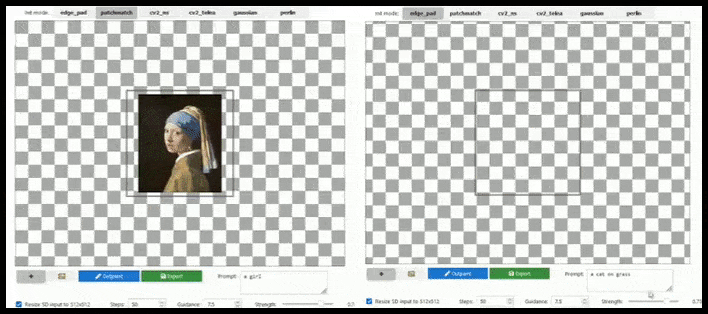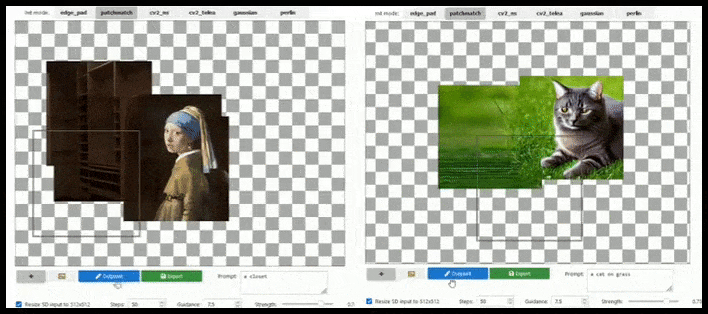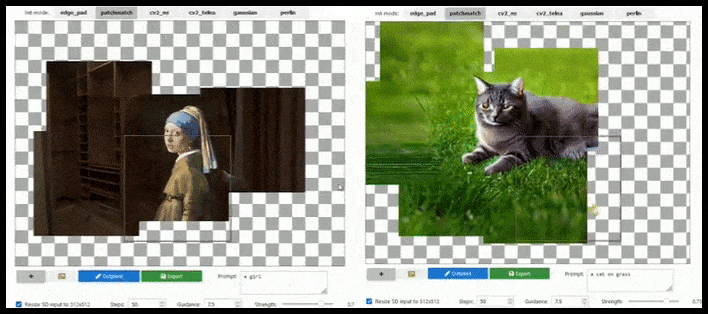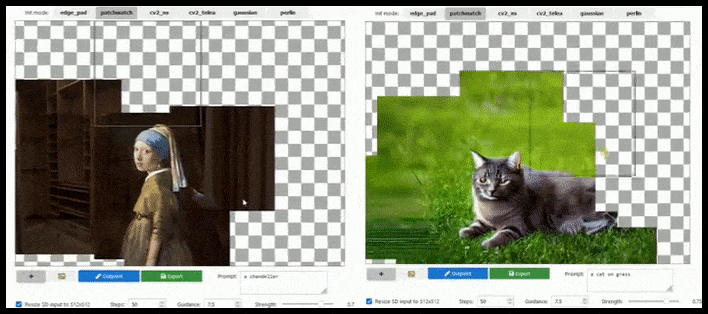
การขยายด้วยไทล์ทำให้ภาพมาตรฐาน 512 × 512 พิกเซลต่อออกไปได้แทบไม่สิ้นสุด ตราบใดที่พรอมต์ ภาพเดิม และตรรกะเชิงความหมายอนุญาต ที่มา: https://github.com/lkwq007/stablediffusion-infinity
เพราะ Stable Diffusion ฝึกบนภาพ 512 × 512 พิกเซล และด้วยเหตุผลอื่นอีกหลายประการ มันจึงมักตัดศีรษะหรือส่วนสำคัญของร่างกายคนออก แม้พรอมต์ระบุชัดว่าให้เน้นศีรษะก็ตาม

ตัวอย่างทั่วไปของการตัดศีรษะโดย Stable Diffusion แต่ outpainting อาจนำ George กลับมาอยู่ในภาพได้
การใช้ outpainting แบบภาพเคลื่อนไหวข้างต้นควรทำเป็นวิธีแก้ปัญหานี้ด้วยคลิกหรือพรอมต์เดียวด้วย แม้ตัวอย่างอาศัยไลบรารี Unix ทั้งหมด แต่ก็น่าจะสร้างซ้ำบน Windows ได้
ปัจจุบันหลายคนขยายพื้นที่ภาพที่ศีรษะถูกตัดขึ้นด้านบน เติมบริเวณศีรษะคร่าวๆ แล้วใช้ img2img ทำภาพที่ผิดพลาดให้สมบูรณ์
การมาสก์ที่มีประสิทธิภาพและเข้าใจบริบท
การมาสก์ อาจได้ผลไม่แน่นอนอย่างมากใน Stable Diffusion ขึ้นกับรุ่นหรือฉบับแยก แม้จะวาดมาสก์ต่อเนื่องกันได้ พื้นที่นั้นก็มักถูกเติมด้วยเนื้อหาที่ไม่คำนึงถึงบริบทของภาพทั้งภาพ
ครั้งหนึ่งผมมาสก์กระจกตาในภาพใบหน้าแล้วป้อนพรอมต์ ดวงตาสีฟ้า เพื่อเติมพื้นที่ แต่กลับดูเหมือนผมมองผ่านดวงตามนุษย์ที่ถูกตัดออกสองดวงไปยังภาพหมาป่าประหลาดที่อยู่ไกลออกไป ถือว่าโชคดีที่ไม่ใช่ Frank Sinatra
ยังแก้ภาพเชิงความหมายได้ด้วยการ ระบุสัญญาณรบกวน ที่สร้างภาพขึ้นมาแต่แรก ซึ่งทำให้ปรับองค์ประกอบโครงสร้างเฉพาะโดยไม่รบกวนส่วนอื่น:

เปลี่ยนองค์ประกอบหนึ่งของภาพโดยไม่ใช้มาสก์แบบเดิมและไม่กระทบเนื้อหาข้างเคียง ด้วยการระบุสัญญาณรบกวนต้นกำเนิดภาพแล้วปรับส่วนที่มีผลต่อพื้นที่เป้าหมาย ที่มา: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
วิธีนี้อาศัย ตัวสุ่มตัวอย่าง K-Diffusion
ตัวกรองเชิงความหมายสำหรับข้อผิดพลาดทางกายวิภาค
ดังที่กล่าวก่อนหน้า Stable Diffusion มักเพิ่มหรือลดแขนขา สาเหตุส่วนใหญ่คือปัญหาข้อมูลและข้อบกพร่องในคำกำกับภาพฝึก

เช่นเดียวกับเด็กซนที่แลบลิ้นในภาพหมู่โรงเรียน ความผิดปกติทางร่างกายของ Stable Diffusion อาจไม่ชัดในทันที คุณอาจโพสต์ผลงาน AI ล่าสุดบน Instagram ไปแล้วก่อนเห็นมือเกินหรือแขนขาที่ละลาย
การแก้ข้อผิดพลาดเหล่านี้ยากมาก จึงจะมีประโยชน์หากแอป Stable Diffusion แบบครบถ้วนมีระบบรู้จำกายวิภาคที่ใช้การแบ่งส่วนเชิงความหมายประเมินว่าภาพมีข้อบกพร่องทางร่างกายรุนแรงหรือไม่ เช่น ภาพข้างบน และทิ้งเพื่อเรนเดอร์ใหม่ก่อนแสดงให้ผู้ใช้

หากผู้ใช้ยอมรับการส่งข้อมูลการใช้งานได้ ข้อผิดพลาดเหล่านี้อาจส่งโดยไม่ระบุตัวตนเพื่อร่วมกันเรียนรู้แบบสหพันธ์ ช่วยให้โมเดลอนาคตเข้าใจตรรกะทางกายวิภาคดีขึ้น
การปรับปรุงใบหน้าอัตโนมัติที่อาศัย LAION
ดังที่ผมกล่าวใน บทวิเคราะห์ก่อนหน้า ถึงสามสิ่งที่ Stable Diffusion อาจปรับปรุงในอนาคต ไม่ควรปล่อยให้ GFPGAN รุ่นใดก็ตามทำหน้าที่ปรับปรุงใบหน้าจากการเรนเดอร์ครั้งแรกเพียงอย่างเดียว
การปรับปรุงของ GFPGAN เป็นแบบทั่วไปมาก มักทำให้สูญเสียอัตลักษณ์ของบุคคล และทำงานเฉพาะบนใบหน้าที่มักเรนเดอร์มาไม่ดีเพราะไม่ได้รับเวลาและการประมวลผลมากกว่าส่วนอื่นของภาพ
ดังนั้นโปรแกรม Stable Diffusion ระดับมืออาชีพควรรู้จำใบหน้าด้วยไลบรารีมาตรฐานที่ค่อนข้างเบา เช่น YOLO แล้วใช้พลัง GPU ที่มีทั้งหมดเรนเดอร์ใบหน้านั้นใหม่ จากนั้นผสานกับภาพเดิมที่มีบริบทครบ หรือบันทึกแยกเพื่อประกอบด้วยมือ ปัจจุบันขั้นตอนนี้ต้องลงมือทำเองค่อนข้างมาก
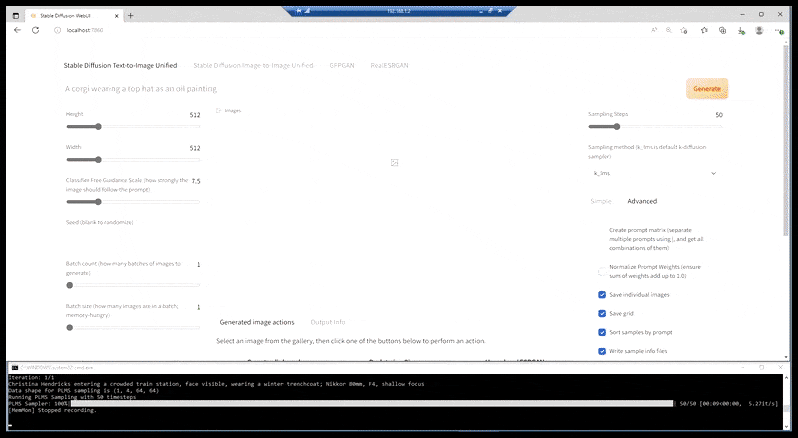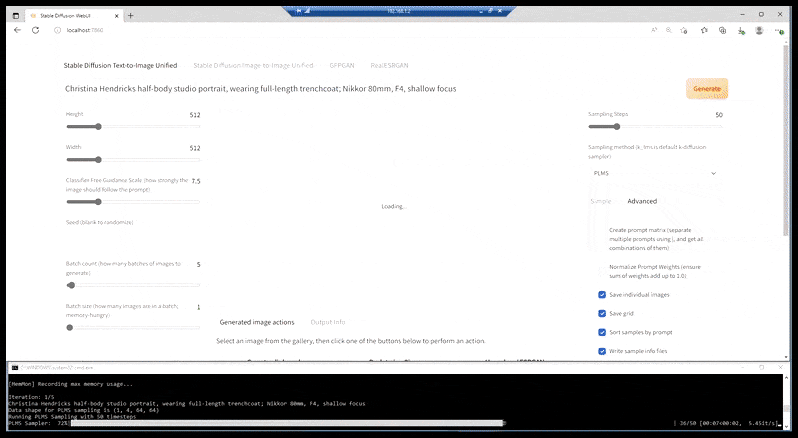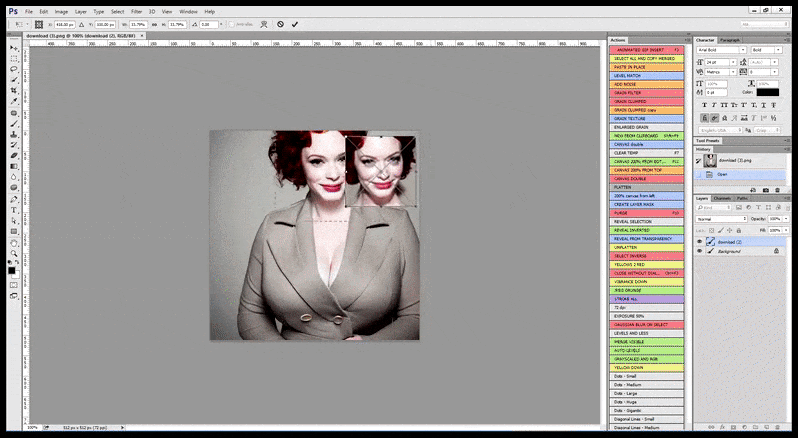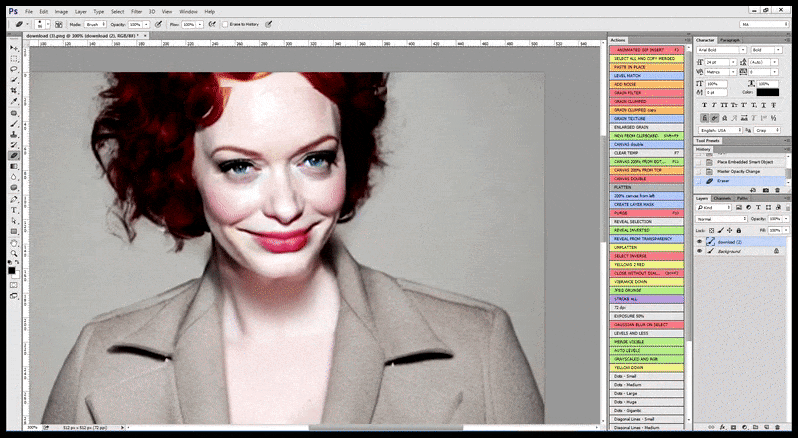
เมื่อ Stable Diffusion ฝึกด้วยภาพคนดังมากพอ เราสามารถใช้ GPU ทั้งหมดเรนเดอร์เฉพาะใบหน้าจากภาพที่สร้างแล้วอีกครั้ง โดยทั่วไปดีขึ้นชัดเจน และต่างจาก GFPGAN ตรงที่อาศัยข้อมูลจากการฝึกด้วย LAION แทนเพียงปรับพิกเซลที่เรนเดอร์แล้ว
การค้นหา LAION ภายในแอป
เมื่อผู้ใช้พบว่าการค้นหาแนวคิด บุคคล และหัวข้อใน LAION ช่วยให้ใช้ Stable Diffusion ดีขึ้น ก็เกิดเครื่องมือสำรวจ LAION ออนไลน์หลายตัว รวมถึง haveibeentrained.com

การค้นหาบน haveibeentrained.com ให้สำรวจภาพที่อยู่เบื้องหลัง Stable Diffusion และดูว่าวัตถุ บุคคล หรือแนวคิดที่อยากเรียกจากระบบน่าจะอยู่ในชุดฝึกหรือไม่ ระบบเช่นนี้ยังช่วยค้นหาแนวคิดใกล้เคียง เช่น การจัดกลุ่มคนดัง หรือแนวคิดถัดไปที่ต่อยอดจากแนวคิดปัจจุบัน ที่มา: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
แม้ฐานข้อมูลเว็บมักเผยแท็กบางส่วนของภาพ แต่กระบวนการ วางนัยทั่วไป ระหว่างฝึกโมเดลทำให้ไม่น่าจะเรียกภาพใดภาพหนึ่งขึ้นมาได้เพียงใช้แท็กของภาพนั้นเป็นพรอมต์
นอกจากนี้ การตัด คำหยุด และการตัดคำเป็นรากศัพท์กับการคืนรูปคำในการประมวลผลภาษาธรรมชาติ หมายความว่าวลีที่แสดงอยู่หลายวลีถูกแบ่งหรือข้ามไปก่อนนำมาฝึก Stable Diffusion
อย่างไรก็ตาม การเชื่อมโยงกลุ่มความงามในอินเทอร์เฟซเหล่านี้สอนผู้ใช้ได้มากเกี่ยวกับตรรกะหรืออาจเรียกว่าบุคลิกของ Stable Diffusion และช่วยให้สร้างภาพดีขึ้น
บทสรุป
ยังมีคุณสมบัติอื่นอีกมากที่ผมอยากเห็นใน Stable Diffusion เดสก์ท็อปแบบเนทีฟที่สมบูรณ์ เช่น การวิเคราะห์ภาพด้วย CLIP ในตัว ซึ่งกลับทิศกระบวนการปกติและให้ผู้ใช้เรียกวลีหรือคำที่ระบบเชื่อมโยงตามธรรมชาติกับภาพต้นทางหรือภาพเรนเดอร์
การเพิ่มความละเอียดแบบไทล์จริงก็เป็นสิ่งที่ควรมี เพราะ ESRGAN เป็นเครื่องมือหยาบแทบพอกับ GFPGAN โชคดีที่แผนรวมการใช้งาน txt2imghd ของ GOBIG กำลังทำให้เรื่องนี้เป็นจริงอย่างรวดเร็วในหลายดิสทริบิวชัน และเป็นตัวเลือกชัดเจนสำหรับรุ่นเดสก์ท็อป
คำขอยอดนิยมอื่นจากชุมชน Discord เช่น พจนานุกรมพรอมต์ในตัวและรายการศิลปินหรือสไตล์ที่นำไปใช้ได้ ผมสนใจน้อยกว่า แต่สมุดบันทึกในแอปหรือคลังวลีที่ปรับเองได้ดูเป็นส่วนเสริมที่สมเหตุสมผล
ข้อจำกัดปัจจุบันของแอนิเมชันที่เน้นมนุษย์ใน Stable Diffusion ยังอยู่ระยะเริ่มต้นมาก แม้ CogVideo และโครงการอื่นช่วยเริ่มต้น และยังขึ้นกับงานวิจัยพื้นฐานเกี่ยวกับข้อมูลล่วงหน้าด้านเวลาที่สัมพันธ์กับการเคลื่อนไหวมนุษย์จริง
ขณะนี้วิดีโอ Stable Diffusion ยังเป็นแบบ ไซเคเดลิก อย่างชัดเจน แต่อาจมีอนาคตอันใกล้ที่สดใสกว่าในงานเชิดตัวละครดีพเฟก ผ่าน EbSynth และโครงการข้อความเป็นวิดีโอที่ยังใหม่อื่นๆ อีกทั้งน่าสังเกตว่าไม่มีคนสังเคราะห์หรือคนที่ถูกดัดแปลงใน วิดีโอประชาสัมพันธ์ล่าสุด ของ Runway
ฟังก์ชันที่มีประโยชน์อีกอย่างคือการส่งภาพไป Photoshop และกลับอย่างราบรื่น ซึ่งมีมานานแล้วในตัวแก้ไขพื้นผิวของ Cinema4D และโปรแกรมลักษณะเดียวกัน ทำให้ส่งภาพระหว่างแอปง่ายและใช้แต่ละแอปทำสิ่งที่ถนัด
สุดท้ายและอาจสำคัญที่สุด โปรแกรม Stable Diffusion เดสก์ท็อปที่ครบถ้วนไม่ควรเพียงสลับจุดตรวจสอบหรือเวอร์ชันของโมเดลพื้นฐานได้ง่าย แต่ควรอัปเดต Textual Inversion ที่สร้างเองซึ่งเคยทำงานกับโมเดลทางการรุ่นก่อน แต่อาจใช้ไม่ได้กับรุ่นถัดมา ตามที่นักพัฒนาใน Discord ทางการระบุว่าอาจเกิดขึ้น
น่าแปลกที่ Adobe ซึ่งอยู่ในตำแหน่งเหมาะที่สุดในการสร้างชุดเครื่องมือ Stable Diffusion ที่ทรงพลังและครบวงจรเช่นนี้ กลับผูกพันกับ Content Authenticity Initiative อย่างแน่นแฟ้น จนการทำเช่นนั้นอาจดูเป็นการถอยหลังด้านประชาสัมพันธ์ เว้นแต่บริษัทจะจำกัดพลังสร้างภาพของ Stable Diffusion อย่างมากเช่นที่ OpenAI ทำกับ DALL-E 2 แล้ววางตำแหน่งให้เป็นวิวัฒนาการตามธรรมชาติของธุรกิจภาพสต็อกขนาดใหญ่ของตนแทน
เผยแพร่ครั้งแรก 15 กันยายน 2022


