มุมมองของ Anderson
ดิสนีย์ผสาน CGI กับการเรนเดอร์แบบประสาทเทียมเพื่อจัดการกับ ‘หุบเขาความแปลกประหลาด’

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
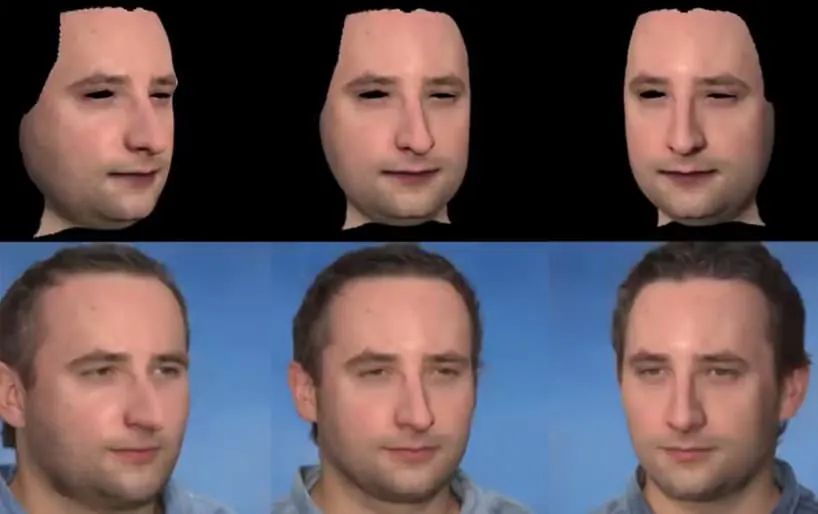
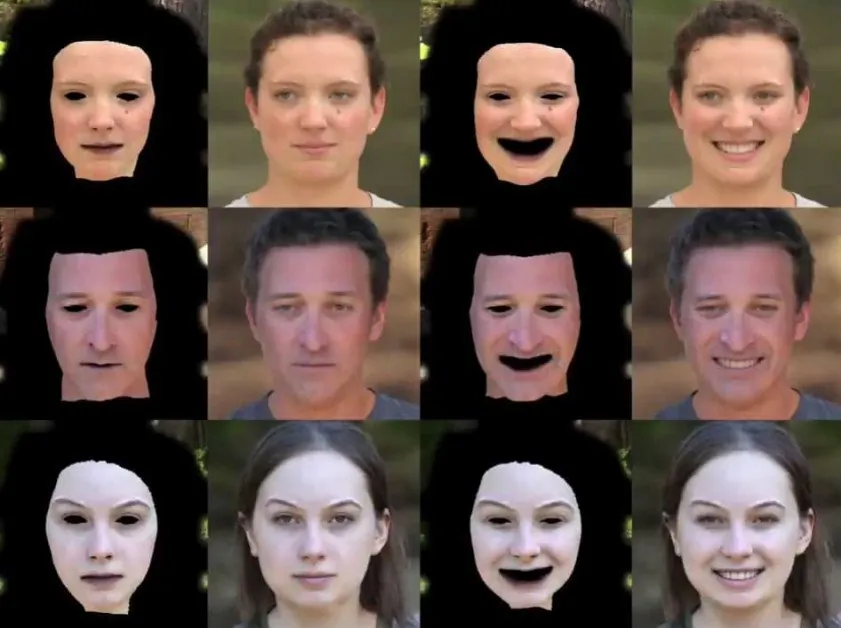
แผนกวิจัย AI ของดิสนีย์ได้พัฒนาวิธีการผสมผสานเพื่อจำลองใบหน้าในระดับภาพยนตร์ โดยรวมจุดแข็งของการเรนเดอร์ใบหน้าแบบประสาทเทียมกับความสม่ำเสมอของวิธีการที่อิง CGI
เอกสารที่กำลังอยู่ในขั้นตอนการตรวจสอบมีชื่อว่า Rendering with Style: Combining Traditional and Neural Approaches for High Quality Face Rendering และได้แสดงตัวอย่างใน วิดีโอใหม่ความยาว 10 นาที บนช่อง Disney Research ของ YouTube (ฝังอยู่ที่ส่วนท้ายของบทความนี้*)
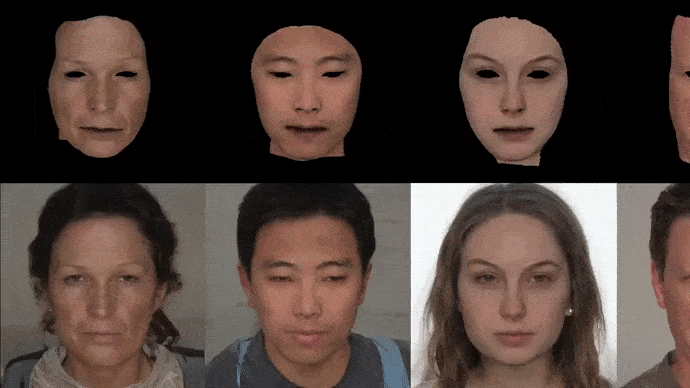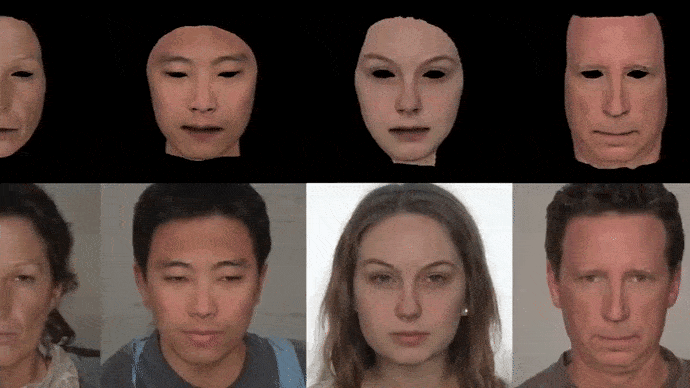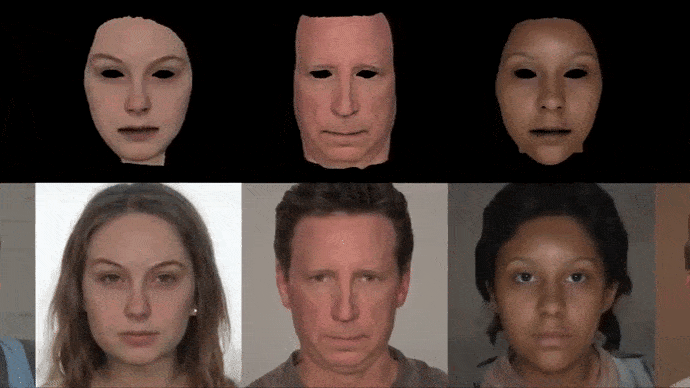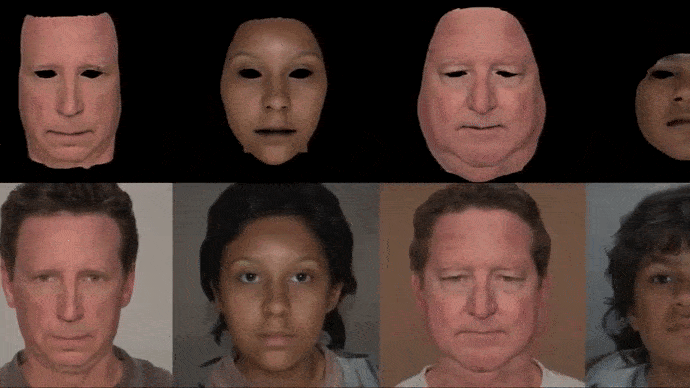
เมชที่ผสมกับการเรนเดอร์ใบหน้าแบบประสาทเทียม ดูวิดีโอฝังที่ส่วนท้ายของบทความเพื่อรายละเอียดและคุณภาพที่ดีกว่า แหล่งที่มา: https://www.youtube.com/watch?v=TwpLqTmvqVk
ตามที่วิดีโอระบุ, การเรนเดอร์ใบหน้าแบบประสาทเทียม (รวมถึง deepfakes) สามารถสร้างดวงตาและภายในปากที่สมจริงมากกว่าที่ CGI จะทำได้, ในขณะที่พื้นผิวใบหน้าที่สร้างด้วย CGI มีความสม่ำเสมอและเหมาะสมสำหรับผลลัพธ์ VFX ระดับภาพยนตร์
ดังนั้นดิสนีย์กำลังทดลองให้ตัวสร้างประสาทเทียม StyleGan2 ของ NVIDIA จัดการลักษณะรอบๆ ของใบหน้าและส่วนสำคัญต่อชีวิต เช่น ดวงตา, พร้อมกับซ้อนชั้นผิวหน้า CGI ที่สม่ำเสมอและองค์ประกอบที่เกี่ยวข้องเข้าสู่ผลลัพธ์
จากวิดีโอ (ดูส่วนท้ายของบทความ), แนวคิดสถาปัตยกรรมเบื้องหลังวิธีการผสมผสานของดิสนีย์, ซึ่งเมช CGI แบบดั้งเดิมที่ใช้สร้าง ‘เด็ก’ Carrie Fisher และ Peter Cushing ผู้เสียชีวิตสำหรับ Rogue One (2016) ถูกผสานเข้าไปในสภาพแวดล้อมใบหน้าที่เรนเดอร์ด้วยประสาทเทียม.
วิดีโอได้อ้างอิงโดยอ้อมถึงการวิพากษ์วิจารณ์บ่อยครั้งเกี่ยวกับความไม่เป็นธรรมชาติและผลกระทบของ ‘หุบเขาความแปลกประหลาด’ ของการสร้าง CGI ของนักแสดงชาวอังกฤษผู้เสียชีวิตจาก Star Wars อย่าง Peter Cushing ใน Rogue One (2016), โดยยอมรับว่า:
‘[ยัง] มีช่องว่างใหญ่ระหว่างสิ่งที่ผู้คนสามารถจับภาพและเรนเดอร์ได้อย่างง่ายดายกับดิจิทัลดับเบิลที่เป็นภาพถ่ายจริงสมบูรณ์พร้อมเส้นผม ดวงตา และภายในปาก. เพื่อปิดช่องว่างนี้ ปกติแล้วต้องอาศัยงานมือจำนวนมากจากศิลปินที่มีทักษะ.’
ความจริงแล้ว แม้ระบบจับภาพใบหน้าที่ทันสมัยที่สุดก็ไม่ได้พยายามสร้างดวงตา ภายในปาก หรือเส้นผมใหม่ ซึ่งส่วนเหล่านี้มีปัญหาเรื่องความเป็นจริงในเทคนิคดังกล่าว (ดวงตา) หรือความสม่ำเสมอเชิงเวลา (เส้นผม).

วิดีโอแสดงให้เห็นว่าศิลปิน VFX จะได้รับอะไรหลังจากการจับภาพใบหน้าที่ทันสมัยทั่วไป. ดวงตา เส้นผม หนวดเครา และภายในปากทั้งหมดจะต้องถูกจัดการโดยทีมแยกต่างหากในสายการผลิต, นอกเหนือจากการทำพื้นผิวและแสงสว่าง.
การควบคุมการส่องสว่าง
วิธีการผสมผสานนี้ยังเป็นประโยชน์ในการรีไลท์ – ซึ่งเป็นความท้าทายที่สำคัญสำหรับการเรนเดอร์ใบหน้าแบบประสาทเทียม, เนื่องจากการซ้อนชั้นผิว CGI สามารถรีไลท์ได้ง่ายกว่า

เวอร์ชันแอนิเมชันของวิธีการ CGI/Neural.
ในสภาพแวดล้อมที่ท้าทายมากขึ้น เช่น การถ่ายทำภายนอก, นักวิจัยได้พัฒนาวิธีการเติมภาพ (inpainting) รอบ ๆ โซนปลอดทหารแบบหนึ่งที่ล้อมรอบบุคคลที่กำลัง ‘สร้าง’
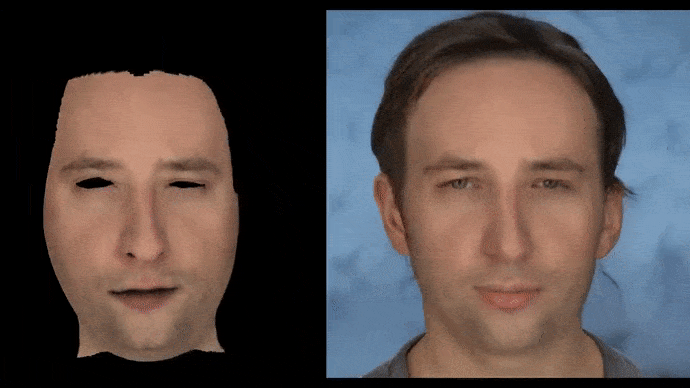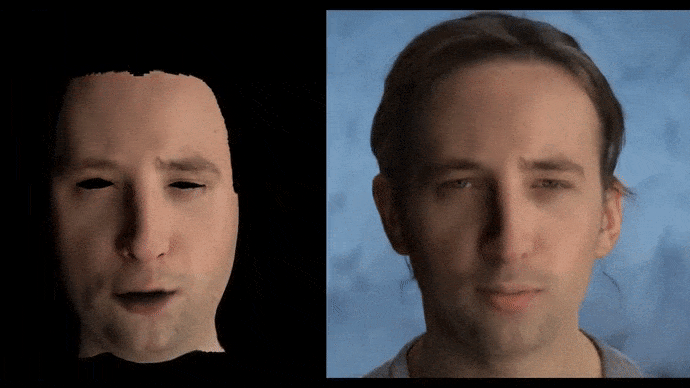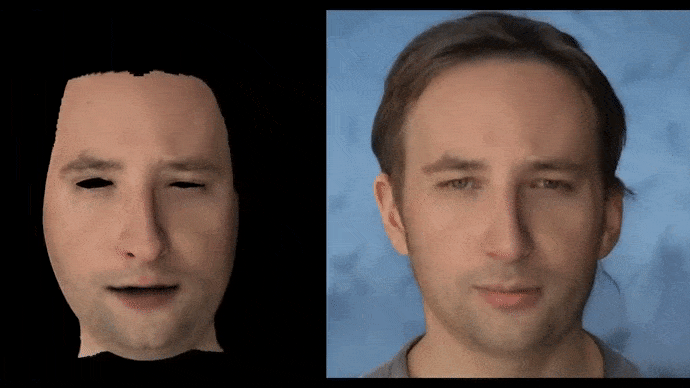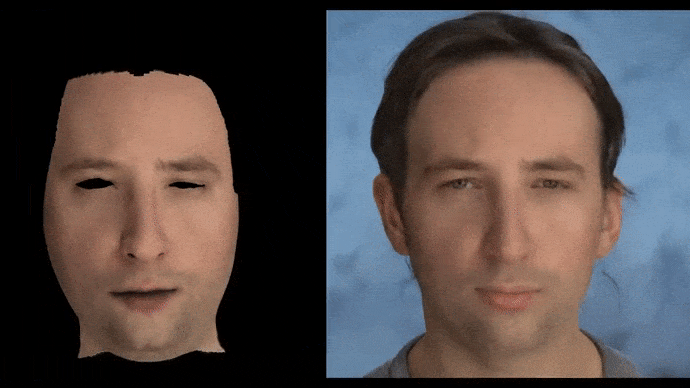
ขอบสีดำถูกสร้างขึ้นเพื่อเป็น ‘ผืนผ้าใบ’ สำหรับการเติมภาพส่วนภายนอกของอัตลักษณ์และการผสานผิว CGI เข้ากับผลลัพธ์ CGI/ประสาทเทียมที่ผสมกัน.
วิดีโออธิบายว่า:
‘[การ] เรนเดอร์ประสาทเทียมไม่ตรงกับข้อจำกัดของพื้นหลังอย่างสมบูรณ์ – มันมีไว้เป็นแนวทางเท่านั้น, เนื่องจากการปรับให้เหมาะสมกับส่วนประกอบมนุษย์ที่สมจริงเช่นเส้นผม ดวงตา และฟันเป็นเป้าหมายหลัก. สิ่งที่ท้าทายยิ่งขึ้นคือการพยายามรักษาอัตลักษณ์ที่สม่ำเสมอในขณะที่เปลี่ยนแสงสภาพแวดล้อม.’
การสร้างเมช CGI จากการเรนเดอร์แบบประสาทเทียม
ทีมวิจัยยังได้พัฒนา variational autoencoder ที่ฝึกด้วยฐานข้อมูลขนาดใหญ่ (ที่ไม่ได้ระบุ) ของภาพใบหน้า 3 มิติ, และอ้างว่าสามารถสร้างเมชใบหน้า 3 มิติที่ ‘สุ่มแต่สมเหตุสมผล’ จากข้อมูล ground truth
มีข้อจำกัดที่การวิจัยนี้ต้องเอาชนะ, รวมถึงความยากในการทำให้เส้นผมคงความสม่ำเสมอเชิงเวลาในภาพเรนเดอร์ประสาทเทียม, และวิดีโอ (ดูด้านล่าง) แสดงตัวอย่างหลายกรณีของเส้นผมที่เปลี่ยนแปลงอย่างรวดเร็วในมุมพานที่คงที่รอบใบหน้า CGI/ประสาทเทียม.
ความสม่ำเสมอเชิงเวลาในการเรนเดอร์วิดีโอประสาทเทียมเป็นปัญหาที่กว้างกว่าปัญหาของดิสนีย์เพียงอย่างเดียว, และดูเหมือนว่าการพัฒนาต่อไปของระบบนี้อาจใช้การเพิ่มเส้นผมในขั้นตอนหลัง (post) หรือวิธีการอื่น ๆ ในการสร้างเส้นผม แทนการคาดหวังว่าการประมวลผลประสาทเทียมใหม่จะสามารถแก้ไขได้ในที่สุด.
การใช้เพื่อการสร้างชุดข้อมูล
วิธีการนี้ยังถูกเสนอเป็นวิธีการสร้างข้อมูลสังเคราะห์และเพิ่มความหลากหลายให้กับชุดภาพใบหน้า, ซึ่งในหลายปีที่ผ่านมาได้กลายเป็น ซ้ำซากอย่างอันตราย.
ดิสนีย์คาดว่าเทคนิคใหม่จะเติมเต็มชุดข้อมูลภาพใบหน้า.
‘[ทุก] ผลลัพธ์ภาพถ่ายจริงที่เราสร้างมีเรขาคณิตพื้นฐานที่สอดคล้องและแผนที่ลักษณะการปรากฏ, ที่เรนเดอร์จากมุมกล้องที่ไม่ทราบโดยมีการส่องสว่างที่รู้จัก. ข้อมูล ‘ground truth’ นี้อาจมีความสำคัญต่อการฝึกโมเดลต่อไป, เช่น การสังเคราะห์ใบหน้า 3 มิติจากภาพเดียว, การจดจำใบหน้า, หรือการเข้าใจฉาก. ดังนั้นการเรนเดอร์แต่ละผลลัพธ์สามารถถือเป็นตัวอย่างข้อมูล, และเราสามารถสร้างหลายรูปแบบของบุคคลหลายคนได้.’
‘นอกจากนี้ แม้สำหรับบุคคลเดียวที่เรนเดอร์ด้วยอาการเดียวจากมุมมองและการส่องสว่างเดียว, เรายังสามารถสร้างความแปรผันแบบสุ่มของการเรนเดอร์ภาพถ่ายจริงโดยการเปลี่ยนค่า seed ของการสุ่มระหว่างการปรับแต่ง.’
นักวิจัยระบุว่าความหลากหลายของผลลัพธ์ที่กำหนดค่าได้นี้อาจเป็นประโยชน์ต่อการฝึกโมเดลการจดจำใบหน้า, โดยสรุปว่า:
‘[วิธีของเรา] สามารถใช้เทคโนโลยีปัจจุบันสำหรับการจับภาพผิวหน้า, การสร้างโมเดลและการเรนเดอร์, และสร้างการเรนเดอร์ใบหน้าแบบภาพถ่ายจริงที่ครบถ้วนโดยอัตโนมัติที่ตรงกับอัตลักษณ์, อาการและการกำหนดฉากที่ต้องการ. วิธีนี้มีการใช้งานในการเรนเดอร์ใบหน้าสำหรับภาพยนตร์และความบันเทิง, ช่วยลดแรงงานศิลปินมือและยังใช้สำหรับการสร้างข้อมูลในสาขาต่าง ๆ ของการเรียนรู้เชิงลึก.’
หากต้องการดูรายละเอียดเพิ่มเติมของวิธีการใหม่, สามารถชมวิดีโอความยาว 10 นาทีที่เผยแพร่วันนี้:
https://www.unite.ai/wp-content/uploads/2021/11/dataset-generation.jpg
* ลิงก์วิดีโอเดิมถูกแทนที่ด้วยลิงก์ที่ดูเหมือนจะเหมือนกันหลังจากบทความนี้เผยแพร่เป็นเวลา 8 ชั่วโมง. ฉันได้เปลี่ยนลิงก์ที่เกี่ยวข้องทั้งหมด เนื่องจากไม่มีร่องรอยของวิดีโอดั้งเดิม.
8:24 GMT+2 – วิดีโอถูกแทนที่, เนื่องจากช่อง Disney Research ของ YouTube สลับออกด้วยเหตุผลบางอย่าง.