
การเฝ้าระวัง
ใบหน้าสังเคราะห์ที่ลดคุณภาพอาจช่วยปรับปรุงการรู้จำใบหน้า

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
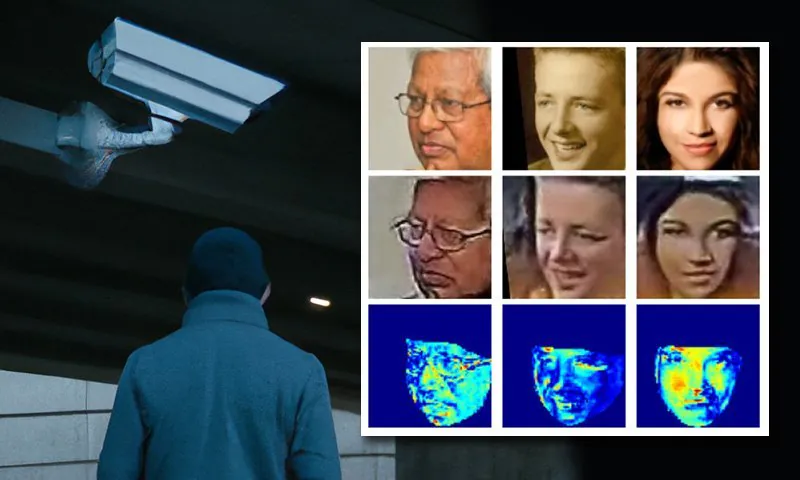
ประเด็นสำคัญใบหน้าที่สังเคราะห์ขึ้นโดยจัดสไตล์ให้เหมือนภาพจากกล้องวงจรปิดจริงสามารถลดช่องว่างของโดเม…
ดูเพิ่มเติม
- ใบหน้าที่สังเคราะห์ขึ้นโดยจัดสไตล์ให้เหมือนภาพจากกล้องวงจรปิดจริงสามารถลดช่องว่างของโดเมนที่ทำให้ความแม่นยำในการจดจำลดลงอย่างรุนแรง
- ระบบกล้องวงจรปิดรุ่นเก่ามีปัญหาหนี้ทางเทคนิคที่ทำให้เป็นแหล่งข้อมูลที่ไม่ดีสำหรับการฝึกระบบจดจำใบหน้าสมัยใหม่
- เทคนิคแบบฝ่ายตรงข้ามสามารถเสริมความแม่นยำในการจดจำได้ แทนที่จะเป็นเพียงภัยคุกคามเท่านั้น
นักวิจัยจากมหาวิทยาลัยมิชิแกนสเตตได้คิดค้นวิธีการที่ใบหน้าสังเคราะห์สามารถหยุดพักจากฉาก deepfakes และทำดีในโลกได้ – โดยการช่วยให้ระบบการรู้จำภาพมีความแม่นยำมากขึ้น
โมดูลการสังเคราะห์ใบหน้าที่ควบคุมได้ (CFSM) ที่พวกเขาคิดค้นขึ้นนี้สามารถสร้างใบหน้าใหม่ในลักษณะของการบันทึกวิดีโอการเฝ้าระวังในโลกแห่งความเป็นจริง มากกว่าที่จะพึ่งพาภาพที่มีคุณภาพสูงกว่าซึ่งใช้ในชุดข้อมูลที่เปิดกว้างที่ได้รับความนิยมของดารา ซึ่งไม่ได้สะท้อนถึงข้อบกพร่องและข้อจำกัดของระบบ CCTV จริงๆ เช่น ความเบลอของใบหน้า ความละเอียดต่ำ และสัญญาณรบกวน – ปัจจัยที่สามารถส่งผลต่อความแม่นยำในการรู้จำ

สถาปัตยกรรมแนวคิดสำหรับ Controllable Face Synthesis Module (CFSM). Source: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022.pdf
CFSM ไม่ได้ถูกออกแบบมาเพื่อจำลองท่าศีรษะ สีหน้า หรือคุณลักษณะทั่วไปอื่น ๆ ที่ระบบดีปเฟกมุ่งสร้างอย่างสมจริง แต่เพื่อสร้างมุมมองที่หลากหลายในลักษณะของระบบการรู้จำที่เป้าหมาย โดยใช้ การถ่ายโอนสไตล์
ระบบนี้ถูกออกแบบมาเพื่อเลียนแบบโดเมนสไตล์ของระบบเป้าหมาย และปรับผลลัพธ์ตามความละเอียดและช่วงของ ‘ความไม่สม่ำเสมอ’ ในนั้น การใช้งานรวมถึงระบบเก่าที่ไม่น่าจะได้รับการอัปเกรดเนื่องจากต้นทุน แต่ซึ่งสามารถมีส่วนร่วมน้อยมากในการรู้จำใบหน้าใหม่ๆ ได้เนื่องจากคุณภาพของเอาต์พุตที่ไม่ดี
การทดสอบระบบนี้ นักวิจัยพบว่ามันทำให้ได้ผลลัพธ์ที่ดีขึ้นอย่างมีนัยสำคัญในระบบการรู้จำภาพที่ต้องจัดการกับข้อมูลที่มีสัญญาณรบกวนและคุณภาพต่ำ

การฝึกอบรมโมเดลการรู้จำใบหน้าให้ปรับตัวเข้ากับข้อจำกัดของระบบเป้าหมาย Source: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022_supp.pdf
พวกเขายังพบผลพลอยได้ที่มีประโยชน์ของกระบวนการ – ที่ชุดข้อมูลเป้าหมายสามารถถูกอธิบายและเปรียบเทียบกับชุดข้อมูลอื่นๆ ได้ ทำให้การเปรียบเทียบและสร้างชุดข้อมูลตามต้องการสำหรับระบบ CCTV ที่แตกต่างกันง่ายขึ้นในอนาคต
นอกจากนี้ วิธีการนี้สามารถใช้กับชุดข้อมูลที่มีอยู่แล้ว โดยทำการปรับให้เข้ากับโดเมนโดยพฤตินัย และทำให้เหมาะกับระบบรู้จำใบหน้ามากขึ้น
บทความใหม่ นี้ มีชื่อเรื่องว่า การสร้างใบหน้าที่ควบคุมและชี้นำสำหรับการรู้จำใบหน้าไม่จำกัด ได้รับการสนับสนุนบางส่วนจากสำนักงานผู้อำนวยการข่าวกรองแห่งชาติ (ODNI ภายใต้ IARPA) ของสหรัฐอเมริกา และมาจากนักวิจัยสี่คนจากภาควิชาวิทยาศาสตร์คอมพิวเตอร์และวิศวกรรมของ MSU
เนื้อหาที่แนะนำ
การรู้จำใบหน้าที่มีคุณภาพต่ำ (LQFR) ได้กลายเป็น พื้นที่การศึกษาที่มีชื่อเสียง ในช่วงไม่กี่ปีที่ผ่านมา เนื่องจากหน่วยงานสาธารณะและเทศบาลสร้างระบบการเฝ้าระวังวิดีโอเพื่อให้มีความทนทานและคงทน (ไม่ต้องการจัดสรรทรัพยากรใหม่เพื่อแก้ปัญหาเป็นระยะ) ระบบเฝ้าระวัง ‘เก่า’ หลายระบบจึงกลายเป็นเหยื่อของหนี้สินทางเทคนิคในแง่ของความสามารถในการปรับตัวเป็นแหล่งข้อมูลสำหรับการเรียนรู้ของเครื่อง

ระดับความละเอียดของใบหน้าที่แตกต่างกันในระบบการเฝ้าระวังวิดีโอต่างๆ Source: https://arxiv.org/pdf/1805.11519.pdf
โชคดีที่มีโมเดลดิฟฟิวชันและโมเดลที่อาศัยสัญญาณรบกวนซึ่งสามารถแก้ปัญหานี้ได้ดี มีระบบสังเคราะห์ภาพที่ได้รับความนิยมในหลายปีที่ผ่านมา ซึ่งสามารถ การปรับขนาดขึ้น ของภาพที่มีความละเอียดต่ำเป็นส่วนหนึ่งของกระบวนการ ทั้งยังจำเป็นอย่างยิ่งต่อเทคนิคการบีบอัดแบบนิวรัล ซึ่งเก็บภาพและวิดีโอเป็นข้อมูลโครงข่ายประสาทแทนข้อมูลบิตแมป
ส่วนหนึ่งของความท้าทายในการรู้จำใบหน้าคือการได้รับผลลัพธ์ที่แม่นยำที่สุดจากจำนวน ‘คุณลักษณะ’ ที่น้อยที่สุดที่สามารถถูกดึงออกมาจากภาพขนาดเล็กและความละเอียดต่ำที่ให้ข้อมูลน้อยที่สุด ข้อจำกัดนี้ไม่ได้เกิดจากประโยชน์ของการระบุหรือสร้างใบหน้าที่ความละเอียดต่ำเท่านั้น แต่ยังมาจากข้อจำกัดทางเทคนิคของขนาดภาพที่ผ่านปริภูมิแฝงของโมเดลระหว่างฝึกได้ ภายใต้หน่วยความจำ VRAM ที่มีอยู่บน GPU ในเครื่อง
ในความหมายของ ‘คุณลักษณะ’ นี้อาจทำให้สับสน เนื่องจากคุณลักษณะเหล่านี้สามารถได้รับจากชุดข้อมูลของม้านั่งอีกด้วย ในสาขาการมองเห็นของคอมพิวเตอร์ ‘คุณลักษณะ’ หมายถึง ลักษณะที่แตกต่าง ที่ได้รับจากภาพ – ใดๆ ภาพ ไม่ว่าจะเป็นรูปทรงของโบสถ์ ภูเขา หรือการวาง ใบหน้า ในชุดข้อมูลใบหน้า
เนื่องจากอัลกอริทึมการมองเห็นของคอมพิวเตอร์สามารถปรับขนาดภาพและวิดีโอได้แล้ว วิธีการต่างๆ จึงถูกเสนอเพื่อ ‘ปรับปรุง’ วัสดุการเฝ้าระวังที่มีความละเอียดต่ำหรือเสื่อมสภาพ เพื่อให้สามารถ ใช้การเพิ่มคุณภาพเหล่านี้เพื่อวัตถุประสงค์ทางกฎหมาย เช่น การวางบุคคลที่เฉพาะเจาะจงไว้ที่ที่เกิดเหตุในกรณีการสืบสวนคดีอาญา
นอกจากความเสี่ยงที่จะระบุตัวบุคคลผิด ซึ่ง มีข่าวเป็นครั้งคราว ในทฤษฎีแล้วไม่จำเป็นต้องมีการปรับขนาดหรือเปลี่ยนแปลงภาพที่มีความละเอียดต่ำเพื่อให้สามารถรู้จำบุคคลได้ เนื่องจากระบบการรู้จำใบหน้าที่เน้นไปที่คุณลักษณะระดับต่ำไม่จำเป็นต้องมีความละเอียดและความชัดเจนในระดับนั้น อีกทั้งการแปลงภาพเช่นนี้มีค่าใช้จ่ายสูงในทางปฏิบัติ และก่อให้เกิดคำถามที่เกิดซ้ำเกี่ยวกับความน่าเชื่อถือและความชอบด้วยกฎหมาย
ความจำเป็นของภาพดาราที่มีคุณภาพต่ำมากขึ้น
จะดีกว่าถ้าระบบการรู้จำใบหน้าสามารถดึงคุณลักษณะ (เช่น คุณลักษณะการเรียนรู้ของเครื่องของ คุณลักษณะของมนุษย์) จากเอาต์พุตของระบบเก่าได้โดยการทำความเข้าใจความสัมพันธ์ระหว่าง ‘ความละเอียดสูง’ และภาพที่เสื่อมสภาพที่มีอยู่ในเฟรมเวิร์กการเฝ้าระวังวิดีโอที่ไม่เปลี่ยนแปลงและไม่สามารถแทนที่ได้
ปัญหาอยู่ที่มาตรฐาน: ชุดข้อมูลที่รวบรวมจากเว็บ เช่น MS-Celeb-1M และ WebFace260M (รวมถึงชุดข้อมูลอื่นๆ) ได้ถูกนำมาใช้โดยชุมชนการวิจัยเนื่องจากให้มาตรฐานที่สม่ำเสมอในการวัดความก้าวหน้า

ตัวอย่างจากชุดข้อมูล MS-Celeb1m ของ Microsoft Source: https://www.microsoft.com/en-us/research/project/ms-celeb-1m-challenge-recognizing-one-million-celebrities-real-world/
อย่างไรก็ตาม ผู้เขียนโต้แย้งว่าระบบการรู้จำใบหน้าที่ได้รับการฝึกอบรมจากชุดข้อมูลเหล่านี้ไม่เหมาะสมสำหรับ ‘โดเมน’ ของเอาต์พุตจากหลายระบบการเฝ้าระวังเก่า
บทความระบุว่า*:
«โมเดลรู้จำใบหน้าระดับแนวหน้า (SoTA) ทำงานได้ไม่ดีบนภาพเฝ้าระวังจริงในสภาพที่ไม่มีการควบคุม เนื่องจากปัญหาการเปลี่ยนโดเมน กล่าวคือ ชุดฝึกขนาดใหญ่ที่ควบคุมบางส่วนและรวบรวมใบหน้าดาราจากเว็บ ขาดความแปรผันจากสภาพจริง เช่น สัญญาณรบกวนของเซ็นเซอร์ ความละเอียดต่ำ ภาพเบลอจากการเคลื่อนไหว และผลของความปั่นป่วนของอากาศ»
‘ตัวอย่างเช่น ความแม่นยำในการยืนยันตัวตน 1:1 ที่รายงานโดย หนึ่งในรุ่นที่ดีที่สุด บนชุดข้อมูล IJB-S ที่ถ่ายในสภาพไม่ควบคุม ต่ำกว่าบนชุดข้อมูล LFW ที่ควบคุมบางส่วนประมาณ 30%
‘วิธีการแก้ปัญหาที่เป็นไปได้สำหรับช่องว่างการแสดงผลนี้คือการรวบรวมชุดข้อมูลใบหน้าที่ไม่จำกัดขนาดใหญ่ อย่างไรก็ตาม การสร้างชุดฝึกดังกล่าวที่มีบุคคลหลายหมื่นคนเป็นเรื่องยากอย่างยิ่ง เนื่องจากต้นทุนการใส่ป้ายกำกับด้วยมือสูง’
บทความทบทวนวิธีการก่อนหน้าที่พยายาม ‘จับคู่’ กับเอาต์พุตที่หลากหลายจากระบบการเฝ้าระวังเก่าหรือราคาถูก แต่สังเกตว่าเหล่านี้จัดการกับการเพิ่มข้อมูลแบบ «ไม่เห็นข้อมูลเป้าหมาย» ในทางกลับกัน CFSM ได้รับการให้ข้อมูลโดยตรงจากเอาต์พุตของระบบเป้าหมายในช่วงการฝึกอบรม และปรับตัวผ่านการถ่ายโอนสไตล์เพื่อเลียนแบบโดเมนนั้น

นักแสดง Natalie Portman ไม่ใช่คนแปลกหน้าสำหรับชุดข้อมูลที่มีอิทธิพลในชุมชนการมองเห็นของคอมพิวเตอร์ ซึ่งปรากฏในตัวอย่างนี้ของ CFSM ที่ทำการปรับโดเมนที่ตรงกับสไตล์ตามข้อมูลจากโดเมนของโมเดลเป้าหมาย
สถาปัตยกรรมที่ออกแบบโดยผู้เขียนใช้ Fast Gradient Sign Method (FGSM) เพื่อแยกและ ‘นำเข้า’ สไตล์และคุณลักษณะที่ได้รับจากเอาต์พุตจริงของระบบเป้าหมาย ส่วนของกระบวนการที่อุทิศให้กับการสร้างภาพจะปรับปรุงและกลายเป็นไปตามระบบเป้าหมายมากขึ้นด้วยการฝึกอบรม ข้อมูลป้อนกลับจากปริภูมิสไตล์มิติต่ำของระบบเป้าหมายนี้เป็นข้อมูลคุณลักษณะระดับต่ำ และสอดคล้องกับตัวบรรยายภาพทั่วไปที่สกัดได้
ผู้เขียนกล่าวว่า:
‘ด้วยข้อมูลจากโมเดลการรู้จำใบหน้า ภาพที่สังเคราะห์เป็นประโยชน์ต่อการแสดงผลของโมเดลการรู้จำใบหน้า ซึ่งนำไปสู่ความสามารถในการนำไปใช้กับข้อมูลใหม่ที่ดีขึ้นอย่างมีนัยสำคัญของโมเดลการรู้จำใบหน้าที่ฝึกอบรมด้วย’
การทดสอบ
นักวิจัยใช้ผลงานก่อนหน้าของ MSU เป็นแบบอย่างสำหรับการทดสอบระบบของพวกเขา โดยใช้ MS-Celeb-1m ซึ่งประกอบด้วยภาพถ่ายของดาราที่รวบรวมจากเว็บเป็นชุดฝึกที่มีป้ายกำกับ โดยใช้ระเบียบการทดลองเดียวกัน เพื่อความเป็นธรรมยังรวม MS1M-V2 ซึ่งมีภาพ 3.9 ล้านภาพใน 85,700 คลาสด้วย
ข้อมูลเป้าหมายคือชุดข้อมูล WiderFace จากมหาวิทยาลัยจีนแห่งฮ่องกง ซึ่งเป็นชุดข้อมูลที่หลากหลายที่ออกแบบสำหรับการตรวจจับใบหน้าในสถานการณ์ที่ท้าทาย 70,000 ภาพจากชุดข้อมูลนี้ถูกใช้
สำหรับการประเมิน ระบบถูกทดสอบกับชุดข้อมูลการรู้จำใบหน้า 4 ชุด: IJB-B, IJB-C, IJB-S และ TinyFace
CFSM ถูกฝึกอบรมด้วย ∼10% ของข้อมูลการฝึกอบรมจาก MS-Celeb-1m ซึ่งประกอบด้วยภาพประมาณ 0.4 ล้านภาพ สำหรับ 125,000 การวนซ้ำที่ขนาดแบตช์ 32 ภายใต้ตัวเลือก Adam optimizer ที่อัตราการเรียนรู้ต่ำมากที่ 1e-4
โมเดลการรู้จำใบหน้าเป้าหมายใช้ การปรับเปลี่ยน ของ ResNet-50 สำหรับโครงร่างหลัก โดยมีฟังก์ชันการสูญเสีย ArcFace เปิดใช้งานระหว่างการฝึก นอกจากนี้ยังฝึกโมเดลด้วย CFSM สำหรับการทดลองตัดองค์ประกอบและการเปรียบเทียบ ซึ่งระบุว่า «ArcFace» ในตารางผลลัพธ์ด้านล่าง

ผลลัพธ์จากการทดสอบหลักสำหรับ CFSM ค่ายิ่งสูงยิ่งดี
ผู้เขียนกล่าวถึงผลลัพธ์หลัก:
‘โมเดล ArcFace มีประสิทธิภาพเหนือกว่าแบบจำลองอื่นๆ ทั้งในงานระบุตัวตนและยืนยันตัวตน และบรรลุผลลัพธ์ที่ดีที่สุดใหม่’
ความสามารถในการดึงโดเมนจากคุณลักษณะต่างๆ ของระบบการเฝ้าระวังที่มีอายุการใช้งานยาวนานหรือไม่เหมาะสมยังช่วยให้ผู้เขียนสามารถเปรียบเทียบและประเมินความคล้ายคลึงกันของการกระจายตัวในระบบเหล่านี้ และนำเสนอระบบแต่ละระบบในแง่ของสไตล์ภาพที่สามารถใช้ประโยชน์ได้ในงานอนาคต

ตัวอย่างจากชุดข้อมูลต่างๆ แสดงถึงความแตกต่างที่ชัดเจนในเรื่องสไตล์
ผู้เขียนยังบ่งชี้ว่าระบบของพวกเขาสามารถใช้ประโยชน์จากเทคโนโลยีบางอย่างที่ถูกมองว่าเป็นปัญหาในการแก้ไขโดยชุมชนการวิจัยและวิสัยทัศน์:
‘[CFSM] แสดงให้เห็นว่าการบิดเบือนแบบโจมตีสามารถเกินกว่าการเป็นโจมตีและเพิ่มความแม่นยำในการรู้จำในงานการมองเห็นได้ ในขณะเดียวกัน เรากำหนดมาตรการความคล้ายคลึงกันของชุดข้อมูลตามพื้นฐานสไตล์ที่เรียนรู้ ซึ่งจับความแตกต่างของสไตล์ในลักษณะที่ไม่ขึ้นอยู่กับป้ายกำกับหรือตัวทำนาย’
‘เรามั่นใจว่าการวิจัยของเรานำเสนอพลังของโมเดลการสร้างใบหน้าที่ควบคุมและชี้นำสำหรับการรู้จำใบหน้าที่ไม่จำกัด และให้ความเข้าใจเกี่ยวกับความแตกต่างของชุดข้อมูล’
* การแปลงอ้างอิงในบรรทัดของฉันให้เป็นลิงก์
เผยแพร่ครั้งแรกเมื่อวันที่ 1 สิงหาคม 2022


