มุมมองของ Anderson
การตัดภาพ AI ที่เข้าใจฉาก

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ในสารคดีพิเศษที่มาพร้อมกับการปล่อย DVD ปี 2003 ของ Alien3 (1992) ตำนานผู้เชี่ยวชาญเอฟเฟกต์ภาพ Richard Edlund ได้ระลึกถึงด้วยความหวาดกลัวการ ‘ต่อสู้ซูโม่’ ของการสกัดแมตต์แบบโฟโตเคมีที่ครอบงำงานเอฟเฟกต์ภาพตั้งแต่ช่วง ปลายทศวรรษ 1930 จนถึงปลายทศวรรษ 1980 Edlund อธิบายลักษณะการทำงานที่ขึ้นอยู่กับโชคของกระบวนการว่าเป็น ‘ต่อสู้ซูโม่’ เมื่อเทียบกับเทคนิคหน้าจอสีฟ้า/สีเขียวดิจิทัลที่เข้ามาแทนที่ในต้นทศวรรษ 1990 (และเขาได้ กลับมาใช้อุปมาอุปมัยนี้อีกครั้งตั้งแต่นั้น)
การสกัดวัตถุพื้นหน้า (เช่น คนหรือโมเดลยานอวกาศ) จากพื้นหลัง เพื่อให้ภาพที่ตัดออกสามารถนำมาผสมกับพื้นหลังอื่นได้เดิมทำโดยการถ่ายวัตถุพื้นหน้าอยู่หน้าพื้นหลังสีฟ้าหรือสีเขียวที่เป็นสีเดียวกัน
กระบวนการสกัดโฟโตเคมีที่ใช้แรงงานมากสำหรับช็อต VFX ของ ILM สำหรับ ‘Return of the Jedi’ (1983).
ในคลิปที่ได้ สีพื้นหลังจะถูกแยกออกโดยกระบวนการเคมีและใช้เป็นแม่แบบเพื่อพิมพ์ซ้ำวัตถุพื้นหน้า (หรือคน) ใน เครื่องพิมพ์ออปติคัล เป็นวัตถุ ‘ลอย’ ในเซลล์ฟิล์มที่โปร่งใสโดยส่วนอื่น
กระบวนการนี้เรียกว่า color separation overlay (CSO) – แม้ว่าคำนี้ในที่สุดจะถูกเชื่อมโยงกับเอฟเฟกต์วิดีโอ ‘Chromakey’ แบบหยาบในรายการโทรทัศน์งบประมาณต่ำของทศวรรษ 1970 และ 1980 ซึ่งทำด้วยวิธีอนาล็อกแทนเคมีหรือดิจิทัล

การสาธิต Color Separation Overlay ในปี 1970 สำหรับรายการเด็กของอังกฤษ ‘Blue Peter’. Source: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
อย่างไรก็ตาม ไม่ว่าจะเป็นภาพยนตร์หรือวิดีโอ หลังจากนั้นคลิปที่สกัดได้สามารถแทรกเข้าไปในคลิปอื่นใดก็ได้
แม้กระบวนการ sodium-vapor ของ Disney ที่มีค่าใช้จ่ายสูงและเป็นกรรมสิทธิ์ sodium-vapor process (ซึ่งใช้สีเหลืองเป็นคีย์และยัง ถูกใช้ในภาพสยองขวัญของ Alfred Hitchcock ปี 1963 The Birds) ให้ความคมชัดและแมตต์ที่คมชัดขึ้น การสกัดโฟโตเคมียังคงเป็นกระบวนการที่ใช้แรงงานมากและไม่น่าเชื่อถือ
[caption id="attachment_181256" align="alignnone" width="482"]
เหนือการตัดภาพดิจิทัล
ในทศวรรษ 1990 การปฏิวัติดิจิทัลทำให้ไม่ต้องใช้สารเคมีแล้ว แต่ยังคงต้องการหน้าจอสีเขียว การลบพื้นหลังสีเขียว (หรือสีใดก็ได้) สามารถทำได้โดยการค้นหาพิกเซลในช่วงความคลาดเคลื่อนของสีนั้นในซอฟต์แวร์แก้ไขภาพเช่น Photoshop และชุดซอฟต์แวร์คอมโพสิตวิดีเจนใหม่ที่สามารถคีย์พื้นหลังสีอัตโนมัติได้ เกือบในชั่วข้ามคืน หกสิบปี ของอุตสาหกรรมการพิมพ์ออปติคัลถูกส่งเข้าสู่ประวัติศาสตร์
สิบปีที่ผ่านมาในการวิจัยคอมพิวเตอร์วิชั่นที่เร่งด้วย GPU กำลังนำการสกัดแมตต์เข้าสู่ยุคที่สาม โดยมอบหมายให้ผู้วิจัยพัฒนาระบบที่สามารถสกัดแมตต์คุณภาพสูงโดยไม่ต้องใช้หน้าจอสีเขียว เพียงที่ Arxiv เท่านั้น มีบทความที่เกี่ยวกับนวัตกรรมการสกัดพื้นหน้าโดยใช้การเรียนรู้ของเครื่องเป็นประจำทุกสัปดาห์
ใส่เราในภาพ
จุดศูนย์กลางของความสนใจจากภาควิชาการและอุตสาหกรรมต่อการสกัด AI นี้ได้ส่งผลต่อพื้นที่ผู้บริโภคแล้ว – การนำไปใช้ที่หยาบแต่ทำงานได้คุ้นเคยกับเราทุกคนในรูปแบบของฟิลเตอร์ Zoom และ Skype ที่สามารถเปลี่ยนพื้นหลังห้องนั่งเล่นของเราเป็นเกาะเขตร้อน ฯลฯ ในการประชุมวิดีโอ
อย่างไรก็ตาม แมตต์ที่ดีที่สุดยังคงต้องการหน้าจอสีเขียว ตามที่ Zoom รายงาน เมื่อวันพุธที่ผ่านมา
ซ้าย: ชายคนหนึ่งอยู่หน้าหน้าจอสีเขียว โดยมีเส้นผมที่สกัดอย่างดีผ่านฟีเจอร์ Virtual Background ของ Zoom. ขวา: ผู้หญิงคนหนึ่งอยู่หน้าฉากภายในบ้านทั่วไป โดยเส้นผมถูกสกัดด้วยอัลกอริทึม ความแม่นยำน้อยกว่าและต้องการกำลังคอมพิวเตอร์สูงกว่า. แหล่งที่มา: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image Source: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
โพสต์เพิ่มเติม จากแพลตฟอร์มสนับสนุนของ Zoom เตือนว่าการสกัดโดยไม่ใช้หน้าจอสีเขียวยังต้องการกำลังคอมพิวเตอร์ที่สูงขึ้นในอุปกรณ์จับภาพ
ความจำเป็นในการตัดออก
การปรับปรุงคุณภาพ ความพกพาและประหยัดทรัพยากรของระบบสกัดแมตต์แบบ ‘ในสภาพแวดล้อมจริง’ (เช่น การแยกคนโดยไม่ต้องใช้หน้าจอสีเขียว) มีความสำคัญต่อหลายภาคส่วนและการใช้งานมากกว่าฟิลเตอร์การประชุมวิดีโอเท่านั้น
สำหรับการพัฒนาชุดข้อมูล การรับรู้ใบหน้า ศีรษะเต็มรูปแบบ และร่างกายเต็มรูปแบบที่ดีขึ้นทำให้สามารถรับประกันได้ว่าองค์ประกอบพื้นหลังที่ไม่เกี่ยวข้องจะไม่ถูกฝึกเข้าสู่โมเดลคอมพิวเตอร์วิชั่นของมนุษย์; การแยกที่แม่นยำมากขึ้นจะช่วยปรับปรุงเทคนิค semantic segmentation ที่ออกแบบมาเพื่อแยกและรวมโดเมน (เช่น ‘cat’, ‘person’, ‘boat’) และปรับปรุงระบบสังเคราะห์ภาพที่อิง VAE และ transformer เช่น DALL-E 2 ของ OpenAI; และอัลกอริทึมการสกัดที่ดีกว่าจะลดความจำเป็นในการทำ rotoscoping ด้วยมือที่มีค่าใช้จ่ายสูงในสายการผลิต VFX
ในความเป็นจริง การเติบโตของวิธีการ multimodal (โดยทั่วไปคือข้อความ/ภาพ) ที่โดเมนเช่น ‘cat’ ถูกเข้ารหัสทั้งเป็นภาพและข้อความที่เกี่ยวข้อง กำลังทำลายเข้าสู่การประมวลผลภาพ ตัวอย่างล่าสุดคือสถาปัตยกรรม Text2Live ซึ่งใช้การฝึกแบบหลายโหมด (ข้อความ/ภาพ) เพื่อสร้างวิดีโอของหลายความเป็นไปได้รวมถึง หงส์คริสตัลและยีราฟแก้ว
การตัดภาพ AI ที่รับรู้ฉาก
งานวิจัยจำนวนมากเกี่ยวกับการตัดภาพอัตโนมัติด้วย AI มุ่งเน้นไปที่การรับรู้ขอบเขตและการประเมินการจัดกลุ่มพิกเซลภายในภาพหรือเฟรมวิดีโอ อย่างไรก็ตาม งานวิจัยใหม่จากจีนได้นำเสนอขั้นตอนการสกัดที่ปรับปรุงการกำหนดเส้นขอบและคุณภาพแมตต์โดยใช้ คำอธิบายแบบข้อความ ของฉาก (แนวทางหลายโหมดที่ได้รับความนิยมในวงการวิจัยคอมพิวเตอร์วิชั่นในช่วง 3‑4 ปีที่ผ่านมา) โดยอ้างว่าปรับปรุงวิธีเดิมหลายด้าน

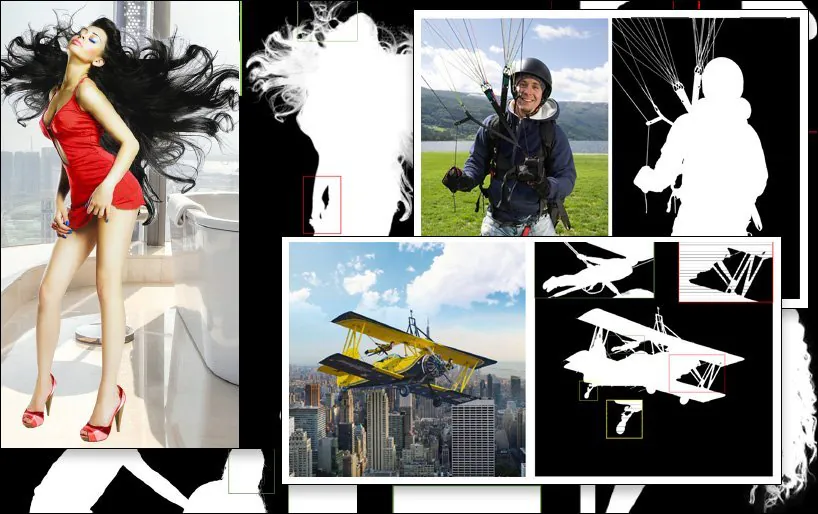
ตัวอย่างการสกัด SPG-IM (ภาพสุดท้ายด้านล่างขวา) เปรียบเทียบกับวิธีก่อนหน้าที่แข่งขันกัน. แหล่งที่มา: https://arxiv.org/pdf/2204.09276.pdf
Source: https://www.unite.ai/wp-content/uploads/2022/04/foreground-extraction.jpg
ความท้าทายที่เกิดขึ้นสำหรับสาขาย่อยการวิจัยการสกัดคือการสร้างกระบวนการทำงานที่ต้องการการทำเครื่องหมายและการแทรกแซงของมนุษย์ให้น้อยที่สุด – อุดมคติคือไม่มีเลย นอกจากผลกระทบด้านค่าใช้จ่าย นักวิจัยของบทความใหม่สังเกตว่าการทำเครื่องหมายและการแบ่งส่วนด้วยมือที่ทำโดยผู้ทำงานจากภายนอกในหลายวัฒนธรรมอาจทำให้ภาพถูกตั้งชื่อหรือแบ่งส่วนในรูปแบบที่แตกต่างกัน ส่งผลให้เกิดอัลกอริทึมที่ไม่สอดคล้องและไม่พอใจ
ตัวอย่างหนึ่งของสิ่งนี้คือการตีความตามอัตวิสัยว่ากำหนด ‘วัตถุพื้นหน้า’ อย่างไร:

จากบทความใหม่: วิธีก่อนหน้า LFM และ MODNet (‘GT’ หมายถึง Ground Truth, ผลลัพธ์ ‘อุดมคติ’ ที่มักทำด้วยมือหรือวิธีที่ไม่ใช้อัลกอริทึม) มีการกำหนดเนื้อหาพื้นหน้าที่แตกต่างและมีประสิทธิภาพต่างกัน ในขณะที่วิธี SPG-IM ใหม่กำหนด ‘เนื้อหาใกล้เคียง’ อย่างมีประสิทธิภาพมากขึ้นผ่านบริบทของฉาก.
เพื่อแก้ไขปัญหานี้ นักวิจัยได้พัฒนาขั้นตอนสองขั้นตอนที่ชื่อว่า Situational Perception Guided Image Matting (SPG-IM) สถาปัตยกรรม encoder/decoder สองขั้นตอนประกอบด้วย Situational Perception Distillation (SPD) และ Situational Perception Guided Matting (SPGM)

สถาปัตยกรรม SPG-IM.
ขั้นแรก SPD ทำการฝึกล่วงหน้าการแปลงคุณลักษณะจากภาพเป็นข้อความ เพื่อสร้างคำอธิบายที่เหมาะสมกับภาพที่เกี่ยวข้อง หลังจากนั้น การทำนายหน้ากากพื้นหน้าจะเปิดใช้งานโดยเชื่อมต่อขั้นตอนกับเทคนิค การพยากรณ์ความสำคัญ (saliency prediction) ใหม่
จากนั้น SPGM จะให้ผลลัพธ์เป็นอัลฟ่าแมตต์ที่ประมาณจากอินพุตภาพ RGB ดิบและหน้ากากที่สร้างขึ้นในโมดูลแรก
เป้าหมายคือการให้คำแนะนำโดยอิงการรับรู้สถานการณ์ ซึ่งระบบจะเข้าใจบริบทของภาพ ทำให้สามารถกำหนดกรอบ – ตัวอย่างเช่น – ความท้าทายของการสกัดเส้นผมซับซ้อนจากพื้นหลังโดยอิงลักษณะเฉพาะของงานนั้น

ในตัวอย่างด้านล่าง SPG-IM เข้าใจว่าสายเคเบิลเป็นส่วนหนึ่งของ ‘ร่มชูชีพ’ ซึ่ง MODNet ไม่สามารถรักษาและกำหนดรายละเอียดเหล่านี้ได้ เช่นเดียวกันในภาพด้านบน โครงสร้างเต็มของอุปกรณ์สนามเด็กเล่นหายไปอย่างไม่มีเหตุผลใน MODNet.
บทความ ใหม่ มีชื่อว่า Situational Perception Guided Image Matting และมาจากนักวิจัยที่ OPPO Research Institute, PicUp.ai, และ Xmotors
แมตต์อัตโนมัติอัจฉริยะ
SPG-IM ยังนำเสนอ Adaptive Focal Transformation (AFT) Refinement Network ที่สามารถประมวลผลรายละเอียดท้องถิ่นและบริบททั่วโลกแยกกัน ทำให้เกิด ‘แมตต์อัจฉริยะ’

การเข้าใจบริบทของฉาก ในกรณีนี้ ‘เด็กหญิงกับม้า’ อาจทำให้การสกัดพื้นหน้าเป็นเรื่องง่ายกว่าวิธีก่อนหน้า.
‘เราเชื่อว่าการแสดงผลภาพจากงาน visual-to-textual เช่น การอธิบายภาพ (image captioning) มุ่งเน้นสัญญาณเชิงความหมายที่ครอบคลุมมากขึ้นระหว่าง a) วัตถุถึงวัตถุ และ b) วัตถุถึงสภาพแวดล้อมรอบข้าง เพื่อสร้างคำอธิบายที่ครอบคลุมทั้งข้อมูลทั่วโลกและรายละเอียดท้องถิ่น นอกจากนี้ เมื่อเทียบกับการทำเครื่องหมายพิกเซลที่มีค่าใช้จ่ายสูงของการตัดภาพ การใช้ป้ายกำกับข้อความสามารถรวบรวมได้เป็นจำนวนมากในต้นทุนที่ต่ำมาก’
สาขา SPD ของสถาปัตยกรรมได้รับการฝึกล่วงหน้าร่วมกับ VirTex ของมหาวิทยาลัยมิชิแกน ซึ่งเป็นตัวถอดรหัสข้อความแบบทรานสฟอร์มเมอร์ ที่เรียนรู้การแสดงผลภาพจากคำอธิบายที่มีความหนาแน่นเชิงความหมาย
VirTex ฝึกร่วมกัน ConvNet และ Transformers ผ่านคู่ภาพ-คำอธิบาย และถ่ายทอดความเข้าใจที่ได้ไปยังงานวิสัยทัศน์ต่อเนื่องเช่นการตรวจจับวัตถุ. แหล่งที่มา: https://arxiv.org/pdf/2006.06666.pdf Source: https://arxiv.org/pdf/2006.06666.pdf
รวมถึงการทดสอบและการศึกษาการตัดส่วนอื่น ๆ นักวิจัยได้ทดสอบ SPG-IM กับวิธีที่อิง trimap ระดับแนวหน้า ได้แก่ Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA, และ Semantic Image Mapping (SIM)
กรอบงานก่อนหน้าที่ทดสอบอื่น ๆ รวมถึงวิธีที่ไม่ใช้ trimap LFM, HAttMatting, และ MODNet เพื่อการเปรียบเทียบที่เป็นธรรม วิธีทดสอบถูกปรับตามวิธีการที่แตกต่างกัน; ในกรณีที่ไม่มีโค้ด ให้ทำการจำลองเทคนิคของบทความจากสถาปัตยกรรมที่อธิบาย
‘SPG-IM ของเราเหนือกว่าวิธี trimap-free ทั้งหมด ([LFM], [HAttMatting] และ [MODNet]) อย่างมาก นอกจากนี้ โมเดลของเรายังแสดงความเหนือชั้นอย่างโดดเด่นเหนือวิธีที่อิง trimap และ mask-guided ระดับแนวหน้า (SOTA) ในแง่ของสี่เมตริกทั้งหมดบนชุดข้อมูลสาธารณะ (เช่น Composition-1K, Distinction-646, และ Human-2K) รวมถึงเกณฑ์ Multi-Object-1K ของเรา’
‘สามารถเห็นได้ชัดเจนว่าวิธีของเรารักษารายละเอียดละเอียด (เช่น ปลายเส้นผม, เนื้อโปร่งใส, และขอบเขต) โดยไม่ต้องอาศัย trimap นอกจากนี้ เมื่อเทียบกับโมเดล trimap-free ที่แข่งขันอื่น ๆ SPG-IM ของเราสามารถรักษาความสมบูรณ์เชิงความหมายระดับโลกได้ดีกว่า’


เผยแพร่ครั้งแรก 24 เมษายน 2022.