
มุมมองของ Anderson
การแก้ไขวิดีโอ AI ที่สอดคล้องกันด้วยการป้อนข้อมูลแบบข้อความ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
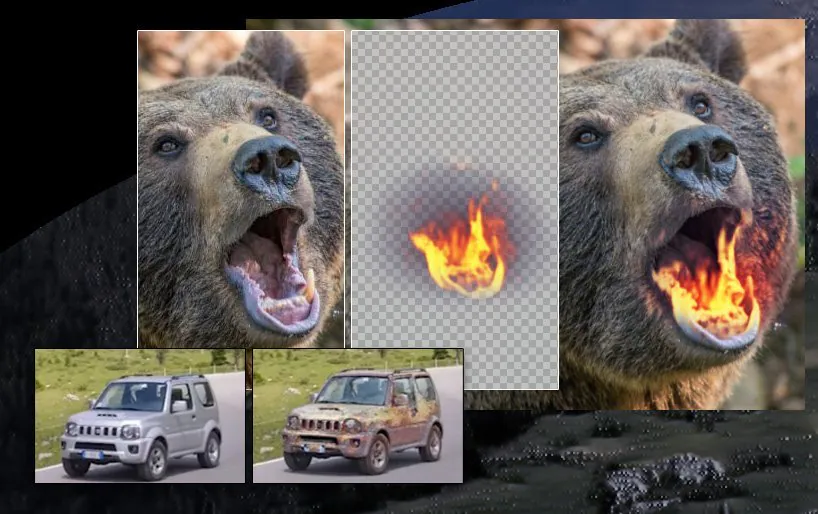
ประเด็นสำคัญText2Live ช่วยให้การแก้ไขวิดีโอสอดคล้องกันจากข้อความแจ้งเตือน โดยไม่ต้องประมวลผลทีละเฟรม
ดูเพิ่มเติม
- Text2Live ช่วยให้การแก้ไขวิดีโอสอดคล้องกันจากข้อความแจ้งเตือน โดยไม่ต้องประมวลผลทีละเฟรม
- ระบบใช้แผนที่ชั้นประสาทเพื่อใช้การแก้ไขเพียงครั้งเดียวตลอดทั้งไทม์ไลน์วิดีโอ
- Text2Live ทำให้การสร้างมาสก์และการประกอบภาพเป็นอัตโนมัติ ขจัดความจำเป็นในการโรโตสโคปหรือกรีนสกรีน
ในขณะที่ชุมชน VFX มืออาชีพตื่นเต้นและบางครั้งรู้สึกถูกคุกคามจากนวัตกรรมใหม่ๆ ในการสร้างภาพและวิดีโอ การขาดความต่อเนื่องในเวลาของโครงการแก้ไขวิดีโอที่ใช้ AI ส่วนใหญ่ทำให้ความพยายามเหล่านี้อยู่ในขอบเขตของภาพหลอนชวนเคลิบเคลิ้ม ด้วยเนื้อหาสะท้อนแสงและโครงสร้างที่เปลี่ยนแปลงอย่างรวดเร็ว และผลกระทบอื่นๆ ที่ไม่สม่ำเสมอ เช่น สิ่งที่เปล่งแสงและเปลี่ยนแปลงอย่างรวดเร็ว และการจัดการเทคโนโลยีอย่างหยาบ ๆที่ทำให้นึกถึง ยุคฟิล์มโฟโตเคมี ของเอฟเฟกต์ภาพ
หากคุณต้องการเปลี่ยนแปลงบางสิ่งที่เฉพาะเจาะจงในการแก้ไขวิดีโอที่ไม่อยู่ในขอบเขตของการสร้างภาพปลอม (เช่น การกำหนดอัตลักษณ์ใหม่ให้กับบุคคลในภาพ) วิธีแก้ปัญหาในปัจจุบันส่วนใหญ่ทำงานภายใต้ข้อจำกัดที่รุนแรงในแง่ของความแม่นยำที่จำเป็นสำหรับวิชวลเอฟเฟกต์ที่ได้คุณภาพระดับงานผลิตจริง
หนึ่งในข้อยกเว้นคืองานที่กำลังดำเนินอยู่ของนักวิจัยจากสถาบันวิทยาศาสตร์ Weizmann ในปี 2021 นักวิจัยสามคนจากสถาบันนี้ร่วมกับ Adobe (ADBE ) ประกาศ วิธีการใหม่สำหรับการแยกส่วนวิดีโอและวางแผนที่ภายในที่สอดคล้องกัน – layered neural atlas – ลงในผลลัพธ์ที่ประกอบด้วยช่อง alpha และผลลัพธ์ที่สอดคล้องกันในแง่ของเวลา
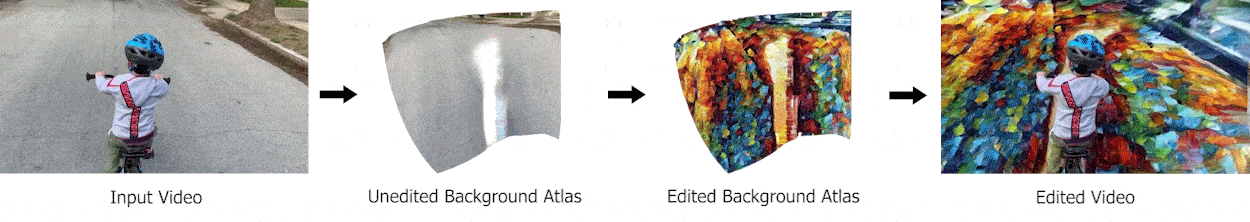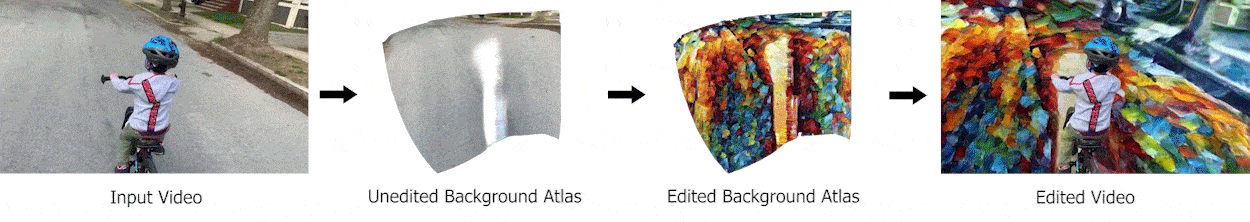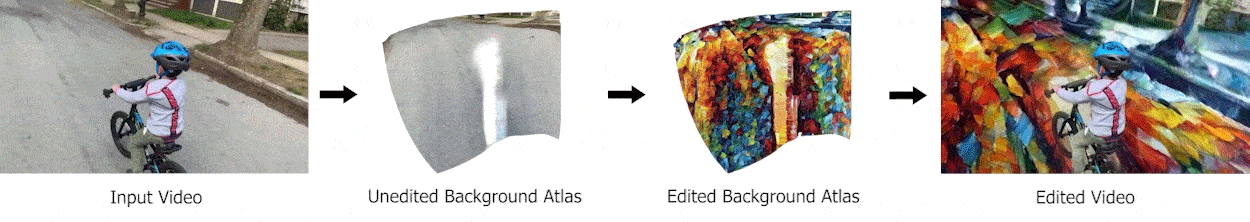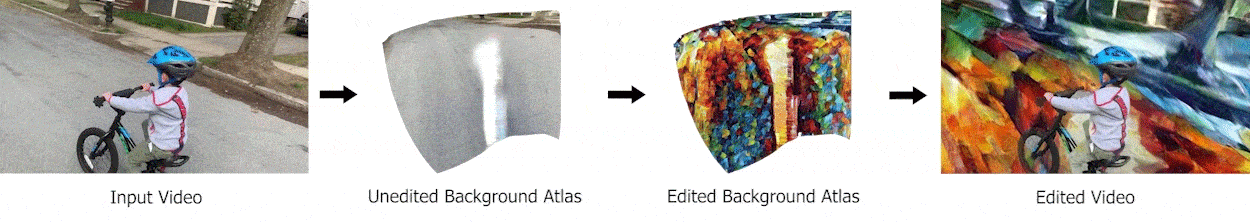
จากเอกสารวิจัยปี 2021: ภาพประมาณของถนนตลอดเส้นทางที่ปรากฏในคลิปต้นฉบับถูกแก้ไขด้วยโครงข่ายประสาทเทียม ในแบบที่ปกติต้องทำโรโตสโคปและจับคู่การเคลื่อนไหวอย่างมาก เนื่องจากองค์ประกอบพื้นหลังและพื้นหน้าถูกจัดการด้วยคนละโครงข่าย มาสก์จึงเป็นอัตโนมัติอย่างแท้จริง ที่มา: https://layered-neural-atlases.github.io/
แม้ว่าจะอยู่ในขอบเขตที่ครอบคลุมโดย การไหลของภาพ ในกระบวนการ VFX แต่แผนที่ที่มีหลายชั้นนี้ไม่มีเทียบเท่าในกระบวนการ CGI แบบดั้งเดิม เนื่องจากมันประกอบขึ้นเป็น “แผนที่พื้นผิวตามเวลา” ที่สามารถสร้างและแก้ไขด้วยวิธีใช้ซอฟต์แวร์ทั่วไปได้ ในภาพที่สองของภาพประกอบด้านบน พื้นหลังของผิวถนนถูกแสดงเป็นภาพแทนตลอดช่วงเวลาของวิดีโอ การแก้ไขภาพพื้นฐานนี้ ซึ่งเป็นภาพที่สามจากซ้าย จะทำให้พื้นหลังเปลี่ยนอย่างสอดคล้องกัน
รูปภาพของ “แผนที่ที่คลี่ออก” ข้างต้นแสดงถึงเฟรมที่ตีความแต่ละเฟรมเท่านั้น การเปลี่ยนแปลงที่สอดคล้องกันในเฟรมวิดีโอที่เป้าหมายจะถูกแมปกลับไปยังเฟรมต้นฉบับ โดยรักษาการปิดบังและผลกระทบฉากอื่นๆ ที่จำเป็น เช่น เงาหรือการสะท้อน
สถาปัตยกรรมหลักใช้ Multilayer Perceptron (MLP) เพื่อแสดงแผนที่ที่คลี่ออก ช่อง alpha และการแมปทั้งหมด ซึ่งทั้งหมดนี้ได้รับการปรับให้เหมาะสมพร้อมกันและทั้งหมดในพื้นที่ 2 มิติ จึงไม่ต้องอาศัยความรู้ล่วงหน้าเกี่ยวกับจุดเรขาคณิต 3 มิติแบบ NeRF แผนที่ความลึก และเครื่องมือ CGI อื่นๆ
แผนที่อ้างอิงของวัตถุแต่ละชิ้นสามารถเปลี่ยนแปลงได้อย่างน่าเชื่อถือ:
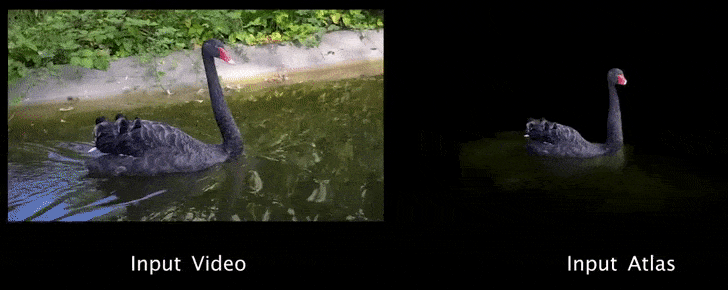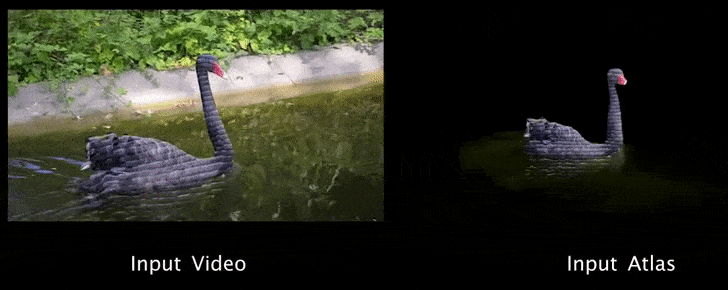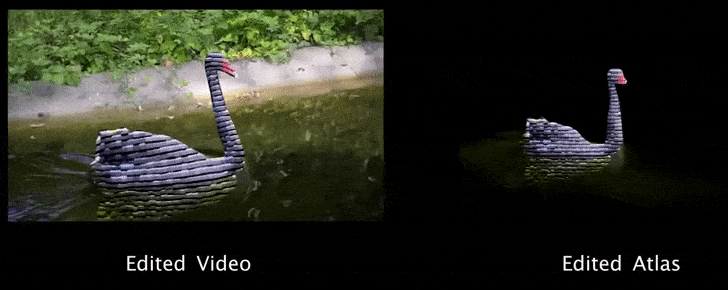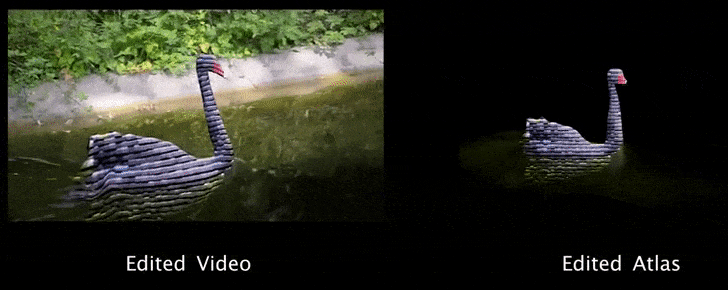
การเปลี่ยนแปลงที่สอดคล้องกันของวัตถุที่เคลื่อนไหวภายใต้โครงสร้างปี 2021 ที่มา: https://www.youtube.com/watch?v=aQhakPFC4oQ
โดยสรุป ระบบปี 2021 รวมการจัดแนวเรขาคณิต การจับคู่การเคลื่อนไหว การแมป การเปลี่ยนพื้นผิว และการทำโรโตสโคปไว้ในกระบวนการโครงข่ายประสาทเทียมเดียว
Text2Live
นักวิจัยสามคนจากเอกสารวิจัยปี 2021 ร่วมกับนักวิจัยจาก NVIDIA (NVDA ) เป็นผู้ร่วมให้ข้อมูลในนวัตกรรมใหม่เกี่ยวกับเทคนิคที่รวมพลังของแผนที่ที่มีหลายชั้นด้วยเทคโนโลยี CLIP ที่ชี้นำด้วยข้อความ ซึ่งกลับมาเป็นที่สนใจในสัปดาห์นี้จากการที่ OpenAI เปิดตัวเฟรมเวิร์ก DALL-E 2
สถาปัตยกรรมใหม่นี้ชื่อว่า Text2Live ช่วยให้ผู้ใช้สามารถสร้างการแก้ไขที่เฉพาะเจาะจงในการแก้ไขวิดีโอตามข้อความที่ป้อน:
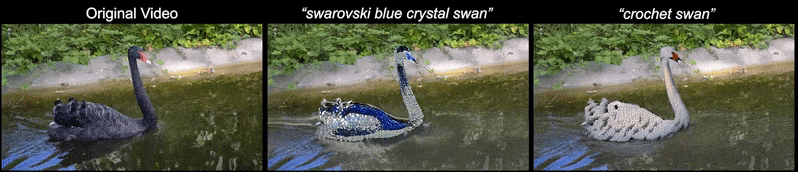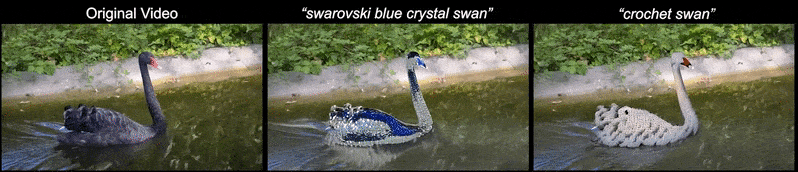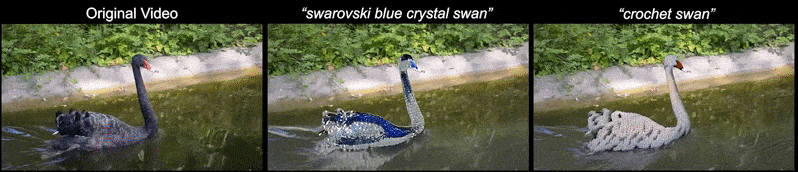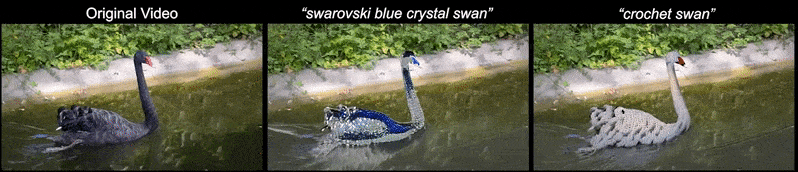
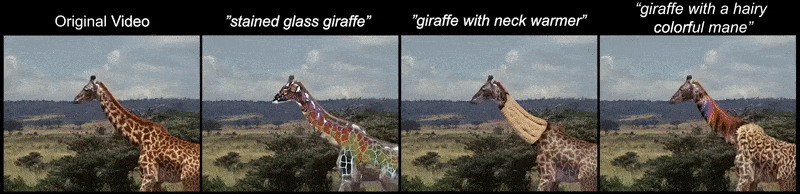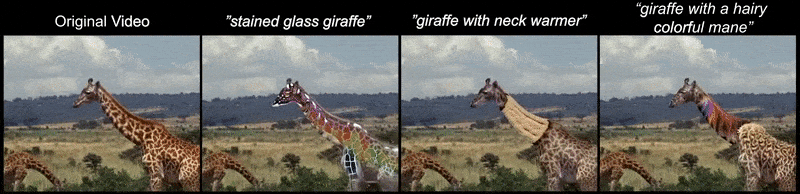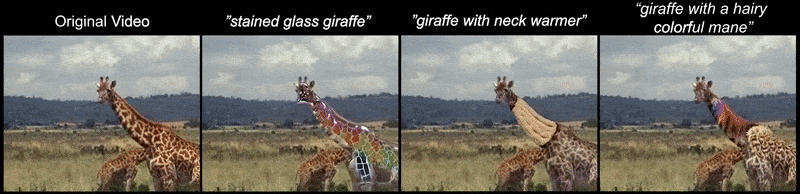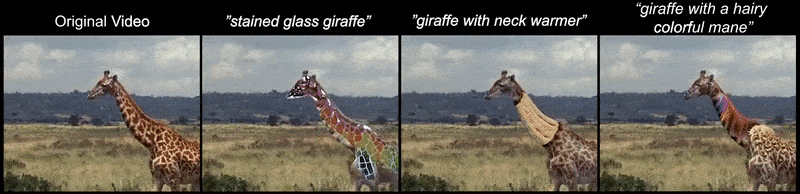
สองตัวอย่างของการแก้ไขพื้นหน้า สำหรับความละเอียดและความคมชัดที่ดีกว่า โปรดดูที่วิดีโอต้นฉบับที่ https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live มีการแก้ไขที่มีความหมายและเฉพาะเจาะจงโดยไม่ต้องใช้เครื่องสร้างที่ได้รับการฝึกฝนล่วงหน้า โดยใช้ฐานข้อมูลภายในที่เฉพาะเจาะจงสำหรับคลิปวิดีโอที่ได้รับผลกระทบ

การเปลี่ยนแปลงพื้นหลังและวัตถุภายใต้ Text2Live ที่มา: https://text2live.github.io/sm/pages/video_results_atlases.html
เทคนิคนี้ไม่ต้องการมาสก์ที่ผู้ใช้สร้างให้ เช่น การทำงานแบบ rotoscoping หรือ green-screen ทั่วไป แต่ประเมิน แผนที่ความเกี่ยวข้อง ผ่านเทคนิคการเริ่มต้นใหม่ตาม การวิจัยปี 2021 จาก School of Computer Science ที่ Tel Aviv University และ Facebook AI Research (FAIR)

แผนที่ผลลัพธ์ที่สร้างขึ้นผ่านโมเดลความสนใจทั่วไปที่ใช้ทรานส์ฟอร์เมอร์
บทความวิจัยใหม่มีชื่อว่า Text2LIVE: Text-Driven Layered Image and Video Editing ทีมงานเดิมในปี 2021 ได้ร่วมมือกับ Omer Bar-Tal จาก Weizmann และ Yoni Kasten จาก NVIDIA Research
สถาปัตยกรรม
Text2Live ประกอบด้วยเครื่องสร้างที่ได้รับการฝึกฝนจากภาพเดียวและข้อความที่ป้อน โมเดลการฝึกล่วงหน้าเชิงเปรียบต่างระหว่างภาษาและภาพ (CLIP) ซึ่งฝึกล่วงหน้าจากคู่ข้อความและภาพ 400 ล้านคู่ให้ข้อมูลที่เกี่ยวข้องซึ่งสามารถตีความการเปลี่ยนแปลงของผู้ใช้ได้

เครื่องสร้างรับภาพเข้า (เฟรม) และส่งออกชั้น RGBA ที่มีข้อมูลสีและความทึบแสง ซึ่งถูกนำมาประกอบกับภาพต้นฉบับพร้อมการเพิ่มเติม

ช่อง alpha ในชั้น RGBA ที่สร้างขึ้นให้ฟังก์ชันการประกอบภายในโดยไม่ต้องใช้กระบวนการแบบดั้งเดิมที่เกี่ยวข้องกับซอฟต์แวร์แบบพิกเซล เช่น After Effects
การฝึกด้วยภาพภายในที่เกี่ยวข้องกับวิดีโอหรือภาพเป้าหมาย ทำให้ Text2Live ไม่จำเป็นต้องแปลงย้อนกลับภาพอินพุตเข้าสู่ปริภูมิแฝงของโครงข่ายปฏิปักษ์กำเนิด (GAN) ซึ่งปัจจุบันยังห่างไกลจากความแม่นยำที่เพียงพอสำหรับงานตัดต่อวิดีโอระดับผลิตจริง หรือใช้โมเดลดิฟฟิวชันที่แม่นยำและปรับแต่งได้มากกว่า แต่ ไม่สามารถคงความตรงกับวิดีโอเป้าหมาย

การเปลี่ยนแปลงที่ต้องการตามคำสั่งจาก Text2Live
วิธีการก่อนหน้านี้ใช้ วิธีการที่ใช้การแพร่กระจาย หรือ วิธีการที่ใช้การไหลของภาพ เนื่องจากเทคนิคนี้เป็นแบบเฟรมต่อเฟรม จึงไม่สามารถสร้างการเปลี่ยนแปลงที่สอดคล้องกันในเวลาได้ แผนที่ที่มีหลายชั้นจึงให้พื้นที่เดียวในการแก้ไขที่สามารถยังคงความสอดคล้องกับการเปลี่ยนแปลงที่ได้รับการยอมรับเมื่อวิดีโอเดินหน้าต่อไป
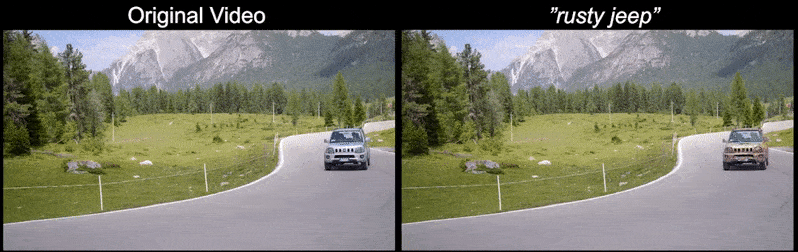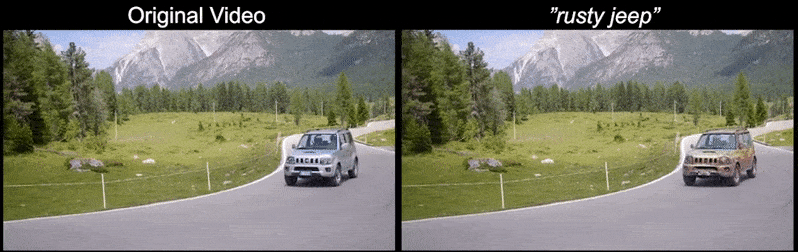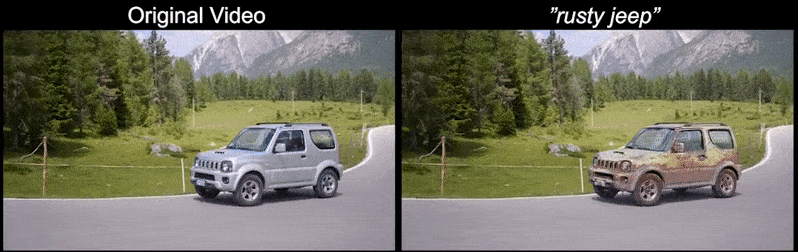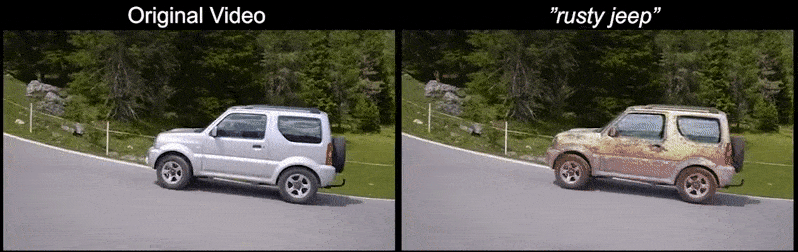
ไม่มีภาพสั่นไหวหรือภาพหลอนแบบสุ่ม: Text2Live ได้รับการตีความของคำสั่ง ‘รถจี๊ปขึ้นสนิม’ และนำไปใช้กับแผนที่ที่มีหลายชั้นของรถในคลิปวิดีโอ โดยไม่ต้องเริ่มการเปลี่ยนแปลงใหม่สำหรับเฟรมที่ตีความแต่ละเฟรม

กระบวนการเปลี่ยนแปลงที่สอดคล้องกันของรถจี๊ปให้กลายเป็นซากเก่า
Text2Live มีความใกล้เคียงกับการพัฒนาในด้านการประกอบภาพ AI มากกว่าในพื้นที่การสร้างภาพจากข้อความที่ได้รับความสนใจอย่างมากในสัปดาห์นี้ด้วยการเปิดตัว รุ่นที่สอง ของเฟรมเวิร์ก DALL-E ของ OpenAI (ซึ่งสามารถรวมภาพเป้าหมายเข้ากับกระบวนการเปลี่ยนแปลงได้ แต่ยังคงมีข้อจำกัดในการแทรกแซงโดยตรงในภาพ รวมถึง การเซ็นเซอร์ข้อมูลการฝึกอบรมและติดตั้งฟิลเตอร์ ที่ออกแบบมาเพื่อป้องกันการละเมิดโดยผู้ใช้)
Text2Live ช่วยให้ผู้ใช้สามารถดึงแผนที่และแก้ไขมันในครั้งเดียวใน สภาพแวดล้อมที่มีการควบคุมสูง เช่น Photoshop (และอาจเป็นเฟรมเวิร์กการสร้างภาพที่เป็นนามธรรม เช่น NeRF) ก่อนที่จะส่งมันกลับเข้าไปใน สภาพแวดล้อมที่มีการจัดแนวที่ถูกต้องซึ่งไม่พึ่งพาการประมาณค่า 3 มิติหรือวิธีการ CGI ที่ย้อนกลับไปใช้แนวทางเก่า
นอกจากนี้ ผู้เขียนระบุว่า Text2Live เป็นเฟรมเวิร์กแรกในกลุ่มที่เทียบเคียงกันที่สามารถทำการปิดบังและการประกอบภาพในลักษณะอัตโนมัติได้อย่างสมบูรณ์
เผยแพร่ครั้งแรกเมื่อวันที่ 7 เมษายน 2022





