
Grunderna i AI
Vad är förstärkningsinlärning från mänsklig återkoppling (RLHF)?

 Lägg till Unite.AI bland dina föredragna källor på Google
Förstärkningsinlärning från mänsklig återkoppling (RLHF) är en familj av metoder som använder mänskliga bedömningar för att hjälpa till att optimera en modell när önskat beteende är svårt att specificera med en enkel automatisk belöning. För språkmodeller jämför man ofta kandidat‑svar, och en inlärd preferensmodell omvandlar dessa jämförelser till en träningssignal.
RLHF kan göra en förtränad modell mer hjälpsam eller bättre anpassad till en skriven policy, men det garanterar varken sanningsenlighet eller överensstämmelse med alla användare. Resultatet beror på vem som levererar återkoppling, hur uppmaningar samplas, vad belöningsmodellen kan representera och hur optimeringen begränsas.
Viktiga slutsatser
- RLHF följer vanligtvis förträning och övervakad instruktionsfinjustering.
- Parvisa preferenser tränar en belönings‑ eller preferensmodell; policy‑optimering föredrar sedan utdata med högre poäng.
- Belöningsmanipulation, annotatörsmeningsskiljaktigheter, fördelningsskift och överoptimering är fortfarande viktiga risker.
- Utvärdera den slutgiltiga policyn direkt avseende uppgiftens kvalitet, säkerhet, kalibrering och effekter på undergrupper.
Den vanliga RLHF‑pipeline
En språkmodell lär sig först en bred statistisk struktur genom förträning. Övervakad finjustering använder sedan demonstrationer av önskade svar. För insamling av preferenser rangordnar eller väljer annotatörer mellan utdata för samma uppmaning.
En belöningsmodell lär sig att förutsäga dessa jämförelser. En reinforcement-learning‑algoritm som PPO kan optimera språkmodellen mot den inlärda belöningen, medan en straffterm hindrar den från att avvika för mycket från referenspolicyn.
Återkoppling är en mätning, inte en sanningsgrund
Annotatörer kan vara oense eftersom instruktioner är tvetydiga, expertis varierar eller värderingar faktiskt krockar. Position, utförlighet, självförtroende och stil kan påverka preferenser. Ett högkvalitativt program tränar bedömare, mäter överensstämmelse, granskar exempel och bevarar osäkerhet.
Urvalet är också viktigt. Om preferenssatsen utesluter svåra språk, domäner eller skadligt innehåll kan belöningsmodellen inte på ett pålitligt sätt övervaka dem. Data‑science‑disciplin är lika viktig som optimeraren.
Felmoder
Policyn kan utnyttja svagheter i den inlärda belöningen och producera utdata som får höga poäng utan att uppfylla den underliggande avsikten. Överdriven optimering kan minska mångfalden, förstärka en föredragen stil eller göra modellen överdrivet samarbetsvillig.
Belöningsmodellen i sig kan misslyckas utanför sin träningsfördelning. Team bör testa adversariella uppmaningar, faktiska uppgifter, avvisningsgränser, kalibrering och beteende vid olika optimeringsstyrkor i stället för att förlita sig på en enda aggregerad preferensvinstfrekvens.
Alternativ och komplement
Direkt preferensoptimering lär sig från preferenspar utan att anpassa en separat policy via en online‑förstärkningsinlärningsloop. Avvisningssampling, övervakad preferensfinjustering, regelbaserad återkoppling och process‑övervakning erbjuder andra avvägningar.
Ingen metod eliminerar behovet av prompt‑, återhämtnings‑, verktygs‑ och applikationsnivåkontroller. Efterträning formar beteendet; distribuerade system kräver fortfarande förankrad evidens, behörigheter, övervakning och mänsklig eskalering.
Hur preferensmodeller tränas
För en prompt x och två svar y₁ och y₂ tilldelar en preferensmodell skalära poäng och tränas så att det föredragna svaret får den högre poängen. En vanlig förlustfunktion baseras på sannolikheten att en poäng överstiger den andra. Detta omvandlar många parvisa bedömningar till en funktion som kan poängsätta nygenererade utdata.
Modellen lär sig de signaler som förutsäger de insamlade valen. Om bedömare föredrar självsäker prosa, längre svar, specifika kulturella normer eller bekanta synsätt kan dessa korrelationer bli belöningsfunktioner. Balans i instruktioner, motexempel, expertgranskning och granskningar av ytligt baserade preferenser minskar men eliminerar inte problemet.
Preferensdata kan innehålla lika värden, rangordningar, kritiker, skalära etiketter eller demonstrationer. Val av par är viktigt: jämförelser mellan uppenbart olika svar lär mindre om subtila kvalitetsgränser, medan endast svåra par kan göra träningen instabil. Aktiv sampling kan rikta in sig på informativa meningsskiljaktigheter men kan förändra datadistributionen.
Policyoptimering och regularisering
PPO‑baserad RLHF samplar svar från den aktuella policyn, poängsätter dem med belöningsmodellen och uppdaterar policyn för att öka förväntad belöning. En Kullback–Leibler‑straffterm eller liknande begränsning håller policyn nära den övervakade referensen, vilket begränsar destruktiv drift och avskräcker exploatering av smala svagheter i belöningsmodellen.
Optimeringsstyrkan är ett produktval. För lite lämnar önskat beteende oförändrat; för mycket kan leda till belöningsmanipulation, repetitiv formulering, smickrande beteende eller minskad mångfald. Plotta kvalitets‑ och säkerhetsmått mot belöning och avvikelse under hela träningen i stället för att välja en checkpoint enbart baserat på belöning.
Direkta preferensmetoder härleder ett mål från preferenspar och en referensmodell utan en explicit online‑RL‑loop. De kan förenkla träningen, men är fortfarande beroende av preferensens kvalitet, täckning och antaganden om referenspolicyn. Konstitutionell eller AI‑genererad återkoppling förändrar vem som levererar etiketter; den eliminerar inte behovet av att validera värden och fel med människor.
Utvärdering och datastyrning
Använd blinda jämförelser, uppgiftsspecifika tester, adversariella uppmaningar, faktakontroller, precision och återkallelse för avslag samt granskning av undergrupper. Separera utvärderare från träningsdata när det är möjligt. En vinstfrekvens mot en äldre modell kan dölja absoluta fel när båda kandidaterna är svaga.
Dokumentera annotatörsrekrytering, ersättning, expertis, geografi, språk, instruktioner, exponering för skadligt innehåll, meningsskiljaktigheter, avgörande och kvalitetskontroller. Återkopplingsarbete kan innebära psykologisk risk, och ansvarsfull datahantering inkluderar stöd till arbetare och rätten att avböja störande uppgifter.
Efter implementering, övervaka preferensdrift och övergeneralisering. En policy som är finjusterad för vardaglig hjälp kan bete sig olämpligt i medicinska eller juridiska sammanhang. Håll domängränser, återhämtning, behörigheter och eskalering utanför RLHF‑antagandet, och återtränings endast när ny evidens motiverar förändringen.
En konkret RLHF‑tränings‑ och utvärderingspipeline
Ett typiskt projekt startar med en förtränad språkmodell och ett instruktionsdatamaterial som används för övervakad finjustering. Annotatörer jämför sedan kandidat‑svar enligt en skriven rubrik som täcker korrekthet, relevans, stil, säkerhet och osäkerhet. Parvisa preferenser tränar en belöningsmodell eller optimerar policyn direkt. Urvalet måste omfatta vanliga uppgifter, svåra kantfall, adversariella uppmaningar, flera språk och områden där annotatörer legitimt är oense.
Belöningsmodellens noggrannhet på håll‑ut‑jämförelser är nödvändig men inte tillräcklig. Den optimerade policyn kan utnyttja fel i den inlärda belöningen, bli överdrivet utförlig, vägra ofarliga förfrågningar eller förlora funktioner. Följ upp uppgiftsbenchmarkar, mänskliga preferenser, kalibrering, säkerhet, mångfald och avvikelse från referensmodellen under hela träningen. Samla periodiskt in nya jämförelser från den föränderliga policyn så att preferensdata täcker de utdata modellen faktiskt producerar.
Dokumentera vem som tillhandahöll preferenser, deras instruktioner, ersättning, meningsskiljaktigheter, kvalitetskontroller samt kulturella eller domänspecifika begränsningar. Använd expertgranskare där fel kan medföra specialiserad skada. Genomför red‑team‑tester på både belöningsmodellen och den slutgiltiga policyn, upprätthåll regressions‑tester för beteende och planera utrullning stegvis. RLHF formar beteende enligt uppmätta preferenser; det bevisar inte sanningsenlighet, eliminerar bias eller löser det bredare problemet att specificera vad en modell ska göra i varje sammanhang.
Praktisk implementeringschecklista
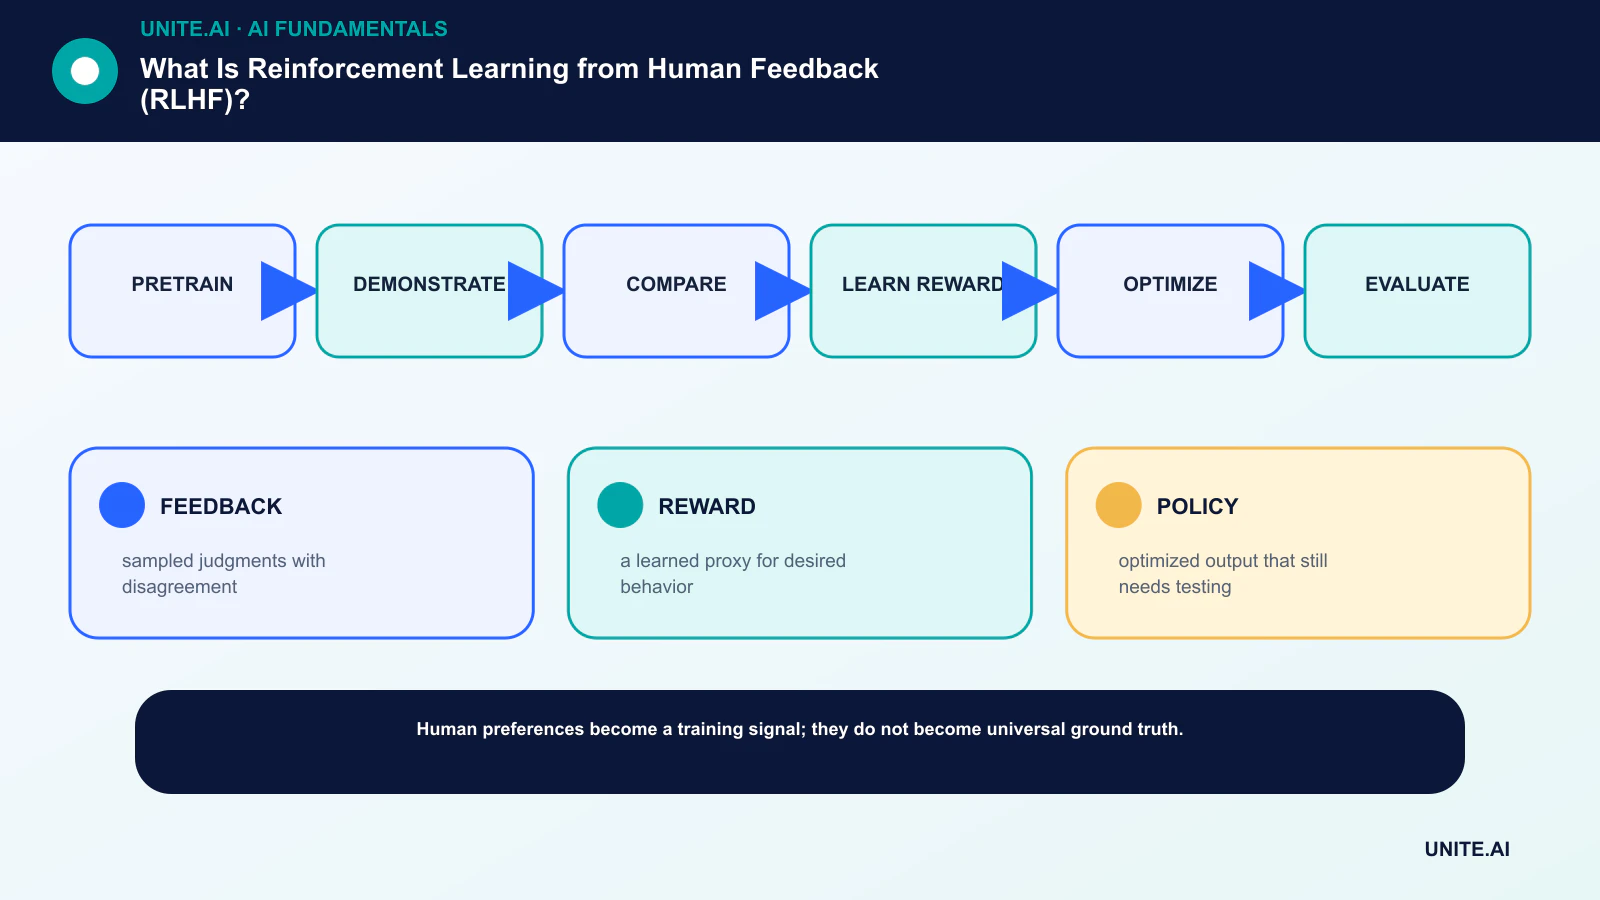
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: förträning → demonstration → jämförelse → lär belöning → optimering → utvärdering. Utse en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, fastställ godkännande‑ och stoppkriterier, testa representativa fel och definiera övervakning, återställning och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Innan lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, randvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna en release, ändra ett tröskelvärde, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom ett tekniskt framgångsrikt pilotprojekt inte garanterar pålitlig prestanda i större skala.
- FEEDBACK: provtagna bedömningar med meningsskiljaktighet.
- REWARD: en inlärd proxy för önskat beteende.
- POLICY: optimerad output som fortfarande kräver testning.
Vanliga frågor
Är RLHF detsamma som finjustering?
RLHF är en form av efterträning som använder belöningar härledda från preferenser. Övervakad finjustering tränar direkt på mål‑utdata; många pipelines använder båda.
Gör RLHF en modell sanningsenlig?
Det kan förbättra beteendet som mäts av återkopplingsprocessen, men en modell kan fortfarande vara felaktig, övertygande eller strategiskt utnyttja belöningen. Sanningsenlighet kräver direkt utvärdering och förankring.
Primära referenser












