Grunderna i AI
Vad är djup förstärkningsinlärning?

 Lägg till Unite.AI bland dina föredragna källor på Google
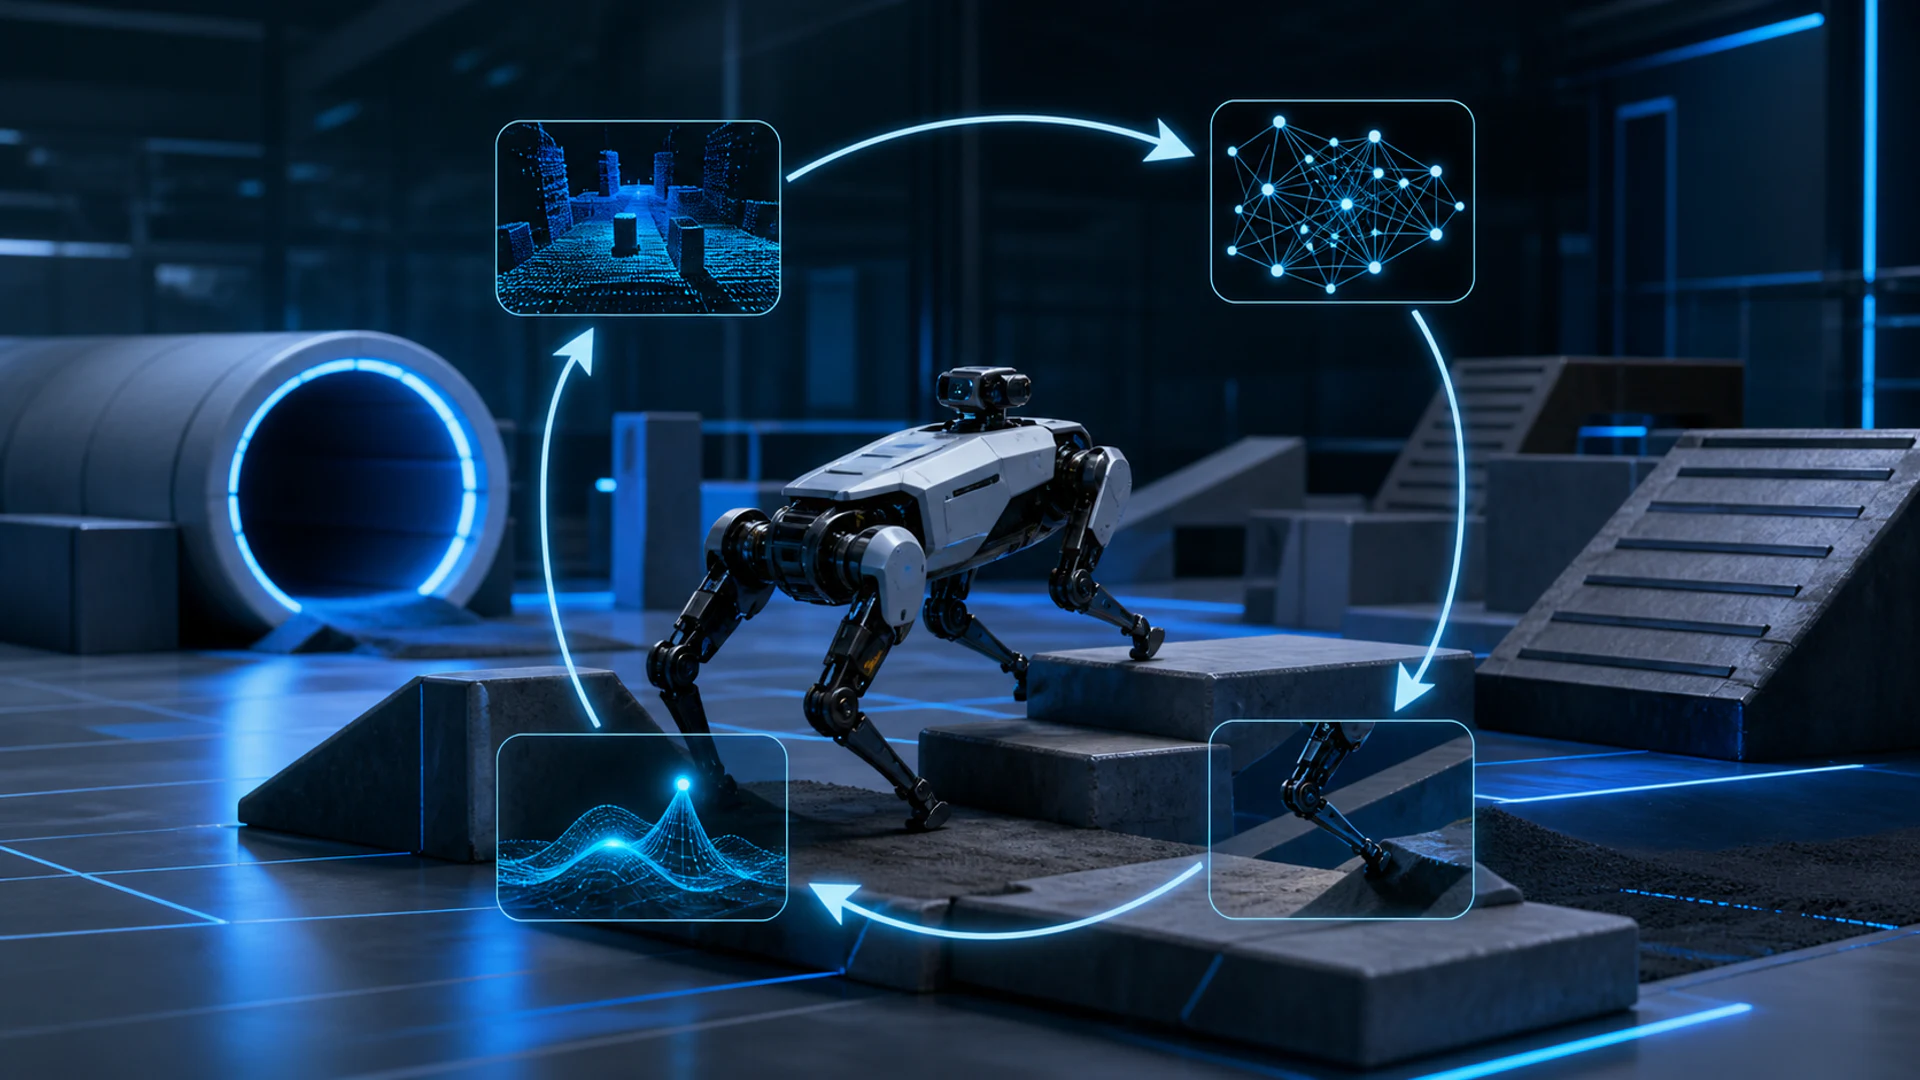
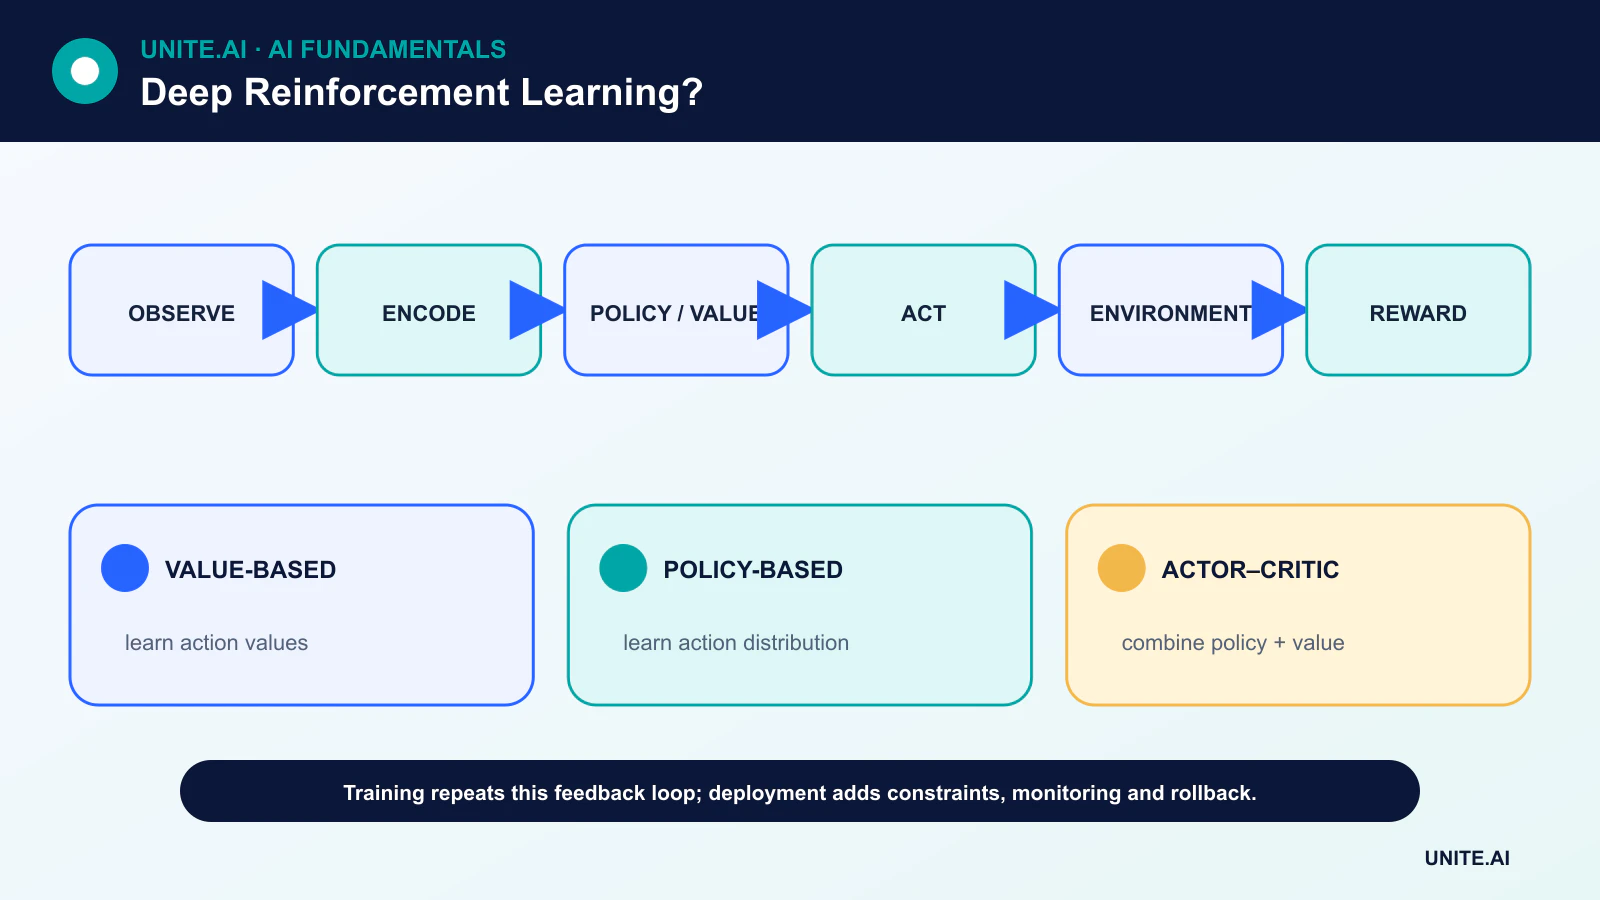
Djup förstärkningsinlärning (djup RL) kombinerar förstärkningsinlärning med djupa neurala nätverk. En agent observerar ett tillstånd, väljer en handling, får en belöning och en ny observation, och justerar sedan en policy eller värdefunktion för att förbättra framtida beslut.
Det djupa nätverket tar inte bort de svåra delarna av förstärkningsinlärning. Det ger ett flexibelt sätt att representera bilder, sensordata, stora åtgärdsutrymmen eller komplexa värdefunktioner. Utforskning, fördröjd kredit, instabil träning och säker utvärdering i verkligheten förblir centrala ingenjörsproblem.
Viktiga slutsatser
- Djup RL lär sig sekventiella beslut genom interaktion snarare än från en fast tabell med märkta exempel.
- Värdebaserade metoder uppskattar hur bra handlingar är; policymetoder lär sig handlingsfördelningen direkt; actor–critic‑metoder kombinerar båda.
- Uppspelningsbuffertar, mål‑nätverk och noggrann belöningsdesign kan förbättra träningen, men ingen garanterar pålitligt beteende.
- Ett starkt simulatörresultat är ingen garanti för robusthet, säkerhet eller lyckad överföring till den fysiska världen.
Beslutsproblemet: tillstånd, handlingar och belöningar
Många djup‑RL‑uppgifter modelleras som en Markov‑beslutsprocess. Vid tid t får agenten tillstånd eller observation st, väljer handling at, får sedan belöning rt+1 och nästa tillstånd. Målet är den förväntade diskonterade avkastningen, inte nödvändigtvis bara nästa belöning.
Diskonteringsfaktorn styr hur starkt avlägsna belöningar vägs. En belöningsfunktion definierar vad optimeringsprocessen ska eftersträva, så en ofullständig proxy kan producera beteende som tekniskt är framgångsrikt men operativt oönskat. Detta är en anledning till att belöningsdesign och testning av begränsningar förtjänar samma uppmärksamhet som modellarkitektur.
Värdebaserade, policysbaserade och actor–critic‑metoder
En värdebaserad algoritm uppskattar ett tillståndsvärde eller ett handlingsvärde. Deep Q‑networks använder ett neuralt nätverk för att approximera Q‑värden och väljer vanligtvis den handling med den högsta uppskattningen samtidigt som viss utforskning bevaras. En policy‑gradient‑algoritm optimerar istället en parametriserad policy som ger en handlingsfördelning.
Actor‑critic‑system upprätthåller både en actor som föreslår handlingar och en critic som uppskattar deras värde. Denna design stödjer kontinuerlig kontroll men introducerar interagerande källor till uppskattningsfel. Djup RL beror därför på samma grunder som djupinlärning, gradientnedstigning och bakåtspridning.
Varför uppspelningsbuffertar och mål‑nätverk hjälper
Efterföljande erfarenhetsprover är korrelerade, medan en nätverksuppdatering ändrar de mål som används i senare uppdateringar. Uppspelningsminne bryter en del av den tidsmässiga korrelationen genom att provta äldre övergångar. Ett mål‑nätverk förändras långsammare än det online‑nätverket, vilket gör bootstrappade mål mindre volatila.
Dessa mekanismer förbättrar träningsstabiliteten, men finjustering är fortfarande viktig. Inlärningshastighet, utforskningsschema, belöningsskala, sammansättning av uppspelning och nätverkskapacitet kan alla påverka resultatet. Flera slumpmässiga frön bör rapporteras eftersom en enskild körning kan vara missvisande.
Offline‑RL, modellbaserad RL och sim‑till‑verklighet
Offline‑RL lär sig från en fast loggad dataset utan att samla in nya interaktioner. Det kan vara användbart när utforskning är dyr eller osäker, men policyn måste undvika handlingar som är dåligt representerade i loggen. Modellbaserad RL lär sig eller använder en övergångsmodell för planering, vilket byter ytterligare antaganden mot proveffektivitet.
Robotik tränas ofta i simulering, randomiserar fysiska parametrar och finjusterar eller validerar sedan på hårdvara. Verklighetsgapet kan fortfarande avslöja fel i perception, timing, kontakt‑dynamik och o‑modelliserade kantfall. Ett förstärknings‑inlärningssystem bör utvärderas under störningar, fördelningsskift och explicita säkerhetsbegränsningar.
Utvärdering och distribution
Användbar utvärdering separerar tränings‑ och testmiljöer, rapporterar avkastningsfördelningar snarare än endast bästa poäng, och kontrollerar begränsningsöverträdelse, interventionsfrekvens och värsta‑fall‑beteende. För verkliga system behöver team också övervakning, återställningsprocedurer, begränsade åtgärdsutrymmen och en mänsklig överskrivning.
Djup RL är mest övertygande när beslut är sekventiella, återkoppling finns och handskrivna styrregler är otillräckliga. Det är ett dåligt val när övervakade etiketter är rikliga, en konventionell optimerare löser problemet, eller utforskning skulle utsätta människor eller tillgångar för risk.
Djup‑RL‑arkitekturer och träningssignaler
Djup förstärkningsinlärning använder neurala nätverk för att representera en värdefunktion, policy, miljömodell eller någon kombination. Ett djupt Q‑nätverk förutsäger handlingsvärden och lär sig från tids‑differensmål; uppspelningsminne minskar korrelationen mellan uppdateringar, medan ett mål‑nätverk stabiliserar det rörliga målet. Policy‑gradient‑metoder optimerar förväntad avkastning direkt, och actor‑critic‑metoder använder en inlärd critic för att minska gradientvariansen. Kontinuerliga handlingar kräver ofta deterministiska eller stokastiska actor‑critic‑varianter, medan diskreta högdimensionella handlingar kräver noggrann utforskning och utformning av utdata.
Träning är icke‑stationär eftersom policyn förändrar de data den samlar in. Uppspelningsdata blir off‑policy, bootstrappade mål beror på aktuella uppskattningar, och funktionsapproximation kan förstärka fel – kombinationen kallas ibland den dödliga triaden. Dubbel‑estimatorer minskar värdeöverskattning; fördelnings‑funktioner förbättrar kredit‑tilldelning; entropi‑bonusar uppmuntrar utforskning; klippta mål begränsar destruktiva policy‑uppdateringar. Normalisera observationer och belöningar endast med läckagesäker tillstånd, och registrera miljö, wrapper, upprepning av handling, terminering och belönings‑förbehandling eftersom varje förändrar problemet.
Utvärdering, simulatorer och distributionssäkerhet
Rapportera avkastningsfördelningar över oberoende frön och miljöinstanser, inte den bästa körningen. Utvärdera prov‑effektivitet, begränsningsöverträdelse, katastrofala resultat, känslighet för belöningsskala, och robusthet mot observationsbrus, fördröjning, aktuatörfel och förändrad dynamik. Jämför med skriptad styrning, klassisk styrning, övervakad imitation och enklare RL. Håll tillbaka miljövariationer och testa belöningsfria resultatmått, eftersom en agent kan utnyttja den programmerade belöningen samtidigt som den misslyckas med den avsedda uppgiften. Video‑ och trajektori‑inspektion avslöjar ofta beteende som döljs av den samlade avkastningen.
Simulering möjliggör utforskning men introducerar ett verklighetsgap. Randomisera relevant fysik och perception, kalibrera mot verkliga mätningar och använd konservativ överföring. Loggade data eller offline‑RL undviker online‑utforskning men kan inte på ett tillförlitligt sätt utvärdera handlingar som inte stöds av beteende‑policyn. Produktionssystem bör begränsa åtgärdssatsen, hastigheten, resurserna och driftsområdet; kräva godkännande för hög‑påverkande handlingar; och inkludera en verifierad säker kontroller eller stopp. Övervaka policy‑ingångar, handlingsfördelning, belöning, verkliga resultat och interventioner, med återställning till en testad policy‑version.
Ett konkret styrexempel
För lagerrobot‑ruttning definieras tillståndet av plats, last, batteri, närliggande trafik och uppgiftskö; handlingar av tillåtna rörelser och laddningsbeslut; och belöning av slutfört arbete, energi, trängsel och säkerhetsbegränsningar. Träna först i en kalibrerad simulator med randomiserad efterfrågan och sensorsfel, och skugga sedan verkliga beslut. Låt aldrig den inlärda policyn kringgå kollision‑undvikande. Utvärdera genomströmning tillsammans med nära missar, dödlägen, batteri‑nödsituationer och värsta‑fall‑fördröjning. Projektet lyckas endast om det lagerade systemet förbättrar driften utan att överföra oacceptabel utforskningsrisk till människor eller utrustning.
Arbetsexempel: DRL för datacenterkylning
Ett datacenter begränsar en RL‑agent till godkända kyl‑sättpunkter och tränar den i en simulator kalibrerad från historiskt väder, arbetsbelastning, temperaturer och utrustningsrespons. Belöningen inkluderar energi men hårda begränsningar skyddar separat temperatur, luftfuktighet och utrustnings‑cykling. Modell‑prediktiv styrning och befintliga regler är baslinjer. Utvärderingen spänner över årstider, sensorsbrus, aktuatörfördröjning, utrustningsförlust, ovanliga belastningar och flera frön, och rapporterar energi, överträdelser, varians och återhämtning.
Den inlärda policyn körs i skuggläge innan en begränsad zon‑prövning. En extern säkerhetskontroller klipper handlingar och operatörer kan överskrida. Handlingshastighet, tillståndstäckning, modell‑osäkerhet och faktiska anläggningsresultat övervakas; simuleringens avvikelse eller upprepade interventioner utlöser återställning. Uppdaterad utrustning eller styrlogik skapar en ny miljöversion och validering. Energibesparingar accepteras endast när tillförlitlighet, termisk marginal, underhåll och svar på fel förblir minst lika starka som baslinjen.
Implementationsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera de avsedda användarna, driftsmiljön, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionsstyrd utvärderingsuppsättning innan finjustering. Testa vanliga fall, gränsvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från ett attraktivt prototyp.
Innan lansering, tilldela ansvar för release, undantag, förändringar, återställning och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regel‑version, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter distribution snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterade återställnings‑, incident‑lärande‑, raderings‑ och bevarandeförfaranden samt en tydlig punkt där det ska inaktiveras eller ersättas.
Vanliga frågor
Är djup förstärkningsinlärning samma som djupinlärning?
Nej. Djupinlärning tillhandahåller funktionsapproximerarna; förstärkningsinlärning tillhandahåller interaktionen, belöningen och målet för sekventiella beslut.
Betyder en hög belöning att agenten lärt sig det avsedda beteendet?
Inte nödvändigtvis. Det betyder att policyn hittade ett beteende som får bra poäng under den implementerade belöningen och miljön. Oberoende säkerhets‑ och mål‑aligneringstester krävs fortfarande.
Primära referenser