
AI-modeller och plattformar
Förbättring av Green Screen Generation för Stable Diffusion

 Lägg till Unite.AI bland dina föredragna källor på Google
Trots entusiasm från samhället och investerare kring visuell generativ AI, är utdata från sådana system inte alltid redo för användning i den verkliga världen; ett exempel är att gen AI-system tenderar att producera hela bilder (eller en serie bilder, i fallet med video), snarare än enskilda, isolerade element som vanligtvis krävs för olika tillämpningar inom multimedia och för visuella effekter.
Ett enkelt exempel på detta är klipp- konst som är utformad för att “flyta” över valfri bakgrund som användaren har valt:

Den ljust gråa rutiga bakgrunden, som kanske är mest bekant för Photoshop-användare, har kommit att representera alfa-kanalen eller transparenskanalen, även i enkla konsumentartiklar som lagerbilder.
Transparens av detta slag har varit allmänt tillgänglig i över trettio år; sedan den digitala revolutionen i början av 1990-talet har användare kunnat extrahera element från video och bilder genom en alltmer sofistikerad serie verktyg och tekniker.
Till exempel var utmaningen att “släppa ut” blåskärm och grön skärm-bakgrunder i videofilm, som tidigare var ett dyrt och tidskrävande arbete med kemiska processer och optiska skrivare (samt handgjorda mattor), blev nu ett arbete som kunde utföras på några minuter med system som Adobe After Effects och Photoshop (bland många andra fria och proprietära program och system).
När ett element har isolerats, tillåter en alfa-kanal (i princip en mask som döljer allt icke-relevant innehåll) att varje element i videon kan läggas över nya bakgrunder eller komponeras med andra isolerade element.

Exempel på alfa-kanaler, med deras effekter avbildade i den nedre raden. Källa: https://helpx.adobe.com/photoshop/using/saving-selections-alpha-channel-masks.html
Släppa ut
I datorseende faller skapandet av alfa-kanaler under semantisk segmentering, med öppen källkodsprojekt som Metas Segment Anything som tillhandahåller en textpromptbar metod för att isolera/extrahera målobjekt, genom semantiskt förbättrad objekterkänning.
Segment Anything-ramverket har använts i en mängd olika visuella effekter och extraktionsarbetsflöden, såsom Alpha-CLIP-projektet.

Exempel på extraktioner med Segment Anything, i Alpha-CLIP-ramverket: Källa: https://arxiv.org/pdf/2312.03818
Det finns många alternativa semantiska segmenteringsmetoder som kan anpassas för uppgiften att tilldela alfa-kanaler.
Men semantisk segmentering bygger på träningsdata som kanske inte innehåller alla kategorier av objekt som behöver extraheras. Även om modeller som tränats på mycket stora datamängder kan möjliggöra en bredare variation av objekt som kan erkännas (i princip blir de grundläggande modeller eller världsmodeller), är de ändå begränsade av de klasser som de tränats för att känna igen mest effektivt.

Semantiska segmenteringssystem som Segment Anything kan ha svårt att identifiera vissa objekt eller delar av objekt, som visas här i utdata från tvetydiga prompter. Källa: https://maucher.pages.mi.hdm-stuttgart.de/orbook/deeplearning/SAM.html
I alla fall är semantisk segmentering lika mycket en post facto-process som en grön skärm-procedur, och måste isolera element utan fördelen av en enda swathe av bakgrunds färg som kan erkännas och tas bort.
För denna anledning har det ibland föreslagits att bilder och videor kunde genereras med grön skärm-bakgrunder som kunde tas bort på konventionellt sätt.
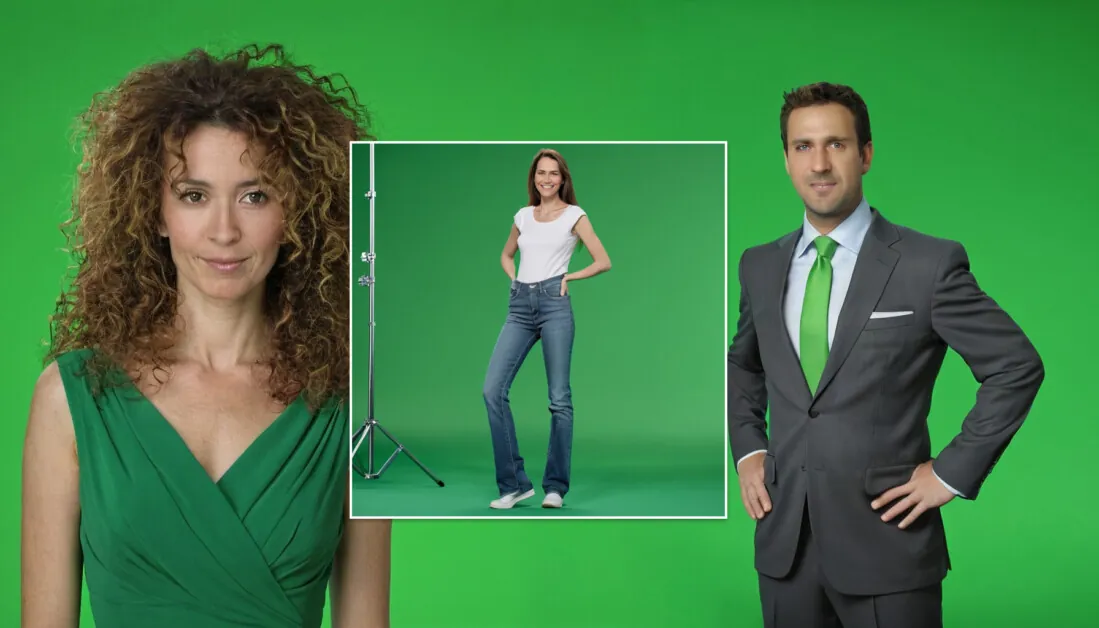
Tyvärr har populära latent diffusionsmodeller som Stable Diffusion ofta svårt att rendera en riktigt livlig grön skärm. Detta beror på att modellens träningsdata inte vanligtvis innehåller många exempel på denna ganska specialiserade scenario. Även när systemet lyckas tenderar idén om “grön” att spridas på ett oväntat sätt till förgrundsobjektet, på grund av koncept sammanflätning:

Ovan ser vi att Stable Diffusion har prioriterat autenticitet i bilden över behovet av att skapa en enda intensitet av grön, effektivt replikerande realvärldens problem som uppstår i traditionella grön skärm-scenarier. Nedan ser vi att “grön”-konceptet har förorenat förgrunds bilden. Ju mer prompten fokuserar på “grön”-konceptet, desto värre kommer detta problem att bli. Källa: https://stablediffusionweb.com/
Trots de avancerade metoderna som används, skulle både kvinnans klänning och mannens slips (i de nedre bilderna ovan) tendera att “släppa ut” tillsammans med den gröna bakgrunden – ett problem som går tillbaka till dagarna med foto kemiska processer och optiska skrivare på 1970- och 1980-talen.
Som alltid kan modellens brister övervinnas genom att kasta specifik data på problemet och ägna betydande träningsresurser. System som Stanfords 2024-erbjudande LayerDiffuse skapar en finjusterad modell som kan generera bilder med alfa-kanaler:

Stanfords LayerDiffuse-projekt tränades på en miljon lämpliga bilder som kunde ge modellen transparensförmåga. Källa: https://arxiv.org/pdf/2402.17113
Tyvärr, förutom de betydande urval- och träningsresurser som krävs för denna metod, är dataset som användes för LayerDiffuse inte offentligt tillgängligt, vilket begränsar användningen av modeller som tränats på det. Även om detta hinder inte fanns, är denna metod svår att anpassa eller utveckla för specifika användningsfall.
Lite senare 2024 samarbetade Adobe (ADBE ) Research med Stonybrook University för att producera MAGICK, en AI-extraktionsmetod tränad på anpassade diffusionsbilder.

Från 2024-papperet, ett exempel på finbearbetad alfa-kanal-extraktion i MAGICK. Källa: https://openaccess.thecvf.com/content/CVPR2024/papers/Burgert_MAGICK_A_Large-scale_Captioned_Dataset_from_Matting_Generated_Images_using_CVPR_2024_paper.pdf
150 000 extraherade, AI-genererade objekt användes för att träna MAGICK, så att systemet skulle utveckla en intuitiv förståelse för extraktion:

Exempel från MAGICK-träningsdatasetet.
Denna dataset, som källpapperet anger, var mycket svår att generera på grund av att diffusionsmetoder har svårt att skapa solida, nyckelbara färger. Därför var manuell urval av de genererade mattorna nödvändig.
Denna logistiska flaskhals leder återigen till ett system som inte kan utvecklas eller anpassas lätt, utan måste användas inom dess ursprungliga träningsområde.
TKG-DM – ‘Native’ Chroma Extraction för en Latent Diffusionsmodell
Ett nytt samarbete mellan tyska och japanska forskare har föreslagit ett alternativ till sådana tränade metoder, som kan – enligt papperet – uppnå bättre resultat än de ovan nämnda metoderna, utan behov av att träna på särskilt kuraterade dataset.

TKG-DM ändrar det slumpmässiga bruset som initierar en genererad bild så att det blir bättre kapabelt att producera en solid, nyckelbar bakgrund – i vilken färg som helst. Källa: https://arxiv.org/pdf/2411.15580
Den nya metoden närmar sig problemet på generationsnivå, genom att optimera det slumpmässiga bruset från vilket en bild genereras i en latent diffusionsmodell (LDM) som Stable Diffusion.
Tillvägagångssättet bygger på en tidigare undersökning av färgschemat i en Stable Diffusion-distribution, och kan producera bakgrunds färg av alla slag, med mindre (eller inget) sammanflätning av den nyckelbara bakgrunds färgen in i förgrunds innehåll, jämfört med andra metoder.

Initialt brus konditionerat av en kanalmedelshift som kan påverka aspekter av den avbrusningsprocessen, utan att sammanfläta färgsignalen in i förgrunds innehållet.
Papperet anger:
‘Våra omfattande experiment visar att TKG-DM förbättrar FID och mask-FID-poäng med 33,7% respektive 35,9%.
‘Således överträffar vår träningsfri modell finjusterade modeller, och erbjuder en effektiv och mångsidig lösning för olika visuella innehållsskapande uppgifter som kräver exakt förgrunds- och bakgrunds kontroll. ‘
Den nya papperet heter TKG-DM: Träningsfri Chroma Key Innehålls Generation Diffusionsmodell, och kommer från sju forskare över Hosei University i Tokyo och RPTU Kaiserslautern-Landau & DFKI GmbH, i Kaiserslautern.
Metod
Den nya tillvägagångssättet utvidgar arkitekturen för Stable Diffusion genom att konditionera det initiala gaussiska bruset genom en kanal medelshift (CMS), som producerar brusmönster som är utformade för att uppmuntra önskad bakgrunds-/förgrunds separation i den genererade bilden.

Schema för det föreslagna systemet.
CMS justerar medelvärdet för varje färgkanal samtidigt som den allmänna utvecklingen av avbrusningsprocessen upprätthålls.
Författarna förklarar:
‘För att generera förgrundsobjektet på chroma-nyckelbakgrunden, använder vi en initbrusvalstrategi som selektivt kombinerar det initiala [bruset] och initfärg[bruset] med hjälp av en 2D-gaussisk [mask].
‘Denna mask skapar en gradvis övergång genom att bevara det ursprungliga bruset i förgrundsområdet och applicera färgskiftat brus till bakgrundsområdet.’

Färgkanalen som önskas för bakgrundschromafärgen initieras med en null-textprompt, medan den faktiska förgrunds innehållet skapas semantiskt från användarens textinstruktion.
Självuppmärksamhet och korsuppmärksamhet används för att separera de två aspekterna av bilden (bakgrundschroma och förgrunds innehåll). Självuppmärksamhet hjälper till med intern konsekvens i förgrundsobjektet, medan korsuppmärksamhet upprätthåller trohet mot textprompten. Papperet påpekar att eftersom bakgrunds bilder vanligtvis är mindre detaljerade och betonade i generationer, är deras svagare inflytande relativt lätt att övervinna och ersätta med en swathe av ren färg.

En visualisering av inflytandet av självuppmärksamhet och korsuppmärksamhet i chroma-stilgenereringsprocessen.
Data och Tester
TKG-DM testades med Stable Diffusion V1.5 och Stable Diffusion SDXL. Bilder genererades i 512x512px och 1024x1024px, respectively.
Bilder skapades med hjälp av DDIM-schemat som är inbyggt i Stable Diffusion, med en vägledningsskala på 7,5, och 50 avbrusningssteg. Den målbakgrunds färgen var grön, nu den dominerande dropout-metoden.
Den nya metoden jämfördes med DeepFloyd, under de inställningar som användes för MAGICK; till den finjusterade låg-rankdiffusionsmodellen GreenBack LoRA; och även till den ovan nämnda LayerDiffuse.
För data användes 3000 bilder från MAGICK-datasetet.

Exempel från MAGICK-datasetet, från vilket 3000 bilder valdes ut för tester av det nya systemet. Källa: https://ryanndagreat.github.io/MAGICK/Explorer/magick_rgba_explorer.html
För mått användes Fréchet Inception Distance (FID) för att bedöma förgrunds kvalitet. De utvecklade också en projektspecifik mått som kallas m-FID, som använder BiRefNet-systemet för att bedöma kvaliteten på den resulterande masken.

Visuella jämförelser av BiRefNet-systemet mot tidigare metoder. Källa: https://arxiv.org/pdf/2401.03407
För att testa semantisk anpassning till indata-prompter användes CLIP-Sentence (CLIP-S) och CLIP-Image (CLIP-I)-metoderna. CLIP-S utvärderar prompttrohet, och CLIP-I den visuella likheten till grund sanning.

Första uppsättningen kvalitativa resultat för den nya metoden, denna gång för Stable Diffusion V1.5. Vänligen se käll-PDF för bättre upplösning.
Författarna hävdar att resultaten (visuellt ovan och nedan, SD1.5 och SDXL, respektive) visar att TKG-DM uppnår överlägsna resultat utan prompt-engineering eller behov av att träna eller finjustera en modell.

SDXL kvalitativa resultat. Vänligen se käll-PDF för bättre upplösning.
De observerar att med en prompt för att framkalla en grön bakgrund i de genererade resultaten, har Stable Diffusion 1.5 svårt att generera en ren bakgrund, medan SDXL (även om den presterar lite bättre) producerar ostabila ljusgröna nyanser som kan störa separationen i en chroma-process.
De noterar vidare att medan LayerDiffuse genererar väl separerade bakgrunder, förlorar den ibland detaljer, såsom exakta siffror eller bokstäver, och författarna tillskriver detta begränsningar i datasetet. De tillägger att maskgenerering ibland misslyckas, vilket leder till “oklippta” bilder.
För kvantitativa tester, även om LayerDiffuse tycks ha en fördel i SDXL för FID, betonar författarna att detta är resultatet av ett specialiserat dataset som i princip utgör en “inbakad” och icke-flexibel produkt. Som tidigare nämnts kan alla objekt eller klasser som inte täcks av detta dataset, eller som inte täcks tillräckligt, inte fungera lika bra, medan ytterligare finjustering för att anpassa sig till nya klasser presenterar användaren med en urvals- och träningsbörda.

Kvantitativa resultat för jämförelserna. LayerDiffuses tydliga fördel, enligt papperet, kommer på bekostnad av flexibilitet och bördan av dataurval och träning.
Papperet anger:
‘DeepFloyds höga FID, m-FID och CLIP-I-poäng reflekterar dess likhet med grund sanningen baserat på DeepFloyds utdata. Men denna anpassning ger det en inbyggd fördel, vilket gör det olämpligt som en rättvis benchmark för bildkvalitet. Dess lägre CLIP-S-poäng indikerar dessutom svagare textanpassning jämfört med andra modeller.
Sammanfattningsvis betonar dessa resultat vår modells förmåga att generera högkvalitativa, textanpassade förgrundsdelar utan finjustering, och erbjuder en effektiv chroma-nyckel-innehållsgenereringslösning.’
Slutligen genomförde forskarna en användarstudie för att utvärdera promptanpassning över de olika metoderna. 100 deltagare fick bedöma 30 bildpar från varje metod, med objekt extraherade med BiRefNet och manuella förbättringar över alla exempel. Författarnas träningsfria tillvägagångssätt föredrogs i denna studie.

Resultat från användarstudien.
TKG-DM är kompatibelt med det populära ControlNet-systemet för Stable Diffusion, och författarna hävdar att det producerar överlägsna resultat jämfört med ControlNets naturliga förmåga att uppnå denna typ av separation.
Slutsats
Kanske den mest anmärkningsvärda slutsatsen från detta nya papper är den omfattning i vilken latent diffusionsmodeller är sammanflätade, i kontrast till den allmänna uppfattningen att de kan lätt separera aspekter av bilder och videor när de genererar nytt innehåll.
Studien betonar ytterligare den omfattning i vilken forskar- och hobbyistgemenskapen har vänt sig till finjustering som en post facto-lösning för modellernas brister – en lösning som alltid kommer att hantera specifika klasser och typer av objekt. I ett sådant scenario kommer en finjusterad modell att antingen fungera mycket bra på en begränsad mängd klasser, eller också fungera tillräckligt bra på en mycket större mängd möjliga klasser och objekt, enligt högre mängder data i träningsuppsättningarna.
Därför är det uppfriskande att se åtminstone en lösning som inte förlitar sig på sådana mödosamma och eventuellt oärliga lösningar.
* Under inspelningen av filmen Superman från 1978, var skådespelaren Christopher Reeve tvungen att bära en turkos Superman-kostym för blåskärmsprocessbilder, för att undvika att den ikoniska blå kostymen skulle raderas. Kostymens blå färg återställdes senare via färgkorrigering.


