
Andersons vinkel
Orkestrering av ansikts syntes med semantisk segmentering

 Lägg till Unite.AI bland dina föredragna källor på Google
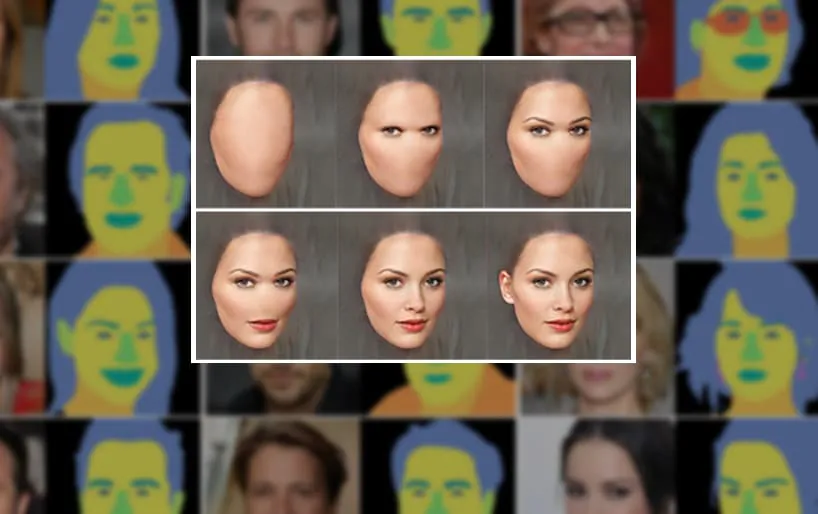
Problemet med att uppfinna mänskliga ansikten med ett Generative Adversarial Network (GAN) är att den verkliga världens data som bränsle för de falska bilderna kommer med ovälkomna och oskiljbara attribut, såsom hår på huvudet (och/eller ansiktet), bakgrunder och olika typer av ansiktsmöbler, såsom glasögon, hattar och örhängen; och att dessa perifera aspekter av personlighet ofrånkomligen blir bundna till en “sammanfogad” identitet.
Under de vanligaste GAN-arkitekturerna är dessa element inte tillgängliga i sin egen dedikerade utrymme, utan är ganska tätt associerade med ansiktet (eller runt) som de är inbäddade i.
Det är inte heller vanligtvis möjligt att diktera eller påverka utseendet på underavdelningar av ett ansikte som skapats av en GAN, såsom att smalna ögonen, förlänga näsan eller ändra hårfärg på det sätt som en polisritare kan.
Men bildsyntesforskningssektorn arbetar med det:

Ny forskning om GAN-baserad ansiktsgenerering har separerat de olika delarna av ett ansikte i distinkta områden, var och en med sin egen “generator”, som arbetar i samverkan med andra generatorer för bilden. I mittenraden ser vi den orkestrerande “funktionella kartan” som bygger upp ytterligare områden av ansiktet. Källa: https://arxiv.org/pdf/2112.02236.pdf
I en ny artikel har forskare från den amerikanska delen av den kinesiska multinationella teknologijätten ByteDance använt semantisk segmentering för att bryta ner de konstituerande delarna av ansiktet i separata sektioner, var och en tilldelad sin egen generator, så att det är möjligt att uppnå en högre grad av disentanglement. Eller, åtminstone, perceptuell disentanglement.
Artikeln heter SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing och åtföljs av en medierik projektsida med flera exempel på de olika fina transformationer som kan uppnås när ansikts- och huvudelement isoleras på detta sätt.
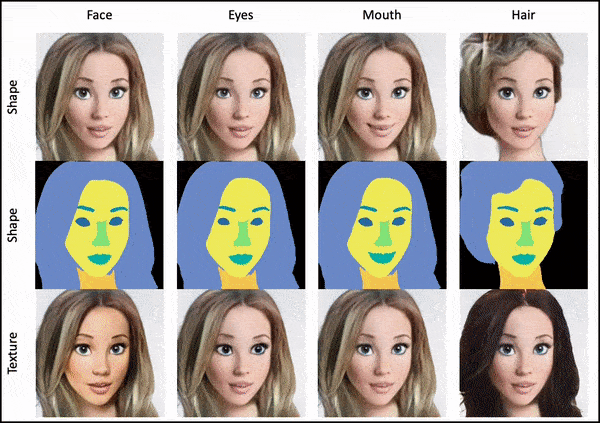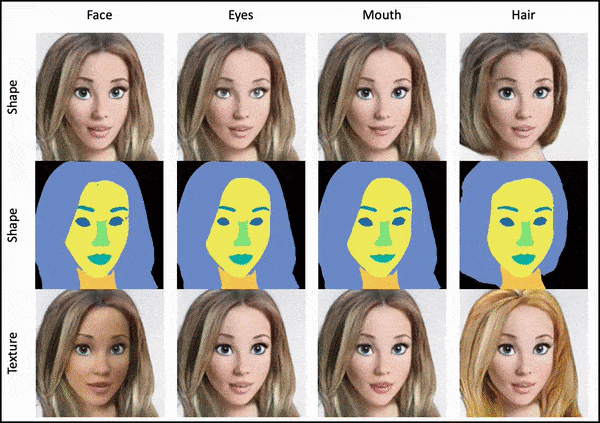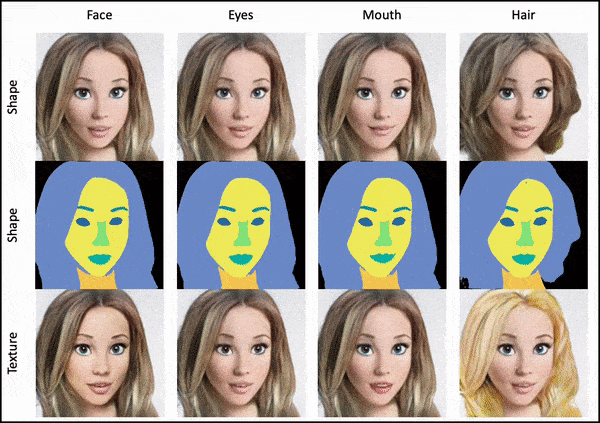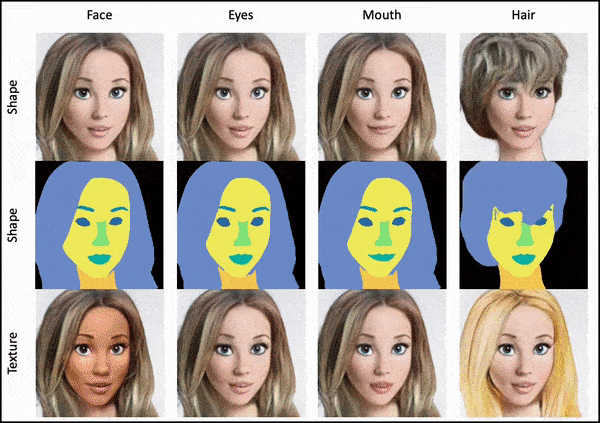
Ansiktstextur, hårstil och färg, ögonform och färg, och många andra aspekter av en gång oskiljbara GAN-genererade funktioner kan nu de facto disentanglas, även om kvaliteten på separationen och nivån på instrumenteringen sannolikt kommer att variera mellan fallen. Källa: https://semanticstylegan.github.io/
Den ostyrbara latenta rymden
En Generative Adversarial Network som tränats för att generera ansikten – såsom StyleGan2-generatoren som driver den populära webbplatsen thispersondoesnotexist.com – bildar komplexa relationer mellan “funktionerna” (inte i ansiktssansen) som den hämtar från att analysera tusentals verkliga ansikten, för att lära sig att skapa realistiska mänskliga ansikten själv.
De här hemliga processerna är “latenta koder”, kollektivt den latenta rymden. De är svåra att analysera och följaktligen svåra att instrumentalisera.
Förra veckan dök ett annat nytt bildsyntesprojekt upp som försöker “karta” denna nästan okända rymd under träningsprocessen själv, och sedan använda dessa kartor för att interaktivt navigera i den, och olika andra lösningar har föreslagits för att få djupare kontroll över GAN-syntetiserat innehåll.
Viss framgång har uppnått, med en mångfaldig utbud av GAN-arkitekturer som försöker “nå in” i den latenta rymden på något sätt och kontrollera ansiktsgenereringen från där. Sådana ansträngningar inkluderar InterFaceGAN, StyleFlow, GANSpace och StyleRig, bland andra erbjudanden i en konstant produktiv ström av nya artiklar.
Vad de alla har gemensamt är begränsade grader av disentanglement; de geniala GUI-reglagen för olika aspekter (såsom “hår” eller “uttryck”) tenderar att dra bakgrunden och/eller andra element in i transformationsprocessen, och ingen av dem (inklusive artikeln som diskuteras här) har löst problemet med temporalt neuralt hår.
Att dela och erövra den latenta rymden
I vilket fall som helst tar ByteDance-forskningen en annan approach: istället för att försöka förstå mysterierna med en enda GAN som opererar över en hel genererad ansiktsbild, formulerar SemanticStyleGAN en layoutbaserad approach, där ansikten “sätts samman” av separata generatorprocesser.
För att uppnå denna distinktion av (ansikts)funktioner använder SemanticStyleGAN Fourier-funktioner för att generera en semantisk segmenteringskarta (grovt färgade distinktioner av ansiktets topografi, visas mot den nedre högra delen av bilden nedan) för att isolera ansiktsområdena som kommer att få individuell, dedikerad uppmärksamhet.

Arkitektur för den nya ansatsen, som påtvingar ett mellanliggande lager av semantisk segmentering på ansiktet, vilket effektivt förvandlar ramverket till en orkestratör av flera generatorer för olika aspekter av en bild.
Segmenteringskartorna genereras för de falska bilderna som systematiskt presenteras för GAN:s diskriminatör för utvärdering när modellen förbättras, och till de (icke-falska) källbilder som används för träningsändamål.
I början av processen kartlägger en Multi-Layer Perceptron (MLP) initialt slumpmässigt valda latenta koder, som sedan kommer att användas för att kontrollera vikterna för de flera generatorer som kommer att ta kontroll över ett område av ansiktsbilden som ska produceras.
<p.Varje generator skapar en funktionell karta och en simulerad djupkarta från de Fourier-funktioner som matas in uppströms. Detta utdata är grunden för segmenteringsmaskerna.
Det nedströms rendernätverket är endast villkorat av de tidigare funktionella kartorna och vet nu hur man genererar en högupplöst segmenteringsmask, vilket underlättar den slutliga produktionen av bilden.
Till sist övervakar en bifurcerad diskriminatör den sammanfogade distributionen av både RGB-bilderna (som för oss är det slutliga resultatet) och segmenteringsmaskerna som har möjliggjort dem att separeras.
Med SemanticStyleGAN finns det inga ovälkomna visuella störningar när man “ställer in” ansiktsfunktioner, eftersom varje ansiktsfunktion har tränats separat inom orkestreringsramverket.
Att ersätta bakgrunder
Eftersom projektets avsikt är att få större kontroll över den genererade miljön, inkluderar renderings-/sammansättningsprocessen en bakgrundsgenerator som tränats på riktiga bilder.

En övertygande anledning till varför bakgrunderna inte dras in i ansiktsmanipulationer i SemanticStyleGAN är att de sitter på ett mer avlägset lager och är kompletta, även om de delvis döljs av de överlagrade ansiktena.
Eftersom segmenteringskartorna kommer att resultera i ansikten utan bakgrunder, tillhandahåller dessa “drop-in”-bakgrunder inte bara sammanhang, utan är också konfigurerade för att vara lämpliga, i termer av belysning, för de överlagrade ansiktena.
Tränings- och data
De “realistiska” modellerna tränades på de första 28 000 bilderna i CelebAMask-HQ, omstorleksändrade till 256×256 pixlar för att anpassa träningsutrymmet (dvs den tillgängliga VRAM, som dikterar en maximal batchstorlek per iteration).
Flera modeller tränades och olika verktyg, datamängder och arkitekturer experimenterades med under utvecklingsprocessen och olika ablations tester. Projektets största produktiva modell hade en upplösning på 512×512, tränad under 2,5 dagar på åtta NVIDIA Tesla V100 GPU:er. Efter träningsprocessen tar det 0,137 sekunder att generera en enda bild på en lobe GPU utan parallellisering.
De mer tecknade/anime-inspirerade experimenten som visas i de många videorna på projektets sida (se länk ovan) är härledda från olika populära ansiktsbaserade datamängder, inklusive Toonify, MetFaces och Bitmoji.
En tillfällig lösning?
Författarna hävdar att det inte finns någon anledning till varför SemanticStyleGAN inte skulle kunna tillämpas på andra områden, såsom landskap, bilar, kyrkor och alla andra “standard”-testområden som nya arkitekturer rutinmässigt utsätts för tidigt i sin karriär.
Men artikeln medger att när antalet klasser ökar för ett område (såsom ‘bil’, ‘‘gatuarmatur’, ‘fotgängare’, ‘byggnad’, ‘bil’ etc.), kan denna bitvis ansats bli oanvändbar på flera sätt, utan ytterligare arbete på optimering. CityScapes urbana datamängd har till exempel 30 klasser över 8 kategorier.
Det är svårt att säga om det nuvarande intresset för att erövra den latenta rymden mer direkt är lika dömt som alkemi; eller om latenta koder slutligen kommer att bli tolkningsbara och kontrollerbara – en utveckling som skulle kunna göra denna mer “externa komplexa” typ av ansats redundant.


