
Fundamentos de IA
O que é AIOps? Inteligência Artificial para Operações de TI

 Adicione Unite.AI às suas fontes preferidas no Google
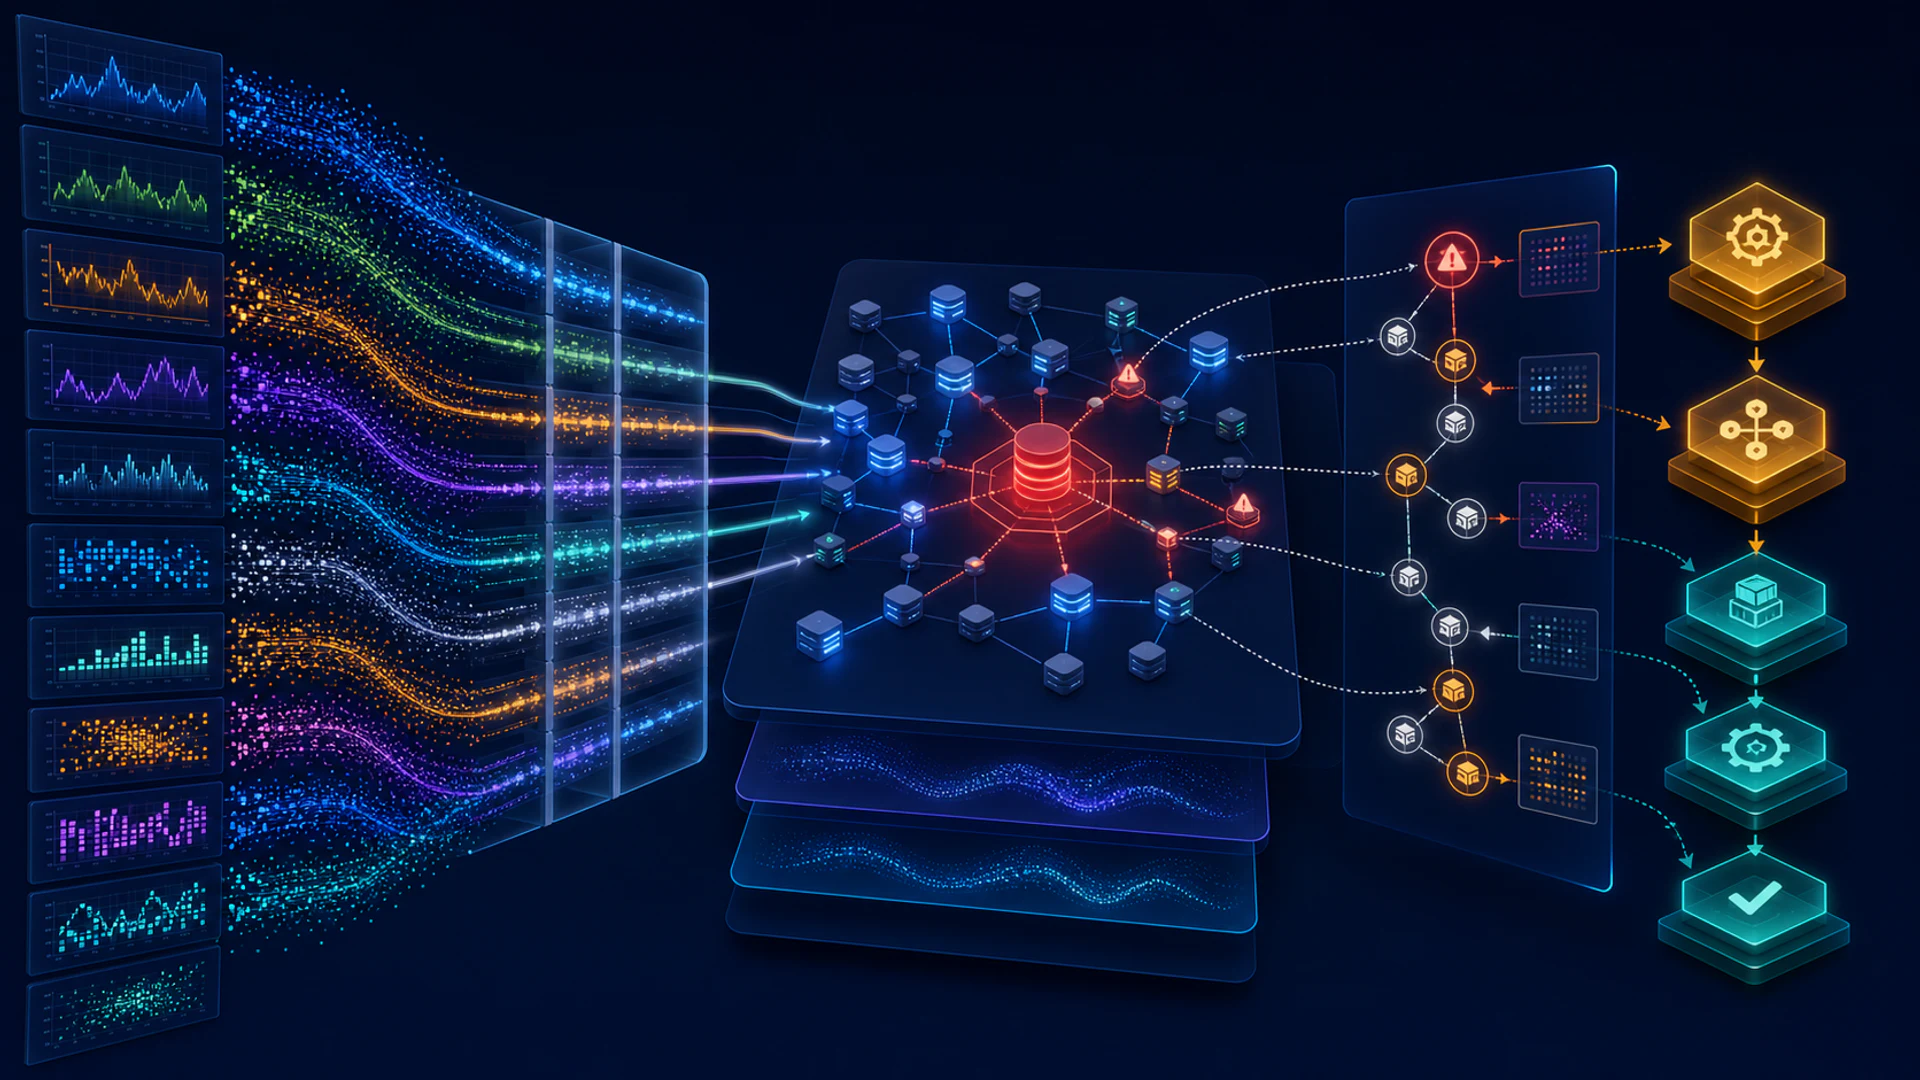
AIOps aplica aprendizado de máquina e automação aos dados de operações de TI para que as equipes possam detectar comportamentos incomuns, reduzir alertas duplicados, conectar eventos relacionados, classificar causas prováveis e recomendar ou executar ações de resposta.
AIOps não é um substituto autônomo para as operações. É uma camada dentro de um sistema ITOps, e seu valor depende da qualidade da telemetria, topologia de serviço, histórico de mudanças, feedback humano e limites seguros de automação.
Principais pontos
- Normalize eventos e adicione contexto de serviço antes de aplicar modelos sofisticados.
- A detecção de anomalias identifica desvios, não necessariamente falhas ou causas raiz.
- A correlação e a classificação de causa provável devem expor evidências e incertezas.
- A remediação automatizada requer privilégio mínimo, aprovações, canários, reversão e monitoramento de resultados.
Construir uma camada de dados operacionais
As plataformas AIOps ingerem métricas, logs, rastreamentos, alertas, tickets, topologia, implantações e mudanças de configuração. Carimbos de tempo, identificadores e propriedade de serviço precisam ser reconciliados para que o sistema possa conectar sinais que se referem ao mesmo incidente.
Contexto ausente ou inconsistente causa correlações falsas. Retenção de dados, acesso e privacidade também são importantes, pois logs podem conter credenciais ou informações pessoais. Aplique a mesma governança esperada de outros sistemas de dados de produção.
Detecção e redução de ruído
Limiares estáticos funcionam para limites conhecidos; métodos estatísticos e de aprendizado de máquina podem modelar sazonalidade ou padrões multivariados. A desduplicação agrupa notificações repetidas, enquanto a supressão remove alertas que não são acionáveis sob regras definidas.
Uma anomalia é apenas um desvio do comportamento esperado. Lançamentos planejados, campanhas de tráfego e ciclos de negócios podem ser incomuns, mas saudáveis. Avalie precisão, recall, atraso de detecção e carga de trabalho do operador em vez de celebrar o número de alertas removidos.
Correlação e causa provável
A correlação de eventos vincula sintomas através de um grafo de dependências e janela de tempo. Um modelo de causa provável pode classificar componentes ou mudanças recentes que possam explicar o incidente. Isso prioriza a investigação; não estabelece causalidade.
Mostre evidências contributivas, hipóteses alternativas e confiança. Explainable AI é especialmente importante quando um operador deve decidir se isola um serviço ou reverte uma implantação.
De recomendação à automação
Um runbook pode coletar diagnósticos, reiniciar um worker sem estado ou escalar capacidade. Copilotos podem resumir incidentes e recuperar procedimentos. Agentes podem planejar chamadas de ferramentas, mas as permissões de produção devem ser restritas e as ações devem ser validadas contra o estado atual.
Comece com recomendações somente leitura. Promova ações maduras por meio de simulação, aprovação humana, canários e reversão automática. Registre as entradas, a versão do modelo, a autorização e o resultado de cada ação.
Avaliação e feedback operacional
Reproduza incidentes históricos sem vazar seus rótulos finais nas características. Teste em novos serviços e mudanças, meça supressão falsa, tempo para detectar, tempo para mitigar, aceitação do operador e recorrência. Compare com regras existentes e linhas de base simples.
Deriva ocorre quando a arquitetura, o tráfego ou as práticas de resposta mudam. Feche o ciclo permitindo que os operadores corrijam correlações e resultados, então revise se o sistema reduz o esforço operacional sem ocultar riscos ou criar complacência na automação.
Pipeline de dados e análise do AIOps
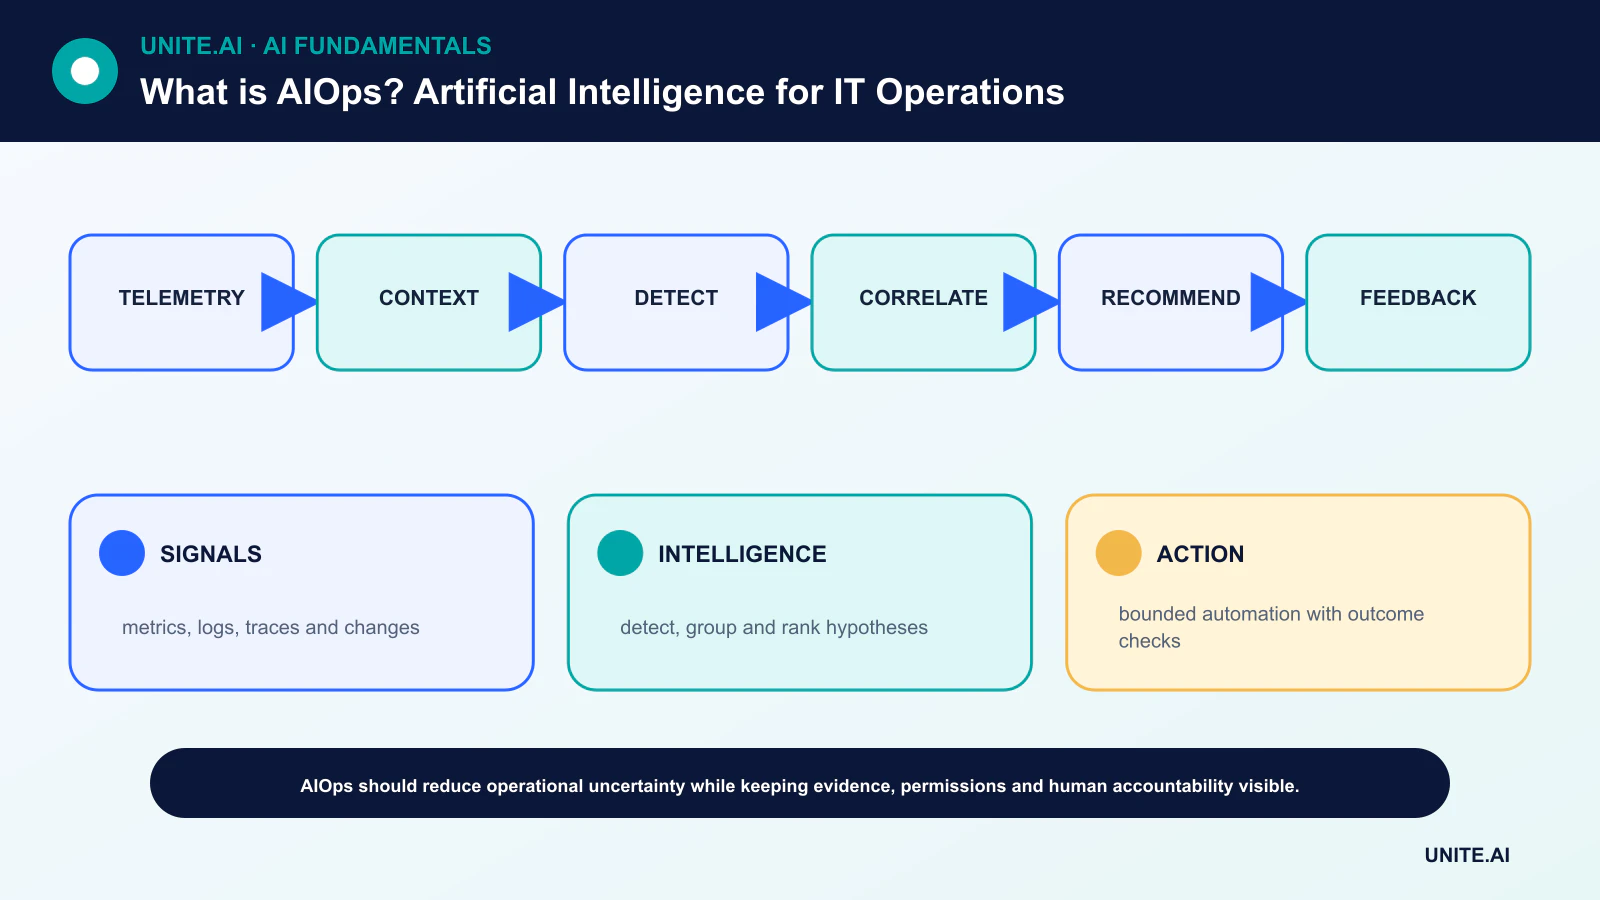
AIOps aplica métodos estatísticos e de aprendizado de máquina aos dados de operações, como métricas, logs, rastreamentos, eventos, topologia, tickets e mudanças. O pipeline coleta e normaliza sinais, enriquece‑os com contexto de serviço e propriedade, detecta anomalias, correlaciona eventos relacionados, estima causas prováveis e recomenda ou aciona ações. A qualidade depende de carimbos de tempo, identificadores, topologia e registros de mudanças. Um modelo sofisticado não pode correlacionar de forma confiável alertas que se referem ao mesmo serviço sob nomes inconsistentes.
A detecção de anomalias aprende linhas de base por serviço, estação e estado operacional; limiares estáticos podem ser melhores para limites de segurança conhecidos. A correlação de eventos agrupa sintomas em um incidente usando tempo, topologia, texto e padrões históricos. A classificação de causa raiz propõe hipóteses, mas pode confundir a primeira falha observada com a causa real ou perder uma dependência compartilhada ausente da topologia. Resumos em linguagem natural podem ajudar os respondentes, mas devem vincular‑se a evidências brutas e indicar incerteza.
Automação, avaliação e feedback
Comece com suporte à decisão e remediação reversível de baixo risco. Cada ação automatizada precisa de autorização, pré‑condições, escopo limitado, tempo limite, verificação de pós‑condição, reversão e trilha de auditoria. O modelo não deve conceder a si mesmo credenciais ou tratar texto de log como instruções confiáveis. Os respondentes humanos devem aceitar, rejeitar ou corrigir recomendações, e esses resultados devem atualizar regras ou dados de treinamento por meio de revisão, em vez de aprendizado autônomo descontrolado.
Avalie a redução de alertas sem perder incidentes, tempo de antecedência da detecção, precisão da correlação, classificação de causa raiz, sucesso da remediação, tempo de recuperação, recorrência e carga de trabalho do respondente. Use reprodução histórica e falhas injetadas, mas considere rótulos de incidentes incompletos. Meça por serviço e tipo de incidente; uma média pode ocultar falhas perigosas em sistemas críticos raros. Compare com regras determinísticas e observabilidade aprimorada antes de adicionar complexidade de IA.
Governança e modos de falha
AIOps pode amplificar lacunas de telemetria, automatizar um diagnóstico errado ou criar ações correlacionadas em toda a frota. Isole ambientes, limite a concorrência, mantenha um interruptor de emergência fora do modelo e ensaie a falha da própria plataforma AIOps. Proteja logs e tickets que contenham segredos ou dados pessoais. Monitore deriva do modelo, frescor da topologia, ações falsas e sobreposições. AIOps apoia operações confiáveis quando torna evidências e ações limitadas mais rápidas; não é um substituto autônomo para a propriedade de serviço, comando de incidentes ou julgamento de engenharia.
Exemplo prático: AIOps para um incidente de pagamento
AIOps agrupa um aumento de erros de API, saturação de banco de dados e alertas regionais em um único incidente e o enriquece com uma implantação recente, topologia e proprietário. Classifica a implantação como um provável contribuinte, mas expõe a telemetria bruta e alternativas. Uma política determinística pausa a continuação da implantação; um comandante humano de incidentes aprova a mudança de tráfego após verificar que a capacidade e a consistência dos dados estão seguras.
O sistema mede a precisão do agrupamento, o tempo de antecedência da detecção, a acurácia da classificação, a aceitação do respondente, a recuperação e a remediação falsa em reproduções históricas e dias de teste. Todas as ações automatizadas têm limites, idempotência, verificações de pós‑condição e reversão. Logs são sanitizados e texto malicioso não pode se tornar um comando. Após o incidente, a causa confirmada e os resultados das ações atualizam as regras revisadas e os dados de avaliação. A plataforma AIOps auxilia na evidência e coordenação; nunca substitui o comando de incidentes ou autorização externa.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entrada malformada ou ausente, mudança de distribuição, interrupção de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidências de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, reversão e desativação. Use uma implantação em etapas, preserve um fallback seguro e verifique o monitoramento com falhas deliberadamente injetadas. A telemetria operacional deve revelar a qualidade da entrada, o comportamento da saída, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e os resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
AIOps é o mesmo que observabilidade?
Não. Observabilidade fornece e explora sinais do sistema; AIOps usa análise e automação sobre esses sinais. Cada um pode existir sem o outro.
AIOps pode determinar a causa raiz automaticamente?
Ele pode classificar hipóteses e coletar evidências, mas afirmações causais requerem topologia, contexto de mudança e validação. Muitos incidentes têm causas interativas.
Referências principais












