
Fundamentos de IA
O que é Engenharia de Plataforma? Plataformas, Experiência do Desenvolvedor e Trilhos de Segurança

 Adicione Unite.AI às suas fontes preferidas no Google
Engenharia de plataforma é a prática de construir e operar capacidades internas compartilhadas que ajudam as equipes de software a entregar e executar aplicações por meio de fluxos de trabalho de autoatendimento suportados. A plataforma é tratada como um produto cujos usuários são desenvolvedores e outras equipes técnicas.
Uma plataforma não é automaticamente um portal, um cluster Kubernetes ou uma coleção de scripts. Ela se torna útil quando reduz a carga cognitiva e o tempo de entrega, ao mesmo tempo em que melhora a confiabilidade, a segurança, a observabilidade e a consistência organizacional.
Principais conclusões
- Comece com pesquisa de desenvolvedores e atritos recorrentes, não com um conjunto de ferramentas pré‑definido.
- Ofereça caminhos dourados opcionais e suportados, com rotas de escape claras para exceções legítimas.
- Exponha capacidades por meio de APIs, modelos, automação e documentação; um portal é apenas uma interface.
- Meça os resultados dos usuários e a adoção do produto juntamente com entrega, confiabilidade, segurança e custo.
Plataforma como um produto interno
Uma equipe de plataforma identifica usuários internos, jornadas, pontos de dor e resultados desejados. Ela mantém um roadmap, níveis de serviço, documentação, suporte e ciclos de feedback como qualquer equipe de produto. A adoção é conquistada pela utilidade, não imposta ao nomear uma equipe central.
Isso amplia a cooperação DevOps. As equipes de aplicação mantêm a propriedade de seus serviços enquanto a plataforma fornece capacidades reutilizáveis e políticas.
Capacidades, portais e caminhos dourados
As capacidades podem abranger repositórios, ambientes, CI/CD, segredos, identidade, infraestrutura, observabilidade, catálogos de serviços, custos e integração de incidentes. Um portal de desenvolvedor pode expô‑las, mas a orquestração e os serviços operacionais tornam a plataforma real.
Um caminho dourado é uma forma bem‑suportada de realizar uma tarefa comum. Deve codificar padrões seguros e permanecer transparente. As equipes precisam de um caminho de exceção governado quando os requisitos diferem.
Arquitetura e trilhos de segurança
Use interfaces estáveis e APIs declarativas para que a plataforma possa evoluir por trás delas. Separe o plano de controle das cargas de trabalho, delimite credenciais, preserve metadados de propriedade e torne as alterações geradas revisáveis e reversíveis.
Integre verificações, políticas e proveniência de artefatos do DevSecOps nos fluxos de trabalho. Os trilhos de segurança devem fornecer feedback rápido e remediação acionável, em vez de negativas inexplicáveis.
Medir e evoluir
Meça o tempo até a primeira implantação, o lead time, a recuperação de mudanças com falha, a disponibilidade da plataforma, a carga de suporte, a adoção, a satisfação, a postura de segurança e o custo. Evite contar logins no portal como um proxy de entrega aprimorada.
Instrumente a plataforma por meio de práticas de IT operations e entreviste usuários regularmente. Retire caminhos não usados, padronize onde a repetição é custosa e permita diversidade onde ela cria valor de produto.
Plataformas internas de desenvolvedor e caminhos dourados
Uma plataforma interna de desenvolvedor é um produto que expõe infraestrutura e capacidades operacionais aprovadas por meio de interfaces de autoatendimento. Pode combinar um portal, catálogo de serviços, modelos, APIs, ferramentas de linha de comando, fluxos de implantação, segredos, ambientes e observabilidade. A plataforma não substitui a nuvem ou o Kubernetes; ela os organiza em capacidades utilizáveis.
Um caminho dourado é uma forma opinativa e suportada de concluir uma tarefa comum, como criar um serviço com um repositório, pipeline CI, runtime, painéis, alertas e metadados de propriedade. Deve ser a opção mais fácil e segura, permitindo exceções justificadas. Um caminho obrigatório que não consegue suportar cargas de trabalho reais torna‑se um gargalo ou é contornado.
As equipes de plataforma devem tratar os desenvolvedores como clientes e as capacidades como produtos. Entrevistas de descoberta, análises de uso, dados de suporte, roadmaps, documentação e objetivos de nível de serviço são tão importantes quanto a automação. A adoção é evidência de utilidade, mas a adoção por si só não comprova que a entrega, a confiabilidade, a segurança ou a experiência do desenvolvedor melhoraram.
Planos de controle, interfaces e modelo operacional
O plano de controle da plataforma reconcilia a intenção declarada de um desenvolvedor com os recursos subjacentes. Uma definição de serviço pode solicitar um runtime, banco de dados, região e nível de confiabilidade; os controladores traduzem isso em configuração de nuvem, rede, políticas e observabilidade. Abstrações estáveis devem ocultar a complexidade incidental sem esconder o estado operacional necessário para depuração.
As interfaces podem incluir portais web, APIs, configuração baseada em Git, CLIs e componentes reutilizáveis de pipeline. A melhor interface depende da frequência das tarefas e do fluxo de trabalho do usuário. Cada interface precisa de autenticação, autorização, validação, histórico de auditoria, explicações de erros e versionamento. O autoatendimento sem gerenciamento de ciclo de vida gera recursos abandonados e proliferação de configurações.
Uma equipe de plataforma possui capacidades compartilhadas e caminhos pavimentados, enquanto as equipes de aplicação mantêm a responsabilidade pelo comportamento do software e pelos resultados de negócio. As equipes de segurança, confiabilidade, finanças e infraestrutura contribuem com políticas e serviços. Limites de responsabilidade explícitos evitam que a plataforma se torne uma fila de tickets sem responsabilidade ou uma tentativa de centralizar todas as decisões de engenharia.
Medindo valor e evitando falhas na plataforma
Meça o lead time até a primeira implantação em produção, o tempo de provisionamento de ambientes, a frequência de implantações, a taxa de falha de mudanças, o tempo de recuperação, a carga cognitiva, o volume de suporte, a confiabilidade e a adoção de controles de segurança. Segmente os resultados por equipe e carga de trabalho. Um lançamento de modelo mais rápido tem valor limitado se as mudanças de segundo dia permanecerem lentas ou os incidentes se tornarem mais difíceis de diagnosticar.
Falhas comuns incluem construir antes de entender os usuários, copiar a pilha de uma grande empresa, expor infraestrutura bruta por trás de um portal, forçar padronização prematura e otimizar para a produção da equipe de plataforma. Comece com uma jornada recorrente dolorosa, mapeie suas etapas e esperas, entregue um caminho fino de ponta a ponta e itere usando os resultados observados.
As plataformas devem evoluir sem desestabilizar todos os serviços. Use contratos versionados, janelas de descontinuação, migrações automatizadas, testes de compatibilidade e propriedade clara. Monitore as dependências da plataforma para que uma interrupção do plano de controle não bloqueie todas as implantações ou danifique cargas de trabalho em execução. Documente procedimentos de quebra‑de‑vidro e teste regularmente a recuperação de falhas da plataforma.
Exemplo prático: um caminho de autoatendimento para uma nova API
Um desenvolvedor seleciona um modelo de API aprovado e fornece o nome do serviço, proprietário, classificação de dados, linguagem e nível de confiabilidade. A plataforma cria um repositório, política de dependência, pipeline CI, ambiente de teste, configuração de implantação, entrada no catálogo de serviços, painéis, alertas e um runbook inicial. A política valida nomes, regiões, permissões e exposição de rede antes do provisionamento, enquanto os artefatos gerados permanecem inspecionáveis e de propriedade da equipe.
A plataforma expõe operações de ciclo de vida — criar ambiente, implantar, escalar, rotacionar um segredo, visualizar logs, reverter e descontinuar — por meio de APIs estáveis e de um portal. As cargas de trabalho em execução continuam se o portal estiver indisponível. Exceções utilizam um ponto de extensão documentado e prazo de validade em vez de uma alteração manual não rastreada. Modelos versionados e migrações automatizadas evitam que melhorias na plataforma quebrem silenciosamente serviços existentes.
Meça o tempo desde a criação do repositório até uma implantação saudável em produção, o esforço do desenvolvedor, a demanda de suporte, a falha de mudanças, a recuperação, a conformidade de políticas e a adoção por tipo de carga de trabalho. Entreviste usuários que abandonam o caminho e inspecione onde eles esperam ou escapam da abstração. A equipe de plataforma deve priorizar o maior atrito recorrente, publicar confiabilidade e roadmap, e retirar capacidades não utilizadas. Um catálogo refinado não é uma plataforma se as equipes ainda precisarem de tickets para cada operação significativa.
A adoção deve ser faseada. Comece com equipes voluntárias e uma classe de carga de trabalho, comprove as operações de segundo dia e, em seguida, migre com ferramentas e suporte. Publique os objetivos de serviço da plataforma e o status de dependências, e projete uma rota de quebra‑de‑vidro que seja controlada, mas utilizável durante interrupções. Cobrança ou demonstração de custos pode expor o custo dos recursos, mas as equipes de produto também precisam de padrões sensatos para que a governança financeira não se torne outra fila de aprovações manuais.
Checklist de implementação prática
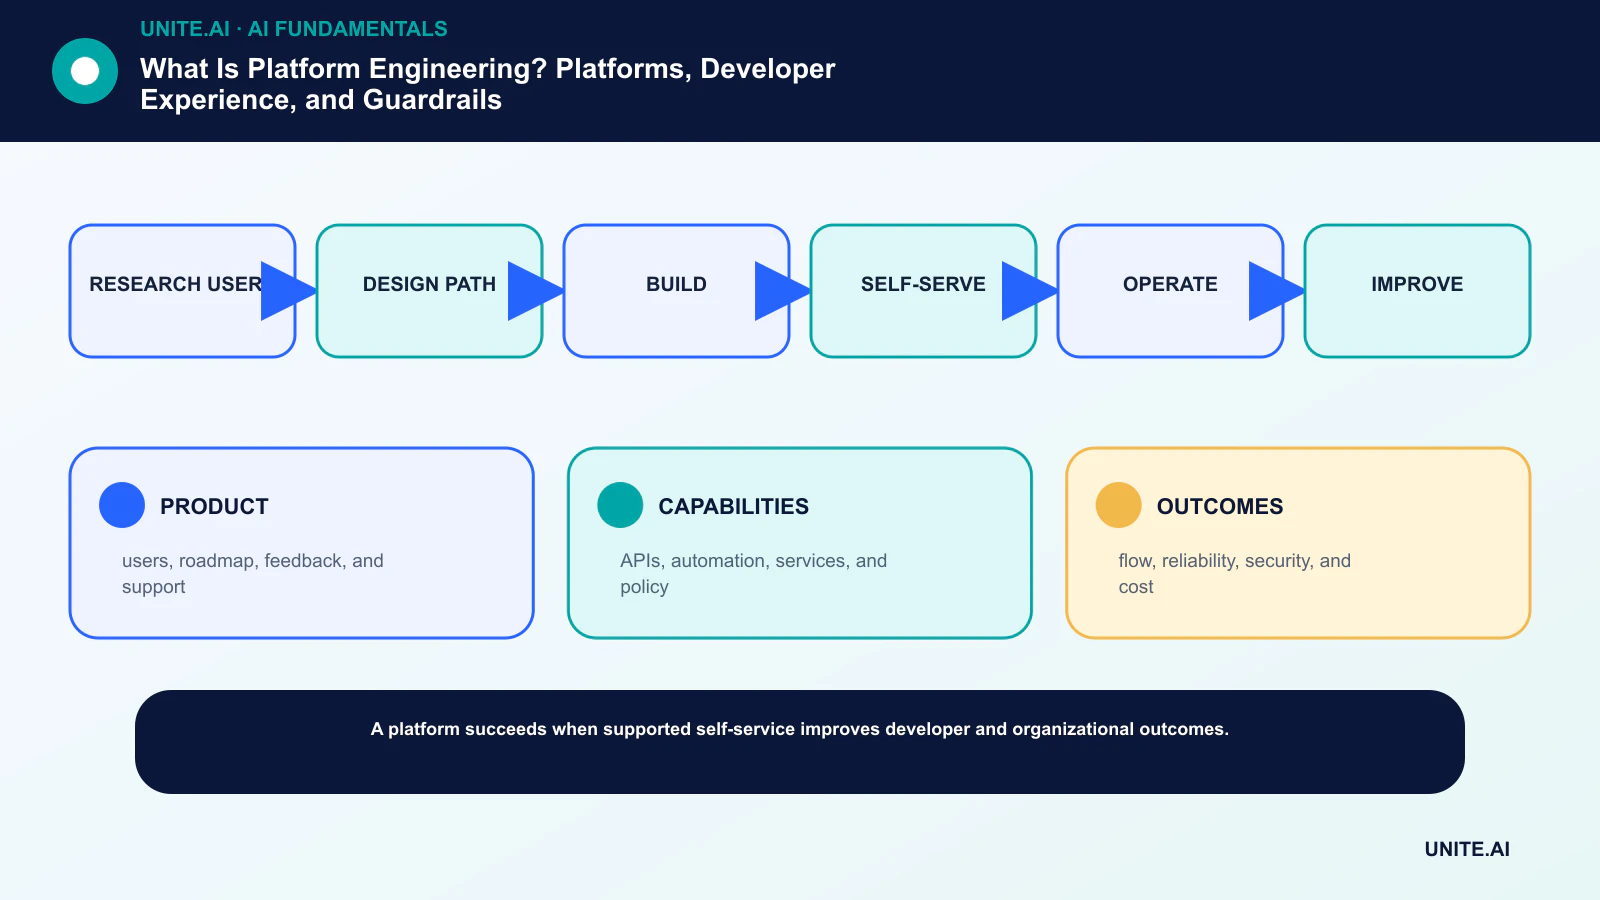
Transforme o conceito em um fluxo de trabalho delimitado e testável: pesquisar usuários → projetar caminho → construir → autoatender → operar → melhorar. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e de parada, teste falhas representativas e defina monitoramento, reversão e revisão antes de expandir o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, realize uma revisão de prontidão documentada com as pessoas que constroem, operam, garantem a segurança e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limite, sobrescrever uma saída ou interromper a operação. Reavalie a decisão após a chegada de dados reais, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- PRODUTO: usuários, roadmap, feedback e suporte.
- CAPACIDADES: APIs, automação, serviços e políticas.
- RESULTADOS: fluxo, confiabilidade, segurança e custo.
Perguntas frequentes
A engenharia de plataforma está substituindo o DevOps?
Não. Engenharia de plataforma é uma forma de escalar os princípios do DevOps ao fornecer produtos compartilhados e capacidades de autoatendimento. A colaboração e a propriedade de serviços continuam essenciais.
Um portal interno de desenvolvedor é a plataforma?
Normalmente não. Um portal é uma interface. A plataforma também inclui APIs, automação, infraestrutura, políticas, serviços, documentação, suporte e propriedade operacional.
Referências principais











