
Fundamentos de IA
O que é Automação de Incidentes? Fluxos de Trabalho, Diretrizes de Segurança e Casos de Uso

 Adicione Unite.AI às suas fontes preferidas no Google
A automação de incidentes usa software para detectar, enriquecer, encaminhar, coordenar e, às vezes, remediar incidentes operacionais ou de segurança. Ela conecta sinais de monitoramento com runbooks, tickets, comunicação, controles de acesso e ações de recuperação, de modo que os respondedores gastem menos tempo copiando dados e mais tempo tomando decisões.
Automação não significa a remoção da responsabilidade humana. Um programa seguro distingue etapas determinísticas de baixo risco de ações que podem afetar clientes ou a produção, aplicando aprovações, credenciais limitadas, trilhas de auditoria, limites de tempo e reversões conforme o impacto.
Principais conclusões
- Automatize a coleta repetível de evidências antes de tentar a remediação autônoma.
- Use gravidade, confiança, raio de explosão e reversibilidade para selecionar um nível de aprovação.
- Trate cada runbook como código de produção versionado, com testes e um responsável.
- Meça detecção, reconhecimento, recuperação, recorrência e impacto ao usuário — não apenas o volume de alertas.
Do sinal à resposta coordenada
Um fluxo de trabalho pode desduplicar alertas, anexar implantações e logs recentes, identificar o proprietário do serviço, abrir um registro de incidente, acionar a equipe de plantão, criar um canal de comunicação e iniciar uma linha do tempo. Essas etapas reduzem a carga cognitiva sem fazer um diagnóstico arriscado de forma automática.
A correlação deve preservar evidências. Se uma plataforma agrupar sintomas de forma muito agressiva, pode ocultar incidentes simultâneos. Vincule a automação à propriedade de operações de TI e mantenha os sinais brutos que os respondedores possam precisar.
Escolha ações com base no risco
Consultas somente leitura, snapshots e mudanças de tráfego reversíveis são geralmente mais fáceis de automatizar do que excluir dados, rotacionar credenciais amplas ou alterar um esquema de produção. Defina pré‑condições, um tempo limite de execução, pós‑condições e uma reversão para cada ação.
Use identidades de serviço com privilégio mínimo e separe a autorização do mecanismo de fluxo de trabalho. Etapas de alto impacto devem exigir um aprovador identificado. Se o AIOps propõe uma causa ou correção, os respondedores ainda precisam de evidências de apoio e de uma forma segura de rejeitá‑la.
Construa runbooks confiáveis
Um runbook deve declarar entradas, dependências, proprietário, escopo, comportamento em falha e evidências produzidas. Teste‑o em ambiente de pré‑produção e em dias de simulação. Etapas idempotentes são valiosas porque sua repetição não gera danos adicionais.
Versione e revise a automação como qualquer outro software. Monitore a expiração de credenciais, alterações de API, limites de taxa, execuções parciais e acoplamentos ocultos entre serviços. Procedimentos manuais continuam necessários quando a própria plataforma de automação está indisponível.
Aprenda após a recuperação
A automação deve preservar um registro com marca temporal de sinais, decisões, ações, aprovações e resultados. Uma revisão sem culpabilização pode então separar as condições sistêmicas contribuintes do gatilho final e transformar lições em melhorias testadas.
Medições úteis incluem tempo médio para reconhecer e restaurar, porcentagem de etapas seguras automatizadas, taxa de ações falhas, incidentes recorrentes e impacto ao cliente. Conecte as descobertas ao planejamento de DevOps em vez de otimizar apenas pelo número de tickets fechados.
Tipos de automação de incidentes
A automação de eventos normaliza e enriquece os sinais recebidos. A automação de coordenação cria um registro de incidente, aciona os proprietários, abre canais de comunicação e publica atualizações de status. A automação diagnóstica executa consultas somente leitura ou captura snapshots. A automação de remediação altera o estado do sistema, enquanto a automação de recuperação verifica a saúde do serviço e encerra mitigações temporárias.
Essas categorias não devem compartilhar um nível de confiança padrão. O enriquecimento pode frequentemente ser executado automaticamente; um failover de produção pode exigir verificações de confiança e um aprovador; a restauração de dados geralmente necessita de um comandante de incidente e do proprietário da aplicação. O controle deve seguir o impacto potencial, não se a etapa é implementada por uma regra ou por um modelo de aprendizado de máquina.
Incidentes de segurança acrescentam requisitos de preservação de evidências. A automação deve evitar modificar um host comprometido antes que os dados voláteis sejam capturados, expor indicadores sensíveis em canais públicos ou colocar em quarentena infraestrutura compartilhada sem compreender o raio de impacto. Runbooks operacionais e forenses podem se sobrepor, mas sua ordem pode ser diferente.
Design de fluxo de trabalho e plano de controle
Modele o runbook como estados explícitos com pré‑condições e resultados finais. Cada ação deve relatar iniciada, bem‑sucedida, falha, expirou ou foi pulada, juntamente com um identificador de execução imutável. Um orquestrador central pode coordenar as etapas, mas os serviços downstream devem impor sua própria autorização e validar as entradas de forma independente.
Utilize credenciais limitadas e de curta duração e restrinja os caminhos de rede a partir do motor de automação. Separe runners de desenvolvimento, teste e produção. Segredos não devem aparecer em transcrições de chat ou logs. Para ações de alto impacto, exija aprovação de duas pessoas ou um papel de emergência cuja utilização crie um registro de revisão imediato.
Projete para falhas parciais. Um ticket pode ser criado enquanto a chamada de alerta falha; uma mudança de tráfego pode ter sucesso em uma região e expirar em outra. Ações compensatórias, trabalhos de reconciliação e propriedade clara evitam que o fluxo de trabalho reporte sucesso apenas porque o processo de orquestração terminou.
Exemplos, testes e maturidade
Um caso de uso maduro inicial é o esgotamento de conexões de banco de dados: coletar métricas de pool, implantações recentes, consultas lentas e informações do proprietário; abrir um incidente; propor uma ação de escalonamento ou tráfego reversível; exigir aprovação; e então verificar a taxa de erro e latência. O mesmo padrão pode servir para expiração de certificados, pressão de disco, jobs falhos ou atividade suspeita de conta.
Teste runbooks por meio de testes unitários, APIs simuladas, incidentes em pré‑produção, dias de simulação e exercícios controlados em produção. Injete dados obsoletos, negação de permissão, dependências lentas, eventos duplicados e incidentes conflitantes. Confirme que as tentativas de nova execução são seguras e que os respondedores podem assumir o controle manual sem lutar contra a automação.
A maturidade avança da notificação, ao enriquecimento, às ações guiadas, até a auto‑remediação limitada. O avanço deve depender de evidências: diagnóstico estável, baixa taxa de ações falhas, reversão verificada e benefício claro ao usuário. O fechamento autônomo deve ser raro até que o sistema possa comprovar a recuperação e preservar evidências suficientes para aprendizado futuro.
Exemplo prático: automatizando um incidente em serviço de produção
Considere uma API de pagamento cujo índice de erro aumenta após uma implantação. O monitoramento emite um alerta estruturado contendo serviço, ambiente, região, versão, orçamento de erro e link do runbook. A automação o enriquece com o registro de mudança, saúde das dependências, logs recentes e propriedade, e então agrupa alertas duplicados em um único incidente. Uma política determinística pode pausar a implantação adicional imediatamente; um rollback deve exigir evidências de que a nova versão é causal e que o rollback é seguro.
O fluxo de trabalho designa um comandante de incidente, abre canais de comunicação, registra uma linha do tempo e sugere etapas diagnósticas. A remediação automatizada começa com ações reversíveis de baixo risco, como redirecionar tráfego para uma instância saudável. Cada ação requer autorização, limites de simultaneidade, tempo limite, pós‑condições verificadas e reversão. Resumos gerados podem auxiliar os respondedores, mas a telemetria e os comandos de origem permanecem visíveis para que a equipe possa contestar uma narrativa incorreta.
Meça o tempo para detectar, reconhecer, mitigar e recuperar; volume de alertas; supressão de duplicados; sucesso da remediação; recorrência; e danos causados pela automação. Realize dias de simulação para credenciais expiradas, regiões parciais, alertas enganosos e rollbacks falhos. Após a recuperação, preserve a linha do tempo factual, identifique as condições técnicas e organizacionais que contribuíram, atualize runbooks e testes e acompanhe o trabalho corretivo até a conclusão, em vez de tratar uma mitigação rápida como o fim do trabalho de confiabilidade.
Lista de verificação para implementação prática
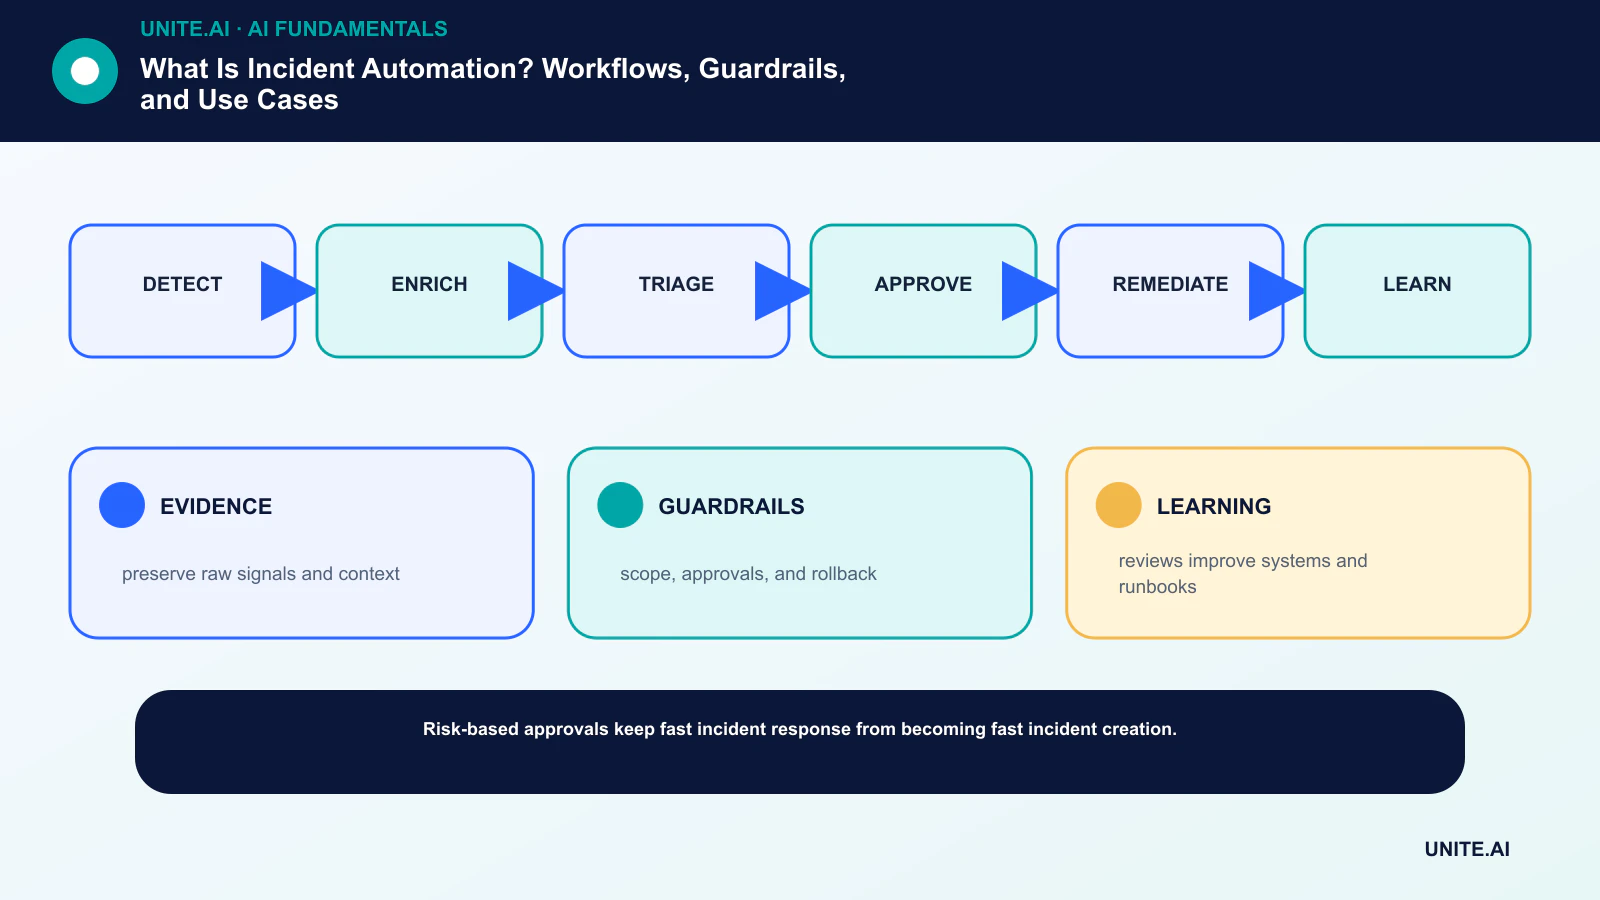
Transforme o conceito em um fluxo de trabalho delimitado e testável: detectar → enriquecer → triage → aprovar → remediar → aprender. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e interrupção, teste falhas representativas e defina monitoramento, rollback e revisão antes de ampliar o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, realize uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limiar, sobrescrever um resultado ou interromper a operação. Reavalie a decisão após a chegada de dados reais, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- EVIDÊNCIA: preserve sinais brutos e o contexto.
- GUARDRAILS: escopo, aprovações e reversão.
- APRENDIZADO: as revisões melhoram sistemas e runbooks.
Perguntas frequentes
A automação de incidentes é a mesma coisa que AIOps?
Não. AIOps aplica análises ou aprendizado de máquina aos dados operacionais. A automação de incidentes é a camada mais ampla de execução e coordenação; pode usar regras simples, resultados de AIOps ou ambos.
O que deve ser automatizado primeiro?
Comece com etapas de alta frequência, baixo risco e bem compreendidas, como enriquecimento, busca de propriedade, captura de evidências, atualizações de status e diagnósticos reversíveis.
Referências principais











