
Fundamentos de IA
O que é Operações de TI (ITOps)?

 Adicione Unite.AI às suas fontes preferidas no Google
Operações de TI (ITOps) é o trabalho de manter os serviços de tecnologia dos quais uma organização depende. Abrange computação, redes, identidade, endpoints, plataformas de nuvem, bancos de dados, armazenamento, backups e os processos operacionais que mantêm esses componentes disponíveis, seguros e suportáveis.
O ITOps moderno não se limita a um centro de operações de rede observando painéis. As equipes gerenciam cada vez mais infraestrutura definida por software, serviços de plataforma, automação e propriedade distribuída, ao mesmo tempo que mantêm a responsabilidade por incidentes, capacidade, continuidade e níveis de serviço.
Principais conclusões
- ITOps gerencia serviços e suas dependências em ambientes on‑premises, nuvem e edge.
- Observabilidade, configuração e inventário fornecem o contexto necessário para interpretar falhas.
- Gerenciamento de incidentes restaura o serviço; gerenciamento de problemas trata causas recorrentes ou sistêmicas.
- ITOps se sobrepõe a ITSM, SRE, DevOps, SecOps e AIOps, mas não é idêntico a nenhum deles.
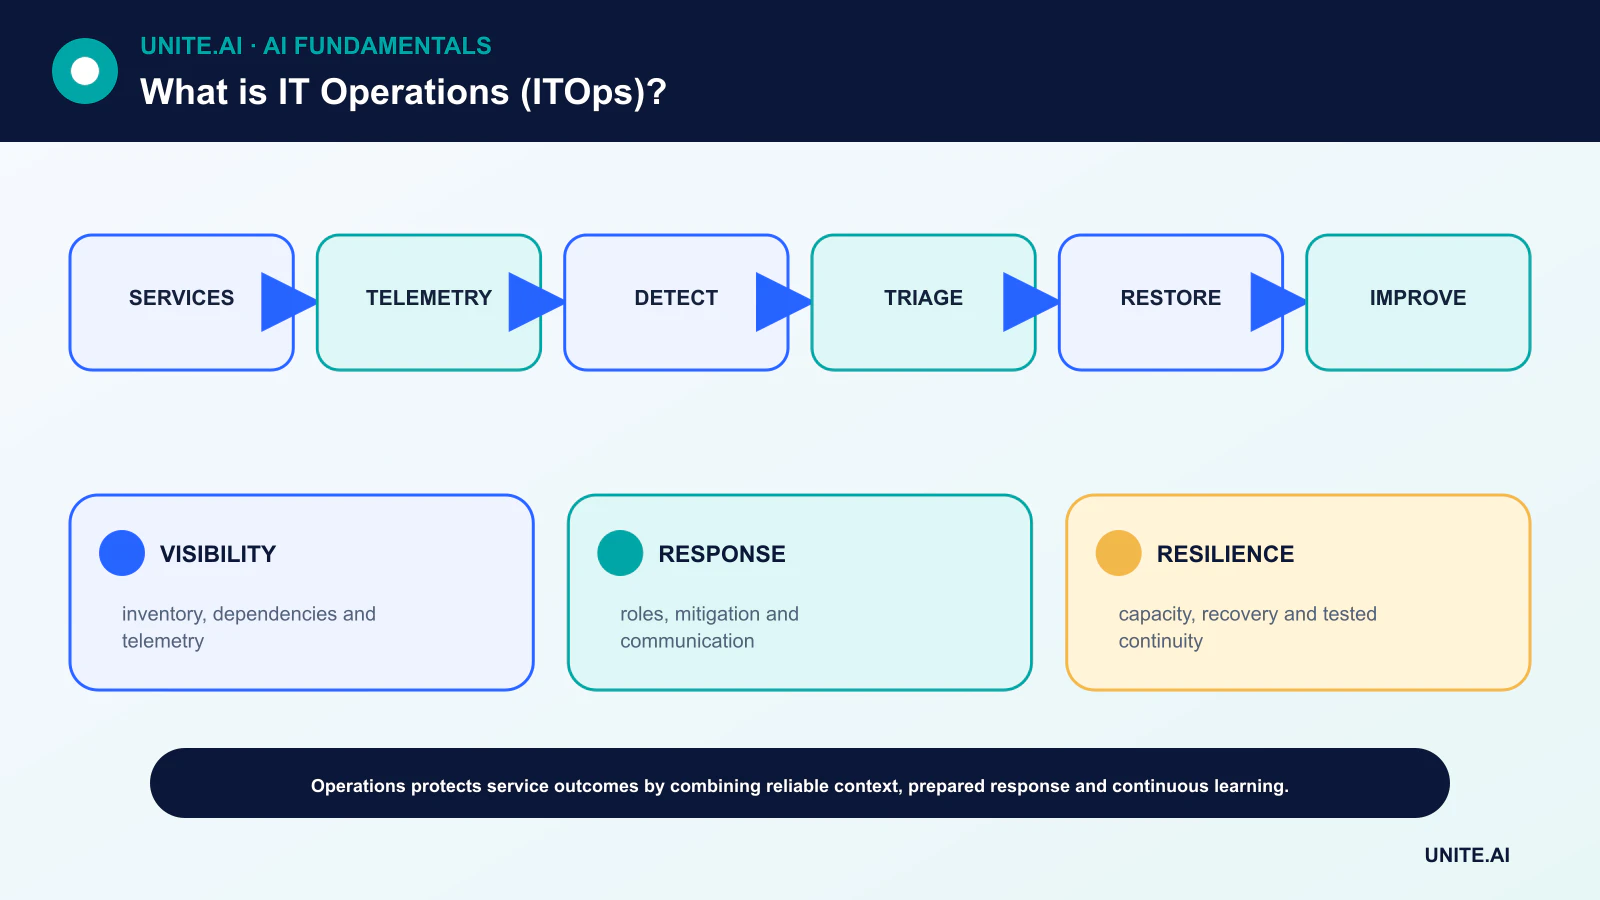
Serviços, ativos e configuração
As operações começam sabendo quais serviços existem, quem os possui, quais usuários dependem deles e qual infraestrutura os sustenta. O inventário de ativos registra os componentes; a gestão de configuração registra relacionamentos relevantes e o estado controlado.
Um inventário que nunca é reconciliado torna‑se enganoso. Automatize a descoberta onde for útil, identifique fontes autoritativas e registre confiança ou frescor em vez de fingir que cada mapa de dependência está completo.
Observabilidade e objetivos de serviço
Métricas quantificam comportamento, logs registram eventos e rastreamentos acompanham o trabalho entre serviços. Verificações sintéticas podem testar uma jornada do usuário. Uma observabilidade útil começa com perguntas e objetivos de serviço, então coleta os sinais necessários para respondê‑los.
Os alertas devem identificar condições que exigem ação oportuna. Limiares sem impacto ao usuário geram ruído, enquanto a falta de contexto de dependência retarda o diagnóstico. AIOps pode ajudar na correlação, mas precisa de telemetria confiável e feedback operacional.
Gerenciamento de incidentes, problemas e mudanças
O gerenciamento de incidentes coordena detecção, triagem, mitigação, comunicação e recuperação. Papéis claros reduzem a confusão sob pressão. Uma solução alternativa temporária pode restaurar o serviço enquanto uma investigação posterior de problema trata causas mais profundas.
O gerenciamento de mudanças avalia e registra risco sem transformar cada mudança em uma fila. Mudanças padrão, automatizadas e de baixo risco podem seguir caminhos pré‑aprovados; mudanças de alto impacto exigem evidência mais robusta, agendamento e preparação para reversão.
Capacidade, resiliência e continuidade
As equipes prevêem demanda de recursos, removem gargalos e testam comportamento sob carga. Backups são úteis apenas quando a restauração é testada. Redundância ajuda somente quando os modos de falha são independentes e o failover realmente funciona.
Continuidade de negócios define prioridades, tempo de recuperação e perda de dados aceitável. Dependências de identidade, DNS, planos de controle de nuvem e fornecedores devem ser incluídas nos exercícios, em vez de presumir que estejam disponíveis.
ITOps, ITSM, SRE e DevOps
O gerenciamento de serviços de TI fornece processos para alinhar serviços às necessidades organizacionais. Engenharia de confiabilidade de site (SRE) aplica engenharia de software às operações e usa objetivos de nível de serviço e orçamentos de erro. DevOps une feedback de desenvolvimento e operações.
SecOps foca em ameaças e respostas, enquanto ITOps mantém a saúde geral do serviço. Os organogramas diferem; o requisito importante é a propriedade explícita e evidência compartilhada entre essas disciplinas.
O modelo operacional do ITOps
Operações de TI mantêm os serviços de tecnologia da organização disponíveis, performáticos, seguros e recuperáveis. O escopo normalmente inclui endpoints, identidade, redes, servidores, nuvem, armazenamento, colaboração, bancos de dados, monitoramento, service desk, backup e serviços de fornecedores. O ITOps moderno abrange infraestrutura própria e plataformas gerenciadas, portanto a responsabilidade deve ser explícita mesmo quando a operação é terceirizada. Um inventário de configuração ou serviço conecta componentes técnicos a proprietários, usuários, dependências, classificação de dados e criticidade de negócios.
O gerenciamento de serviços organiza incidentes, solicitações, problemas, mudanças, ativos, conhecimento e níveis de serviço. O gerenciamento de incidentes restaura o serviço; o gerenciamento de problemas investiga causas recorrentes; a habilitação de mudanças avalia e coordena risco. Tratar cada mudança como uma aprovação lenta cria desvios, enquanto automação não governada gera falhas descontroladas. Mudanças padrão de baixo risco podem ser pré‑autorizadas e automatizadas; mudanças de alto risco precisam de evidência, comunicação, reversão e agendamento baseados no impacto.
Confiabilidade, capacidade e continuidade
O monitoramento deve seguir serviços voltados ao usuário e suas dependências, não apenas a contagem de dispositivos. Defina disponibilidade, latência, capacidade, frescor e objetivos de suporte com os responsáveis de negócios. Alerta sobre sintomas acionáveis e consumo de orçamento de erro; enriqueça eventos com propriedade e alterações recentes. Modelos de planejamento de capacidade consideram demanda, saturação, licenças e tempo de entrega. A elasticidade da nuvem reduz atrasos de provisionamento, mas não elimina cotas, limites regionais ou controle de custos.
Continuidade de negócios requer backups testados, restauração, recuperação de identidade, alternativas de rede, contatos de fornecedores e procedimentos manuais. Defina objetivos de tempo de recuperação (RTO) e ponto de recuperação (RPO) por serviço. Um backup não é evidência de recuperação até ser restaurado e validado. Treine cenários de ransomware, perda de região, certificados expirados, interrupção de identidade e falha de fornecedor. Rastreie configuração e infraestrutura como código sempre que possível para que a recuperação seja reproduzível.
Segurança, automação e métricas
Use o princípio do menor privilégio, gerenciamento de patches e vulnerabilidades, controles de endpoint, segmentação de rede, registro de logs e resposta a incidentes. Automatize trabalhos repetitivos com idempotência, limites, aprovações e auditoria. Meça disponibilidade de serviço, recorrência de incidentes, atendimento de solicitações, falhas de mudança, recuperação, exposição a patches, capacidade, custo e satisfação do usuário — não apenas o fechamento de tickets. ITOps tem sucesso quando a tecnologia apoia o trabalho de forma previsível e pode se recuperar de falhas, não quando a infraestrutura parece ocupada ou os painéis exibem apenas indicadores verdes.
Exemplo prático: recuperação de um serviço de colaboração
Uma empresa define um objetivo de tempo de recuperação de quatro horas e um objetivo de ponto de recuperação de uma hora para uma plataforma de colaboração. Ela inventaria identidade, DNS, rede, dados, chaves, configuração, integrações e dependências de fornecedores. Um exercício de recuperação assume que a região primária e a conta administrativa estão indisponíveis. Os operadores ativam uma identidade de emergência protegida de forma independente, restauram a configuração e os dados do serviço em uma região isolada e validam permissões, mensagens, integrações e acesso de clientes. Os responsáveis de negócios verificam o serviço restaurado com jornadas de usuário realistas, em vez de confiar apenas em verificações de saúde da infraestrutura.
O exercício registra perda real de dados, tempo decorrido, etapas manuais, contatos falhados e dependências ocultas. Um backup que restaura arquivos, mas não chaves de criptografia ou política de identidade, é marcado como incompleto. Ações corretivas recebem responsáveis e datas, e o runbook é atualizado e retestado. Modelos de monitoramento e comunicação são incluídos. A organização mede evidências de recuperação em vez de sucesso de job de backup, reconhecendo que ITOps confiável deve restaurar o serviço que os usuários precisam sob condições de falha realistas.
Provas de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes de ajustes. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, interrupção de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, reversão e aposentadoria. Use um rollout em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar qualidade de entrada, comportamento de saída, versão do modelo ou regra, saúde de dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável por resposta, então revise evidências do mundo real após a implantação ao invés de presumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Qual é o objetivo principal do ITOps?
Entregar e restaurar serviços de tecnologia confiáveis dentro dos limites acordados de segurança, desempenho, continuidade e custo.
A infraestrutura de nuvem é operada integralmente pelo provedor de nuvem?
Não. Os provedores operam partes da plataforma subjacente, enquanto os clientes permanecem responsáveis por configuração, identidade, dados, cargas de trabalho, monitoramento e muitas decisões de nível de serviço.
Referências principais












