
Fundamentos de IA
O que é Gerenciamento de Desempenho de Ativos (APM)?

 Adicione Unite.AI às suas fontes preferidas no Google
O gerenciamento de desempenho de ativos (APM) combina estratégia de ativos, manutenção, monitoramento de condição, análise de confiabilidade e dados operacionais para melhorar o valor entregue pelos ativos físicos. É comumente usado em equipamentos como turbinas, bombas, veículos, linhas de produção e infraestrutura.
O APM não é um painel de sensores ou um modelo de manutenção preditiva por si só. É um processo de decisão que equilibra desempenho, custo, risco, segurança e sustentabilidade ao longo do ciclo de vida do ativo, com responsabilidade clara para inspeções, trabalhos, peças sobressalentes e planejamento de capital.
Principais conclusões
- Comece com a criticidade e as consequências de falha, não com o sensor mais fácil de coletar.
- Combine dados de condição com histórico de manutenção, contexto operacional e conhecimento de engenharia.
- Use sinais preditivos para apoiar uma decisão de trabalho definida e o requisito de prazo.
- Meça risco evitado, disponibilidade, qualidade da manutenção, custo do ciclo de vida e alarmes falsos.
Da estratégia de ativos ao trabalho
As organizações definem objetivos, hierarquias de ativos, criticidade, padrões de desempenho, modos de falha e estratégias de manutenção. Um sistema de gerenciamento de trabalho agenda inspeções e reparos; as análises de APM ajudam a priorizar quando e por que o trabalho deve ocorrer.
A mesma condição pode implicar ações diferentes para uma bomba de baixo custo e redundante e uma turbina crítica para a segurança. O APM conecta evidências técnicas ao contexto de negócios e segurança, em vez de otimizar apenas um escore de previsão.
Dados e representações digitais
Fontes úteis incluem séries temporais de sensores, alarmes, rondas de operadores, notas de manutenção, peças, ambiente, cargas e limites de projeto. Identificadores de ativos e timestamps devem estar alinhados antes da análise. Sensores ausentes, com deriva ou substituídos podem gerar tendências falsas.
Um gêmeo digital pode combinar modelos de engenharia e estado ao vivo, mas requer suposições validadas e regras de atualização. Notas de técnicos não estruturadas podem acrescentar contexto que a telemetria não possui.
Condição, previsão e decisão
Limiares detectam limites conhecidos; modelos de anomalia sinalizam desvios; modelos diagnósticos estimam causas; modelos prognósticos estimam a vida útil remanescente. Cada um requer um horizonte temporal e incerteza adequados à decisão de manutenção.
Um modelo que prevê a falha cinco minutos antes de ocorrer pode ser preciso, mas operacionalmente inútil se as peças exigirem uma semana. Aprendizado de máquina deve ser comparado com regras e métodos de confiabilidade e testado em diferentes regimes operacionais.
Implementação e mensuração
Comece com uma classe de ativo crítico, um modo de falha credível, prazo disponível e um responsável que possa agir. Integre recomendações ao planejamento, ordens de serviço e inventário; colete o resultado para que a regra ou modelo possa ser revisado.
Acompanhe disponibilidade, tempo de inatividade não planejado, custo de manutenção, conformidade de cronograma, alarmes falsos, eventos perdidos, exposição à segurança e valor ao longo do ciclo de vida. Evite alegar falhas evitadas sem um método contrafactual e suposições documentadas.
Hierarquia de ativos, comportamento de falha e criticidade
Um programa de APM começa com uma hierarquia de ativos que conecta sites, sistemas, equipamentos, conjuntos e componentes passíveis de manutenção. Cada nível necessita de identificadores consistentes, responsabilidade, localização, especificações e relacionamentos. Sem essa base, fluxos de sensores, ordens de serviço, resultados de inspeções e registros de custos não podem descrever de forma confiável o mesmo ativo físico.
Modos de falha explicam como um ativo pode deixar de atender sua função requerida, por que a falha ocorre, que evidência aparece primeiro e qual consequência se segue. Análise de modos e efeitos de falha, manutenção centrada na confiabilidade e análise de causa raiz transformam a manutenção de uma atividade baseada em calendário para uma disciplina orientada ao risco. A análise deve distinguir sintomas de mecanismos causais.
A criticidade combina probabilidade com consequências para segurança, meio ambiente, produção, qualidade, conformidade e custo. Uma bomba redundante que atende a um circuito não essencial não deve receber o mesmo orçamento de monitoramento que um compressor de ponto único de falha. A criticidade muda com o contexto operacional, portanto as equipes devem revisitar as classificações após alterações de processo, ativo ou demanda.
Monitoramento de condição, previsão e decisões de manutenção
O monitoramento de condição pode usar vibração, temperatura, pressão, corrente, emissão acústica, análise de lubrificante, inspeção visual e observações do operador. A frequência de amostragem deve corresponder à física da falha. Vibração de rolamento de alta frequência e corrosão de deriva lenta exigem sensores, armazenamento, características e lógica de alerta diferentes. Calibração e qualidade da instalação fazem parte da qualidade dos dados.
Modelos preditivos podem detectar anomalias, classificar falhas conhecidas, estimar indicadores de saúde ou prever a vida útil remanescente. Um sinal estatisticamente incomum não é automaticamente uma falha acionável. Os modelos precisam de contexto de estado operacional, incerteza, avaliação de prazo, e validação em diferentes equipamentos, estações, cargas e eventos de manutenção. Alarmes falsos consomem confiança e mão de obra; detecções perdidas podem gerar perdas graves.
A saída das análises deve conectar-se a uma decisão: inspecionar, lubrificar, desclassificar, programar trabalho, solicitar uma peça ou desligar. Os limiares de decisão devem refletir a consequência da falha, prazo de intervenção, capacidade da força de trabalho, peças sobressalentes e janelas de produção. O limiar economicamente ótimo raramente é o que maximiza uma métrica genérica do modelo.
Integração do APM, mensuração de valor e governança
O APM conecta tecnologia operacional a sistemas corporativos como gerenciamento computadorizado de manutenção, gerenciamento de ativos empresariais, históricos, inventário e planejamento. A integração deve preservar timestamps, unidades, identidade do ativo, status de trabalho e procedência. Segmentação de rede e gateways controlados são essenciais, pois a conveniência diagnóstica não deve criar um caminho para sistemas de controle críticos à segurança.
Meça o valor por meio de tempo de inatividade evitado, redução de trabalhos emergenciais, custo de manutenção, disponibilidade de peças sobressalentes, eficiência energética, rendimento, exposição à segurança e vida útil do ativo. Falhas evitadas são contrafactuais, portanto use linhas de base credíveis, ativos comparáveis, suposições documentadas e faixas de sensibilidade. Um piloto que identifica muitas anomalias mas não altera decisões de manutenção não demonstrou valor de negócio.
A governança atribui responsáveis por sensores, modelos, regras de alarme, bibliotecas de falhas e processos de trabalho. Revise alertas após cada intervenção, registre se o diagnóstico estava correto e alimente os resultados confirmados de volta nas regras e modelos. Operadores e mantenedores precisam de um meio para contestar recomendações; o conhecimento local é evidência, não resistência à automação.
Exemplo prático: protegendo um ativo rotativo crítico
Para um compressor de produção, a equipe mapeia componentes e modos de falha, classifica as consequências de perda de produção e segurança, e conecta tags de histórico, sensores de vibração, amostras de lubrificante, inspeções e ordens de serviço a uma única identidade de ativo. Dados de linha de base devem cobrir partida, carga estável, redução e condições sazonais. Caso contrário, o modelo pode sinalizar transições operacionais normais como falhas ou perder degradações visíveis apenas em uma carga específica.
Uma camada de análise detecta mudanças no espectro de vibração e temperatura de rolamento, estima a incerteza e exibe as evidências ao lado de eventos históricos comparáveis. Um alerta persistente gera um pedido de inspeção em vez de desligar automaticamente. O mantenedor registra constatações, ação, peça substituída e causa confirmada. Esses resultados determinam se o limiar, o modelo de falha ou a instalação do sensor devem ser alterados.
Avalie o prazo de aviso, taxa de detecção confirmada, carga de alarmes falsos, tempo de inatividade evitado, trabalhos emergenciais, prontidão de peças sobressalentes e custo de manutenção em relação a uma linha de base documentada. Inclua o custo de sensores, integração, análise e processos de trabalho alterados. A revisão de cibersegurança isola o monitoramento do controle, e a governança atribui responsáveis pelos dados e modelos. O objetivo é uma decisão de manutenção econômica e mais segura, não a maior coleção possível de telemetria de ativos.
Checklist de implementação prática
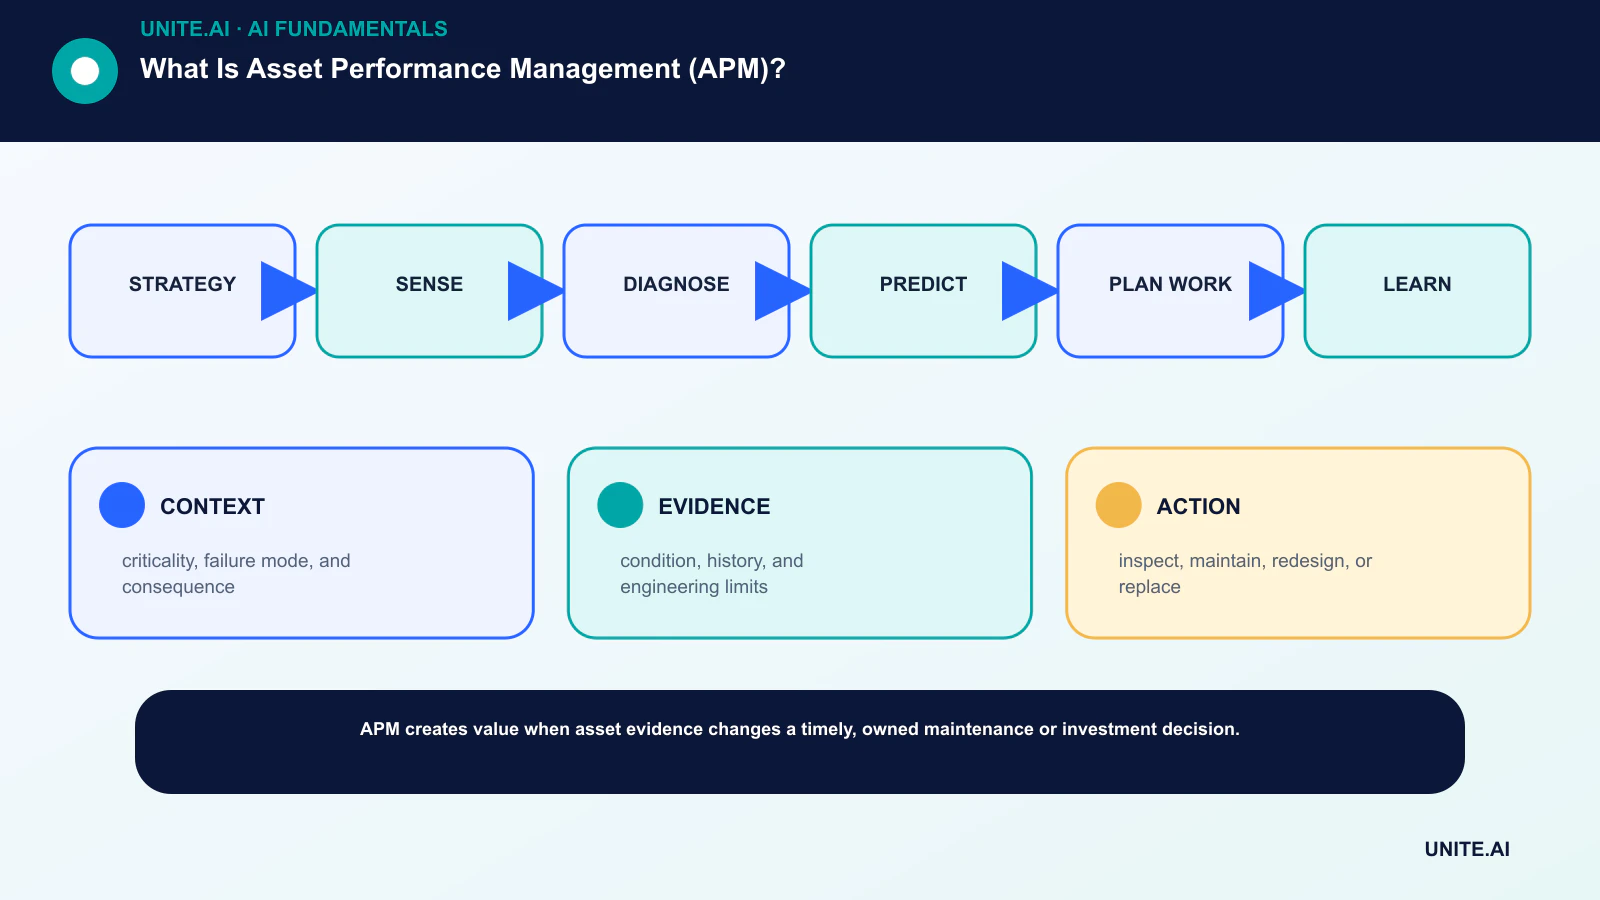
Transforme o conceito em um fluxo de trabalho delimitado e testável: estratégia → detecção → diagnóstico → previsão → planejamento de trabalho → aprendizado. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e parada, teste falhas representativas e defina monitoramento, reversão e revisão antes de ampliar o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, execute uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limiar, sobrescrever um resultado ou interromper a operação. Reavalie a decisão após a chegada de dados reais, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- CONTEXTO: criticidade, modo de falha e consequência.
- EVIDÊNCIA: condição, histórico e limites de engenharia.
- AÇÃO: inspecionar, manter, redesenhar ou substituir.
Perguntas frequentes
Como o APM difere de um CMMS?
Um CMMS gerencia principalmente o trabalho de manutenção, cronogramas e registros. O APM adiciona estratégia de ativos, análise de confiabilidade e condição, priorização e decisões de desempenho; os sistemas frequentemente se integram.
A manutenção preditiva é necessária para o APM?
Não. Estratégias preventivas, baseadas em condição, de execução até falha, de redesign e de substituição podem ser adequadas. A previsão é uma ferramenta dentro da estratégia de ativos.
Referências principais












