
Fundamentos de IA
O que é IA Explicável?

 Adicione Unite.AI às suas fontes preferidas no Google
Inteligência Artificial Explicável (XAI) compreende métodos e práticas que ajudam as pessoas a entender o comportamento ou a saída de um sistema de IA. Uma explicação pode descrever entradas influentes, mostrar um exemplo semelhante, apresentar uma mudança contrafactual, resumir uma regra global ou comunicar quando o sistema não sabe.
Nenhuma explicação é universalmente a melhor. Um desenvolvedor depurando um modelo, um auditor testando a conformidade de políticas e uma pessoa afetada por uma decisão precisam de evidências diferentes. As explicações, portanto, devem ser avaliadas quanto à precisão, significado e uso pretendido — não apenas ao apelo visual.
Principais pontos
- Transparência descreve as informações disponíveis; interpretabilidade se refere ao significado; explicação comunica evidências ou razões.
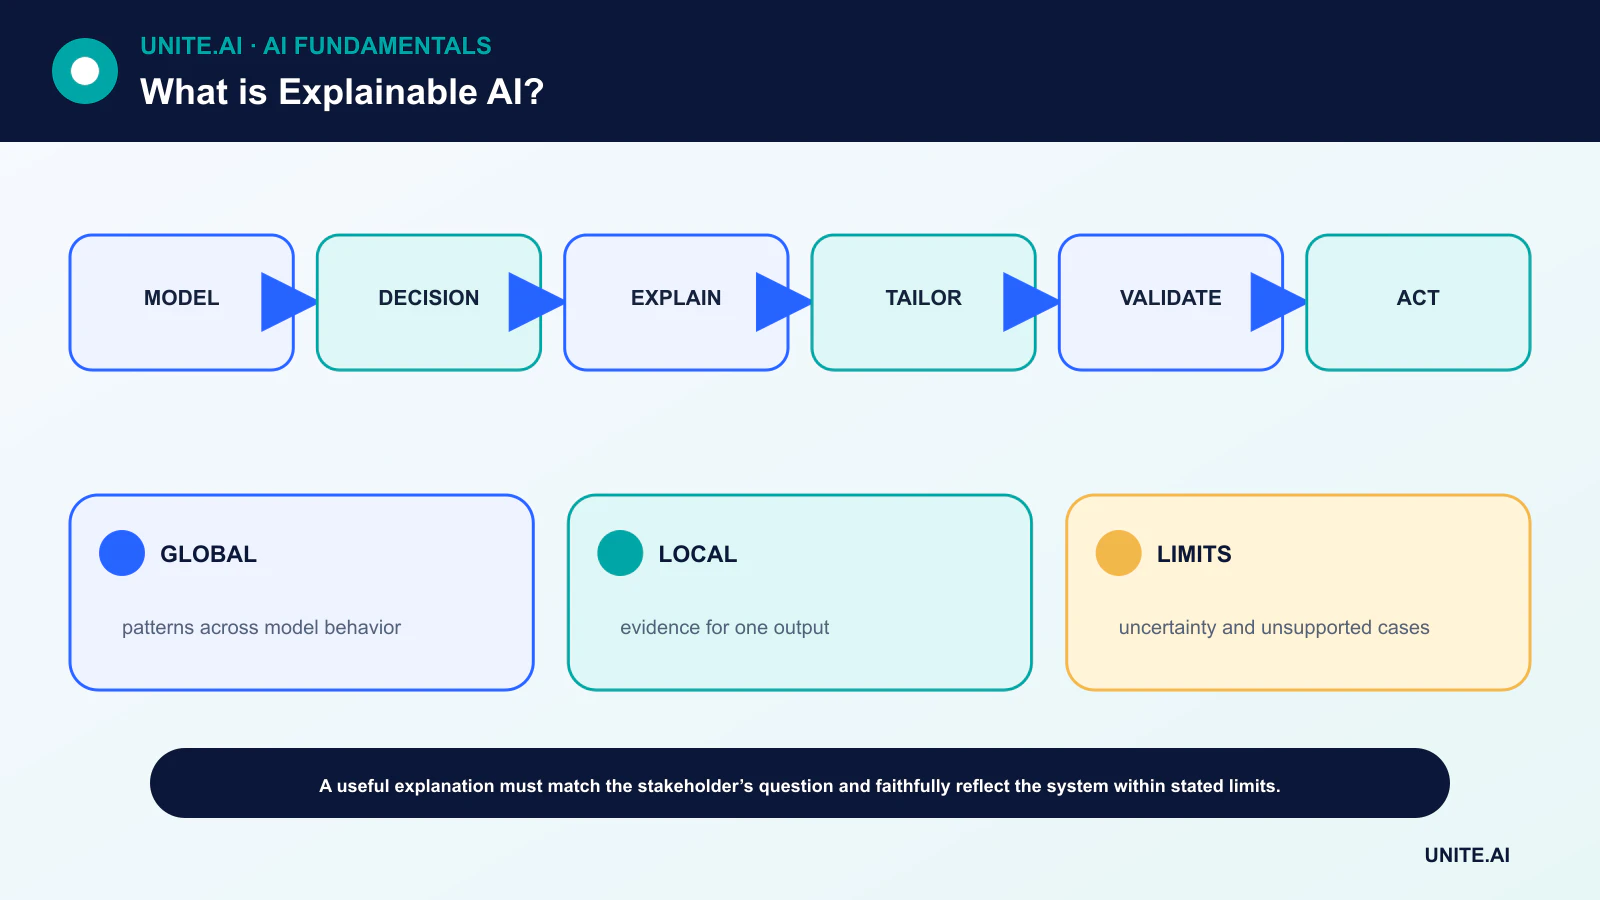
- Métodos globais resumem um modelo, enquanto métodos locais tratam de uma previsão ou de uma pequena região.
- Explicações pós-hoc podem ser úteis, mas podem ser instáveis ou não fiéis ao modelo subjacente.
- Uma explicação não prova justiça, causalidade, robustez ou correção.
Quatro princípios para explicações úteis
A NIST propõe que um sistema forneça uma explicação, torne-a significativa para seu usuário pretendido, garanta que reflita com precisão o processo do sistema e comunique seus limites de conhecimento. Esses princípios separam a existência de uma explicação de sua qualidade.
O significado é específico ao público. Um código de razão conciso pode ajudar um candidato, enquanto um desenvolvedor de modelo pode precisar de distribuições, comportamento de recursos e clusters de falhas. Ambos devem estar conectados ao mesmo sistema documentado e ao contexto de decisão.
Métodos intrínsecos e pós-hoc
Um modelo linear esparso ou uma árvore de decisão restrita pode ser diretamente interpretável dentro de seu escopo válido. Um modelo complexo pode, em vez disso, usar atribuição de recursos pós-hoc, um substituto local, exemplos, mapas de saliência ou contrafactuais.
A simplicidade intrínseca não é automaticamente fiel quando os recursos são mal definidos ou o pipeline está oculto. A complexidade pós-hoc não é automaticamente enganosa. O método deve ser testado em relação à pergunta que se pretende responder.
Atribuição de recursos e entradas correlacionadas
Métodos de atribuição atribuem partes de uma saída aos recursos de entrada sob suposições explícitas. O LIME ajusta um substituto local simples ao redor de uma previsão; métodos relacionados ao SHAP conectam atribuições aditivas aos conceitos de valor de Shapley.
Recursos correlacionados podem compartilhar ou trocar atribuição, e uma alta atribuição não é um efeito causal. Alterar um recurso isoladamente pode gerar uma pessoa, imagem ou transação impossível. As explicações devem declarar suas suposições de linha de base, amostragem e dependência.
Contrafactuais, exemplos e comportamento global
Um contrafactual pergunta qual mudança viável alteraria um resultado. Restrições são essenciais: uma explicação acionável não deve recomendar mudanças imutáveis, ilegais ou irrealistas. Métodos baseados em exemplos mostram protótipos ou casos de treinamento influentes, mas podem expor dados privados.
A análise global examina desempenho, dependência parcial, monotonicidade, interações e comportamento de subgrupos. Para ensembles como gradient boosting, combine resumos com evidências locais e testes diretos das restrições esperadas.
Validar a explicação e o sistema
Teste fidelidade, estabilidade sob pequenas perturbações, consistência entre entradas equivalentes, compreensão do usuário e se a explicação apoia uma decisão adequada. Testes adversariais devem verificar se uma explicação persuasiva pode acompanhar uma saída errada ou manipulada.
XAI faz parte de uma avaliação mais ampla: qualidade reservada, calibração, justiça, privacidade, segurança, monitoramento e mecanismos de recurso. Uma explicação pode apoiar a responsabilidade, mas não pode substituir uma governança responsável.
Alvos de explicação e famílias de métodos
A IA explicável deve começar com uma pergunta e um público: por que uma decisão ocorreu, como o modelo se comporta em geral, quais evidências o influenciaram, o que mudaria o resultado ou se uma política foi seguida. Explicações locais abordam uma previsão; explicações globais resumem o comportamento mais amplo. Modelos intrinsecamente interpretáveis expõem coeficientes, regras ou estruturas, enquanto métodos pós-hoc aproximam modelos complexos. Uma explicação do comportamento do modelo não é automaticamente uma explicação causal do mundo ou uma justificativa de que uma decisão é justa.
Métodos de atribuição de recursos incluem gradientes, gradientes integrados, valores no estilo SHAP, permutação e modelos substitutos locais. Explicações baseadas em exemplos recuperam casos influentes ou semelhantes; contrafactuais propõem mudanças associadas a uma saída diferente; métodos de conceito relacionam representações internas a categorias humanas. Cada um tem suposições sobre linhas de base, independência de recursos, linearidade local ou acesso ao modelo. Variáveis correlacionadas, interações e pré-processamento podem tornar as atribuições instáveis ou enganosas. Compare os métodos e perturbe as entradas para testar se uma explicação prevê o comportamento.
Avaliação e fatores humanos
Avalie a fidelidade — se a explicação corresponde ao modelo — separadamente da plausibilidade para a pessoa. Teste estabilidade, sensibilidade, completude, esparsidade e utilidade para uma tarefa definida, como depuração ou recurso. Estudos humanos precisam de participantes representativos e devem medir a qualidade da decisão, detecção de erros, dependência e tempo, não se os usuários dizem que um gráfico parece claro. Uma explicação persuasiva pode aumentar a confiança em um modelo errado, portanto as interfaces devem mostrar incerteza, alternativas e limitações.
Contrafactuais devem ser viáveis, acionáveis e não recomendar a mudança de características protegidas ou imutáveis. Explicações podem vazar informações do modelo ou pessoais e ajudar atacantes a engenharia reversa de decisões. Aplique controles de acesso e minimização de saída. Para usos regulados ou de alto impacto, mantenha a proveniência dos dados, versão do modelo, limiar e lógica de decisão real; um gráfico genérico de importância de recursos não pode substituir uma razão juridicamente significativa ou revisão humana.
Usar explicações de forma responsável
Selecione o modelo mais simples que atenda ao desempenho e às necessidades operacionais, mas não sacrifique a validade por interpretabilidade superficial. Combine explicações com testes de subgrupos, verificações de robustez, análise causal quando relevante e monitoramento de resultados. Documente o público pretendido e inferências inválidas. Se uma explicação mudar após uma perturbação inofensiva, investigue antes da implantação. Explicabilidade é evidência sobre um sistema sob um método; é valiosa para depuração, supervisão e comunicação, mas não certifica verdade, justiça, segurança ou compreensão.
Exemplo prático: explicando um modelo de risco de crédito
Um credor primeiro define o público e a razão necessária: os solicitantes precisam de fatores de decisão precisos e um caminho de correção, enquanto os desenvolvedores precisam de diagnósticos. Uma linha de base interpretável calibrada é comparada com um modelo impulsionado. Atribuições locais, contrafactuais e análise de erro global são testados quanto à fidelidade, estabilidade, comportamento de recursos correlacionados e utilidade. As explicações não podem recomendar a mudança de idade, deficiência ou outra característica imutável, e não são apresentadas como efeitos causais.
O registro de decisão de produção preserva os dados de origem, transformação de recursos, modelo, limiar, política e ação humana. Os solicitantes podem contestar dados incorretos e receber uma revisão significativa. O monitoramento verifica a estabilidade de resultados e explicações entre grupos e atualizações de modelo. Se uma explicação plausível mudar sob perturbação inofensiva de recurso ou omitir uma regra política decisiva, a implantação é interrompida. A explicabilidade complementa a validação e os direitos processuais; não isenta um alvo inválido, resultados discriminatórios ou falta de autoridade humana responsável.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem-sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e descontinuação. Use um lançamento em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise as evidências do mundo real após a implantação, em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Mapas de atenção são explicações?
Eles podem ser sinais diagnósticos, mas os pesos de atenção por si só não garantem representar fielmente as razões da saída de um modelo.
IA explicável requer um modelo simples?
Nem sempre. Modelos complexos podem ser analisados com métodos pós-hoc, mas essas explicações precisam de validação independente e limites claramente declarados.
Referências principais












