
Fundamentos de IA
O que é TinyML? Aprendizado de Máquina em Microcontroladores

 Adicione Unite.AI às suas fontes preferidas no Google
TinyML traz inferência de aprendizado de máquina para dispositivos altamente restritos, como microcontroladores, pequenos processadores de sinal digital e sensores de baixo consumo. Esses sistemas podem ter quilobytes ou megabytes de memória, orçamentos de energia rigorosos, nenhuma conexão de rede contínua e prazos em tempo real.
O valor não está apenas em um modelo menor. Processar próximo ao sensor pode reduzir latência, largura de banda e exposição de dados brutos, ao mesmo tempo que permite produtos que operam por longos períodos com baterias ou energia captada.
Principais pontos
- TinyML é definido pelo orçamento completo de hardware e software, não por um limite de tamanho de modelo.
- Quantização, arquiteturas compactas, kernels otimizados e buffering cuidadoso tornam a implantação possível.
- A inferência no dispositivo pode melhorar a privacidade, mas atualizações seguras e governança de dados ainda são importantes.
- Avalie a precisão juntamente com latência, memória máxima, energia, ciclo de trabalho e robustez.
A pilha TinyML
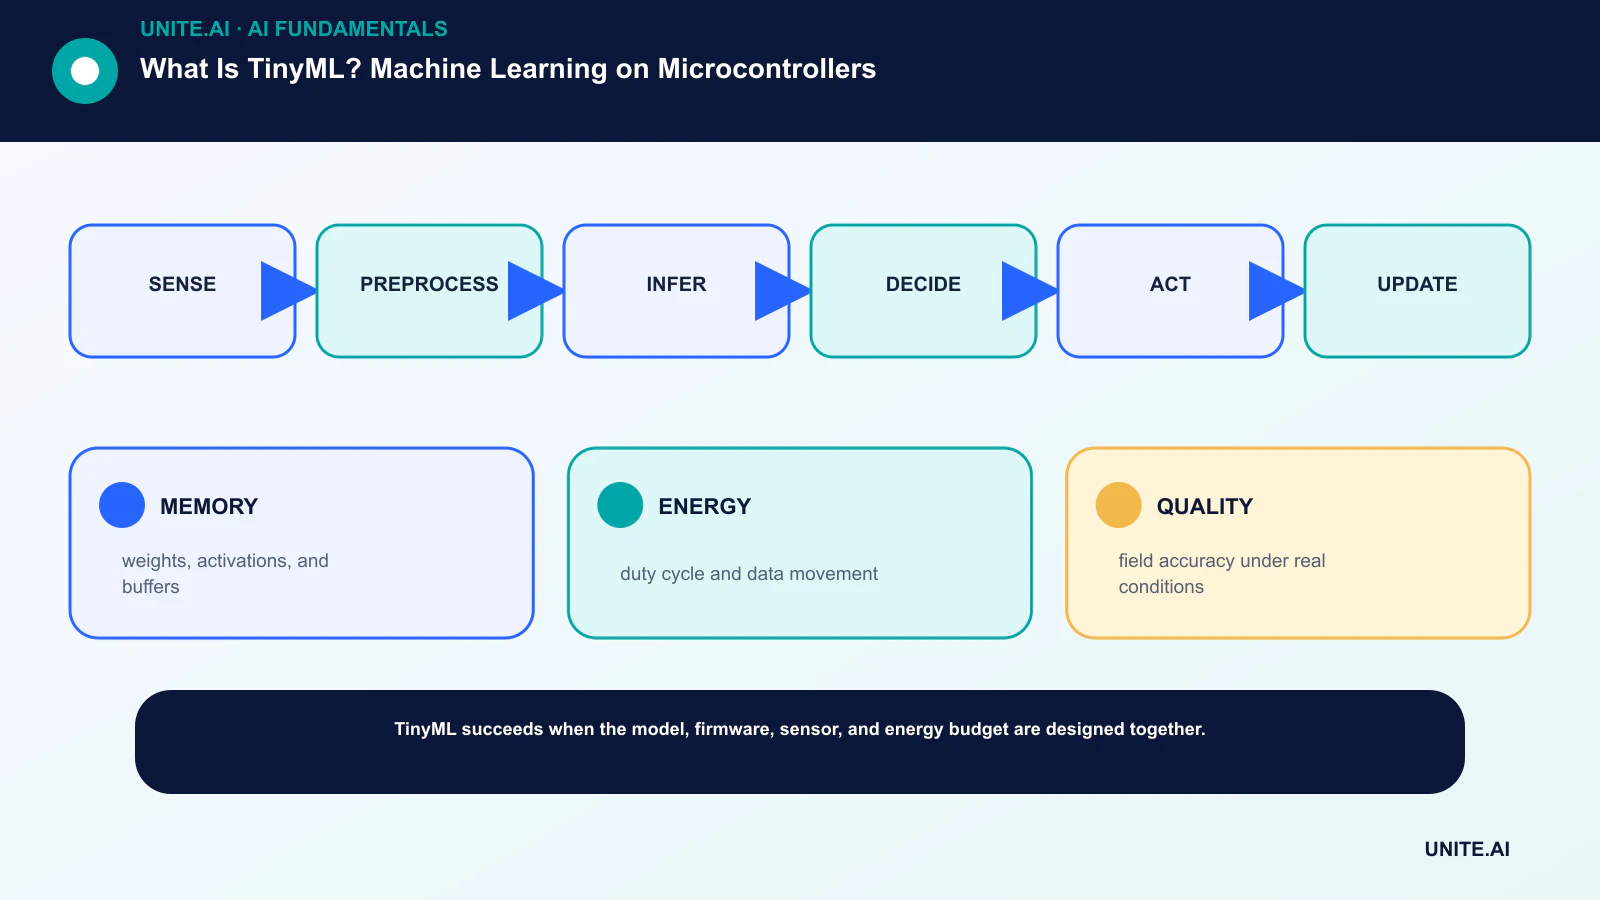
Um sensor captura áudio, movimento, vibração, imagens ou outro sinal. O firmware o pré-processa em recursos ou tensores; um modelo compacto é executado por um runtime embarcado; a lógica da aplicação decide se deve despertar um sistema maior ou agir localmente.
Esta é uma forma restrita de edge AI. O hardware pode incluir um MCU, memória, interfaces de sensores e, às vezes, um acelerador neural. Cada buffer, operador e cópia competem por recursos limitados.
Ajuste o modelo
A quantização substitui valores de alta precisão por representações inteiras menores. Poda, destilação, engenharia de recursos e busca de arquitetura podem reduzir o cálculo ou o armazenamento. O suporte a operadores no runtime alvo restringe quais modelos são práticos.
O treinamento costuma ocorrer em hardware maior, depois o modelo é convertido e compilado para o dispositivo. Transfer learning pode reduzir a necessidade de dados, mas o artefato final deve ser avaliado após a conversão, pois mudanças numéricas podem alterar a precisão.
Dados e mudança ambiental
Gravações de laboratório raramente representam todos os microfones, posições de montagem, temperaturas, padrões de vibração, sotaques ou condições de fundo. Colete dados de dispositivos e ambientes representativos, mantenha as fontes de treinamento e teste independentes e inclua casos de ‘nenhum dos anteriores’.
Um disparo falso pode desperdiçar energia ou irritar o usuário; uma anomalia não detectada pode ser custosa. Selecione limites usando os custos reais de erro e monitore o desempenho em campo por meio de resumos que preservam a privacidade ou diagnósticos amostrados, quando apropriado.
Meça todo o dispositivo
Contagens de operações do modelo não equivalem ao desempenho do produto. Relate frequência de ativação, tempo de pré-processamento, latência de inferência, RAM máxima, uso de flash, potência média e pico, comportamento térmico e impacto na bateria sob um ciclo de trabalho explícito.
Planeje firmware e atualizações de modelo assinados, rollback, identidade do dispositivo e resposta a vulnerabilidades. Dispositivos pequenos podem permanecer implantados por anos, portanto a manutenção faz parte da qualidade do modelo. Os controles de Cybersecurity não podem ser postergados porque o dispositivo é pequeno.
Orçamento de memória e computação
O flash armazena firmware, pesos do modelo e constantes; a RAM contém buffers de sensores, ativações intermediárias e estado de runtime. A memória de ativação máxima pode exceder o tamanho dos pesos, especialmente nas primeiras camadas convolucionais. Planejadores de memória reutilizam buffers cujas vidas não se sobrepõem, enquanto recursos de streaming evitam armazenar uma janela completa de sinal.
A contagem de operações é uma estimativa inicial, mas a eficiência do kernel depende da forma do tensor, alinhamento, suporte a instruções e acesso à memória. Uma convolução depthwise pode reduzir a aritmética, mas executar mal em hardware sem kernel otimizado. Avalie o modelo compilado na placa alvo, não apenas em um profiler de desktop.
O ciclo de trabalho domina muitos produtos. O sensor e o MCU podem ficar em modo de espera, despertar por um disparo simples, executar um modelo pequeno e ativar um rádio ou processador maior apenas quando necessário. Meça todo o ciclo de trabalho, incluindo sensor, conversão, pré-processamento, despertar, inferência, comunicação e vazamento em repouso.
Desenvolvimento e conversão de modelo
Comece com as restrições de implantação e colete dados de sensores representativos. O pré-processamento usado no treinamento deve corresponder exatamente à implementação em ponto fixo ou embarcada. Diferenças na taxa de amostragem, janelamento, conversão de cor, normalização ou extração de recursos podem fazer o modelo falhar mesmo quando a conversão tem sucesso.
A quantização pós-treinamento calibra intervalos a partir de amostras representativas; o treinamento consciente de quantização simula menor precisão durante o aprendizado. Escalas de peso por canal geralmente preservam melhor a qualidade convolucional do que uma única escala. Operações não suportadas podem ser reescritas, aproximadas ou movidas para um fallback mais lento, exigindo nova avaliação.
A compressão deve ser guiada por hipóteses. Poda de pesos não estruturados pode não acelerar um kernel denso embarcado; a remoção estruturada de canais é mais fácil de ser explorada pelo hardware. A destilação transfere o comportamento de um professor maior, mas pode transferir seus vieses e erros. Compare com processamentos de sinal e linhas de base de limiar.
Aplicações, testes em campo e manutenção
Tarefas comuns de TinyML incluem detecção de palavras‑chave, detecção de palavra‑despertar, reconhecimento de gestos, detecção de anomalias de vibração, ocupação, eventos acústicos e visão simples. O modelo pode servir como um filtro ao invés da decisão final, conservando largura de banda ao enviar casos incertos ou importantes para um sistema mais capaz.
Os testes de campo devem abranger tolerâncias do dispositivo, envelhecimento do sensor, montagem, estado da bateria, temperatura, clima, usuários e interferência de fundo. Registre disparos falsos por hora ou eventos perdidos por ciclo de operação, não apenas a acurácia balanceada do teste. Um limiar escolhido no laboratório pode precisar de calibração específica ao produto.
Planeje atualizações OTA assinadas, rollback, telemetria de versão do modelo e períodos longos de suporte. Se atualizações forem impossíveis, use modelos conservadores e documente o desvio ambiental esperado. A desativação deve revogar credenciais do dispositivo e tratar os dados armazenados, não apenas interromper a venda do produto.
Exemplo prático: um monitor de vibração TinyML
Um pequeno acelerômetro em um motor amostra vibrações sob cargas normais e condições de falha conhecidas. O dispositivo segmenta o sinal, remove o offset, calcula recursos compactos no domínio do tempo ou da frequência e executa um detector de anomalias ou classificador. A taxa de amostragem deve capturar frequências relevantes de rolamentos e eixos sem sobrecarregar memória ou energia. Os rótulos devem provir de inspeções verificadas, não apenas de um alarme que pode estar errado.
O treinamento ocorre em uma estação de trabalho, seguido de quantização, conversão e compilação para o microcontrolador alvo. Meça flash do modelo, RAM máxima, tempo de execução, energia e precisão no dispositivo físico. A aritmética inteira e a disponibilidade de operadores podem alterar as saídas do modelo treinado. Teste orientação do sensor, montagem, temperatura, voltagem, variação de componentes e vibração de fundo real, não apenas arquivos laboratoriais curados.
O dispositivo implantado necessita de calibração, atualizações seguras de firmware, relatório de versão, comportamento à prova de falhas e um plano para desvio. Pode transmitir apenas um índice de saúde ou recursos selecionados para economizar energia e proteger dados brutos, mas alarmes falsos locais ainda geram custos de manutenção. Use um limiar em estágios, exija persistência e combine evidências do modelo com o estado operacional. TinyML é mais valioso quando latência local, privacidade, conectividade ou restrições de energia justificam seus limites de engenharia.
Os testes de produção devem incluir recuperação de ciclos de energia, deriva de relógio, desconexões de sensores, entrada corrompida, exaustão de memória e atualizações interrompidas. Defina o que acontece quando o modelo não pode ser executado ou a confiança colapsa: um padrão seguro, um indicador de falha explícito ou uma regra convencional pode ser preferível a um palpite silencioso. Rastreie versões de hardware e firmware da frota para que um erro recém‑observado possa ser isolado a uma revisão do dispositivo, ambiente ou versão do modelo.
Checklist de implementação prática
Transforme o conceito em um fluxo de trabalho delimitado e testável: captar → pré-processar → inferir → decidir → agir → atualizar. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e parada, teste falhas representativas e defina monitoramento, rollback e revisão antes de expandir o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, conduza uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limiar, sobrescrever uma saída ou interromper a operação. Revise a decisão após a chegada de dados do mundo real, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- MEMORY: pesos, ativações e buffers.
- ENERGY: ciclo de trabalho e movimentação de dados.
- QUALITY: precisão de campo sob condições reais.
Perguntas frequentes
TinyML é o mesmo que IA móvel?
Não exatamente. Dispositivos móveis são sistemas de borda com processadores e memória comparativamente grandes. TinyML foca em restrições muito mais apertadas de dispositivos embarcados e de classe microcontrolador.
Modelos TinyML podem aprender no dispositivo?
A maioria das implantações treina em outro lugar e inferência ocorre no dispositivo. Adaptação limitada é possível, mas memória, energia, estabilidade, privacidade e rollback tornam o treinamento no dispositivo mais difícil.
Referências principais












