
Fundamentos de IA
O que é Aprendizado Federado?

 Adicione Unite.AI às suas fontes preferidas no Google
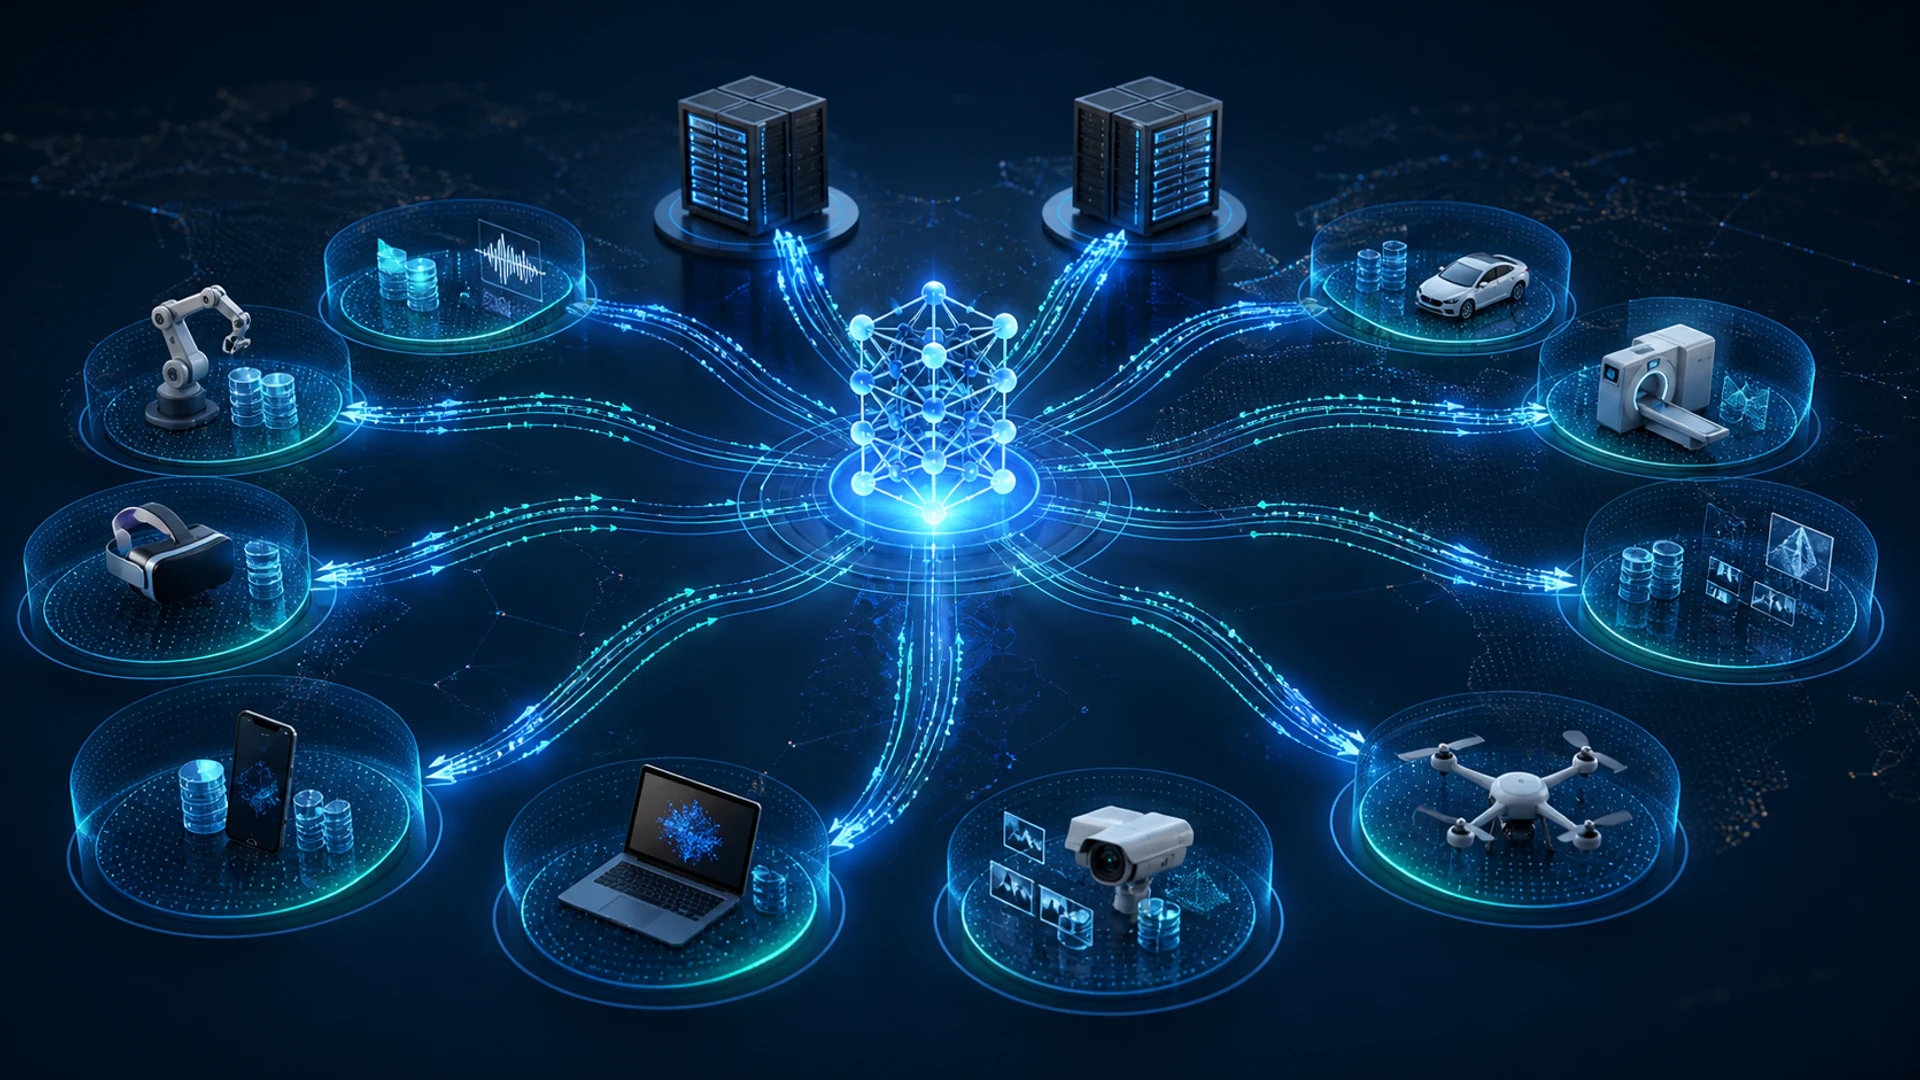
Aprendizado federado treina um modelo compartilhado em vários dispositivos ou organizações, mantendo os dados brutos de treinamento de cada participante localmente. Um coordenador distribui os parâmetros do modelo, os clientes calculam atualizações em seus próprios registros e uma etapa de agregação combina essas atualizações.
Manter os registros localmente é útil, mas não é sinônimo de privacidade ou segurança. Atualizações do modelo podem vazar informações, clientes comprometidos podem envenenar o treinamento, e o coordenador ainda precisa de autenticação, segurança de transporte, controles de acesso e um modelo de confiança definido.
Principais pontos
- O aprendizado federado desloca a computação para dados distribuídos; ele não move o conjunto de dados bruto para um único treinador central.
- Sistemas cross-device envolvem muitos dispositivos intermitentes, enquanto sistemas cross-silo envolvem menos organizações, porém mais estáveis.
- Agregação segura e privacidade diferencial abordam riscos diferentes e podem ser combinadas.
- Dados não IID, largura de banda limitada, participação pouco confiável e atualizações maliciosas são restrições de design fundamentais.
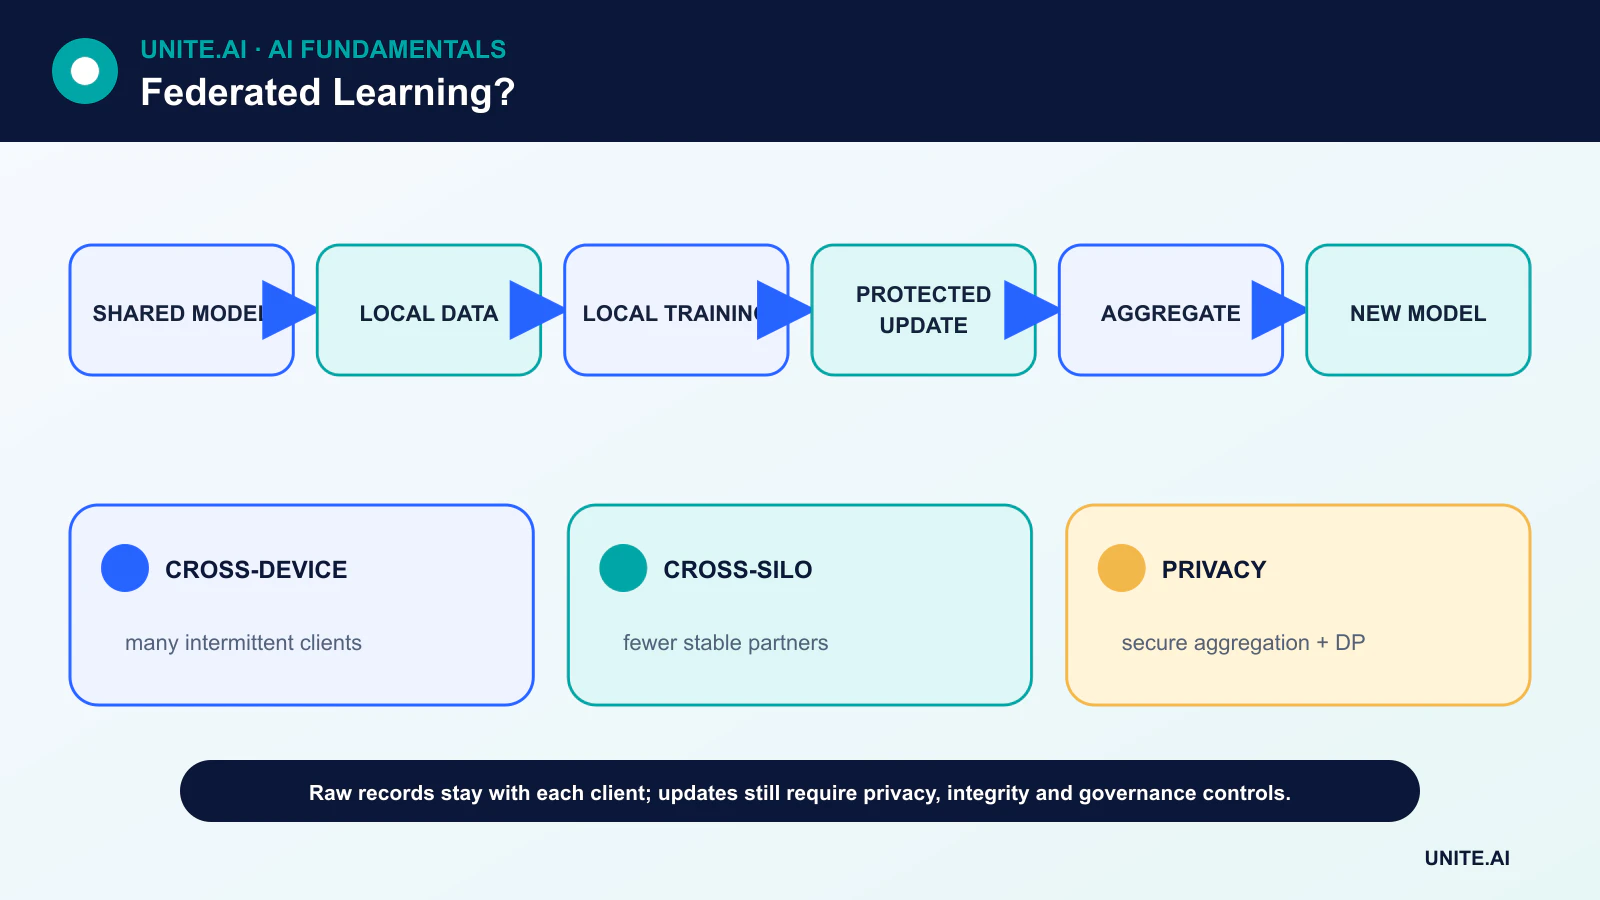
O ciclo de vida da média federada
Uma rodada típica começa quando um coordenador seleciona clientes elegíveis e envia o modelo atual. Cada cliente treina localmente por um número limitado de etapas, produzindo uma atualização de parâmetro ou gradiente. O coordenador agrega as atualizações elegíveis — frequentemente com pesos baseados na contagem de exemplos locais — e publica o novo modelo compartilhado.
Só uma fração dos clientes pode participar de cada rodada. O protocolo deve tolerar conexões interrompidas, incompatibilidades de versão e dispositivos que não podem treinar enquanto carregam, estão ocupados ou offline. A comunicação pode dominar a computação, portanto compressão de atualizações e menos idas e vindas costumam ser mais importantes que a velocidade bruta do acelerador.
Dispositivos cruzados versus silos cruzados
O aprendizado federado cross-device pode envolver telefones, sensores ou navegadores de muitos indivíduos. Os clientes são numerosos, pouco confiáveis e disponíveis intermitentemente. O aprendizado federado cross-silo geralmente conecta um conjunto menor de hospitais, bancos ou unidades de negócios com infraestrutura estável e governança contratual.
Os dois cenários exigem diferentes suposições de identidade, auditoria e falhas. Um projeto cross-silo pode negociar um esquema compartilhado e um processo de validação; um serviço cross-device pode precisar lidar com milhões de versões de software e conjuntos de dados locais altamente desiguais.
Agregação segura, privacidade diferencial e criptografia
Agregação segura é um protocolo criptográfico que permite ao servidor recuperar um agregado sem ler a atualização de cada cliente. A privacidade diferencial limita o quanto o resultado divulgado pode depender de um registro ou participante ao recortar contribuições e adicionar ruído calibrado.
Nenhum dos mecanismos resolve todos os riscos. Agregação segura não torna o agregado inofensivo, e a privacidade diferencial impõe um trade‑off entre precisão e privacidade que deve ser considerado com um orçamento de privacidade explícito. Criptografia protege dados em trânsito ou armazenamento; por si só não impede inferência a partir de um modelo.
Dados não IID e qualidade do modelo
Os dados dos clientes raramente são independentes e identicamente distribuídos. Um modelo de teclado vê o vocabulário de cada pessoa; hospitais atendem populações diferentes; fábricas utilizam equipamentos distintos. Essas diferenças podem retardar a convergência e ocultar desempenho ruim para pequenos grupos de clientes.
A avaliação deve incluir métricas globais, distribuições por cliente ou coorte, calibração e análise de falhas. Um conjunto de teste central pode ser conveniente, mas é insuficiente. Isso conecta o aprendizado federado à qualidade de dados de aprendizado de máquina e à governança de dados estruturados e não estruturados.
Ameaças e controles operacionais
Clientes maliciosos podem submeter atualizações envenenadas, clientes sybil podem distorcer a agregação, e um servidor comprometido pode distribuir um modelo direcionado. Defesas incluem inscrição autenticada, detecção de anomalias, agregação robusta, validação de atualizações, limites de taxa e atestação de software reproduzível quando prático.
O aprendizado federado faz parte de um programa mais amplo de cibersegurança. As equipes devem documentar quem controla o coordenador, quais metadados são coletados, como os participantes podem sair, como os modelos são revertidos e o que acontece quando testes de privacidade ou qualidade falham.
Otimização federada e heterogeneidade de dados
O aprendizado federado envia um modelo ou tarefa de atualização para os clientes participantes, treina localmente e agrega atualizações sem centralizar os exemplos brutos. Na média federada, os clientes selecionados executam várias etapas de otimização local e o servidor calcula uma média ponderada, normalmente pelo número de exemplos. Rodadas de comunicação, épocas locais, seleção e taxas de aprendizado negociam largura de banda contra convergência. Configurações cross-device envolvem muitos telefones ou sensores pouco confiáveis; configurações cross-silo envolvem menos organizações com computação, identidade e governança mais robustas.
Os dados do cliente geralmente são não independentes e desiguais: os usuários diferem em comportamento, distribuição de rótulos, volume e disponibilidade. O treinamento local pode divergir em direções incompatíveis, tornando uma média simples instável ou tendenciosa em favor de clientes ativos de alto volume. Algoritmos podem usar termos proximais, otimização adaptativa no servidor, clustering, personalização ou variáveis de controle. A avaliação deve relatar desempenho global e por cliente, clientes de cauda, frequência de participação, convergência, comunicação e energia. Uma boa média pode ocultar que populações de clientes pequenas ou raras recebem um modelo pior.
Privacidade, segurança e engenharia de sistemas
Manter os dados localmente não garante privacidade por si só. Gradientes e atualizações podem vazar a participação ou características, enquanto o modelo final pode memorizar exemplos. Agregação segura oculta atualizações individuais do servidor, e a privacidade diferencial limita a contribuição de informação ao recortar e adicionar ruído, mas ambas alteram a utilidade e a complexidade operacional. Defina o modelo de ameaça, a unidade de privacidade, o orçamento e os componentes confiáveis. Criptografia em trânsito é necessária, mas não impede um cliente malicioso, atualização envenenada, coordenador comprometido ou ataque de inferência.
Defesas incluem clientes autenticados, agregação robusta, verificações de anomalias, limites de atualização, enclaves seguros em alguns projetos e validação contra dados limpos. Atacantes sybil podem criar muitos clientes; backdoors podem sobreviver à média; descartar atualizações suspeitas também pode excluir comportamentos raros legítimos. Versione o código do cliente, suporte rodadas interrompidas, previna replay e projete para atrasados e restrições de dispositivos. Consentimento, retenção, regras regionais e exclusão ainda se aplicam aos dados locais e às atualizações derivadas.
Exemplo de implantação e governança
Um teclado móvel pode treinar melhorias de próxima palavra localmente, mas a implantação deve usar uma população elegível pela capacidade do dispositivo e consentimento, coletar atualizações protegidas recortadas e comparar com uma linha de base congelada. Valide o desempenho de idioma e dialeto, bateria, uso de dados e risco de memorização antes do lançamento. Os clientes precisam de tarefas de treinamento assinadas e atualizações de modelo; o servidor precisa de configuração de rodada auditável e reversão. O aprendizado federado é uma arquitetura para aprendizado distribuído sob restrições, não um substituto para dados representativos, engenharia de privacidade ou responsabilidade.
Exemplo prático: aprendizado federado entre hospitais
Hospitais treinam um modelo compartilhado de qualidade de imagem sem agrupar exames. Um protocolo comum define metadados de dispositivo, rótulos, pré-processamento, elegibilidade de cliente, épocas locais, recorte e agregação segura. Os sites mantêm os dados dos pacientes e enviam atualizações protegidas, enquanto um coordenador avalia cada rodada em conjuntos locais de validação. Os resultados relatam desempenho por site e de cauda, não apenas uma média ponderada por volume, pois hospitais pequenos e tipos de dispositivos poderiam ser ignorados.
O modelo de ameaça cobre atualizações maliciosas, vazamento de participação, clientes comprometidos e acesso do coordenador. A privacidade diferencial é configurada com um orçamento documentado e utilidade testada. Pacotes de modelo e tarefa são assinados; os sites podem se retirar e as atualizações são auditáveis. Uma rodada envenenada ou instável não substitui o modelo implantado automaticamente. O projeto mantém linhas de base locais e revisão clínica, e trata a arquitetura federada como um controle de privacidade dentro de obrigações mais amplas de consentimento, segurança e governança.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use uma implantação em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável por respostas, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O aprendizado federado garante que dados privados não possam vazar?
Não. Ele reduz o movimento de dados brutos, mas atualizações e modelos finais ainda podem revelar informações. A privacidade requer um modelo de ameaça e controles técnicos e organizacionais adicionais.
Quando o treinamento centralizado é mais simples?
Quando os dados podem ser centralizados de forma legal e segura, o treinamento centralizado costuma ser mais fácil de depurar, reproduzir e monitorar. O aprendizado federado se justifica quando a distribuição é uma exigência real, não apenas um objetivo de marketing.
Referências principais












