Modelos e plataformas de IA
O que é a Lei de Moore e como ela afeta a IA?

 Adicione Unite.AI às suas fontes preferidas no Google
A Lei de Moore é a observação histórica de que circuitos integrados economicamente úteis tendiam a ganhar componentes em ritmo exponencial. Não é uma lei da física e não afirma que os computadores se tornam automaticamente duas vezes mais rápidos em um cronograma fixo.
Para a IA, a densidade de transistores importa porque permite mais unidades aritméticas, memória e interconexões. Contudo, o progresso prático também depende da arquitetura, precisão numérica, encapsulamento, largura de banda da memória, algoritmos, software, energia, rendimento de fabricação e da quantidade de dados úteis.
Principais pontos
- O artigo original de Moore de 1965 descreveu uma tendência econômica e de engenharia, não uma garantia física.
- A escalada da frequência de relógio desacelerou; os ganhos modernos vêm cada vez mais do paralelismo e de aceleradores especializados.
- O desempenho da IA costuma ser limitado pelo movimento de memória e energia, não apenas pela aritmética.
- Compare sistemas com latência, taxa de transferência, qualidade, consumo de energia e custo total em nível de carga de trabalho — não apenas com a contagem de transistores.
O que Moore realmente observou
Gordon Moore traçou o número de componentes nos principais circuitos integrados e projetou um crescimento rápido contínuo ao custo mínimo por componente. Mais tarde, esse ritmo foi frequentemente resumido como uma duplicação aproximadamente a cada dois anos, embora as formulações e as grandezas medidas tenham variado.
Características menores podem aumentar a densidade e reduzir alguns custos de comutação, porém a complexidade e a economia da fabricação determinam se a tendência permanece útil. Os nomes dos nós são rótulos de marketing, portanto não devem ser tratados como comparações físicas diretas entre fundições.
De núcleos mais rápidos à computação heterogênea
O dimensionamento de tensão ao estilo Dennard permitia, em um tempo, taxas de relógio mais altas sem crescimento proporcional de energia, mas essa relação enfraqueceu. Os projetistas passaram a focar em CPUs multicore, GPUs, unidades tensor, chiplets, encapsulamento avançado e aceleradores específicos de domínio.
Essa heterogeneidade está no centro do deep learning. Operações de matriz densa podem ser executadas eficientemente em hardware paralelo, enquanto as CPUs coordenam lógica irregular e movimentação de dados. O componente mais rápido não ajuda se o pipeline não puder mantê-lo abastecido.
Memória, precisão e algoritmos
Treinamento e inferência movem repetidamente pesos, ativações e dados de cache através de uma hierarquia de memória on-chip e off-chip. Largura de banda, capacidade, localidade e comunicação podem dominar o custo. Precisão numérica mais baixa e quantização reduzem o movimento quando a qualidade permanece aceitável.
Melhorias algorítmicas podem reduzir o cálculo necessário para alcançar um resultado‑alvo. Modelos esparsos, métodos de eficiência de transformer, otimizadores melhores e dados de maior qualidade afetam todo o progresso efetivo que os usuários experimentam.
Como comparar hardware de IA
Operações de pico por segundo são teóricas. Use um modelo representativo, tamanho de lote, comprimento de sequência, precisão, pilha de software e limiar de qualidade. Relate latência de ponta a ponta, taxa de transferência, energia, uso de memória, utilização e custo.
Sistemas de borda podem valorizar privacidade e baixo consumo mais do que a taxa de transferência máxima; data centers podem priorizar o total de tokens ou amostras por watt. Edge AI deixa claro por que um único número principal não pode descrever todos os sistemas úteis.
Por que a escalada dos semicondutores mudou
O progresso inicial dos circuitos integrados combinou dispositivos menores, fabricação melhor, custo menor por componente e aprimoramentos de design. Por anos, a redução das dimensões dos transistores também sustentou comutação mais rápida e menor energia por operação. Eventualmente, vazamento, limites de tensão, densidade de calor, atraso de interconexão e custo de fabricação enfraqueceram a relação simples entre um novo nó de processo e núcleos de uso geral mais rápidos.
O progresso moderno, portanto, é multidimensional. Dispositivos FinFET e gate‑all‑around melhoram o controle eletrostático; litografia de ultra‑violeta extremo suporta padrões menores; chiplets permitem que projetistas combinem die fabricados em processos diferentes; encapsulamento avançado coloca computação e memória mais próximas. Rendimento e encapsulamento determinam se um design tecnicamente impressionante é econômico em volume.
A desaceleração de um mecanismo de escalada não significa que o hardware deixou de melhorar. Significa que os arquitetos precisam usar os transistores de forma mais deliberada. Unidades especializadas trocam flexibilidade por taxa de transferência ou eficiência em cargas de trabalho selecionadas, enquanto caches maiores e interconexões tentam manter essas unidades abastecidas.
Como as cargas de trabalho de IA pressionam o hardware
O treinamento alterna computação forward, retropropagação, atualizações de otimizador e comunicação entre aceleradores. A inferência varia de pontuação em lote a geração interativa de tokens. A multiplicação de matrizes é importante, mas embeddings, normalização, funções de ativação, atenção, roteamento, acesso a cache e orquestração do host também contribuem para o desempenho real.
A intensidade aritmética — a quantidade de cálculo realizada por byte movimentado — ajuda a explicar se uma carga de trabalho é limitada por computação ou por largura de banda. Tamanhos de lote pequenos e decodificação autorregressiva frequentemente deixam as unidades aritméticas subutilizadas porque pesos ou dados de cache precisam ser buscados repetidamente. Lotes maiores melhoram a utilização, mas aumentam a latência e a memória.
O formato numérico altera o trade‑off. FP32, BF16, FP16, FP8 e formatos inteiros diferem em alcance, precisão, suporte de hardware e erro. Treinamento de precisão mista preserva operações sensíveis em precisão mais alta; inferência quantizada requer calibração e teste de qualidade, em vez de uma promessa de que todo modelo tolera a mesma largura de bits.
Economia de sistemas e direções futuras
O custo total da IA inclui compra ou aluguel de aceleradores, fornecimento de energia, refrigeração, rede, armazenamento, engenharia de software, capacidade ociosa e experimentos fracassados. Um chip mais rápido pode custar mais no total se a utilização for baixa ou se o modelo exigir uma topologia distribuída cara. Meça a produção útil em um limiar de qualidade definido.
A escalada também é limitada por dados e algoritmos. Mais computação não pode corrigir dados rotulados incorretamente ou uma avaliação que recompensa atalhos. Atenção eficiente, otimizadores melhores, esparsidade, recuperação, destilação e descobertas algorítmicas podem melhorar os resultados sem um aumento proporcional de hardware, embora possam deslocar custos para outros lugares.
Sistemas futuros combinarão avanços de processo com empilhamento tridimensional, memória de alta largura de banda, interconexões ópticas ou elétricas avançadas, fluxo de dados específico de domínio e software co‑projetado. A Lei de Moore continua sendo um contexto histórico valioso, mas o planejamento deve usar curvas de carga de trabalho mensuradas e restrições realistas de fornecimento, energia e implantação.
Lendo a Lei de Moore corretamente no design de um sistema de IA
Uma análise útil separa densidade de transistores, desempenho de CPU de uso geral, taxa de transferência de aceleradores, capacidade de memória, largura de banda de memória, interconexão, energia, rendimento de fabricação e custo. Esses fatores não melhoram à mesma taxa. Uma carga de trabalho de IA dominada pela movimentação de pesos de modelo pode ganhar pouco com mais unidades aritméticas, enquanto um modelo pequeno on‑chip pode se beneficiar substancialmente de hardware especializado de baixa precisão. Cite a métrica exata, a precisão, a carga de trabalho e o envelope de energia em vez de tratar um nó de processo como desempenho.
Escalar um modelo de IA também altera as demandas de software e sistema. Execuções de treinamento maiores precisam de algoritmos paralelos, checkpointing confiável, rede de alta velocidade, pipelines de armazenamento e dados suficientes para usar a capacidade adicional. Na inferência, a latência depende do comprimento do prompt, dos tokens gerados, do lote, da memória cache e dos objetivos de nível de serviço. Melhorias algorítmicas, esparsidade, quantização, recuperação e dados melhores podem gerar ganhos independentes das tendências de transistores e, às vezes, superar uma geração de hardware.
Para planejamento, faça benchmark de modelos representativos em sistemas candidatos e modele o custo total ao longo da vida de implantação: preço de aquisição ou nuvem, energia, refrigeração, utilização, engenharia, migração e risco de fornecimento. Use cenários em vez de uma única previsão exponencial. A Lei de Moore continua sendo uma observação histórica valiosa sobre a economia da integração, mas não garante que a IA se torne proporcionalmente mais rápida, barata, capaz ou sustentável em um cronograma fixo.
Checklist de implementação prática
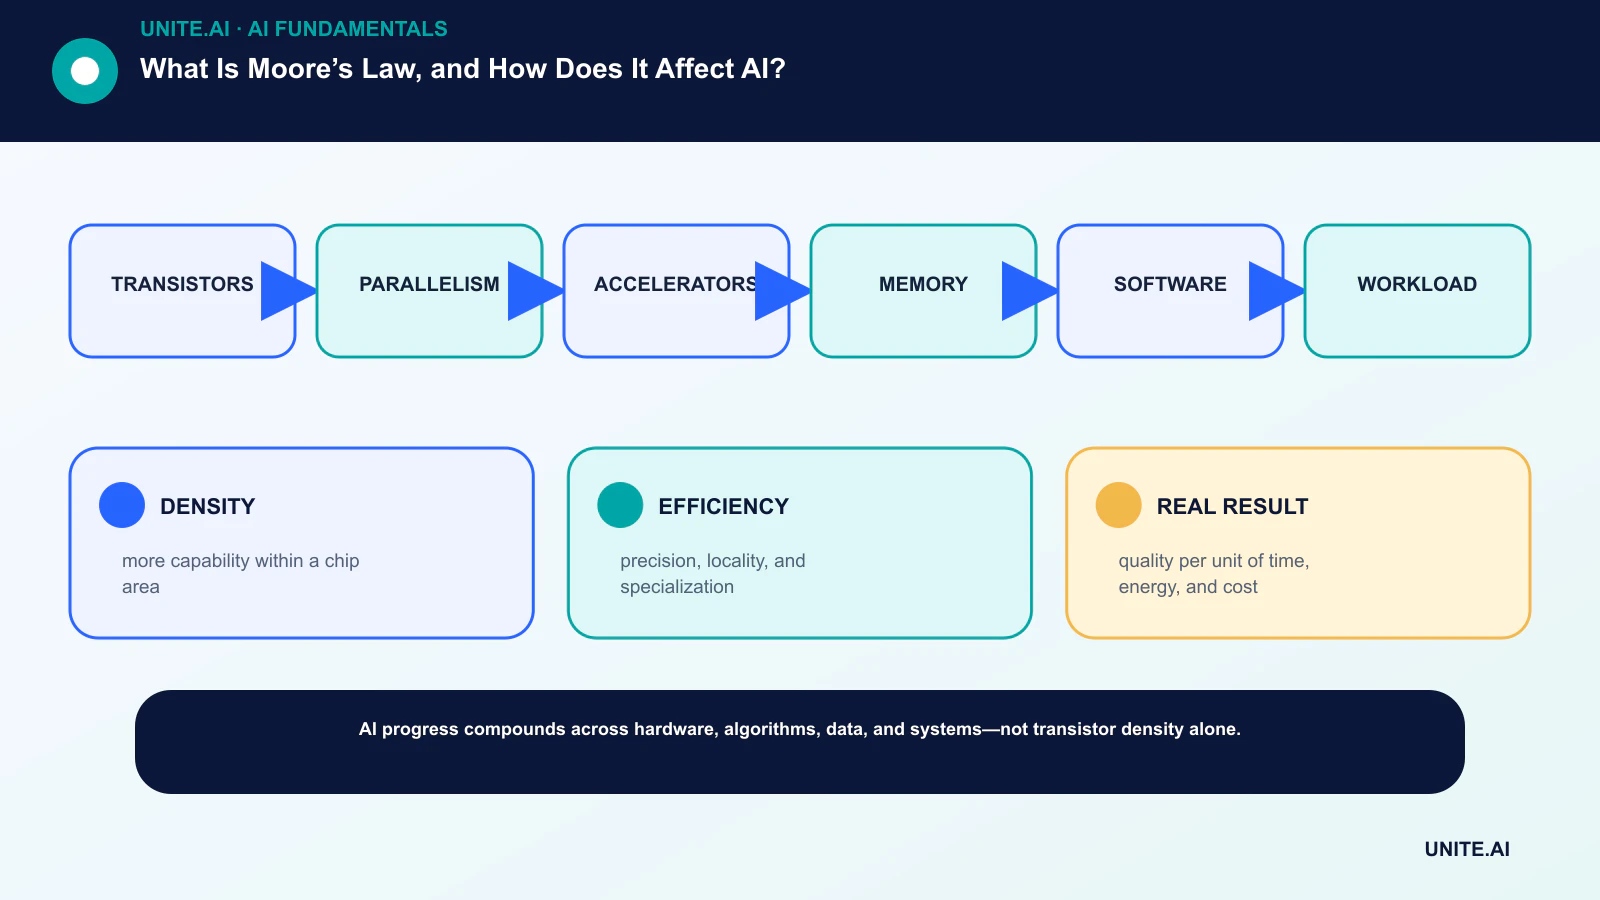
Transforme o conceito em um fluxo de trabalho delimitado e testável: transistores → paralelismo → aceleradores → memória → software → carga de trabalho. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e de parada, teste falhas representativas e defina monitoramento, reversão e revisão antes de expandir o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, execute uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e os riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limiar, sobrescrever um resultado ou interromper a operação. Revise a decisão após a chegada de dados do mundo real, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- DENSITY: mais capacidade dentro de uma área de chip.
- EFFICIENCY: precisão, localidade e especialização.
- REAL RESULT: qualidade por unidade de tempo, energia e custo.
Perguntas frequentes
A Lei de Moore acabou?
A tendência histórica simples desacelerou e mudou de caráter, mas o progresso dos semicondutores continua por meio de dispositivos, arquitetura, encapsulamento, memória e software. Se a expressão ainda se aplica depende da métrica.
Duas vezes mais transistores significam duas vezes o desempenho de IA?
Não. O desempenho depende de como os transistores são usados e da largura de banda, precisão, estrutura do modelo, eficiência do software, energia e restrições da carga de trabalho.
Referências principais