Fundamentos de IA
O que é um NPU? Unidades de Processamento Neural explicadas

 Adicione Unite.AI às suas fontes preferidas no Google
Uma unidade de processamento neural (NPU) é um acelerador especializado projetado para executar operações comuns de redes neurais de forma eficiente. Em telefones, PCs, veículos, câmeras e sistemas embarcados, ela pode executar cargas de trabalho de IA suportadas com menor consumo de energia ou liberar a CPU e a GPU para outras tarefas.
NPU é um termo amplo da indústria, e não uma arquitetura universal. O desempenho depende dos operadores suportados, formatos numéricos, memória, compilador e tempo de execução, limites térmicos e de quanto da aplicação pode permanecer no acelerador.
Principais pontos
- NPUs enfatizam operações de matriz, vetor e tensor com alto reuso de dados e baixo consumo de energia.
- O pico de TOPS não é um benchmark de aplicação de ponta a ponta e pode assumir uma precisão ou esparsidade específicas.
- Um modelo pode precisar de conversão, quantização, particionamento de grafo e fallback para operações não suportadas.
- Compare latência, taxa de transferência, energia, memória, qualidade, privacidade e portabilidade na carga de trabalho real.
Papéis da CPU, GPU e NPU
CPUs se destacam no controle geral de fluxo e ampla compatibilidade. GPUs fornecem paralelismo programável e grandes ecossistemas de software. NPUs especializam‑se em operações de tensor repetidas e podem incluir memória local, arrays de multiplicação‑acumulação e fluxo de dados otimizado para inferência.
Sistemas heterogêneos agendam diferentes partes onde elas se encaixam melhor. Isso é importante para edge AI, onde potência sustentada e capacidade de resposta podem ser mais relevantes que o pico de taxa de transferência de data centers.
Compilação e execução de modelo
Um grafo de framework é convertido em uma representação intermediária, otimizado, quantizado quando apropriado e compilado para os operadores suportados. O tempo de execução pode particionar o grafo para que camadas não suportadas sejam executadas na CPU ou GPU.
Transferências entre processadores podem apagar os ganhos do acelerador. Formatos estáticos, layout, precisão, lote e reutilização de memória influenciam o desempenho. Teste o artefato compilado porque a qualidade do modelo de deep-learning pode mudar após a conversão.
Entendendo TOPS e alegações de eficiência
TOPS reporta trilhões de operações por segundo sob suposições definidas. Vendedores podem contar multiplicação e adição separadamente, usar precisão de inteiro de baixa bits ou assumir esparsidade. Um número maior não garante menor latência para um modelo específico.
Meça início a frio e quente, latência por consulta, taxa de transferência, energia, memória de pico, throttling térmico, tamanho de contexto ou imagem suportado, e a fração do grafo acelerada. Use precisão equivalente e versões de software.
Compromissos da IA no dispositivo
A execução local pode reduzir a dependência de rede e manter entradas brutas no dispositivo, mas modelos baixados, logs, backups e fallback para a nuvem ainda criam fluxos de dados. A entrega segura de modelos e atualizações de plataforma continuam necessárias.
NPUs podem suportar aplicações de visão, áudio, linguagem e sensores, incluindo cargas de trabalho adjacentes ao TinyML. Desenvolvedores devem projetar fallback elegante e comunicar quando o processamento sai do dispositivo.
Arquitetura de NPU e operações suportadas
Um NPU acelera operações de tensor usando arrays de unidades de multiplicação‑acumulação, memória local, agendamento de fluxo de dados e formatos numéricos especializados. Manter pesos e ativações próximos ao cálculo reduz movimentação de dados custosa. Dispositivos reais diferem em suporte a operadores, hierarquia de memória, precisão, esparsidade, programabilidade e como o trabalho é compartilhado com CPU e GPU.
O desempenho máximo costuma ser anunciado em TOPS, mas TOPS não especifica precisão, utilização, limites de memória, cobertura de operadores ou latência de ponta a ponta. Dois processadores com o mesmo número de destaque podem ter desempenho diferente no mesmo modelo. Avalie o modelo compilado, tamanhos realistas de lote e sequência, pré‑processamento, transferências e modo de energia.
NPUs são eficazes para cargas de trabalho neurais suportadas como visão, fala, denoising, efeitos de fundo e modelos de linguagem compactos. Operadores não suportados podem recair para CPU ou GPU, criando transferências e latência imprevisível. Inspecione relatórios do compilador e rastros de tempo de execução para confirmar o posicionamento ao invés de assumir que todo o grafo usa o acelerador.
Conversão, quantização e implantação de modelo
A implantação geralmente segue do framework de treinamento através de exportação, otimização de grafo, quantização, compilação do fornecedor e integração de tempo de execução. Formatos estáticos e operadores comuns são mais fáceis de acelerar. Fluxo de controle dinâmico, kernels personalizados, tensores intermediários grandes e normalização ou padrões de atenção não suportados podem exigir mudanças no grafo ou execução híbrida.
Formatos inteiros e de baixa precisão reduzem tamanho do modelo, largura de banda, energia e latência, mas os dados de calibração devem representar entradas reais. Compare quantização pós‑treinamento com treinamento consciente de quantização quando a qualidade for sensível. Avalie comportamento por classe e pior caso, pois a acurácia média pode esconder degradação em casos raros ou críticos de segurança.
A inferência no dispositivo melhora latência, operação offline e privacidade ao limitar transferência de dados, mas o dispositivo ainda precisa de modelos seguros, acesso a dados consciente de permissões e mecanismos de atualização. Proteja arquivos de modelo quando apropriado, assine atualizações, divulgue fallback para nuvem e assegure que a telemetria não reintroduza a exposição de privacidade que a arquitetura local pretendia reduzir.
Avaliação de desempenho e trade‑offs a nível de sistema
Meça latência de inicialização a frio e em estado estável, taxa de transferência, energia por inferência, memória, comportamento térmico, acurácia e impacto na bateria. Testes longos revelam throttling que benchmarks curtos perdem. Inclua pré‑processamento e pós‑processamento porque redimensionamento, tokenização, decodificação ou cópias de dados podem dominar um acelerador aparentemente rápido.
O agendamento é um problema de sistema. A CPU gerencia a lógica da aplicação, a GPU pode renderizar ou executar camadas não suportadas, e a NPU executa grafos compatíveis. Câmera, áudio, display e cargas de IA concorrentes competem por largura de banda de memória e energia. Teste o cenário completo do usuário ao invés de um modelo isolado em ferramenta do fornecedor.
A portabilidade permanece limitada entre compiladores e tempos de execução. Prefira representações de modelo padrão onde funcionam, isole código específico do fornecedor atrás de interfaces, preserve saídas de referência e mantenha cobertura de testes em dispositivos. Escolha hardware baseado em cargas de trabalho validadas, suporte de software, horizonte de atualizações e custo total do sistema — não em uma única especificação de acelerador.
Exemplo prático: implantando um modelo de visão em um laptop com NPU
Uma equipe treina um modelo de segmentação para efeitos de fundo, exporta‑o para um formato de intercâmbio suportado, substitui operadores não suportados e calibra a quantização inteira com câmeras representativas, iluminação, tons de pele, vestuário e fundos. O compilador do fornecedor relata quais nós rodam na NPU e quais recuam. A equipe trata qualquer recuo como custo de sistema, pois transferências de tensor podem dominar um kernel individual rápido.
A medição de benchmark inclui pré‑processamento da câmera, execução do modelo, composição, memória, inicialização a frio, latência em estado estável, estabilidade de quadros, energia e throttling térmico durante uma chamada de vídeo real. Os resultados são comparados com caminhos de CPU e GPU com qualidade de saída equivalente. A aplicação usa detecção de capacidade e fallback testado ao invés de assumir que o acelerador existe ou suporta o mesmo grafo após atualização de driver.
Os testes de liberação cobrem modelos de dispositivos, versões de sistema operacional e driver, cargas de trabalho concorrentes, modos de bateria e entradas malformadas. Pacotes de modelo são assinados e versionados; a telemetria registra desempenho e falhas sem coletar vídeo desnecessário. O produto explica quando o processamento permanece no dispositivo e quando recursos de nuvem são usados. O NPU ganha seu lugar ao melhorar a experiência completa sob restrições realistas, não ao alcançar um benchmark isolado de TOPS ou kernel.
Lista de verificação de implementação prática
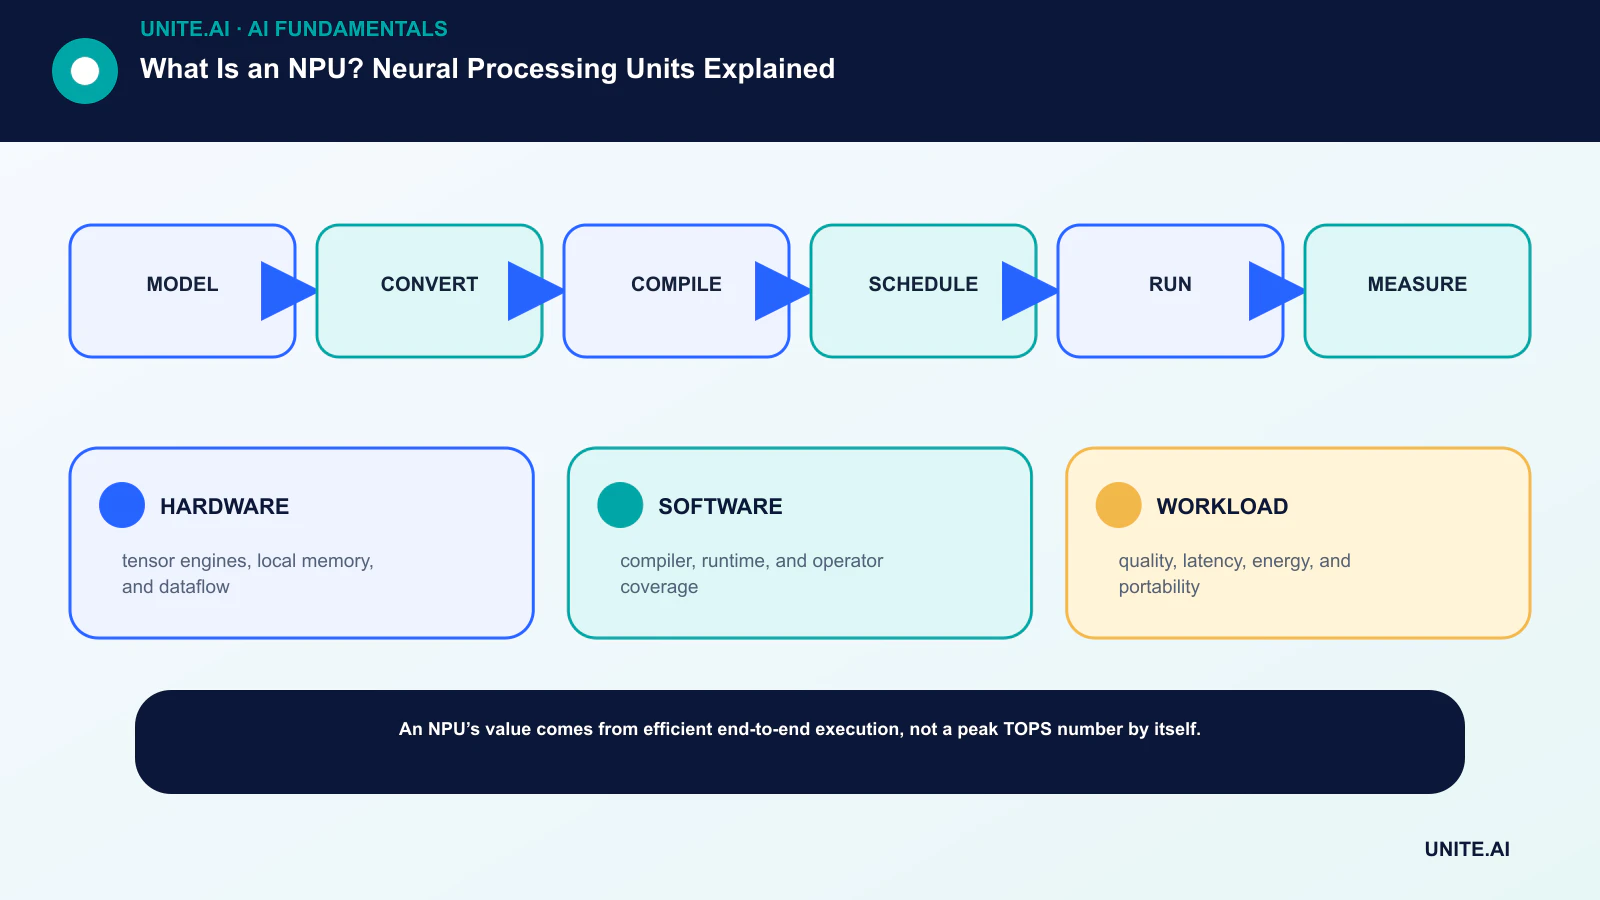
Transforme o conceito em um fluxo de trabalho delimitado e testável: modelo → converter → compilar → agendar → executar → medir. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e parada, teste falhas representativas e defina monitoramento, rollback e revisão antes de expandir o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, realize uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar o lançamento, mudar um limiar, sobrescrever uma saída ou interromper a operação. Revise a decisão após a chegada de dados do mundo real, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- HARDWARE: motores de tensor, memória local e fluxo de dados.
- SOFTWARE: compilador, tempo de execução e cobertura de operadores.
- WORKLOAD: qualidade, latência, energia e portabilidade.
Perguntas frequentes
Um NPU é mais rápido que uma GPU?
Depende do modelo, da precisão, do suporte a operadores, do tamanho do lote, do limite de energia e do software. Um NPU pode ser mais eficiente para uma carga de trabalho suportada no dispositivo, enquanto uma GPU pode ser mais rápida ou mais flexível em outros cenários.
Um NPU mantém todos os dados de IA privados?
Não. Ele permite o processamento local, mas a aplicação ainda pode enviar dados ou resultados para serviços de nuvem. A privacidade depende da arquitetura completa e da política.
Referências principais