
Podstawy AI
Czym jest NPU? Jednostki przetwarzania neuronowego wyjaśnione

 Dodaj Unite.AI do preferowanych źródeł w Google
Jednostka przetwarzania neuronowego (NPU) jest specjalizowanym akceleratorem zaprojektowanym do wydajnego wykonywania typowych operacji sieci neuronowych. W telefonach, komputerach, pojazdach, aparatach i systemach wbudowanych może uruchamiać obsługiwane obciążenia AI przy niższym zużyciu energii lub odciążać CPU i GPU dla innych zadań.
NPU jest szerokim terminem branżowym, a nie jedną uniwersalną architekturą. Wydajność zależy od obsługiwanych operatorów, formatów liczbowych, pamięci, kompilatora i środowiska uruchomieniowego, ograniczeń termicznych oraz tego, jak duża część aplikacji może pozostać na akceleratorze.
Kluczowe wnioski
- NPU koncentrują się na operacjach macierzowych, wektorowych i tensorowych, charakteryzujących się wysokim ponownym wykorzystaniem danych i niskim zużyciem energii.
- Maksymalna liczba TOPS nie jest benchmarkiem aplikacji end‑to‑end i może zakładać określoną precyzję lub rzadkość.
- Model może wymagać konwersji, kwantyzacji, podziału grafu oraz awaryjnego uruchomienia nieobsługiwanych operacji.
- Porównaj opóźnienie, przepustowość, zużycie energii, pamięć, jakość, prywatność i przenośność na rzeczywistym obciążeniu.
Rola CPU, GPU i NPU
CPU doskonale radzą sobie z ogólnym przepływem sterowania i szeroką kompatybilnością. GPU zapewniają programowalną równoległą przepustowość oraz rozbudowane ekosystemy oprogramowania. NPU specjalizują się w powtarzalnych operacjach tensorowych i mogą zawierać pamięć lokalną, tablice mnożenia‑akumulacji oraz przepływ danych zoptymalizowany pod kątem wnioskowania.
Systemy heterogeniczne przydzielają różne części tam, gdzie pasują najlepiej. Ma to znaczenie w edge AI, gdzie stała moc i responsywność mogą być ważniejsze niż szczytowa przepustowość w centrach danych.
Kompilacja i wykonywanie modelu
Graf frameworku jest konwertowany do reprezentacji pośredniej, optymalizowany, kwantowany w miarę potrzeb i kompilowany pod obsługiwane operatory. Środowisko uruchomieniowe może podzielić graf, aby nieobsługiwane warstwy wykonywały się na CPU lub GPU.
Transfery między procesorami mogą niwelować zyski akceleratora. Statyczne kształty, układ, precyzja, batchowanie i ponowne wykorzystanie pamięci wpływają na wydajność. Przetestuj skompilowany artefakt, ponieważ jakość modelu deep‑learning może ulec zmianie po konwersji.
Zrozumienie TOPS i roszczeń dotyczących efektywności
TOPS podaje liczbę bilionów operacji na sekundę przy określonych założeniach. Dostawcy mogą liczyć mnożenie i dodawanie osobno, używać niskobitowej precyzji całkowitej lub zakładać rzadkość. Wyższa liczba nie gwarantuje niższego opóźnienia dla konkretnego modelu.
Mierz czasy uruchomienia na zimno i na gorąco, opóźnienie na zapytanie, przepustowość, zużycie energii, maksymalną pamięć, throttling termiczny, obsługiwany kontekst lub rozmiar obrazu oraz udział przyspieszonej części grafu. Używaj równoważnej dokładności i wersji oprogramowania.
Kompromisy w AI na urządzeniu
Lokalne wykonywanie może zmniejszyć zależność od sieci i utrzymać surowe dane wejściowe na urządzeniu, ale pobrane modele, logi, kopie zapasowe i awaryjne rozwiązania w chmurze wciąż generują przepływy danych. Bezpieczna dostawa modeli i aktualizacje platformy pozostają niezbędne.
NPU mogą obsługiwać aplikacje wizyjne, dźwiękowe, językowe i czujnikowe, w tym obciążenia powiązane z TinyML. Programiści powinni projektować eleganckie rozwiązania awaryjne i informować, kiedy przetwarzanie opuszcza urządzenie.
Architektura NPU i obsługiwane operacje
NPU przyspiesza operacje tensorowe, wykorzystując tablice jednostek mnożenie‑akumulacja, pamięć lokalną, harmonogramowanie przepływu danych oraz specjalistyczne formaty liczbowe. Trzymanie wag i aktywacji blisko jednostek obliczeniowych zmniejsza kosztowne przemieszczanie danych. Rzeczywiste urządzenia różnią się pod względem obsługi operatorów, hierarchii pamięci, precyzji, rzadkości, programowalności oraz sposobu współdzielenia pracy z CPU i GPU.
Maksymalna wydajność jest często reklamowana w TOPS, ale TOPS nie określa precyzji, wykorzystania, limitów pamięci, zakresu operatorów ani opóźnienia end‑to‑end. Dwa procesory o tej samej liczbie w nagłówku mogą zachowywać się różnie na tym samym modelu. Przeprowadź benchmark skompilowanego modelu, realistycznych rozmiarów batch i sekwencji, preprocessing, transferów oraz trybu zasilania.
NPU są skuteczne w obsługiwanych obciążeniach neuronowych, takich jak wizja, mowa, odszumianie, efekty tła i kompaktowe modele językowe. Nieobsługiwane operatory mogą przechodzić na CPU lub GPU, powodując transfery i nieprzewidywalne opóźnienia. Sprawdź raporty kompilatora i ślady runtime, aby potwierdzić rozmieszczenie, zamiast zakładać, że cały graf korzysta z akceleratora.
Konwersja modelu, kwantyzacja i wdrożenie
Wdrożenie zazwyczaj przechodzi od frameworku treningowego przez eksport, optymalizację grafu, kwantyzację, kompilację dostawcy i integrację runtime. Statyczne kształty i powszechne operatory są najłatwiejsze do przyspieszenia. Dynamiczny przepływ sterowania, własne jądra, duże tensory pośrednie oraz nieobsługiwane wzorce normalizacji lub uwagi mogą wymagać zmian w grafie lub hybrydowego wykonywania.
Formaty całkowite i o niższej precyzji zmniejszają rozmiar modelu, przepustowość, zużycie energii i opóźnienie, ale dane kalibracyjne muszą odzwierciedlać rzeczywiste wejścia. Porównaj kwantyzację po treningu z treningiem świadomym kwantyzacji, gdy jakość jest wrażliwa. Oceń zachowanie per‑klasa i w najgorszym przypadku, ponieważ średnia dokładność może ukrywać degradację w rzadkich lub krytycznych pod względem bezpieczeństwa przypadkach.
Wnioskowanie na urządzeniu poprawia opóźnienie, działanie offline i prywatność poprzez ograniczenie transferu danych, ale urządzenie nadal potrzebuje bezpiecznych modeli, dostępu do danych z uwzględnieniem uprawnień oraz mechanizmów aktualizacji. Chroń pliki modeli w odpowiednich miejscach, podpisuj aktualizacje, ujawniaj awaryjne rozwiązania w chmurze i zapewnij, że telemetryka nie przywraca wycieku prywatności, którego lokalna architektura miała zapobiec.
Ocena wydajności i kompromisy na poziomie systemu
Mierz opóźnienie przy uruchomieniu na zimno i w stanie ustalonym, przepustowość, zużycie energii na inferencję, pamięć, zachowanie termiczne, dokładność oraz wpływ na baterię. Długie testy ujawniają throttling, którego krótkie benchmarki nie wykrywają. Uwzględnij preprocessing i postprocessing, ponieważ zmiana rozmiaru, tokenizacja, dekodowanie lub kopiowanie danych mogą dominować przy otherwise szybkim akceleratorze.
Planowanie to problem systemowy. CPU zarządza logiką aplikacji, GPU może renderować lub wykonywać nieobsługiwane warstwy, a NPU uruchamia kompatybilne grafy. Równoczesne obciążenia kamery, dźwięku, wyświetlacza i AI konkurują o przepustowość pamięci i moc. Testuj kompletny scenariusz użytkownika, a nie izolowany model w narzędziu dostawcy.
Przenośność pozostaje ograniczona między kompilatorami i środowiskami uruchomieniowymi. Preferuj standardowe reprezentacje modeli tam, gdzie działają, izoluj kod specyficzny dla dostawcy za pośrednictwem interfejsów, zachowuj wyniki referencyjne i utrzymuj pokrycie testami urządzeń. Wybieraj sprzęt na podstawie zweryfikowanych obciążeń, wsparcia oprogramowania, perspektywy aktualizacji i całkowitego kosztu systemu — nie na podstawie jednej specyfikacji akceleratora.
Przykład praktyczny: wdrożenie modelu wizyjnego na laptopie z NPU
Zespół trenuje model segmentacji do efektów tła, eksportuje go do obsługiwanego formatu wymiany, zastępuje nieobsługiwane operatory i kalibruje kwantyzację całkowitą przy użyciu reprezentatywnych kamer, oświetlenia, odcieni skóry, ubrań i tła. Kompilator dostawcy raportuje, które węzły działają na NPU, a które przechodzą w tryb awaryjny. Zespół traktuje każde przejście na fallback jako koszt systemowy, ponieważ transfery tensorów mogą zdominować szybkie pojedyncze jądro.
Benchmarking mierzy preprocessing kamery, wykonanie modelu, kompozycję, pamięć, uruchomienie na zimno, opóźnienie w stanie ustalonym, stabilność klatek, moc i throttling termiczny podczas rzeczywistej rozmowy wideo. Wyniki są porównywane z ścieżkami CPU i GPU przy równej jakości wyjścia. Aplikacja wykorzystuje wykrywanie możliwości i przetestowany fallback, zamiast zakładać, że akcelerator istnieje lub obsługuje ten sam graf po aktualizacji sterownika.
Testy wydania obejmują modele urządzeń, wersje systemu operacyjnego i sterowników, równoczesne obciążenia, tryby baterii oraz nieprawidłowe dane wejściowe. Pakiety modeli są podpisane i wersjonowane; telemetryka rejestruje wydajność i awarie bez zbierania niepotrzebnego wideo. Produkt wyjaśnia, kiedy przetwarzanie pozostaje na urządzeniu, a kiedy wykorzystywane są funkcje w chmurze. NPU zasługuje na miejsce, poprawiając całe doświadczenie w realistycznych warunkach, a nie osiągając jedynie izolowany benchmark TOPS lub jądra.
Praktyczna lista kontrolna wdrożenia
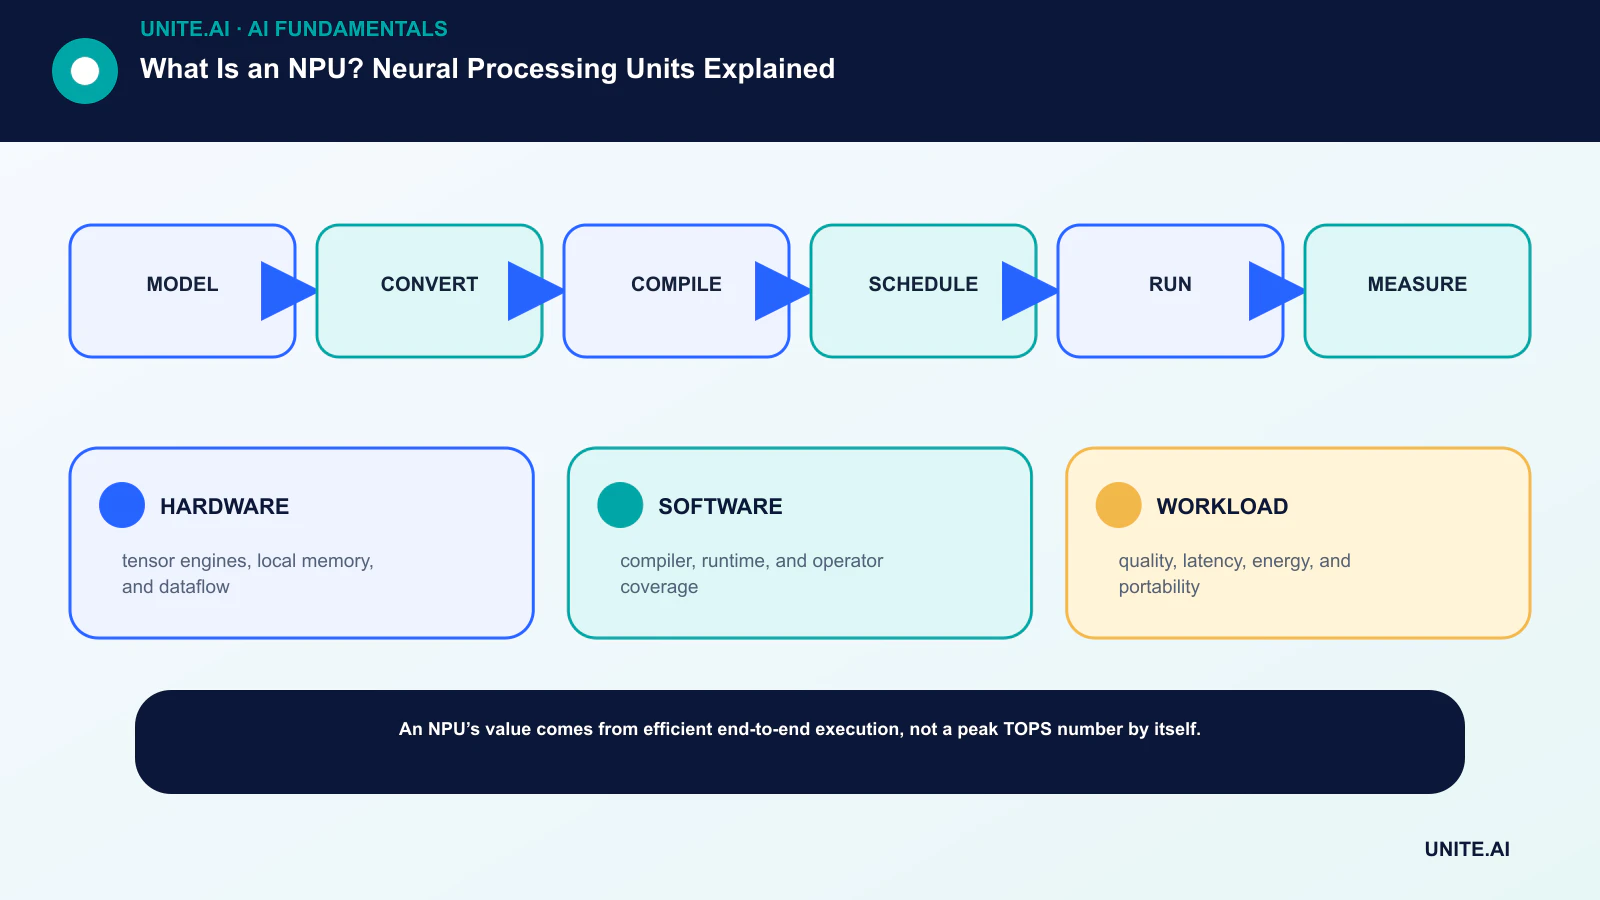
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: model → konwersja → kompilacja → planowanie → uruchomienie → pomiar. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę odniesienia, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, przywracanie i przegląd przed rozszerzeniem zakresu. Zapisz wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowany przegląd gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie przeanalizuj decyzję po otrzymaniu danych z rzeczywistości, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności na szerszą skalę.
- HARDWARE: silniki tensorowe, pamięć lokalna i przepływ danych.
- SOFTWARE: kompilator, runtime i zakres operatorów.
- WORKLOAD: jakość, opóźnienie, energia i przenośność.
Najczęściej zadawane pytania
Czy NPU jest szybszy niż GPU?
To zależy od modelu, precyzji, wsparcia operatorów, rozmiaru batch, limitu mocy i oprogramowania. NPU może być bardziej efektywne przy obsługiwanym obciążeniu na urządzeniu, podczas gdy GPU jest szybsze lub bardziej elastyczne w innych przypadkach.
Czy NPU zapewnia pełną prywatność danych AI?
Nie. Umożliwia przetwarzanie lokalne, ale aplikacja nadal może wysyłać dane lub wyniki do usług w chmurze. Prywatność zależy od pełnej architektury i polityki.
Podstawowe źródła












