
Podstawy AI
Czym jest TinyML? Uczenie maszynowe na mikrokontrolerach

 Dodaj Unite.AI do preferowanych źródeł w Google
TinyML przenosi wnioskowanie uczenia maszynowego na wysoce ograniczone urządzenia, takie jak mikrokontrolery, małe procesory sygnałowe oraz czujniki o niskim poborze energii. Systemy te mogą dysponować kilobajtami lub megabajtami pamięci, ścisłymi limitami energetycznymi, brakiem ciągłego połączenia sieciowego oraz terminami w czasie rzeczywistym.
Wartość nie polega jedynie na mniejszym modelu. Przetwarzanie w pobliżu czujnika może zmniejszyć opóźnienia, zużycie pasma i narażenie surowych danych, jednocześnie umożliwiając produkty działające przez długie okresy na bateriach lub energii pozyskiwanej.
Kluczowe wnioski
- TinyML definiuje pełny budżet sprzętowo‑programowy, a nie pojedynczy próg rozmiaru modelu.
- Kwantyzacja, kompaktowe architektury, zoptymalizowane jądra i staranne buforowanie umożliwiają wdrożenie.
- Wnioskowanie na urządzeniu może zwiększyć prywatność, ale nadal istotne są bezpieczne aktualizacje i zarządzanie danymi.
- Należy benchmarkować dokładność wraz z opóźnieniem, maksymalną pamięcią, zużyciem energii, cyklem pracy i odpornością.
Stos TinyML
Czujnik przechwytuje dźwięk, ruch, wibracje, obrazy lub inny sygnał. Oprogramowanie układowe przetwarza go w cechy lub tensory; kompaktowy model działa w osadzonym środowisku wykonawczym; logika aplikacji decyduje, czy uruchomić większy system, czy działać lokalnie.
Jest to ograniczona forma edge AI. Sprzęt może zawierać MCU, pamięć, interfejsy czujników oraz czasami akcelerator neuronowy. Każdy bufor, operator i kopiowanie rywalizują o ograniczone zasoby.
Dopasowanie modelu
Kwantyzacja zastępuje wartości wysokiej precyzji mniejszymi reprezentacjami całkowitymi. Przyciskanie, destylacja, inżynieria cech i poszukiwanie architektury mogą zmniejszyć obliczenia lub pamięć. Wsparcie operatorów w docelowym środowisku wykonawczym ogranicza, które modele są praktyczne.
Trening często odbywa się na większym sprzęcie, po czym model jest konwertowany i kompilowany dla urządzenia. Transfer learning może zmniejszyć zapotrzebowanie na dane, ale ostateczny artefakt musi być oceniony po konwersji, ponieważ zmiany numeryczne mogą wpłynąć na dokładność.
Dane i zmiany środowiskowe
Nagrania laboratoryjne rzadko odzwierciedlają każdy mikrofon, pozycję montażu, temperaturę, wzorzec wibracji, akcent czy warunki tła. Zbieraj dane z reprezentatywnych urządzeń i środowisk, utrzymuj niezależność źródeł treningowych i testowych oraz uwzględniaj przypadki „żadne z powyższych”.
Fałszywe wyzwolenie może marnować energię lub irytować użytkownika; pominięcie anomalii może być kosztowne. Dobieraj progi, uwzględniając rzeczywiste koszty błędów, i monitoruj wydajność w terenie za pomocą podsumowań chroniących prywatność lub próbkowanych diagnostyk, gdy jest to właściwe.
Mierzenie całego urządzenia
Liczba operacji modelu nie równa się wydajności produktu. Raportuj częstotliwość wybudzania, czas przetwarzania wstępnego, opóźnienie wnioskowania, maksymalną pamięć RAM, zużycie flash, średnie i szczytowe zużycie energii, zachowanie termiczne oraz wpływ na baterię przy określonym cyklu pracy.
Planuj podpisane aktualizacje oprogramowania i modelu, przywracanie poprzednich wersji, tożsamość urządzenia oraz reakcję na podatności. Małe urządzenia mogą być używane przez lata, więc możliwość utrzymania jest częścią jakości modelu. Kontrole Cybersecurity nie mogą być odkładane ze względu na mały rozmiar urządzenia.
Budżetowanie pamięci i obliczeń
Flash przechowuje oprogramowanie układowe, wagi modelu i stałe; RAM trzyma bufory czujników, pośrednie aktywacje oraz stan środowiska wykonawczego. Szczytowa pamięć aktywacji może przekraczać rozmiar wag, szczególnie w początkowych warstwach konwolucyjnych. Planery pamięci ponownie wykorzystują bufory, których okresy życia się nie pokrywają, a strumieniowanie cech unika przechowywania całego okna sygnału.
Liczba operacji to wstępne oszacowanie, ale wydajność jądra zależy od kształtu tensora, wyrównania, wsparcia instrukcji i dostępu do pamięci. Konwolucja depthwise może zmniejszyć liczbę operacji, ale działa słabo na sprzęcie bez zoptymalizowanego jądra. Testuj skompilowany model na docelowej płytce, a nie tylko w profilerze stacjonarnym.
Cykle pracy dominują w wielu produktach. Czujnik i MCU mogą spać, wybudzać się na prosty wyzwalacz, uruchamiać mały model i aktywować radio lub większy procesor tylko w razie potrzeby. Mierz cały cykl pracy, włączając czujnik, konwersję, przetwarzanie wstępne, wybudzanie, wnioskowanie, komunikację i wycieki w stanie bezczynności.
Rozwój i konwersja modelu
Zacznij od ograniczeń wdrożeniowych i zbierz reprezentatywne dane z czujników. Przetwarzanie wstępne użyte w treningu musi dokładnie odpowiadać implementacji stałoprzecinkowej lub osadzonej. Różnice w częstotliwości próbkowania, oknach, konwersji kolorów, normalizacji lub ekstrakcji cech mogą spowodować niepowodzenie modelu, nawet gdy konwersja się powiedzie.
Kwantyzacja po treningu kalibruje zakresy na podstawie reprezentatywnych próbek; trening z uwzględnieniem kwantyzacji symuluje niższą precyzję podczas uczenia. Skale wag per‑kanał często lepiej zachowują jakość konwolucji niż jedna skala. Nieobsługiwane operacje mogą być przepisane, przybliżone lub przeniesione do wolniejszego rozwiązania awaryjnego, co wymaga ponownej oceny.
Kompresję należy prowadzić w oparciu o hipotezy. Przycinanie nieustrukturyzowanych wag może nie przyspieszyć gęstego jądra osadzonego; usuwanie kanałów w sposób strukturalny jest łatwiejsze do wykorzystania przez sprzęt. Destylacja przenosi zachowanie z większego nauczyciela, ale może przenieść jego uprzedzenia i błędy. Porównaj z metodami przetwarzania sygnału i progowymi bazami odniesienia.
Zastosowania, testy w terenie i utrzymanie
Typowe zadania TinyML obejmują wykrywanie słów kluczowych, detekcję słowa wybudzającego, rozpoznawanie gestów, wykrywanie anomalii wibracji, monitorowanie obecności, zdarzenia akustyczne oraz prostą wizję. Model może pełnić rolę bramki, a nie ostatecznej decyzji, oszczędzając pasmo, jednocześnie przesyłając niepewne lub ważne przypadki do bardziej zaawansowanego systemu.
Testy w terenie powinny obejmować tolerancje urządzenia, starzenie się czujników, montaż, stan baterii, temperaturę, warunki pogodowe, użytkowników oraz zakłócenia tła. Monitoruj liczbę fałszywych wyzwoleń na godzinę lub pominiętych zdarzeń na cykl pracy, nie tylko zrównoważoną dokładność testu. Próg wybrany w laboratorium może wymagać kalibracji specyficznej dla produktu.
Planuj podpisane aktualizacje over‑the‑air, przywracanie poprzednich wersji, telemetrię wersji modelu oraz długie okresy wsparcia. Jeśli aktualizacje są niemożliwe, używaj konserwatywnych modeli i dokumentuj oczekiwany dryf środowiskowy. Wycofywanie produktu musi unieważnić poświadczenia urządzenia i zająć się przechowywanymi danymi, a nie jedynie przestać sprzedawać produkt.
Przykładowe zastosowanie: monitor wibracji TinyML
Mały akcelerometr zamontowany na silniku pobiera próbki wibracji przy normalnym obciążeniu i znanych warunkach usterek. Urządzenie dzieli sygnał na okna, usuwa offset, oblicza kompaktowe cechy w dziedzinie czasu lub częstotliwości i uruchamia detektor anomalii lub klasyfikator. Częstotliwość próbkowania musi uchwycić istotne częstotliwości łożysk i wału, nie przeciążając pamięci ani energii. Etykiety powinny pochodzić z zweryfikowanych inspekcji, a nie jedynie z alarmu, który sam może być błędny.
Trening odbywa się na stacji roboczej, po czym następuje kwantyzacja, konwersja i kompilacja pod docelowy mikrokontroler. Zmierz rozmiar flash modelu, szczytową pamięć RAM, czas wykonania, zużycie energii i dokładność na fizycznym urządzeniu. Arytmetyka całkowita i dostępność operatorów mogą zmienić wyniki w porównaniu do modelu treningowego. Testuj orientację czujnika, montaż, temperaturę, napięcie, wariacje komponentów oraz rzeczywiste tło wibracji, a nie tylko wyselekcjonowane pliki laboratoryjne.
Wdrożone urządzenie wymaga kalibracji, bezpiecznych aktualizacji oprogramowania, raportowania wersji, zachowania awaryjnego oraz planu na wypadek dryfu. Może przesyłać jedynie wskaźnik stanu zdrowia lub wybrane cechy, aby oszczędzić energię i chronić surowe dane, ale lokalne fałszywe alarmy nadal generują koszty utrzymania. Stosuj progowanie etapowe, wymagaj utrzymania oraz łącz dowody modelu ze stanem operacyjnym. TinyML jest najcenniejsze, gdy lokalne opóźnienia, prywatność, łączność lub ograniczenia energetyczne uzasadniają jego ograniczenia inżynieryjne.
Testy produkcyjne powinny obejmować odzyskiwanie po cyklu zasilania, dryf zegara, odłączenia czujnika, uszkodzone dane wejściowe, wyczerpanie pamięci oraz przerwane aktualizacje. Zdefiniuj, co się stanie, gdy model nie może działać lub spadnie pewność: bezpieczna wartość domyślna, wyraźny wskaźnik błędu lub konwencjonalna reguła mogą być lepsze niż cicha domyślna decyzja. Śledź wersje sprzętu i oprogramowania floty, aby nowo zaobserwowany błąd można było powiązać z wersją urządzenia, środowiskiem lub wydaniem modelu.
Praktyczna lista kontrolna wdrożenia
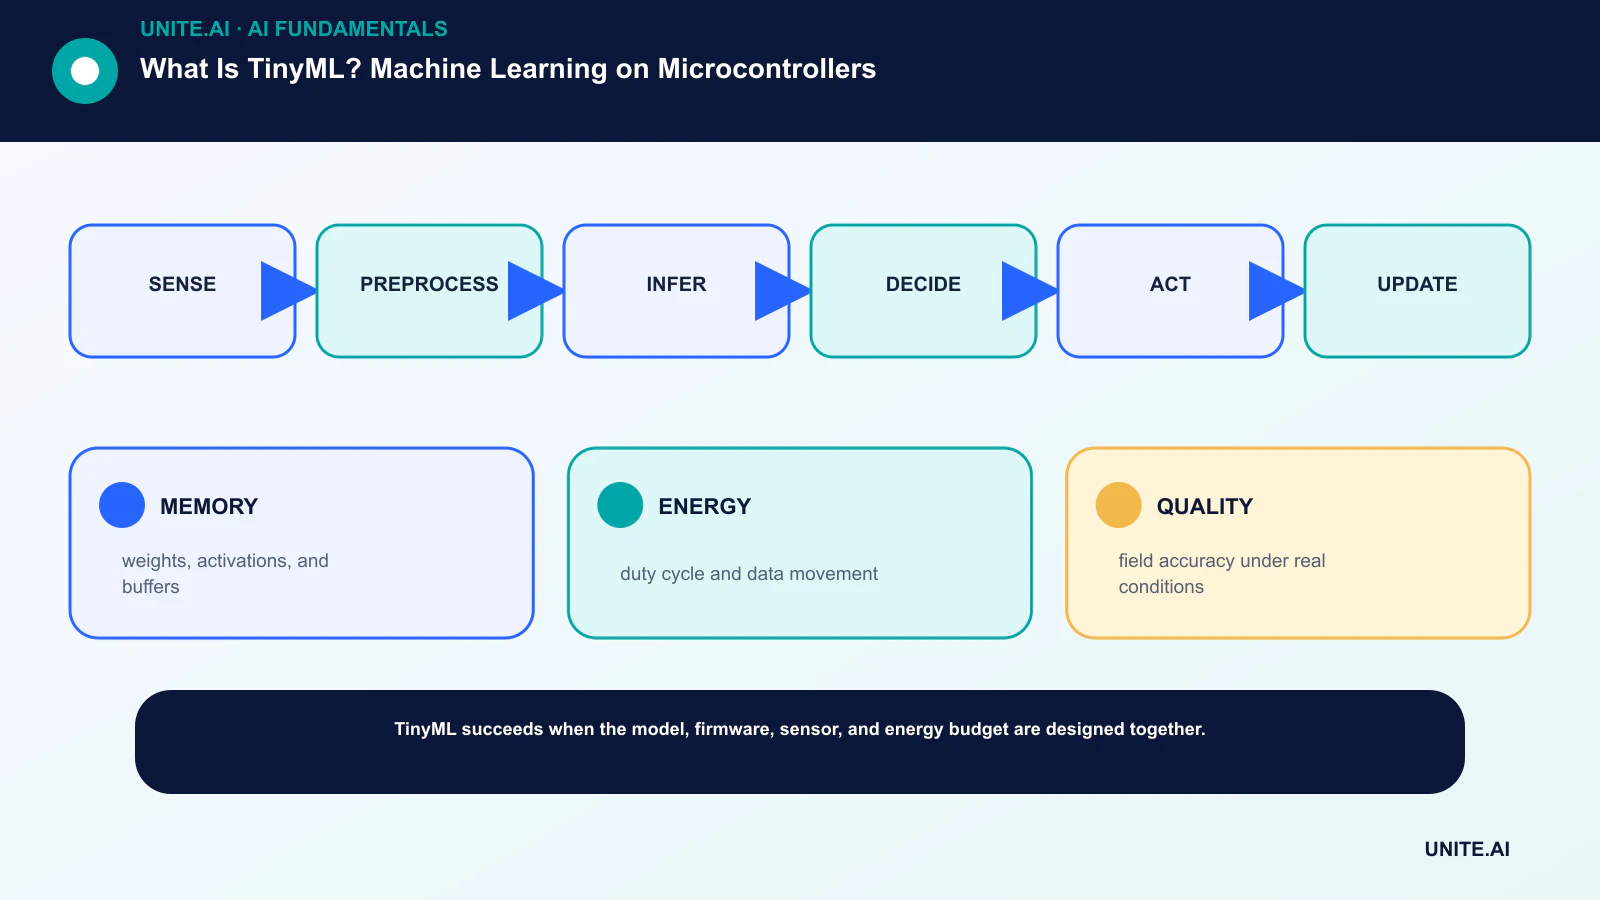
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: wykrywanie → przetwarzanie wstępne → wnioskowanie → decyzja → działanie → aktualizacja. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, przywracanie i przegląd przed rozszerzeniem zakresu. Rejestruj wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowany przegląd gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie oceń decyzję po otrzymaniu danych z rzeczywistości, ponieważ technicznie udany pilot nie gwarantuje niezawodnej wydajności na szerszą skalę.
- PAMIĘĆ: wagi, aktywacje i bufory.
- ENERGIA: cykl pracy i przepływ danych.
- JAKOŚĆ: dokładność w terenie w rzeczywistych warunkach.
Najczęściej zadawane pytania
Czy TinyML jest tym samym co mobilne AI?
Nie do końca. Urządzenia mobilne są systemami brzegowymi z stosunkowo dużymi procesorami i pamięcią. TinyML koncentruje się na znacznie ściślejszych ograniczeniach typowych dla systemów wbudowanych i mikrokontrolerów.
Czy modele TinyML mogą się uczyć na urządzeniu?
Większość wdrożeń trenuje się poza urządzeniem i wykonuje wnioskowanie na nim. Ograniczona adaptacja jest możliwa, ale pamięć, energia, stabilność, prywatność i możliwość przywrócenia poprzedniej wersji utrudniają trening bezpośrednio na urządzeniu.
Podstawowe źródła












