Modele i platformy AI
Co to jest prawo Moore’a i jak wpływa na AI?

 Dodaj Unite.AI do preferowanych źródeł w Google
Prawo Moore’a jest historyczną obserwacją, że ekonomicznie użyteczne układy scalone zyskiwały komponenty w tempie wykładniczym. Nie jest to prawo fizyki i nie stwierdza, że komputery automatycznie stają się dwa razy szybsze według stałego harmonogramu.
W przypadku AI gęstość tranzystorów ma znaczenie, ponieważ umożliwia więcej jednostek arytmetycznych, pamięci i połączeń. Jednak praktyczny postęp zależy także od architektury, precyzji numerycznej, pakowania, przepustowości pamięci, algorytmów, oprogramowania, energii, wydajności produkcji oraz ilości użytecznych danych.
Kluczowe wnioski
- Oryginalny artykuł Moore’a z 1965 roku opisywał trend ekonomiczny i inżynieryjny, a nie fizyczną gwarancję.
- Skalowanie częstotliwości zegara zwolniło; współczesne zyski pochodzą coraz częściej z paralelizmu i wyspecjalizowanych akceleratorów.
- Wydajność AI jest często ograniczana przez przemieszczanie pamięci i energię, a nie samą arytmetykę.
- Porównuj systemy pod względem opóźnienia, przepustowości, jakości, zużycia energii i całkowitego kosztu na poziomie obciążenia, a nie liczbą tranzystorów.
Co Moore naprawdę zaobserwował
Gordon Moore wykreślił liczbę komponentów w wiodących układach scalonych i prognozował dalszy szybki wzrost przy minimalnym koszcie na komponent. Zwykle podsumowano to jako podwajanie się liczby komponentów mniej więcej co dwa lata, choć formułowania i mierzone wielkości się różniły.
Mniejsze cechy mogą zwiększyć gęstość i obniżyć niektóre koszty przełączania, jednak złożoność produkcji i ekonomia decydują, czy trend pozostaje użyteczny. Nazwy węzłów są etykietami marketingowymi, więc nie powinny być traktowane jako bezpośrednie porównanie fizyczne pomiędzy fabrykami.
Od szybszych rdzeni do obliczeń heterogenicznych
Skalowanie napięcia w stylu Dennarda kiedyś pozwalało na wyższe częstotliwości zegara bez proporcjonalnego wzrostu mocy, ale zależność ta osłabła. Projektanci przeszli na wielordzeniowe CPU, GPU, jednostki tensorowe, chiplety, zaawansowane pakowanie i akceleratory specyficzne dla domeny.
Ta heterogeniczność jest kluczowa dla głębokiego uczenia. Gęste operacje macierzowe mogą być wydajnie wykonywane na sprzęcie równoległym, podczas gdy CPU koordynują nieregularną logikę i przemieszczanie danych. Najszybszy komponent nie pomaga, jeśli potok nie może go odpowiednio zasilić.
Pamięć, precyzja i algorytmy
Podczas treningu i inferencji wagi, aktywacje i dane pamięci podręcznej są wielokrotnie przenoszone przez hierarchię pamięci na chipie i poza nim. Przepustowość, pojemność, lokalność i komunikacja mogą dominować koszty. Niższa precyzja numeryczna i kwantyzacja zmniejszają przemieszczanie, gdy jakość pozostaje akceptowalna.
Ulepszenia algorytmiczne mogą obniżyć wymaganą moc obliczeniową do osiągnięcia określonego wyniku. Modele rzadkie, metody zwiększające wydajność transformerów, lepsze optymalizatory i wyższej jakości dane wpływają na rzeczywisty postęp, jaki odczuwają użytkownicy.
Jak porównywać sprzęt AI
Maksymalna liczba operacji na sekundę jest teoretyczna. Użyj reprezentatywnego modelu, rozmiaru wsadu, długości sekwencji, precyzji, stosu oprogramowania i progu jakości. Raportuj opóźnienie end‑to‑end, przepustowość, zużycie energii, ślad pamięciowy, wykorzystanie i koszt.
Systemy brzegowe mogą cenić prywatność i niskie zużycie energii bardziej niż maksymalną przepustowość; centra danych mogą priorytetyzować całkowitą liczbę tokenów lub próbek na wat. Edge AI wyjaśnia, dlaczego jedna liczba nagłówkowa nie opisuje każdego użytecznego systemu.
Dlaczego zmieniło się skalowanie półprzewodników
Wczesny postęp układów scalonych łączył mniejsze elementy, lepszą produkcję, niższy koszt na komponent i ulepszenia projektowe. Przez lata zmniejszanie wymiarów tranzystorów wspierało szybsze przełączanie i niższą energię na operację. Ostatecznie nieszczelność, limity napięcia, gęstość ciepła, opóźnienia połączeń i koszty produkcji osłabiły prostą zależność między nowym węzłem procesu a szybszymi rdzeniami ogólnego przeznaczenia.
Współczesny postęp jest więc wielowymiarowy. FinFET i urządzenia typu gate‑all‑around poprawiają kontrolę elektrostatyczną; litografia EUV umożliwia mniejsze wzory; chiplety pozwalają projektantom łączyć dies wykonane w różnych procesach; zaawansowane pakowanie umieszcza obliczenia i pamięć bliżej siebie. Wydajność i pakowanie decydują, czy technicznie imponujący projekt jest ekonomiczny przy dużych wolumenach.
Spowolnienie jednego mechanizmu skalowania nie oznacza, że sprzęt przestał się poprawiać. Oznacza to, że architekci muszą używać tranzystorów bardziej świadomie. Specjalizowane jednostki wymieniają elastyczność na przepustowość lub wydajność przy wybranych obciążeniach, podczas gdy większe pamięci podręczne i połączenia starają się zapewnić im niezbędne zasoby.
Jak obciążenia AI obciążają sprzęt
Trening przełącza się pomiędzy obliczeniami w przód, backpropagacją, aktualizacjami optymalizatora i komunikacją pomiędzy akceleratorami. Inferencja waha się od wsadowego oceniania po interaktywne generowanie tokenów. Mnożenie macierzy jest ważne, ale osadzenia, normalizacja, funkcje aktywacji, uwaga, routowanie, dostęp do pamięci podręcznej i orkiestracja hosta również wpływają na rzeczywistą wydajność.
Intensywność arytmetyczna — ilość obliczeń wykonanych na bajt przeniesiony — pomaga wyjaśnić, czy obciążenie jest ograniczone przez moc obliczeniową, czy przez przepustowość. Małe rozmiary wsadów i dekodowanie autoregresywne często pozostawiają jednostki arytmetyczne niewykorzystane, ponieważ wagi lub dane pamięci podręcznej muszą być wielokrotnie pobierane. Większe wsady zwiększają wykorzystanie, ale podnoszą opóźnienie i zapotrzebowanie na pamięć.
Format numeryczny zmienia kompromis. FP32, BF16, FP16, FP8 i formaty całkowitoliczbowe różnią się zakresem, precyzją, wsparciem sprzętowym i błędem. Trening w mieszanej precyzji zachowuje wrażliwe operacje w wyższej precyzji; kwantyzowana inferencja wymaga kalibracji i testów jakości, a nie obietnicy, że każdy model toleruje tę samą szerokość bitu.
Ekonomia systemu i kierunki przyszłości
Całkowity koszt AI obejmuje zakup lub wynajem akceleratora, dostawę energii, chłodzenie, sieci, przechowywanie, inżynierię oprogramowania, nieużywaną pojemność i nieudane eksperymenty. Szybszy chip może kosztować więcej ogółem, jeśli jego wykorzystanie jest niskie lub jeśli model wymaga kosztownej, rozproszonej topologii. Mierz użyteczny wynik przy określonym progu jakości.
Skalowanie jest także ograniczone przez dane i algorytmy. Więcej mocy obliczeniowej nie naprawi źle oznaczonych danych ani oceny nagradzającej skróty. Efektywna uwaga, lepsze optymalizatory, rzadkość, wyszukiwanie, destylacja i odkrycia algorytmiczne mogą poprawić wyniki bez proporcjonalnego zwiększenia sprzętu, choć mogą przenieść koszty w inne miejsce.
Przyszłe systemy połączą postępy procesowe z trójwymiarowym układaniem, pamięcią o wysokiej przepustowości, połączeniami optycznymi lub zaawansowanymi elektrycznymi, przepływem danych specyficznym dla domeny i współprojektowanym oprogramowaniem. Prawo Moore’a pozostaje cennym kontekstem historycznym, ale planowanie powinno opierać się na zmierzonych krzywych obciążenia i realistycznych ograniczeniach dostaw, energii i wdrożenia.
Jak prawidłowo odczytywać prawo Moore’a w projektowaniu systemu AI
Użyteczna analiza oddziela gęstość tranzystorów, wydajność CPU ogólnego przeznaczenia, przepustowość akceleratora, pojemność pamięci, przepustowość pamięci, połączenia, energię, wydajność produkcji i koszt. Nie poprawiają się one w tym samym tempie. Obciążenie AI zdominowane przez przemieszczanie wag modelu może niewiele zyskać z większej liczby jednostek arytmetycznych, podczas gdy mały model na chipie może znacznie skorzystać ze specjalistycznego sprzętu niskiej precyzji. Cytuj dokładną metrykę, precyzję, obciążenie i envelope mocy, zamiast traktować węzeł procesu jako wskaźnik wydajności.
Skalowanie modelu AI zmienia także wymagania oprogramowania i systemu. Większe treningi wymagają równoległych algorytmów, niezawodnego zapisywania punktów kontrolnych, szybkich sieci, potoków przechowywania i wystarczającej ilości danych, aby wykorzystać dodatkową pojemność. Przy inferencji opóźnienie zależy od długości promptu, generowanych tokenów, wsadów, pamięci podręcznej i celów SLA. Ulepszenia algorytmiczne, rzadkość, kwantyzacja, wyszukiwanie i lepsze dane mogą przynieść zyski niezależne od trendów tranzystorów i czasem przewyższyć generację sprzętu.
Do planowania, benchmarkuj reprezentatywne modele na kandydackich systemach i modeluj całkowity koszt w czasie eksploatacji: zakup lub cena w chmurze, energia, chłodzenie, wykorzystanie, inżynieria, migracja i ryzyko dostaw. Używaj scenariuszy zamiast jednej wykładniczej prognozy. Prawo Moore’a pozostaje cenną historyczną obserwacją dotyczącą ekonomii integracji, ale nie gwarantuje, że AI stanie się proporcjonalnie szybsze, tańsze, bardziej zdolne lub bardziej zrównoważone według stałego harmonogramu.
Lista kontrolna praktycznej implementacji
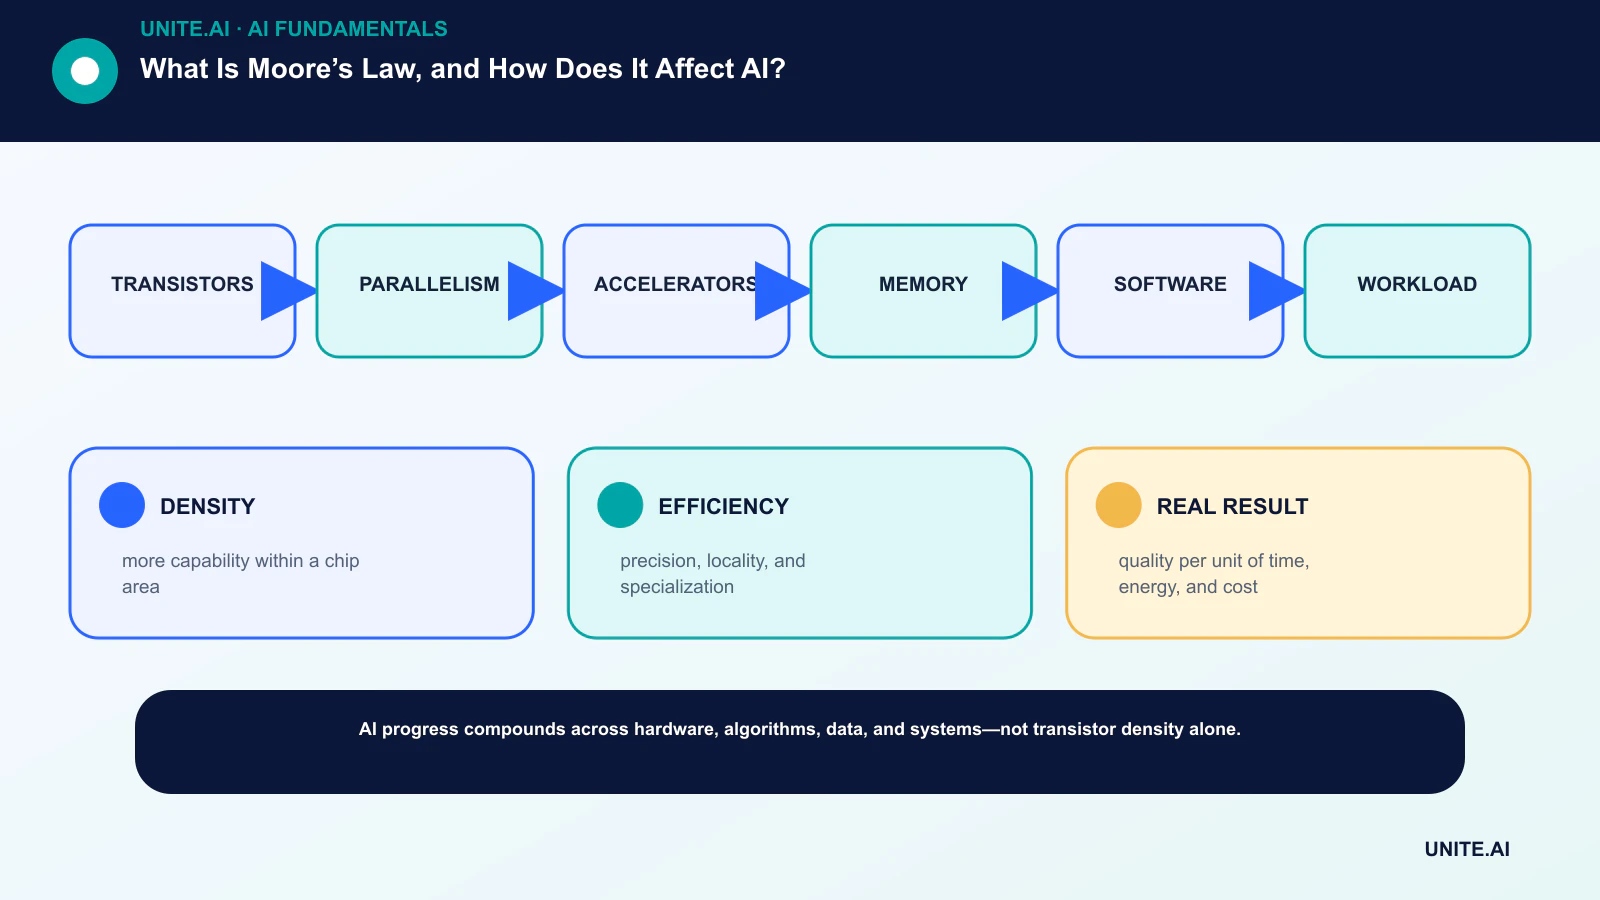
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: tranzystory → paralelizm → akceleratory → pamięć → oprogramowanie → obciążenie. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę odniesienia, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie i zdefiniuj monitorowanie, wycofywanie i przegląd przed rozszerzeniem zakresu. Rejestruj wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowaną ocenę gotowości z osobami, które budują, operują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie oceń decyzję po pojawieniu się danych z rzeczywistości, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności w szerszej skali.
- GĘSTOŚĆ: więcej możliwości w obrębie powierzchni chipu.
- EFEKTYWNOŚĆ: precyzja, lokalność i specjalizacja.
- RZECZYWISTY WYNIK: jakość na jednostkę czasu, energii i kosztu.
Najczęściej zadawane pytania
Czy prawo Moore’a dobiegło końca?
Prosty historyczny trend zwolnił i zmienił charakter, ale postęp w dziedzinie półprzewodników trwa dzięki nowym urządzeniom, architekturze, pakowaniu, pamięci i oprogramowaniu. Czy określenie nadal ma zastosowanie, zależy od wybranej miary.
Czy dwa razy więcej tranzystorów oznacza dwa razy większą wydajność AI?
Nie. Wydajność zależy od tego, jak tranzystory są wykorzystywane oraz od przepustowości, precyzji, struktury modelu, efektywności oprogramowania, mocy i ograniczeń obciążenia.
Podstawowe odniesienia