Grunnleggende AI
Hvordan fungerer bildeklassifisering?

 Legg til Unite.AI blant dine foretrukne kilder på Google
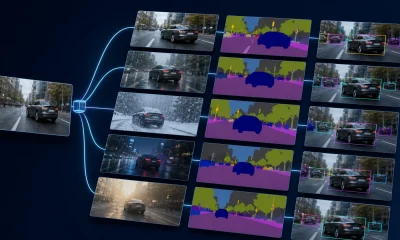
Bildeklassifisering forutsier en etikett for et helt bilde. Den svarer på spørsmål som «Hvilken produktkategori vises?» eller «Inneholder dette skanningen et målrettet funn?» Den lokerer ikke selv hvert objekt eller avgrenser dets piksler.
Moderne systemer bruker vanligvis konvolusjonelle nevrale nettverk eller visjonstransformatorer, ofte initialisert med forhåndstrente vekter. Pålitelig ytelse avhenger fortsatt av etiketter, utvalg, augmentering, kalibrering og testing under reelle distribusjonsforhold.
Viktige punkter
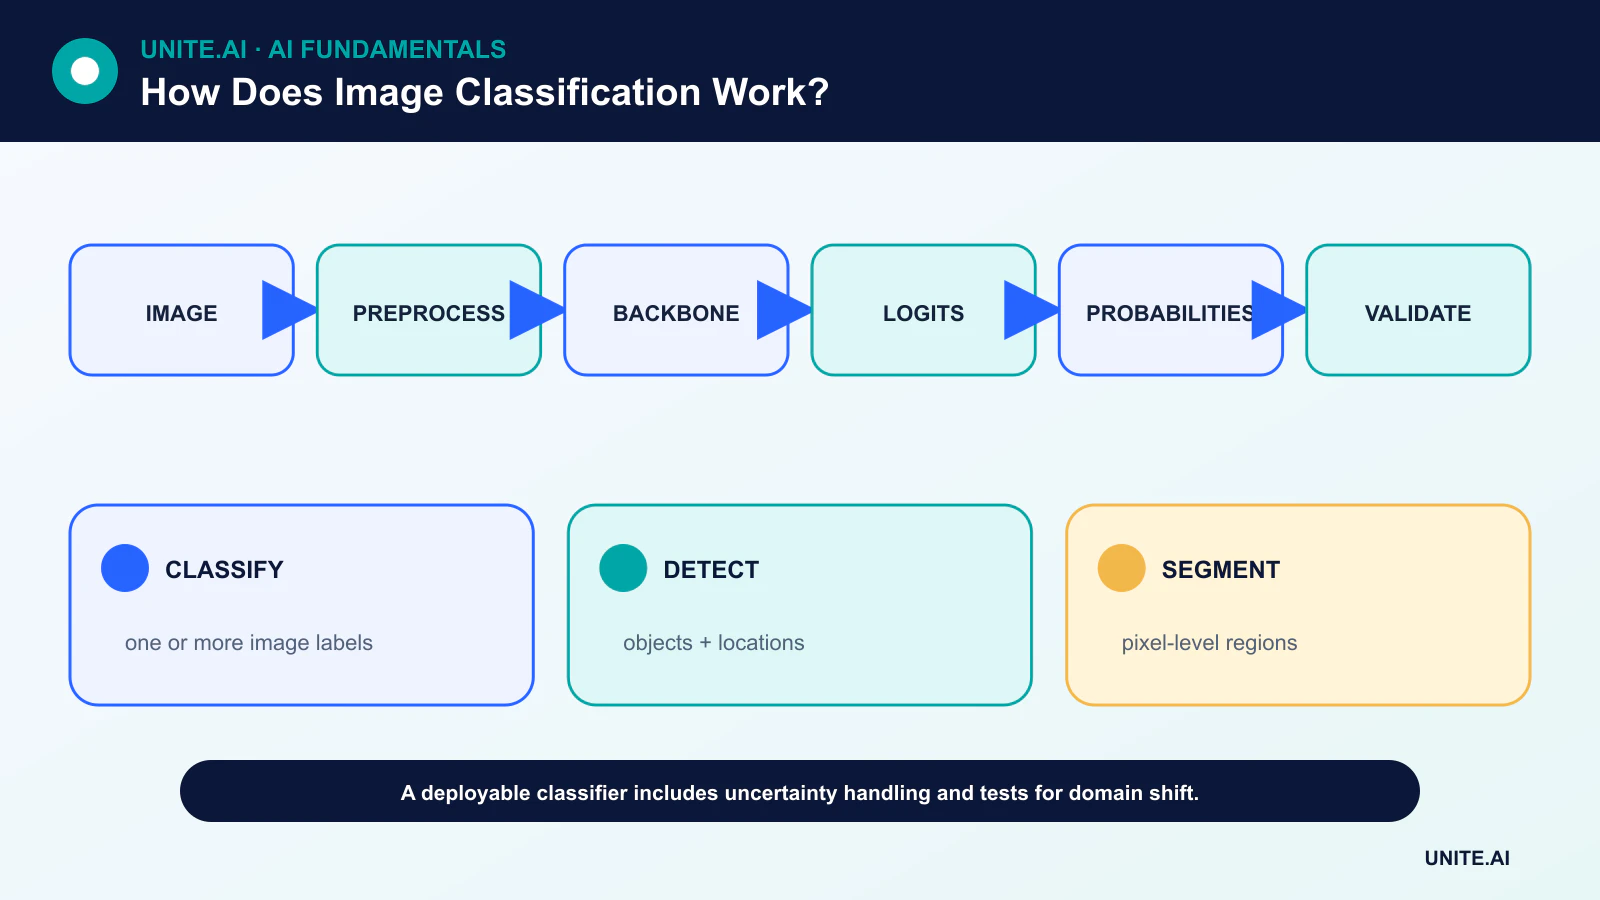
- Klassifisering merker hele bildet; gjenkjenning tegner objektbokser og segmentering tildeler pikselnivåregioner.
- Forhåndstrening og overføringslæring kan redusere datakrav, men domene‑mismatch kan fjerne fordelen.
- Den overordnede nøyaktigheten kan skjule klasseubalanse, falske snarveier og dårlig kalibrering.
- Bildekvalitet, opptaksutstyr, geografisk plassering og endringer i arbeidsflyt kan alle skape distribusjonsforskyvning.
Fra piksler til poeng
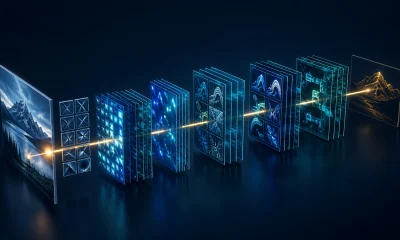
Bilder blir endret i størrelse eller beskjært, normalisert og konvertert til tensorer. Dataaugmentering kan anvende etikettbevarende transformasjoner som speiling, beskjæring eller fargeendringer. En backbone kartlegger piksler til funksjoner; et klassifiseringshode produserer logits som konverteres til relative klassetall.
Den valgte forhåndsbehandlingen må samsvare med distribusjonen. En sentrert beskjæring som fjerner det relevante objektet eller en normaliseringsmismatch kan skade ytelsen selv om de trente vektene er uendret.
CNN-er og visjonstransformatorer
Konvolusjonelle nevrale nettverk bruker lokale filtre og delte vekter for å bygge romlige funksjoner. Residual‑koblinger gjorde svært dype CNN-er enklere å optimalisere. Visjonstransformatorer deler et bilde i lapper og bruker oppmerksomhet for å modellere relasjoner mellom dem.
Arkitektursammenligninger bør kontrollere for treningsdata, augmentering, beregning og oppløsning. Den beste modellen på en offentlig benchmark er kanskje ikke den beste for en edge‑enhet, lite datasett eller krav til forklarbarhet.
Overføringslæring og datadesign
Overføringslæring starter fra vekter trent på et større kilde‑datasett. Et team kan fryse backbonen, finjustere senere lag eller oppdatere hele modellen. Finjustering krever vanligvis en lavere læringsrate og et valideringssett som er sikkert mot lekkasje.
Etiketter bør beskrive hva som er synlig infererbart. Hvis en diagnose avhenger av pasienthistorie som ikke er tilgjengelig i bildet, kan klassifisereren ikke lære den fulle kliniske beslutningen. Duplikater, rammer fra én video og bilder fra samme subjekt må forbli i samme deling.
Måleparametre, usikkerhet og snarveier
Top‑1‑nøyaktighet krever at den høyest scorerte klassen er korrekt; top‑k‑nøyaktighet aksepterer den korrekte klassen blant de k høyeste poengene. Presisjon, tilbakekalling per klasse og en forvirringsmatrise avdekker ujevne feil.
Modeller kan utnytte bakgrunner, vannmerker, innhentingsutstyr eller innramming i stedet for det tiltenkte objektet. Kontrafaktiske tester, undergruppeanalyse og saliensverktøy kan hjelpe med å oppdage snarveier, men et forklarings‑varmekart er ikke bevis på kausal resonnering.
Overvåking av distribusjon
Produksjonskontroller bør dekke korrupte filer, uventede dimensjoner, uskarphet, belysning, kameramodeller og nye klasser. Tillit bør kalibreres på data som ligner distribusjonsmiljøet, og utenfor‑omfang‑input bør avvises eller gjennomgås.
Overvåking av forsinkede etiketter og endringer i feilkostnad er essensielt. En modell som virker stabil basert på inndata‑statistikk kan fortsatt feile dersom forholdet mellom piksler og etiketter endres.
Bygge et datasett for bildeklassifisering
Bildeklassifisering tilordner én eller flere etiketter til et helt bilde. Det skiller seg fra gjenkjenning, som lokaliserer objekter, og segmentering, som merker piksler. Definer klassens omfang, hierarki, fleretikettregler, bakgrunns‑ eller ukjente kategorier, og hvilket bevis som må være synlig. Samle inn kameraer, lokasjoner, belysning, synsvinkler, avstander og motiv som representerer distribusjonsmiljøet. Del opp etter motiv, scene, økt eller kilde før augmentering; tilstøtende videorammer eller dupliserte produktbilder på tvers av partisjoner forårsaker alvorlig lekkasje.
Annotasjonsinstruksjoner bør dekke okklusjon, tvetydige objekter, flere klasser, lav kvalitet og avståelse. Mål enighet og gjennomgå systematisk uenighet. Klassebalanse alene garanterer ikke dekning: en sykdomsklasse kan inneholde én enhet eller en dyrelivsklasse kun én bakgrunn. Inspiser metadata og nesten duplikater, og hold et beskyttet testsett fra uavhengig innsamling. Syntetiske data og nettskraping kan øke variasjonen, men introdusere lisens‑, opprinnelses‑, stil‑ og etikettproblemer som må måles på ekte bilder.
Modeller, trening og evaluering
Klassiske metoder kombinerer konstruerte beskrivelser med en klassifiserer; moderne systemer bruker konvolusjonsnettverk eller visjonstransformatorer, ofte via overføringslæring. Valg av endring av størrelse og beskjæring bestemmer hvilken informasjon som overlever. Augmentering bør gjenspeile gyldig variasjon og bevare etiketter. Optimaliser et oppgave‑passende tap, håndter ubalanse gjennom vekting eller prøvetaking nøye, og velg sjekkpunkter på valideringsdata. Sammenlign med et enkelt referansepunkt og fjern (ablate) augmentering, oppløsning og forhåndstrent initialisering for å finne hvor gevinstene kommer fra.
Rapporter presisjon, tilbakekalling, F1, forvirring per klasse, top‑k‑nøyaktighet når relevant, kalibrering og ytelse etter forhold. Test uskarphet, komprimering, belysning, beskjæring, okklusjon, enhet og input uten støttet klasse. Toleranser for tillit kan dirigere usikre tilfeller til gjennomgang; softmax‑sannsynlighet garanterer ikke tillit, spesielt under forskyvning. Kontrafaktiske bakgrunner og okklusjonstester avdekker snarveislæring. For sikkerhetskritisk bruk, evaluer worst‑case‑feil og konsekvensene av falske positive og negative.
Distribusjon og overvåking
Pakk sammen dekoding, fargekonvertering, orientering, normalisering, modell og etikettkart. Valider den eksporterte eller kvantiserte artefakten på mål‑enheter og mål end‑to‑end‑latens, minne, strømforbruk og gjennomstrømning. Overvåk bildekvalitet, inndata‑ og utdata‑fordelinger, kalibrering, bekreftede etiketter og sensorhelse. Minimaliser og sikre lagring av bilder, spesielt ansikter, lokasjoner og tilskuere. Tilby en fallback for korrupte eller utenfor‑omfang‑input og rull tilbake modellversjoner. Klassifisering svarer på det definerte bilde‑nivå‑spørsmålet; den bør ikke strekkes til å dekke uunderstøttet lokalisering, identitet eller intensjons‑påstander.
Arbeidseksempel: klassifisering av resirkulerbare materialer
Et anlegg fotograferer gjenstander på et transportbånd og merker materialklasse, forurensning og ukjent. Bilder deles etter innsamlingsdag og objektbatch, og dekker belysning, våte overflater, krølling, overlapp og tomme belter. En liten CNN og en forhåndstrent modell sammenlignes med farge‑ og formregler. Tilbakekalling per klasse, feil sortering, kalibrering, gjennomstrømning og resultater etter kamera og materialtilstand styrer valget.
Produksjonspipelinen verifiserer kamerautsattelse og belttiming, og sender deretter usikre gjenstander til en generell strøm i stedet for å tvinge en klasse. Kvantisert inferens valideres på nøyaktig maskinvare. Overvåking sporer inndata‑kvalitet, klasseringsrater, avvisninger og utvalgte manuelle revisjoner; ny emballasje utløser en gjennomgått dataoppdatering. Modellen styrer en avgrenset sorteringsmaskin med fysiske sperrer, og sensor‑ eller modell‑feil bringer mekanismen tilbake til en sikker tilstand i stedet for å stille omdirigere materialet stille.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensebetingelser, feilformatert eller manglende inndata, distribusjonsforskyvning, avhengighetsavbrudd, misbruk, og gruppene eller miljøene som sannsynligvis er underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avsløre inndata‑kvalitet, utdata‑atferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varselterskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og lagringsprosedyrer, og et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Kan en bildklassifiserer identifisere flere objekter?
En fleretikett‑klassifiserer kan angi hvilke kategorier som er til stede, men den lokaliserer ikke individuelle forekomster. Objektgjenkjenning er nødvendig for bokser eller tellinger.
Hvorfor kan en modell feile på bilder som ser normale ut for en person?
Den kan være avhengig av opptaksartefakter, teksturer eller korrelasjoner som har endret seg. Små forskjeller i forhåndsbehandling og domene‑forskyvning kan også påvirke lærte funksjoner.
Primære referanser