
AI-basisprincipes
Wat is de Bayes‑stelling?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Bayes’ theorem beschrijft hoe de waarschijnlijkheid van een hypothese bij te werken na het observeren van bewijs. Het verbindt de waarschijnlijkheid van bewijs gegeven een hypothese met de waarschijnlijkheid van de hypothese gegeven dat bewijs.
Dit onderscheid is centraal voor statistisch redeneren en machine learning. Een test kan zeer nauwkeurig zijn wanneer een aandoening aanwezig is, terwijl een positief resultaat nog steeds een bescheiden kans heeft om de aandoening aan te duiden als die zeldzaam is.
Belangrijkste inzichten
- De posterior combineert een voorafgaande overtuiging met de waarschijnlijkheid van het geobserveerde bewijs.
- De bewijs‑term normaliseert de mogelijke hypothesen.
- Basispercentages kunnen dominant zijn boven schijnbaar sterk bewijs.
- Naive Bayes gaat ervan uit dat kenmerken voorwaardelijk onafhankelijk zijn gegeven de klasse, niet dat ze in elke situatie onafhankelijk zijn.
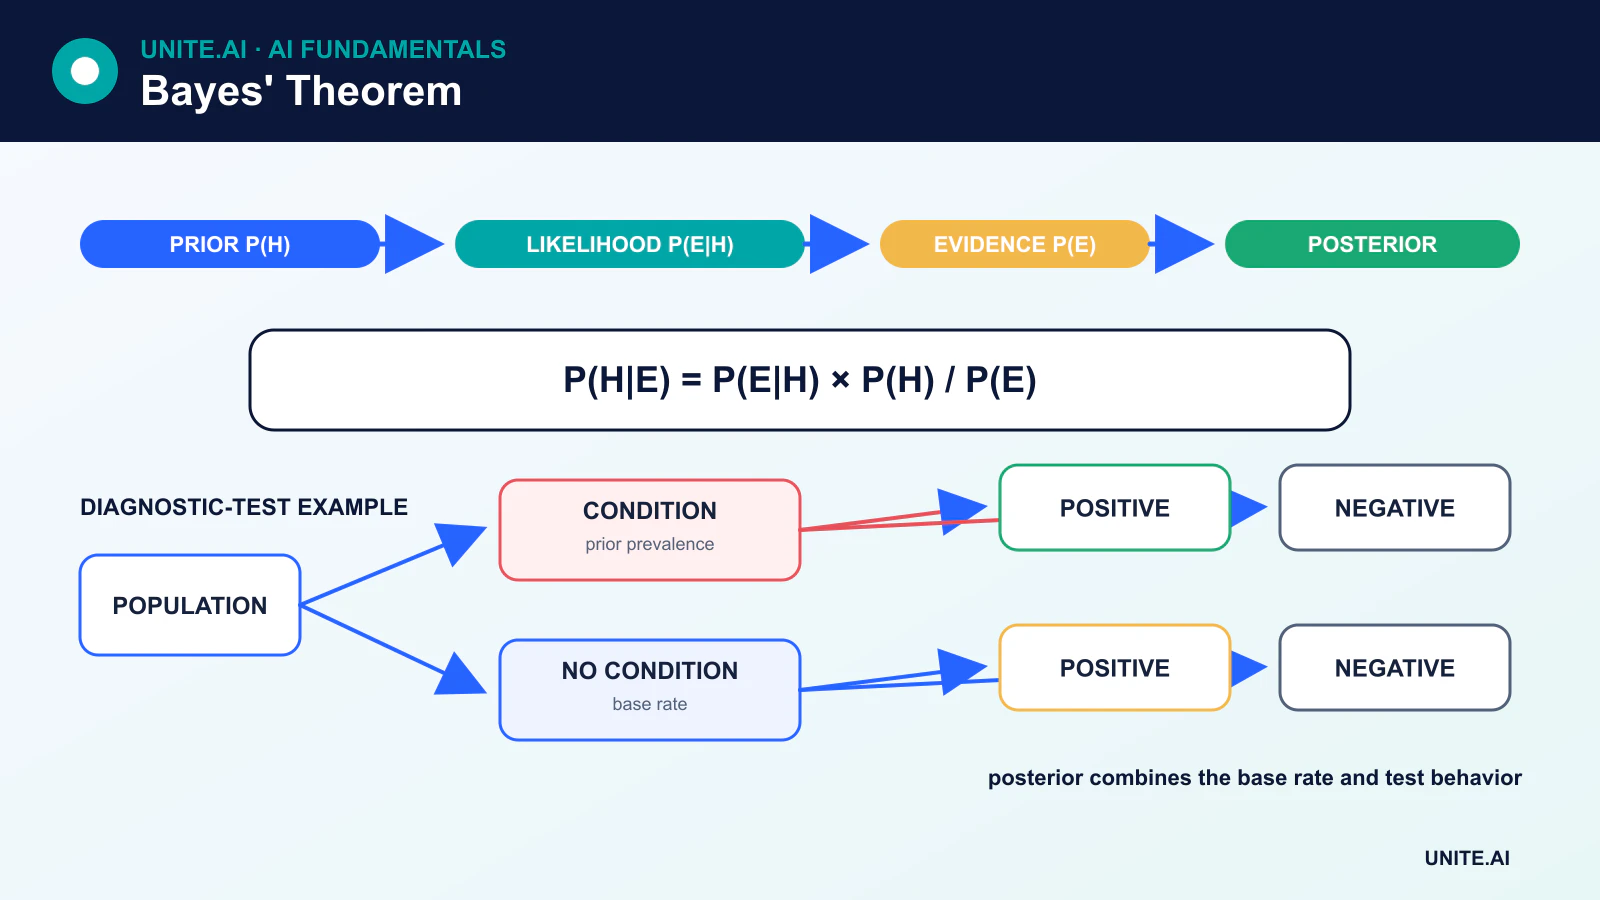
De formule
P(A|B) = P(B|A)P(A) / P(B)
- P(A) is de voorafgaande waarschijnlijkheid van hypothese A.
- P(B|A) is de waarschijnlijkheid van het observeren van bewijs B als A waar is.
- P(B) is de totale waarschijnlijkheid van het bewijs.
- P(A|B) is de posteriorkans van A na het observeren van B.
De stelling volgt uit twee gelijkwaardige uitdrukkingen voor de gezamenlijke waarschijnlijkheid: P(A ∩ B) = P(B|A)P(A) en P(A ∩ B) = P(A|B)P(B).
Een numeriek voorbeeld met basispercentage
Stel dat een aandoening 1 % van een populatie treft. Een test heeft 90 % sensitiviteit en een fout‑positiefpercentage van 5 %. Beschouw 1 000 personen:
- Ongeveer 10 hebben de aandoening; de test markeert er correct 9.
- Ongeveer 990 hebben het niet; een fout‑positiefpercentage van 5 % markeert ongeveer 50.
- Er zijn dus ongeveer 59 positieve resultaten, waarvan 9 ware positieven.
De kans op de aandoening na een positief resultaat is ongeveer 9 / 59 ≈ 15 %, niet 90 %. De sensitiviteit van de test beantwoordt P(positief | aandoening); de gebruiker wil meestal P(aandoening | positief). Bayes’ theorem verbindt deze twee via het basispercentage.
Bayesiaanse bijwerking
Naarmate nieuw bewijs binnenkomt, kan een posterior de prior worden voor de volgende bijwerking. Een volledig Bayesiaans model specificeert mogelijke hypothesen, prior‑distributies, een likelihood en de te schatten grootheid. Onzekerheid wordt weergegeven met een posterior‑distributie in plaats van slechts een puntschatting.
De prior moet worden gedocumenteerd en getest op gevoeligheid. Een zwak informatieve prior kan onrealistische waarden regulariseren, terwijl een slecht gekozen sterke prior beperkte data kan domineren.
Naive Bayes-classificatoren
Naive Bayes voorspelt een klasse y uit kenmerken x₁ … xₙ met behulp van Bayes’ theorem en de veronderstelling:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
De kenmerken worden verondersteld voorwaardelijk onafhankelijk te zijn zodra de klasse bekend is. Dit is vaak onrealistisch, maar de classifier kan goed presteren wanneer de resulterende klasscores nog bruikbaar zijn.
Veelvoorkomende varianten
- Multinomial Naive Bayes modelleert tel‑achtige kenmerken en is gangbaar bij documentclassificatie.
- Bernoulli Naive Bayes modelleert binaire aanwezigheid van kenmerken.
- Gaussian Naive Bayes modelleert elke continue eigenschap met een klasse‑voorwaardelijke Gaussiaanse verdeling.
- Categorical Naive Bayes modelleert discrete categorieën.
Gladstrijken en numerieke stabiliteit
Als een kenmerk nooit voorkomt bij een klasse in de training, kan een niet‑gegladste kansschatting nul worden en het volledige product elimineren. Additieve of Laplace‑achtige gladstrijken voorkomt dit. Implementaties berekenen log‑kansen zodat het vermenigvuldigen van vele kleine waarden wordt omgezet in het optellen van stabiele log‑waarden.
Kanswaarden, scores en calibratie
Naive Bayes‑kansuitvoer kan slecht gekalibreerd zijn omdat gecorreleerde kenmerken feitelijk meer dan eens worden geteld. Een classifier kan klassen goed rangschikken terwijl hij het vertrouwen overschat. Calibratie moet worden geëvalueerd op een hold‑out‑set wanneer kansen beslissingen aansturen.
Bayes voorbij Naive Bayes
Bayesiaanse inferentie ondersteunt hiërarchische modellen, A/B‑tests, wetenschappelijke parameter‑schattingen, prognoses, onzekerheids‑bewuste besluitvorming en probabilistische grafische modellen. Approximate methoden zoals Markov chain Monte Carlo en variational inference worden gebruikt wanneer een posterior niet in gesloten vorm kan worden berekend.
Veelvoorkomende redeneerfouten
- P(A|B) verwarren met P(B|A).
- Een zeldzaam of veelvoorkomend basispercentage negeren.
- Een prior als objectief behandelen of deze niet documenteren.
- Aannemen dat een hoge likelihood automatisch een hoge posterior impliceert.
- Een voorspellende associatie interpreteren als causaliteit.
Voorwaardelijke waarschijnlijkheid, odds en bewijs
Bayes’ theorem verbindt de waarschijnlijkheid van een hypothese na bewijs met haar voorafgaande waarschijnlijkheid, de likelihood van het waarnemen van dat bewijs onder de hypothese, en de totale waarschijnlijkheid van het bewijs. In odds‑vorm geldt: posterior‑odds = prior‑odds × likelihood‑ratio. Dit scheidt wat vóór een test werd aangenomen van hoe sterk de test hypothesen onderscheidt. Een test die zeer accuraat lijkt, kan toch veel fout‑positieven opleveren wanneer de aandoening zeldzaam is, omdat het basispercentage de posterior beïnvloedt.
De likelihood is een functie van de hypothese voor vaste waargenomen data en mag niet worden verward met de kans op de hypothese. Normalisatie van bewijs somt of integreert over concurrerende hypothesen. Voorwaardelijke onafhankelijkheidsassumpties kunnen de berekening vereenvoudigen, zoals bij naive Bayes, maar moeten worden getoetst aan de consequenties. Meerdere bewijsstukken kunnen niet als onafhankelijk worden vermenigvuldigd wanneer ze oorzaken delen of informatie dupliceren. De causale richting is ook van belang: P(bewijs|hypothese) is over het algemeen niet gelijk aan P(hypothese|bewijs), de klassieke inverse‑probabiliteitsfout.
Modelkeuzes, berekeningen en besluitvorming
Bayesiaanse analyse specificeert een prior, een likelihood en een posterior‑predictieve distributie. Priors kunnen gevestigde kennis coderen, kleine steekproeven regulariseren of zwak informatief zijn; ze moeten worden gemotiveerd en getest via gevoeligheidsanalyse. Conjugate modellen leveren analytische updates, terwijl Markov chain Monte Carlo, variational inference en sequentiële methoden complexe posteriors benaderen. Diagnoseer convergentie, effectieve steekproefgrootte, benaderingsfout en plausibiliteit van de prior‑predictie in plaats van een posterior‑cijfer te rapporteren zonder reken‑checks.
Een posterior‑kans informeert, maar bepaalt op zichzelf geen actie. Beslissingen vereisen verlies‑ en winstfuncties, beperkingen en beschikbare alternatieven. Evalueer probabilistische modellen met calibratie, juiste scoringsregels en posterior‑predictieve controles op nieuwe data. Werk alleen bij met bewijs dat is verzameld onder een gemodelleerd proces; selectiebias en dataset‑shift kunnen de likelihood ongeldig maken. Communiceer geloofsintervallen en aannames zonder ze als gegarandeerde frequentiebereiken te presenteren. Bayes’ theorem is exacte probabiliteits‑algebra, terwijl de kwaliteit van een Bayesiaanse conclusie afhangt van het model en het geleverde bewijs.
Voorbeeld: een diagnostische test interpreteren
Een test heeft 95 % sensitiviteit en 90 % specificiteit, maar de aandoening treft slechts 1 % van de gescreende populatie. Voor 10 000 personen worden ongeveer 95 ware positieven en 990 fout‑positieven verwacht, wat een positieve voorspellende waarde onder 9 % oplevert. Bayes’ theorem maakt het basispercentage‑effect expliciet. De berekening geeft populatie, testdrempel en onzekerheid weer in plaats van sensitiviteit te adverteren als de kans dat een positief resultaat correct is. Dit onderscheid is ook fundamenteel voor zorgvuldige data science.
Artsen passen de kans alleen aan met extra bewijs wanneer onderlinge afhankelijkheid tussen tests wordt gemodelleerd. Een beslissingsdrempel houdt rekening met schade door gemiste diagnoses, risico van bevestigende tests, kosten en patiëntvoorkeur. Calibratie wordt gecontroleerd in de lokale populatie, en veranderingen in prevalentie triggeren een herziening. De posterior ondersteunt discussie en vervolgstappen; hij vervangt geen bevestigende diagnose. Rapportage gebruikt natuurlijke frequenties en gevoeligheidsanalyse zodat patiënten en professionals kunnen zien hoe de conclusie verandert onder plausibele aannames.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset op vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan scheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit voor release, uitzonderingen, wijzigingen, rollback en pensionering worden toegewezen. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met bewust ingevoerde fouten. Operationele telemetrie moet invoer‑kwaliteit, uitvoer‑gedrag, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor respons, en beoordeel vervolgens real‑world‑bewijs na implementatie in plaats van te veronderstellen dat offline‑prestaties behouden blijven. Her‑evalueer wanneer databronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem vereist ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Wat is het verschil tussen een likelihood en een kans?
Met vaste parameters kent een model een kans toe aan mogelijke data. Met vaste waargenomen data kan dezelfde uitdrukking worden gezien als een likelihood‑functie over mogelijke parameterwaarden. De numerieke formule kan gelijk zijn, maar de interpretatie verschilt.
Is Naive Bayes volledige Bayesiaanse inferentie?
Het gebruikt Bayes’ theorem voor classificatie onder een sterk voorwaardelijk‑onafhankelijkheidsmodel. Brede Bayesiaanse inferentie plaatst distributies over onbekende grootheden en redeneert met een posterior‑distributie.
Primaire referenties












