
AI-basisprincipes
Wat is sentimentanalyse? Methoden, toepassingen en beperkingen

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Sentimentanalyse schat evaluatieve taal in tekst, spraaktranscripties of andere inhoud. Een systeem kan polariteit classificeren, zoals positief, negatief of neutraal; aspect‑niveau meningen detecteren; intensiteit inschatten; of een standpunt ten opzichte van een specifieke bewering identificeren.
Het doel moet zorgvuldig worden gedefinieerd. Sentiment is niet hetzelfde als emotie, intentie, toxiciteit, tevredenheid of waarheid. Een positieve zin kan een schadelijke gebeurtenis sarcastisch beschrijven, terwijl een negatieve productreview het product toch in het algemeen kan aanbevelen.
Belangrijkste conclusies
- Definieer eenheid, doel, labels en context voordat je voorbeelden verzamelt.
- Lexicons zijn transparante baselines; supervised‑ en transformer‑modellen kunnen meer context vastleggen, maar hebben representatieve data nodig.
- Negatie, sarcasme, domeinspecifieke woordenschat, meertalige tekst en aspect‑grenzen blijven moeilijk.
- Evalueer per klasse, subgroep, domein en tijdsperiode; betrek menselijke beoordeling bij consequentiale toepassingen.
Niveaus en doelen
Analyse op documentniveau levert één label op voor een heel item. Analyse op zinsniveau scheidt afzonderlijke uitspraken, terwijl aspect‑gebaseerde analyse sentiment koppelt aan een entiteit of attribuut – bijvoorbeeld positief over beeldkwaliteit maar negatief over batterijduur.
Stance vraagt of een spreker een specifieke stelling ondersteunt, wat kan verschillen van de emotionele toon. Deze onderscheidingen moeten in de annotatiegids worden vastgelegd voordat tekstclassificatiemethoden worden toegepast.
Lexicons, klassieke modellen en transformers
Een lexicon kent scores toe aan woorden en combineert ze met regels voor negatie of intensiteit. Het is interpreteerbaar en goedkoop, maar worstelt met context. Klassieke supervised‑modellen gebruiken woord‑ of n‑gram‑features, terwijl transformers contextuele representaties leren en fijn afgestemd kunnen worden.
Few‑shot prompting kan handig zijn, maar de output hangt af van voorbeelden en formulering. Vergelijk elke complexe aanpak met een baseline en gebruik few‑shot learning alleen met een gereserveerde, versie‑gecontroleerde evaluatieset.
Gegevens‑ en taaluitdagingen
Labels kunnen de perspectief van de annotator weerspiegelen in plaats van een objectief feit. Domein‑shift is ernstig: ‘onvoorspelbaar’ kan een lofzang op een film zijn en kritiek op een voertuig. Code‑switching, dialect, emoji’s, geciteerde spraak en ironie bemoeilijken token‑niveau signalen.
Balanceer klassen bewust en voorkom dat gerelateerde auteurs, producten of gesprekken lekken tussen training en test. Een model dat een merk of spreker memoriseert kan accuraat lijken zonder daadwerkelijk sentiment te leren.
Evaluatie en verantwoord gebruik
Rapporteer precisie, recall, F1 en een confusiematrix in plaats van alleen nauwkeurigheid. Analyseer fouten per aspect, lengte, dialect en tijd, en kalibreer drempels op basis van de operationele kosten van elke fout.
Geaggregeerde trends kunnen onderzoek of triage ondersteunen, maar het afleiden van iemands toestand of het nemen van beslissingen op het gebied van werk, krediet, gezondheid of politiezorg brengt grotere risico’s met zich mee. Bied onzekerheid, broncontext, privacy‑controles en menselijke beoordeling.
Annotatie en datasetconstructie
Schrijf een annotatiegids met doel‑entiteit, analyseeenheid, labeldefinities, behandeling van gemengde en neutrale gevallen, aanhalingsregels, sarcasme‑beleid en voorbeelden uit het domein. Pilot met meerdere annotatoren, bereken overeenstemming, bespreek meningsverschillen en reviseer de taak voordat je de labels opschaalt.
Sampling bepaalt wat het model leert. Een social‑media‑stroom kan zeer actieve accounts oververtegenwoordigen; support‑tickets kunnen tevreden klanten weglaten; sterbeoordelingen komen niet altijd overeen met de reviewtekst. Bewaar bron‑ en tijdmetadata, respecteer platformvoorwaarden en privacy, en maak een testset van de populatie waar beslissingen worden genomen.
Label‑lekkage kan optreden via beoordelingen, emoji’s die door het verzamelingssysteem zijn ingevoegd, sjabloonhandtekeningen of productnamen die met sentiment correleren. Dedupliceer bijna identieke berichten en groepeer gesprekken of auteurs zodat hun taal niet aan beide zijden van een splitsing verschijnt.
Modelkeuzes en calibratie
Lexicon‑systemen sommeren woordenscores en passen ze aan voor negatie, intensifiers, interpunctie of emoji’s. Ze bieden een nuttige sanity‑check en kunnen worden aangepast met domeinspecifieke termen. Lineaire modellen met TF–IDF‑features blijven concurrerend op sommige datasets en onthullen invloedrijke n‑grams.
Contextuele encoders representeren woorden volgens de omringende tekst en kunnen worden gefinetuned voor polariteit of aspecten. Lange documenten kunnen hiërarchische modellen, zin‑aggregatie of het ophalen van relevante passages nodig hebben. Meertalige benaderingen kunnen één gedeeld model trainen, vertalen naar een pivot‑taal, of lokale modellen onderhouden; elk heeft dekking‑ en culturele afwegingen.
Kans‑calibratie is belangrijk wanneer scores tot actie leiden. Betrouwbaarheids‑plots en expected calibration error laten zien of een gerapporteerde 0.8‑confidence overeenkomt met ongeveer 80 % correctheid. Drempels kunnen een afwijzingsband voor menselijke beoordeling creëren, en gescheiden drempels kunnen gerechtvaardigd zijn wanneer fout‑kosten verschillen – niet om ongelijke kwaliteit te verbergen.
Toepassingen en veelvoorkomende misinterpretaties
Geaggregeerd sentiment kan helpen thema’s te prioriteren, campagneresultaten te vergelijken of urgente service‑berichten te routeren. Aspect‑analyse is vaak bruikbaarder dan algemene polariteit omdat het identificeert waar mensen over spreken. Trendanalyse vereist stabiele sampling en consistente labeldefinities over tijd.
Verwar de prevalentie van negatieve berichten niet met de mening van de bevolking. Plaatsingsgedrag, bots, moderatie, demografie van het platform, campagnes en verzamelings‑queries vormen de steekproef. Een sentimentmodel meet niet de stille populatie, en een wijziging in bewoording kan lijken op een wijziging in houding.
Voor individuele beslissingen kunnen foutieve labels stigmatiserend en moeilijk te betwisten zijn. Vermijd sentiment als proxy voor medewerker‑betrokkenheid, mentale gezondheid, kredietwaardigheid, intentie of bedrog. Wanneer mensen worden beïnvloed, toon broncontext, sta correcties toe en eis een menselijke besluit‑nemer met echte discretie.
Voorbeeld: sentimentanalyse voor klantfeedback
Een bedrijf dat support‑commentaren analyseert moet bepalen of het document‑sentiment, aspect‑sentiment, emotie, urgentie of issue‑classificatie nodig heeft. ‘De levering was snel maar het product ging kapot’ kan niet getrouw worden weergegeven door één positief‑of‑negatief label. Maak een annotatiegids voor doelen, negatie, sarcasme, gemengde uitspraken, geciteerde spraak en onbekende gevallen, meet vervolgens de overeenstemming voordat je labels als grondwaarheid behandelt.
Vergelijk een lexicon‑ of lineaire baseline met een gefinetuned encoder of een prompted language model. Splits data op tijd of klant om lekken van bijna‑dubbele items te voorkomen, en behoud de klassen‑prevalentie. Rapporteer precisie, recall, F1, calibratie en verwarring per taal, kanaal, product en demografische proxy’s, alleen waar wettelijk toegestaan en gerechtvaardigd. Analyseer fouten met hoge confidence omdat die gevaarlijker zijn in geautomatiseerde routing dan onzekere uitkomsten die worden geëscaleerd.
Gebruik sentiment als één signaal voor aggregatie of prioritering, niet als een onbetwistbare maat voor de toestand van een persoon. Monitor woordenschat‑ en product‑drift, train opnieuw met beoordeelde voorbeelden, en sta agents toe labels te corrigeren. Infer nooit beschermde kenmerken of disciplinaire maatregelen op basis van niet‑geverifieerde sentiment‑scores. Voor rapportage aan het management toon steekproefgrootte, onzekerheid, ontbrekende data en de onderwerpen die verandering aandrijven zodat een fluctuerende score leidt tot onderzoek in plaats van een simplistische conclusie.
Meertalige inzet mag niet veronderstellen dat het vertalen van invoer toon, negatie, idiomen of culturele conventies behoudt. Valideer elke ondersteunde taal en mengtaal‑patroon met native reviewers, en bied een onbekende uitkomst wanneer bewijs zwak is. Domein‑adaptatie is ook belangrijk: woorden die in alledaagse gesprekken negatief klinken, kunnen neutrale technische beschrijvingen zijn. Houd gescheiden drempels of modellen alleen aan wanneer operationeel bewijs de extra complexiteit en governance‑last rechtvaardigt.
Praktische implementatie‑checklist
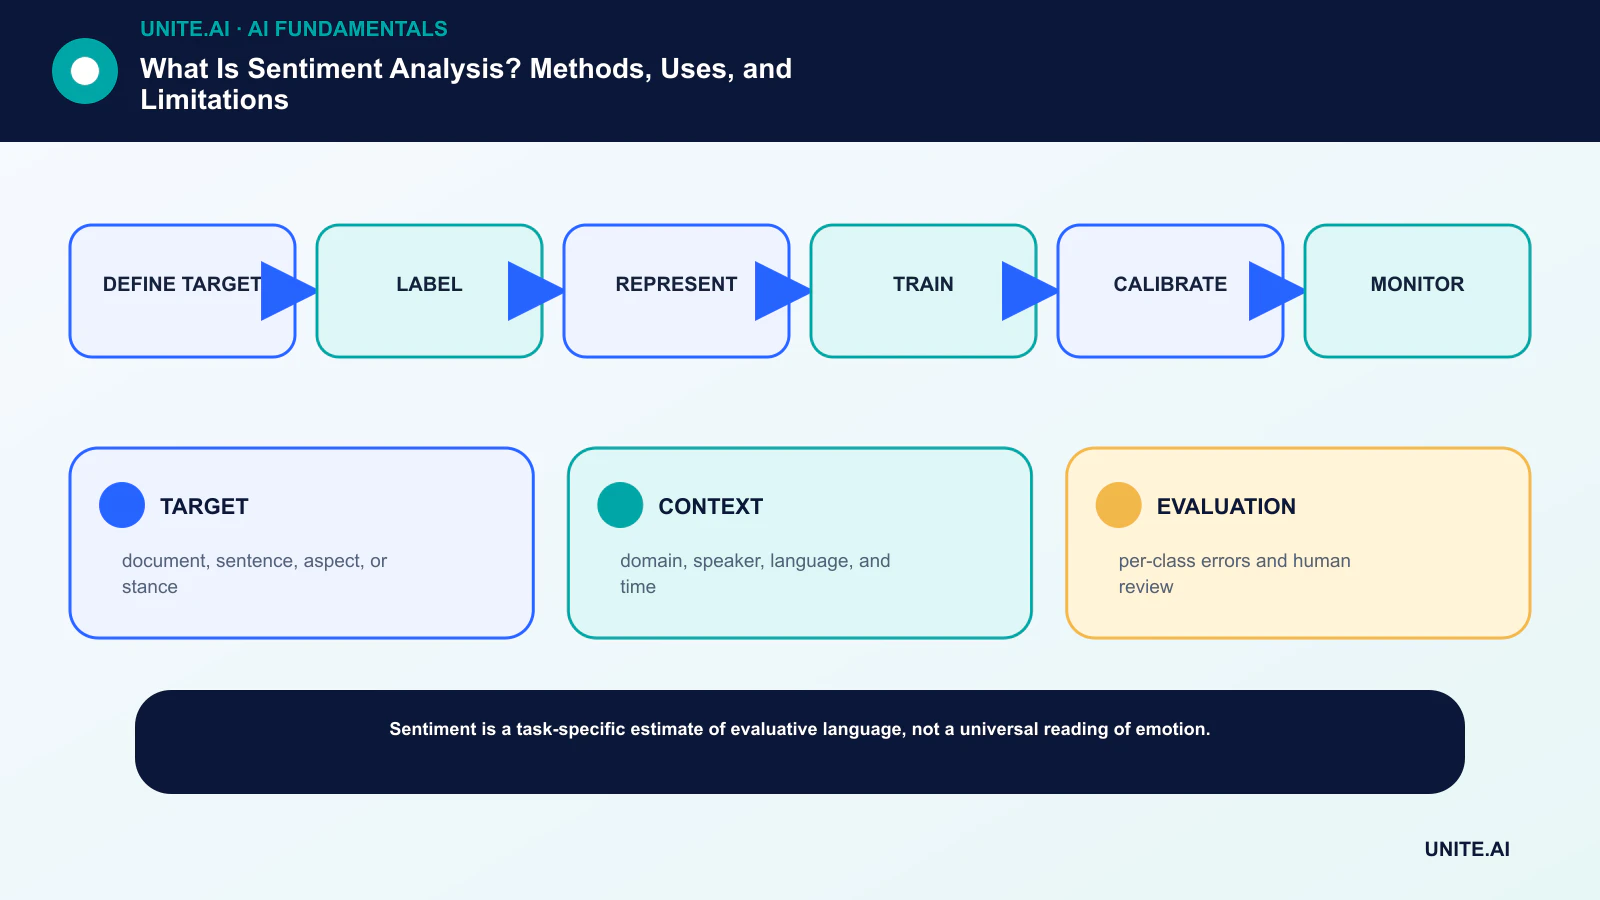
Zet het concept om in een begrensde, testbare workflow: definieer doel → label → representatie → training → calibratie → monitoring. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige baseline vast, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en definieer monitoring, rollback en beoordeling voordat je de scope uitbreidt. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er is veranderd.
Voor de lancering, voer een gedocumenteerde readiness‑review uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grenscondities, afhankelijkheids‑fouten en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie de release kan goedkeuren, een drempel kan aanpassen, een output kan overrulen of de werking kan stoppen. Herzie de beslissing nadat real‑world data binnenkomt, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- DOEL: document, zin, aspect of stance.
- CONTEXT: domein, spreker, taal en tijd.
- EVALUATIE: per‑klasse fouten en menselijke beoordeling.
Veelgestelde vragen
Is sentimentanalyse objectief?
Nee. Het schat labels in die gedefinieerd zijn door een taak en annotatieproces. Sommige teksten zijn werkelijk ambigu, gemengd, context‑afhankelijk of worden door lezers verschillend geïnterpreteerd.
Kan sentimentanalyse sarcasme detecteren?
Modellen kunnen sommige patronen leren, maar sarcasme hangt vaak af van de sprekerhistorie, gedeelde kennis en context buiten de tekst. Het blijft een veelvoorkomende foutmodus.
Primaire referenties












