
AIの基礎
人間のフィードバックからの強化学習(RLHF)とは何か?

 Unite.AI を Google の優先ソースに追加
人間のフィードバックからの強化学習(RLHF)は、望ましい行動を単純な自動報酬で明示的に指定することが困難な場合に、人間の判断を利用してモデルの最適化を支援する手法群です。言語モデルにおいては、候補となる応答を比較し、学習された嗜好モデルがそれらの比較をトレーニングシグナルに変換します。
RLHFは事前学習済みモデルをより有用にしたり、記述されたポリシーにより適合させたりすることができますが、真実性やすべてのユーザーとの整合性を保証するものではありません。結果は、フィードバックを提供する人物、プロンプトのサンプリング方法、報酬モデルが表現できる範囲、そして最適化の制約方法に依存します。
重要ポイント
- RLHFは通常、事前学習と教師あり指示チューニングの後に実施されます。
- ペアワイズの嗜好が報酬または嗜好モデルを学習し、ポリシー最適化はスコアの高い出力を優先します。
- 報酬ハッキング、アノテーターの意見不一致、分布シフト、過度な最適化は依然として重要なリスクです。
- 最終ポリシーはタスクの品質、安全性、キャリブレーション、サブグループへの影響について直接評価します。
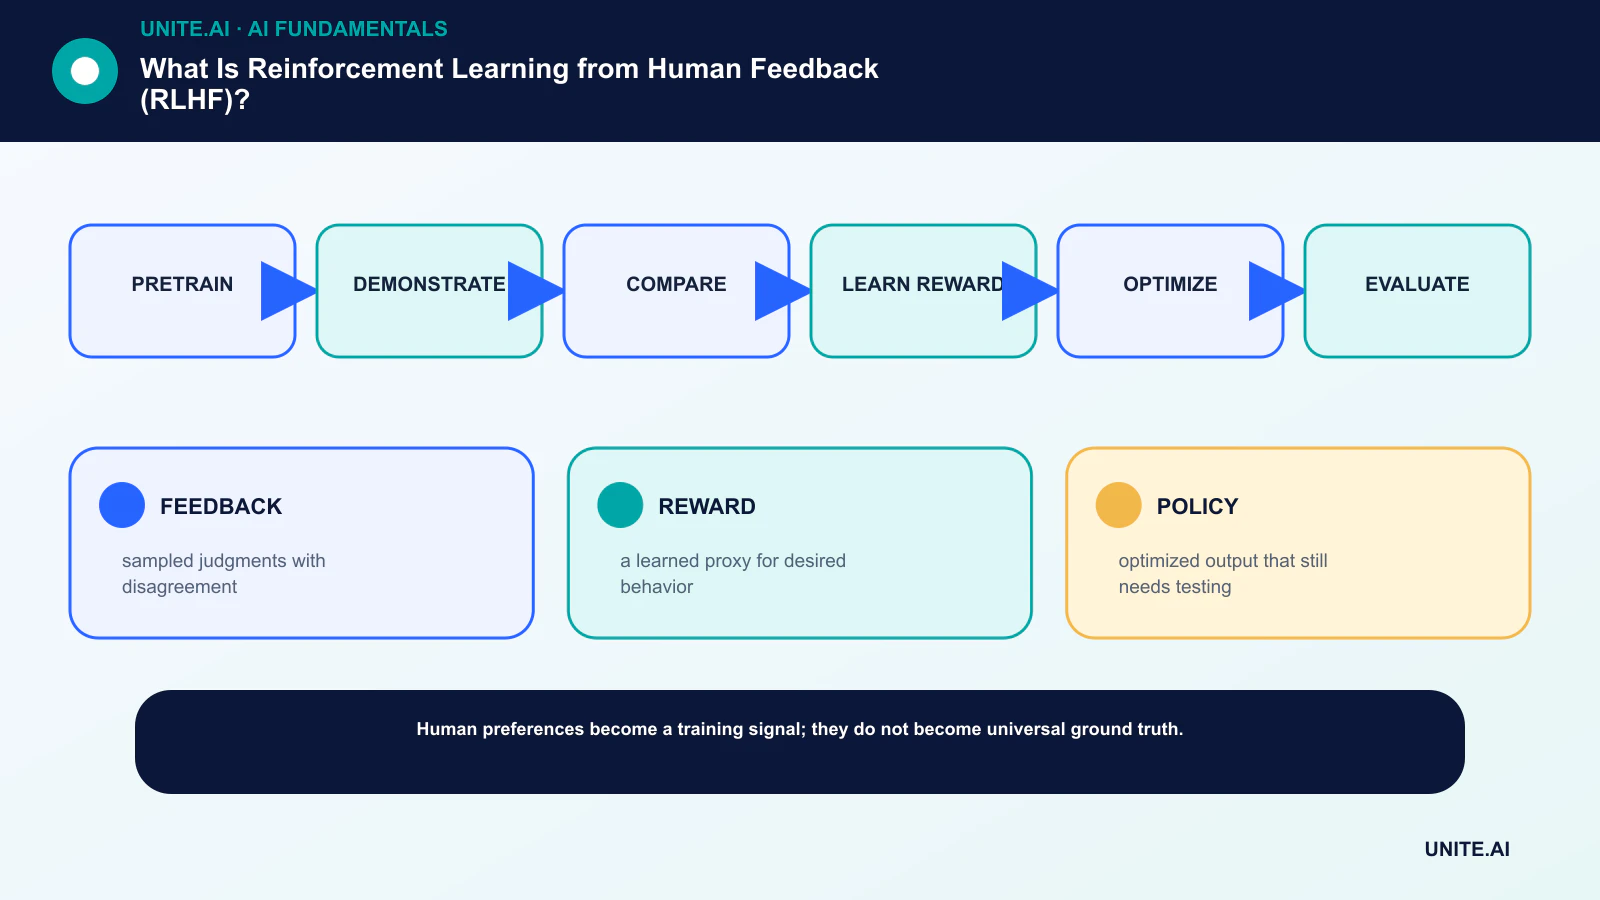
一般的なRLHFパイプライン
言語モデルはまず事前学習により広範な統計構造を学習します。その後、教師ありファインチューニングで望ましい応答のデモンストレーションを使用します。嗜好収集では、アノテーターが同一プロンプトに対する出力をランク付けまたは選択します。
報酬モデルはそれらの比較を予測するように学習します。PPO などの強化学習アルゴリズムは、学習された報酬に対して言語モデルを最適化し、ペナルティにより参照ポリシーから過度に逸脱することを抑制します。
フィードバックは測定であり、真実ではない
指示が曖昧であったり、専門性が異なったり、価値観が実際に衝突したりするため、アノテーターは意見が分かれることがあります。位置、冗長さ、確信度、スタイルなどが嗜好にバイアスを与えることがあります。高品質なプログラムは評価者を訓練し、合意度を測定し、例を監査し、不確実性を保持します。
サンプリングも重要です。嗜好セットに難しい言語やドメイン、あるいは有害なケースが除外されていると、報酬モデルはそれらを信頼的に監督できません。データサイエンスの discipline はオプティマイザーと同等に重要です。
失敗モード
ポリシーは学習された報酬の弱点を利用し、根本的な意図を満たさないまま高スコアの出力を生成することがあります。過度な最適化は多様性を減少させ、好まれるスタイルを増幅させ、モデルが自信を持って同意的になることがあります。
報酬モデル自体も訓練分布外で失敗する可能性があります。チームは、単一の総合嗜好勝率に頼るのではなく、敵対的プロンプト、事実タスク、拒否の境界、キャリブレーション、異なる最適化強度での挙動をテストすべきです。
代替手段と補完手段
Direct Preference Optimization は、オンライン強化学習ループで別個のポリシーをフィットさせることなく、嗜好ペアから学習します。リジェクションサンプリング、教師あり嗜好ファインチューニング、ルールベースのフィードバック、プロセス監督などが他のトレードオフを提供します。
どの手法もプロンプト、検索、ツール、アプリケーションレベルの制御の必要性を排除しません。トレーニング後に振る舞いが形成されますが、実装されたシステムは依然として根拠ある証拠、権限、モニタリング、人間によるエスカレーションを必要とします。
嗜好モデルの学習方法
プロンプト x と二つの応答 y₁、y₂ に対し、嗜好モデルはスカラー得点を割り当て、好ましい応答が高い得点を受け取るように学習します。一般的な損失は、一方の得点が他方を上回る確率に基づきます。これにより多数のペアワイズ判断が、新たに生成された出力を評価できる関数へと変換されます。
モデルは、収集された選択を予測するあらゆるシグナルを学習します。評価者が自信ある文章、長い回答、特定の文化的規範、あるいは馴染みのある視点を好む場合、これらの相関が報酬特徴となり得ます。バランスの取れた指示、反例、専門家レビュー、表面的な嗜好に対する監査は問題を減らしますが、完全には排除できません。
嗜好データは、同点、ランキング、批評、スカラーラベル、デモンストレーションを含むことがあります。ペアの選択は重要です:明らかに異なる回答間の比較は微妙な品質境界についての学習が少なく、難しいペアのみが訓練を不安定にする可能性があります。能動的サンプリングは有益な意見不一致を狙えますが、データ分布を変えることもあります。
ポリシー最適化と正則化
PPO ベースの RLHF は現在のポリシーから応答をサンプリングし、報酬モデルでスコア付けし、期待報酬を高めるようにポリシーを更新します。KL(カルバック・ライブラー)ペナルティや類似の制約により、ポリシーは教師あり参照に近く保たれ、破壊的なドリフトを抑制し、狭い報酬モデルの弱点の利用を防ぎます。
最適化の強さは製品選択のようなものです。弱すぎると望ましい行動が変わらず、強すぎると報酬ハッキング、繰り返し表現、媚び、または多様性の低下を引き起こす可能性があります。報酬だけでチェックポイントを選ぶのではなく、訓練中は品質と安全性の指標を報酬と発散度に対してプロットすべきです。
直接嗜好手法は、明示的なオンライン RL ループなしに嗜好ペアと参照モデルから目的関数を導出します。訓練を簡素化できますが、嗜好の品質、カバレッジ、参照ポリシーの前提は依然として引き継がれます。憲法的または AI 生成フィードバックはラベル提供者を変えますが、価値観や失敗を人間で検証する必要は依然として残ります。
評価とデータガバナンス
ブラインド比較、タスク固有のテスト、敵対的プロンプト、事実性チェック、拒否の適合率と再現率、サブグループレビューを使用します。可能な限り評価者を訓練データから分離します。古いモデルに対する勝率は、両方の候補が低品質な場合に絶対的な失敗を隠すことがあります。
アノテーターの募集、報酬、専門性、地域、言語、指示、有害コンテンツへの曝露、意見不一致、裁定、品質管理を文書化します。フィードバック作業は心理的リスクを伴う可能性があり、責任あるデータ運用には作業者支援と不快なタスクを拒否する権利が含まれます。
展開後は、嗜好のドリフトと過度な一般化を監視します。カジュアルな支援向けにチューニングされたポリシーは、医療や法的文脈で問題を起こす可能性があります。ドメインの境界、検索、権限、エスカレーションは RLHF の前提外に保ち、新たな証拠が変更を正当化する場合にのみ再訓練します。
具体的なRLHF訓練・評価パイプライン
典型的なプロジェクトは、事前学習済み言語モデルと教師ありファインチューニングに使用される指示データセットから始まります。その後、アノテーターは正確性、関連性、スタイル、安全性、不確実性を網羅した評価基準に基づき、候補応答を比較します。ペアワイズ嗜好は報酬モデルを学習させるか、直接ポリシーを最適化します。サンプリングは通常タスク、難しいエッジケース、敵対的プロンプト、複数言語、アノテーターが正当な意見不一致を示す領域を含める必要があります。
保持された比較に対する報酬モデルの精度は必要条件ですが、十分条件ではありません。最適化されたポリシーは学習された報酬の誤りを利用し、過度に冗長になったり、無害な要求を拒否したり、能力を失ったりすることがあります。訓練全体でタスクベンチマーク、人間の嗜好、キャリブレーション、安全性、多様性、参照モデルからの発散を追跡します。定期的に変化するポリシーから新たな比較を収集し、嗜好データが実際に生成される出力をカバーするようにします。
嗜好を提供した人物、指示、報酬、意見不一致、品質管理、文化的・ドメイン的制限を文書化します。専門的な危害が伴うミスがある場合は専門家レビューアを活用します。報酬モデルと最終ポリシーの両方に対してレッドチームを実施し、行動回帰テストを維持し、段階的に展開します。RLHF は測定された嗜好に基づいて振る舞いを形成しますが、真実性を証明したり、バイアスを排除したり、あらゆる文脈でモデルが何をすべきかを規定する広範な課題を解決したりはしません。
実装チェックリスト
概念を限定的でテスト可能なワークフローに落とし込みます:事前学習 → デモンストレーション → 比較 → 報酬学習 → 最適化 → 評価。責任者を明確にし、データと依存関係を文書化し、シンプルなベースラインを設定し、受け入れ基準と停止基準を定め、代表的な失敗をテストし、スコープ拡大前にモニタリング、ロールバック、レビューを定義します。バージョンと前提条件を記録し、別チームが結果を再現し変更点を理解できるようにします。
リリース前に、システムを構築・運用・保護し、影響を受ける関係者と文書化された準備レビューを実施します。通常ケース、境界条件、依存失敗、誤用をテストし、証拠と未解決リスクを保存します。リリース承認、閾値変更、出力上書き、運用停止ができる人物を定義します。実データが到着した後に判断を再検討します。技術的に成功したパイロットでも、広範なスケールでの信頼できる性能を保証するものではありません。
- フィードバック: 意見が分かれたサンプル判断。
- 報酬: 望ましい行動の学習された代理指標。
- ポリシー: まだテストが必要な最適化出力。
よくある質問
RLHFはファインチューニングと同じですか?
RLHF は嗜好由来の報酬を利用する事後トレーニングの形態です。教師ありファインチューニングは対象出力に直接学習しますが、多くのパイプラインは両方を組み合わせて使用します。
RLHFはモデルを真実的にしますか?
フィードバックプロセスで測定された行動は改善できるものの、モデルは依然として誤っていたり、説得的であったり、報酬を戦略的に利用したりする可能性があります。真実性は直接的な評価と根拠が必要です。
主要参考文献












