
AIの基礎
深層強化学習とは何か?

 Unite.AI を Google の優先ソースに追加
深層強化学習(deep RL)は、強化学習と深層ニューラルネットワークを組み合わせたものです。エージェントは状態を観測し、行動を選択し、報酬と新たな観測を受け取り、将来の意思決定を改善するために方策または価値関数を調整します。
深層ネットワークは強化学習の難しい部分を取り除くわけではありません。画像、センサーストリーム、大規模な行動空間、あるいは複雑な価値関数を柔軟に表現する手段を提供します。探索、遅延した報酬の帰属、不安定な学習、そして安全な実世界での評価は依然として重要なエンジニアリング課題です。
重要ポイント
- 深層強化学習は、固定されたラベル付き例のテーブルではなく、相互作用から順次的な意思決定を学習します。
- 価値ベースの手法は行動の良さを推定し、方策ベースの手法は行動分布を直接学習し、アクター・クリティック手法は両者を組み合わせます。
- リプレイバッファ、ターゲットネットワーク、慎重な報酬設計は学習を改善できますが、信頼できる挙動を保証するものではありません。
- シミュレータで高得点を得ても、ロバスト性や安全性、実世界への成功的な転移を証明するものではありません。
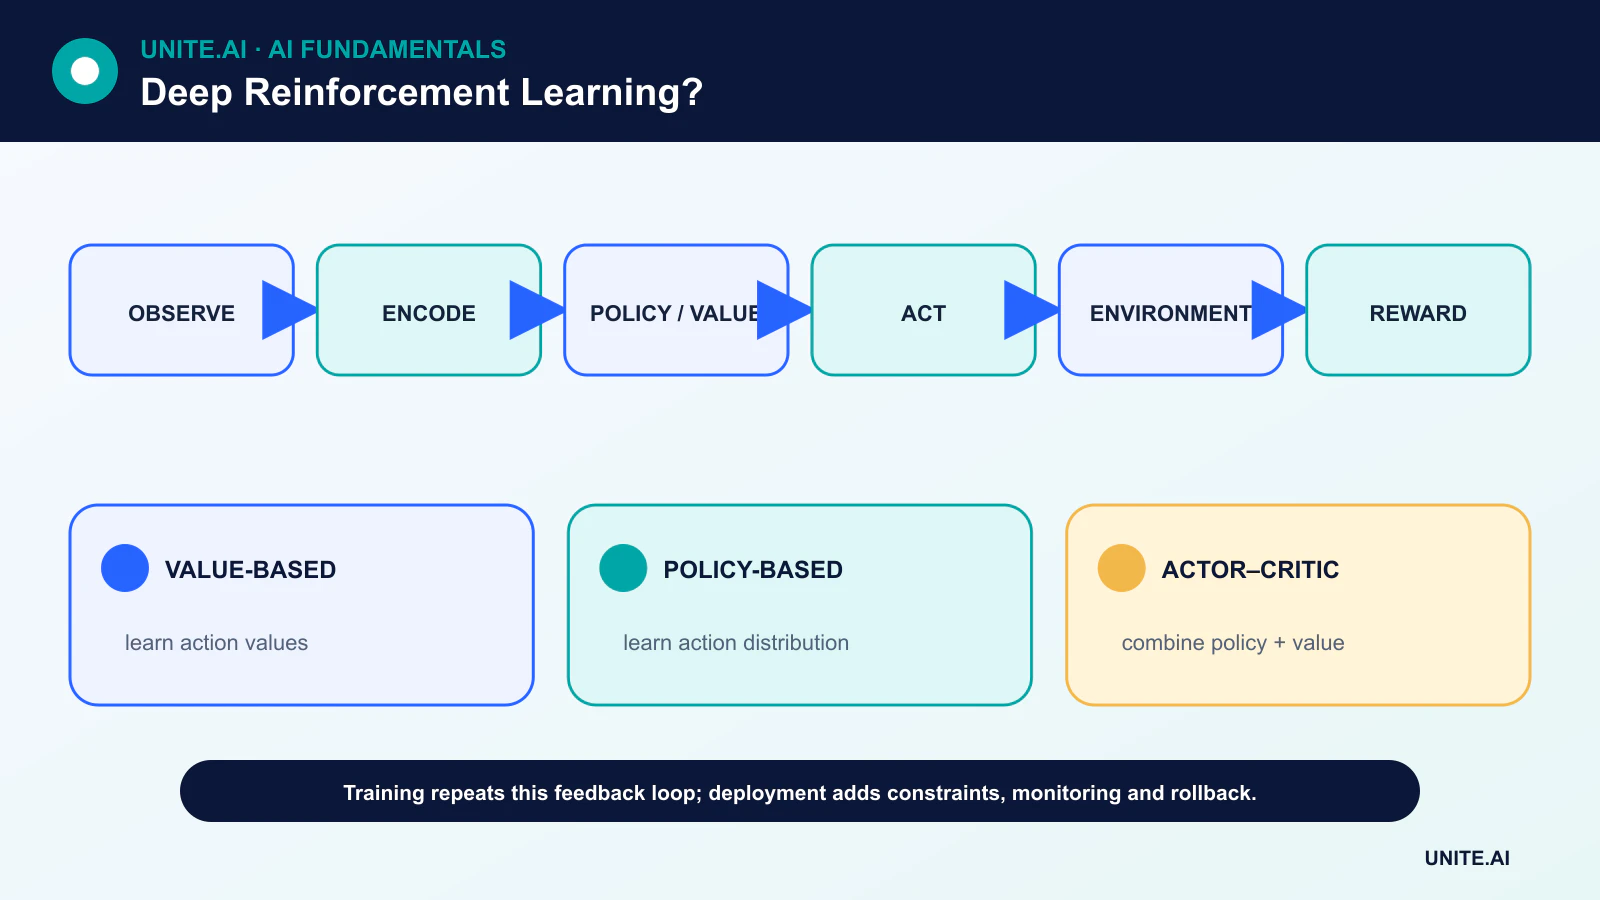
意思決定問題:状態、行動、報酬
多くの深層強化学習タスクはマルコフ決定過程としてモデル化されます。時刻 t にエージェントは状態または観測 st を受け取り、行動 at を選択し、報酬 rt+1 と次の状態を受け取ります。目的は次の報酬だけでなく、期待割引累積報酬です。
割引率は遠くの報酬の重要度を制御します。報酬関数は最適化プロセスが追求すべき目標を定義するため、不完全な代理関数は技術的には成功しても運用上好ましくない行動を引き起こすことがあります。これが報酬設計と制約テストがモデルアーキテクチャと同等に重要視される理由の一つです。
価値ベース、方策ベース、アクター・クリティック手法
価値ベースのアルゴリズムは状態価値または行動価値を推定します。Deep Q‑Network はニューラルネットワークで Q 値を近似し、通常は最高推定値の行動を選択しつつ一定の探索を保ちます。一方、方策勾配アルゴリズムは行動分布を出力するパラメータ化された方策を最適化します。
アクター・クリティックシステムは、行動を提案するアクターとその価値を推定するクリティックの両方を保持します。この設計は連続制御をサポートしますが、推定誤差の相互作用をもたらします。したがって、深層強化学習は 深層学習、勾配降下法、逆伝搬 と同じ基盤に依存しています。
リプレイバッファとターゲットネットワークが有効な理由
連続した経験サンプルは相関がありますが、ネットワークの更新は後続の更新で使用されるターゲットを変化させます。経験リプレイは古い遷移をサンプリングすることで時間的相関の一部を解消します。ターゲットネットワークはオンラインネットワークよりも遅く変化するため、ブートストラップされたターゲットの揮発性が低減します。
これらの仕組みは学習の安定性を向上させますが、チューニングは依然として重要です。学習率、探索スケジュール、報酬スケール、リプレイの構成、ネットワーク容量はすべて結果に影響します。単一の実行だけでは誤解を招く可能性があるため、複数の乱数シードでの結果を報告すべきです。
オフラインRL、モデルベースRL、シミュレーションから実環境への転移
オフラインRLは新たな相互作用を収集せず、固定されたログデータセットから学習します。探索が高コストまたは危険な場合に有用ですが、方策はログに十分に表れていない行動を回避しなければなりません。モデルベースRLは遷移モデルを学習または利用して計画を立て、追加の仮定と引き換えにサンプル効率を高めます。
ロボティクスでは、シミュレーションで学習し、物理パラメータをランダム化した後、ハードウェア上で微調整または検証を行うことが一般的です。現実との差異は、知覚、タイミング、接触ダイナミクス、未モデル化のエッジケースにおけるエラーを露呈させることがあります。強化学習システムは、摂動、分布シフト、明示的な安全制約下で評価すべきです。
評価と実装
有用な評価はトレーニング環境とテスト環境を分離し、最高スコアだけでなくリターンの分布を報告し、制約違反、介入頻度、最悪ケースの挙動を確認します。実システムでは、モニタリング、ロールバック手順、制限された行動空間、そして人間による介入が必要です。
深層強化学習は、意思決定が連続的でフィードバックが得られ、手書きの制御ルールでは不十分な場合に最も魅力的です。逆に、教師ラベルが豊富で従来の最適化手法で解決できる場合や、探索が人や資産にリスクをもたらす場合は、デフォルトとしては適しません。
深層RLアーキテクチャと学習シグナル
深層強化学習は、価値関数、方策、環境モデル、あるいはそれらの組み合わせを表現するためにニューラルネットワークを使用します。Deep Q‑Network は行動価値を予測し、時間差分(TD)ターゲットから学習します。経験リプレイは更新間の相関を低減し、ターゲットネットワークは変動する目的関数を安定化させます。方策勾配法は期待リターンを直接最適化し、アクター・クリティック法は学習したクリティックで勾配分散を減らします。連続行動では決定論的または確率的なアクター・クリティック変種が必要になることが多く、離散的で高次元な行動では慎重な探索と出力設計が求められます。
学習は非定常的です。方策が収集データを変化させるため、リプレイデータはオフポリシーになり、ブートストラップされたターゲットは現在の推定に依存し、関数近似は誤差を増幅することがあります—この組み合わせはしばしば「致命的三位一体」と呼ばれます。二重推定器は価値の過大評価を抑え、アドバンテージ関数はクレジット割り当てを改善し、エントロピー報酬は探索を促し、クリップされた目的関数は破壊的な方策更新を制限します。観測と報酬はリーク安全な状態でのみ正規化し、環境、ラッパー、行動繰り返し、終了条件、報酬前処理を記録してください。これらはすべて問題を変化させます。
評価、シミュレータ、実装時の安全性
ベストランではなく、独立したシードと環境インスタンス全体でリターン分布を報告してください。サンプル効率、制約違反、破滅的結果、報酬スケールへの感度、観測ノイズ、遅延、アクチュエータ誤差、ダイナミクス変化に対するロバスト性を評価します。スクリプト制御、古典制御、教師あり模倣、よりシンプルなRLと比較してください。環境のバリエーションを保持し、報酬なしの成果指標をテストします。エージェントはプログラムされた報酬を利用しつつ、意図したタスクに失敗することがあるためです。動画や軌跡の検査は、集計リターンで隠れた挙動を明らかにすることが多いです。
シミュレーションは探索を可能にしますが、現実との差異(リアリティギャップ)をもたらします。関連する物理と知覚をランダム化し、実測と較正し、保守的な転移を行ってください。ログデータやオフラインRLはオンライン探索を回避しますが、行動方策がサポートしない行動を信頼性をもって評価できません。実運用システムでは、行動集合、レート、リソース、作動範囲を制限し、高インパクトな行動には承認を要し、検証済みの安全コントローラまたは停止機構を組み込むべきです。方策入力、行動分布、報酬、実際の結果、介入をモニタリングし、テスト済み方策バージョンへのロールバックを行います。
具体的な制御例
倉庫ロボットのルーティングでは、状態を位置、荷重、バッテリー、近隣の交通、タスクキューから定義し、行動は許可された移動と充電判断から、報酬は完了した作業、エネルギー消費、渋滞、そして安全制約から算出します。まず需要とセンサ障害をランダム化した較正シミュレータで学習し、次に実際の意思決定をシャドウで評価します。学習した方策が衝突回避を回避しないようにしてください。スループットをニアミス、デッドロック、バッテリー緊急事態、最悪遅延と共に評価します。層化されたシステムが運用を改善し、人や機器に受容できない探索リスクを転嫁しなければプロジェクトは成功しません。
実例:データセンター冷却におけるDRL
データセンターでは、RL エージェントに許可された冷却設定点のみを使用させ、過去の天候、ワークロード、温度、機器応答から較正したシミュレータで学習させます。報酬にはエネルギー消費が含まれますが、温度、湿度、機器のサイクルに対するハード制約は別途保護されます。モデル予測制御と既存ルールをベンチマークとします。評価は季節、センサノイズ、アクチュエータ遅延、機器故障、異常負荷、複数シードにわたり、エネルギー、違反、分散、回復を報告します。
学習した方策は限定エリアでの試験前にシャドウモードで実行されます。外部安全コントローラが行動をクリップし、オペレーターが介入可能です。行動レート、状態カバレッジ、モデル不確実性、実施設備の結果をモニタリングし、シミュレータの不一致や繰り返し介入が発生した場合はロールバックします。機器や制御ロジックの更新により新しい環境バージョンと検証が作成されます。エネルギー削減は、信頼性、熱余裕、保守、障害対応がベースラインと同等以上である場合にのみ受け入れられます。
実装証拠と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、稼働環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立してください。通常ケース、境界条件、形式不正または欠損入力、分布シフト、依存障害、誤用、そして支援が不足しやすいグループや環境をテストします。タスク品質を較正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に障害を注入してモニタリングを検証してください。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間の介入、確認された結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、オフライン性能が持続すると仮定せずに、展開後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価してください。維持されたシステムは、文書化された復旧、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントも必要です。
よくある質問
深層強化学習は深層学習と同じですか?
いいえ。深層学習は関数近似器を提供し、強化学習は相互作用、報酬、そして順次決定の目的を提供します。
高い報酬はエージェントが意図した行動を学習したことを意味しますか?
必ずしもそうとは限りません。実装された報酬と環境下で高得点を得る行動を方策が見つけたという意味です。独立した安全性と目標整合性のテストは依然として必要です。
主要参考文献












