
Andersonの視点
AIを使用して実際の写真を撮影前に改善する

 Unite.AI を Google の優先ソースに追加
撮影後に生成AIで写真を直す代わりに、研究者らは、写真を記憶に残りやすくする要因についての研究知識を使い、撮影前に移動・ポーズ・構図を助言するシステムを訓練した。
メーカーや技術プラットフォームが、撮った直後に画像を変更できるカメラ内編集を増やしたため、事後修正は以前から容易になっている。代表例にはGoogleの会話型編集やSamsungの生成編集がある。
一方で、AIによる「改善」より真正性を重視する流れが生まれ、こうした機能の対象利用者が加工写真を「AIの粗製品」とみなす可能性も出てきた。
これが、GoogleがGeminiを利用し、撮影中に直接指示して写真を改善するAI訓練型の「Camera Coach」を作った背景かもしれない。
Google Camera Coachは、構図を取り直す方法などの基本的な助言を利用者に示す。出典非公開システムでオンライン情報もほとんどないが、Camera CoachはGeminiを使って構図を改善し、被写体同士を近づけたりカメラを正面から見させたりする小さな姿勢変更を提案するようだ。
分かる範囲では、Geminiの訓練に寄与した可能性のある何百万件ものアップロードを基に、構図を平均的な形へ寄せる。利用者は不満な写真を捨て、気に入った写真だけをアップロードすることで、AIの基準を事実上無料で選別したことになる。
しかし平均化された構図の写真が、記憶に残る写真と同じ美的価値や見る人への影響を持つとは限らない。
「チーズ!」と三分割法の先へ
イタリアの研究者らは、複数のプラットフォームで利用でき、写真を記憶に残す要因についての先行知識を活用するコーチ型システムを提案した。
新システムが提示した幅広い助言の例。出典MemCoachという新システムの助言には、構図中心のCamera Coachでは出しにくいものもある。最初の例で頭飾りを外すよう求める提案は特に疑問が残る。目を閉じて床に横たわる若い女性の芸術的な写真のような例も、通常の構図規則だけでは文脈を理解しにくい。
三部構成のシステムが用いる写真の記憶性は、2015年のWhat makes an object memorable?や2013年のWhat makes a photograph memorable?などの先行研究に基づく。
2013年の論文が示した、記憶性が高い・中程度・低い写真の代表例。出典先行研究は、人、屋内場面、感情表現が、物体やパノラマより強い内在的要因になるとし、文脈や観察者などの外在要因も指摘した。新プロジェクトは記憶性フィードバック(MemFeed)、それを提供するMemCoach、PPR10Kを基にしたMemBenchベンチマークを中心とする。
PPR10K人物補正データセットの多様な例。上段は原画像、下段は専門家による補正結果と人物領域マスク。原画像は視点、背景、照明、カメラ設定が大きく異なるが、補正後は画質とグループ内の一貫性が向上している。出典論文は、記憶性を主観的判断の集積ではなく写真で定量化できる特性とみなす。この特性は写真だけでなく動画でも複数の研究によって確認されている。
論文名はHow to Take a Memorable Picture? Empowering Users with Actionable Feedbackで、University of Trento、University of Pisa、Fondazione Bruno Kesslerの研究者4人による。プロジェクトページはGitHubコードとHugging Face上のデータを2026年3月に公開する予定だとしている。
方法
PPR10K人物写真データセットからMemBenchを作るため、研究者らは同じ場面の写真をまとめ、CLIP特徴を用いた訓練済み予測器で各画像の記憶性を採点した。その後、場面内で記憶性の低い写真から高い写真へ順位づけし、対を作った。
MemBenchの構築と評価。上段は場面ごとの画像グループ化、記憶性予測、順位づけ、記憶性を意識した行動助言の生成へ進むデータ工程。下段は編集による記憶性向上とperplexityで助言の品質を測る評価工程。各ペアについてInternVL3.5が、記憶性の低い版と高い版の目に見える違いを自然言語で説明し、その説明が記憶性フィードバックシステムの訓練信号になった。
Google Camera Coachの考え方とは異なり、「画像を明るくする」のような事後補正ではなく、「互いの方を向く」のように撮影者がその場で実行できる意味的行動を目標にした。
最終的なMemBenchは約1万枚を1,570場面にまとめ、1場面平均6.5枚を含む。研究者らの単語雲は、データに幅広い意味カテゴリがあることを示す。
MemBenchで最も頻繁に現れる語のワードクラウド。元写真の記憶性平均は0.63だった。同じ場面で最も記憶に残る写真の点数は0.51から1.0に分布し、二つのグループには目立つ重なりもあった。
各場面で最も記憶性が低い画像と高い画像の得点分布。助言は7語の短い指示からかなり長いものまで幅があり、GPT-5 Miniで小さな行動単位へ分解した。
内容語で測った助言の長さと、原子的な下位行動の分類。結びつきの幅はカテゴリ同士が共起する頻度を示す。提案の大半は被写体のポーズに関するもので、次いで意味や場面内容の変更が多かった。構図はポーズと、照明調整は意味的変更と組み合わされる傾向があった。
FLUXによる助言効果の模擬評価
助言で記憶性が増すかを調べるため、FLUX.1 Kontext生成モデルを撮影者の代理として使った。元画像と文章による助言を与え、提案された変更を模擬した編集画像を生成した。
左はデータセットの実画像、右は下の黄色いプロンプトからFLUXが作った画像。大規模な人手を使わずに助言の効果を評価でき、将来は実写例を用いてシステムを反復改善できる流れを示す。元画像と編集画像の両方を記憶性予測器に通した。編集版の点数が上がった頻度をImprovement Ratio、開始画像に対する増加幅をRelative Memorabilityとした。
正解説明に対するperplexityで、記憶性に焦点を当てた参照助言との類似性も測った。場面単位で80対20に分割し、訓練に使わなかった場面だけで試験した。
既存マルチモーダルモデルの限界
現在のマルチモーダル大規模言語モデルが記憶性を理解するかを見るため、LaMem画像を複数の主要モデルに示し、記憶に残るかを尋ねた。モデルの確信度を元研究の人間評価と比較した。
基準マルチモーダルモデルが記憶性を捉えないことを示す試験。左は予測とLaMem正解のSpearman順位相関で、人間評価者間の一致度も参考表示した。右は編集基準に対するゼロショット助言のImprovement Ratioで、改善はわずかだった。人間判断との意味ある相関はほとんど見られなかった。大規模な事前訓練にもかかわらず、モデルは人が一貫して覚える要素を追跡できなかった。
LaMemデータセットの例。左上の画像にはヒートマップも表示されている。出典MemCoach
MemCoachはシャッターを押す前に実行できる意味的指示に集中する。ポーズ、被写体同士の関わり、場面要素を変更する指示である。助言の長さは内容語で7~102語だった。論文は、単純な構図修正より被写体配置と物語的手掛かりが記憶性を強く左右すると考える。
MemCoachの工程。記憶性を理解した教師MLLMの助言と中立的な生徒応答を対照データにし、層ごとの活性化差を平均して記憶性ステアリングベクトルを得る。推論時にそのベクトルを注入し、追加訓練なしで生徒の活性化を、より良い記憶性助言の方向へ移動させる。試験
試験にはQwen2.5-VL、InternVL3.5-8B、Idefics3-8B、LLaVA-OneVision-1.5、非公開モデルGPT-5 Mini、美学特化型Q-InstructとAesExpertの7つのMLLMを使った。各モデルはゼロショット基準または教師オラクルとして動作した。
InternVL3.5は教師と生徒の両方に使い、MemBenchの訓練分割から対照例を作った。
MemCoachと最新MLLM、教師オラクル、美学特化モデル、ゼロショット基準の比較。MemCoachは高いImprovement Ratio、競争力のあるRelative Memorability、最も低いperplexityを示し、一貫して記憶性を意識した助言を生成した。MemCoachは比較モデルのどれより効果的な記憶性助言を出した。ステアリングしたInternVL3.5はGPT-5 MiniよりImprovement Ratioが5%高く、未調整版よりRelative Memorabilityが31.81%上昇した。
追加訓練なしで美学特化システムも上回った。低いperplexityは、人間の記憶性判断が好む言語パターンに助言がより近いことを示す根拠とされた。
一般化結果。MemCoachは複数のマルチモーダル基盤でImprovement RatioとRelative Memorabilityを一貫して高め、多くのモデルでperplexityも下げた。追加試験でも全てのマルチモーダル基盤で記憶性助言が改善した。Improvement Ratioは一貫して上がり、Qwen2.5-VLとLLaVA-OVで最大の上昇が見られた。
定性評価では元画像、自然言語助言、想定した改善結果を並べて調べた。
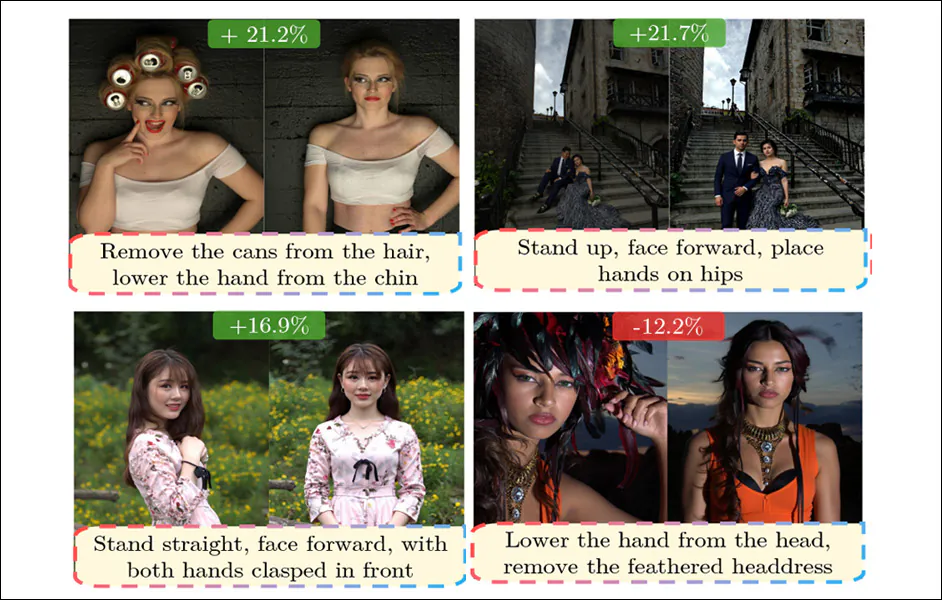
MemCoachの記憶性助言例。各組は元画像、自然言語指示、編集結果を示し、Relative Memorabilityで変化を表す。ポーズや視線の調整から物体除去まで含み、改善例と、珍しい要素を消したため記憶性が下がった例の両方がある。著者らによれば、視線、ポーズ、手の位置といった細かな構図変更から、物体除去や表情変更のような意味的介入まで提案は多様だった。「近づける」「立つ」「取り除く」といった動詞中心の短く解釈可能な指示で、記憶に残る写真の撮り方を直接実行できる言葉にした。
結論
Googleの非公開Camera CoachとMemBenchの方法を比較できれば興味深い。特にGoogleがシステムの美的基準を決めるために使った中心的規範、参照資料、データベースを知りたいところだ。
公開・非公開を問わず、この種のシステムは大規模に使われると均一な基準を押しつけ、ミームや陳腐な型を生む危険がある。これは「正しい」手順が日常文ではかえって嫌われるようになったAIのem dash論争を視覚化したような問題である。
* 他でリンクが示されていない場合、筆者が著者の文中引用をハイパーリンク化した。
† 論文は複数箇所で補足資料に言及するが、論文、Arxivの一覧、プロジェクトサイトのいずれでも見つけられなかった。
2026年2月26日初出。


