
Andersonの視点
小さなディープフェイクがより大きな脅威となる可能性がある

 Unite.AI を Google の優先ソースに追加
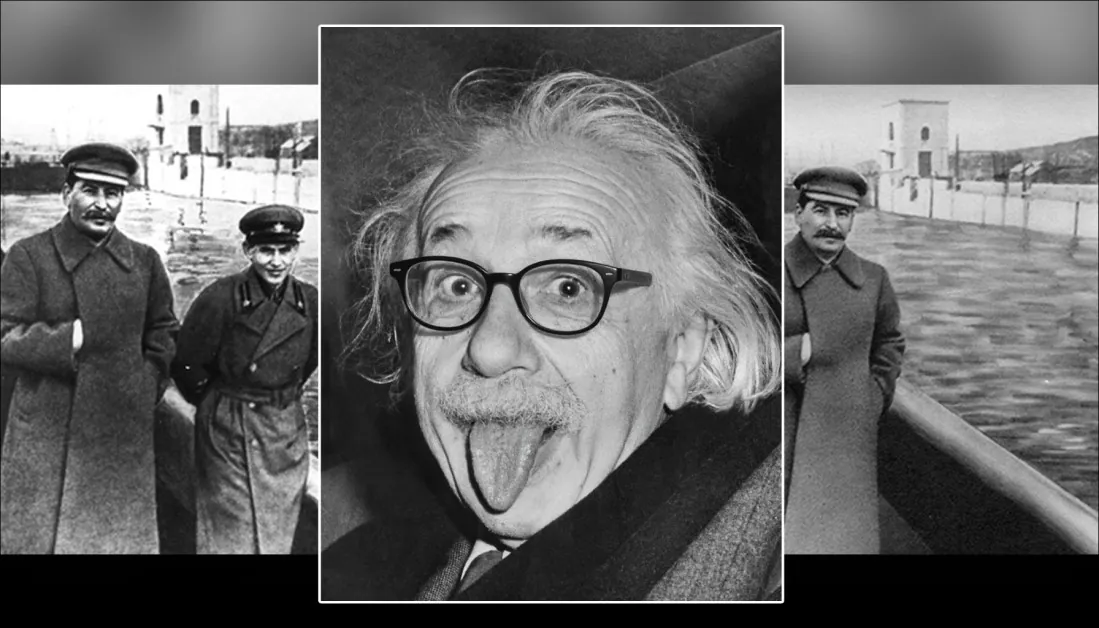
会話型AIツールであるChatGPTやGoogle Geminiは、顔の交換ではなく、より繊細な方法で画像の中の物語を書き換えるために使用されています。ジェスチャー、プロップ、背景を変更することで、これらの編集は、AI検出ツールと人間の両方を欺き、オンラインでのリアルなものを見分けるためのリスクを高めています。
現在の状況では、特にTAKE IT DOWN法案のような重大な法律の影響を受けて、多くの人々はディープフェイクやAI駆動のアイデンティティ合成を、非同意のAIポルノや政治的操作と関連付けます。一般的に、重大な真実の歪曲です。
これにより、私たちは、AI操作された画像が常に高リスクのコンテンツを狙っていることを期待するようになります。レンダリングの品質とコンテキストの操作が、少なくとも短期的には、信頼性のクーポンを達成する可能性があります。
しかし、歴史的には、はるかに繊細な変更が、より陰険で持続的な影響を及ぼしてきました。たとえば、スターリンの時代の写真トリックは、スターリンが好ましくない人々を写真記録から除去することを可能にしました。ジョージ・オーウェルの小説『1984年』では、ウィンストン・スミスは、歴史を書き換え、写真を作成、破壊、修正する日々を過ごします。
以下の例では、2番目の写真の問題は、私たちが何を知らないかを知らないことです。スターリンの秘密警察の元責任者、ニコライ・エジョフが、安全柵で隠れたスペースを占めていたということです。
<img class=" wp-image-218824" src="https://www.unite.ai/wp-content/uploads/2025/06/stalin-photo-trickery.jpg" alt="今見え、今見えません… スターリン時代の写真操作は、失脚した党員を歴史から抹消します。ソース:パブリックドメイン、https://www.rferl.org/a/soviet-airbrushing-the-censors-who-scratched-out-history/29361426.htmlより” width=”881″ height=”301″ /> 今見え、今見えません… スターリン時代の写真操作は、失脚した党員を歴史から抹消します。 ソース:パブリックドメイン、https://www.rferl.org/a/soviet-airbrushing-the-censors-who-scratched-out-history/29361426.htmlより
このような流れは、繰り返し続けられ、文化的にもコンピュータービジョンにも影響しています。コンピュータービジョンは、トレーニングデータセット内の統計的に支配的なテーマやモチーフからトレンドを導き出します。例えば、スマートフォンが写真撮影への障壁を低下させ、大幅にコストを下げたことは、アイコンの表現が多くの抽象的な概念と密接に結びつくことになりました。たとえば、不適切な時代にiPhoneが描かれることもあります。
欠落していたデータセット構築と評価結果
MultiFakeVerseはEMOTIC、PISC、PIPA、PIC 2.0という人物中心の実画像データセットを出発点とする。86,952枚の原画像から758,041枚の改変画像を作り、合計845,826枚を収録した。Gemini-2.0-FlashとChatGPT-4oに、画像内で最も目立つ人物を「素朴」「誇らしげ」「後悔している」「未熟」「無頓着」に見せる、または場面の事実関係を変える最小限の編集案を各画像につき六つ提案させた。
編集対象を曖昧にしないため、モデルは人物や物体を特定する参照表現も生成した。実際の画像編集にはGPT-Image-1、Gemini-2.0-Flash-Image-Generation、ICEditを比較し、22,000枚の試作ではGeminiが最も自然に周囲へ溶け込む編集を作った。ICEditは改変領域に目立つ欠陥が出やすく、GPT-Image-1は固定アスペクト比の影響で意図しない部分まで変えることがあった。
改変範囲と意味の変化
原画像と改変画像のピクセル差から微小なランダムノイズを除き、意味のある編集範囲を測った。ごく小さな領域だけが変わる画像もあれば、場面の最大80%が変わる例もあった。ShareGPT-4Vで両画像の説明文を生成し、Long-CLIP埋め込みで意味の距離を比較したところ、人物の近くにある物や本人が扱う物の変更が、面積が小さくても解釈を大きく変える傾向があった。
編集は人物レベル、物体レベル、場面レベルの三種類に分類された。人物レベルは表情、姿勢、視線、衣服など、物体レベルは手に持つ物や前景で関わる物、場面レベルは背景や設定全体を指す。約3分の1は人物だけ、約5分の1は場面だけ、約6分の1は物体だけを変更しており、一枚に複数の種類が含まれることもあった。
知覚への影響と画質
Gemini-2.0-Flashで感情、個人のアイデンティティ、力関係、場面の物語、改変意図、倫理的懸念の六領域を評価した。編集は人物を「喜んでいる」「親しみやすい」「若い」「遊び好き」「弱い立場」に見せたり、場面をより専門的に見せたりした。意図は説得的、欺瞞的、美的などに分類され、多くは軽度の倫理的懸念とされたが、中度または重大と評価された少数例もあった。
画質指標はSSIM 0.5774、FID 3.30、PSNR 66.30デシベルだった。SSIMは大部分を保ちながら局所編集する目的に合う中程度の類似性を示し、低いFIDは高い品質と多様性、PSNRは改変後も良好な視覚忠実度が残ることを示した。
人間による判定と作成コスト
18人に実画像と改変画像を半数ずつ含む50枚を見せたところ、真偽判定の正解率は61.67%で、3分の1を超える画像が誤分類された。偽画像で改変領域を当てた結果と正解領域のIoUは平均24.96%にすぎず、人間にも局所的な編集位置の特定が難しいことが分かった。
編集指示の生成にはGeminiとGPTへ84万5千回を超えるAPI呼び出しを行い、約1,000ドルを要した。Geminiによる画像生成は約2,867ドル、GPT-Image-1は約200ドルだった。ICEditはNVIDIA A6000 GPU上でローカル実行され、約24時間で処理を終えた。
検出器の試験
原画像を訓練70%、検証10%、試験20%に分け、各原画像から作った改変版を必ず同じ集合に入れた。画像全体の真偽には精度とF1、改変領域の位置にはAUC、F1、IoUを用いた。CnnSpot、AntifakePrompt、TruFor、VLMベースのSIDAをゼロショットで評価し、CnnSpotとSIDAはMultiFakeVerseで追加学習した。
従来のインペインティング偽画像で訓練されたモデルはVLM編集を見抜けず、CnnSpotはほぼ全画像を本物と判断した。ゼロショットではAntifakePromptがクラス平均精度66.87%、F1 55.55%で最良だった。追加学習後はCnnSpotとSIDA-13Bの双方が改善し、CnnSpotがSIDAを平均精度で1.92ポイント、F1で1.97ポイント上回った。
SIDA-13Bの改変位置特定はゼロショットでIoU 13.10、F1 19.92、AUC 14.06だった。追加学習後はそれぞれ24.74、39.40、37.53まで向上したが、それでも小さく意味のある編集がどこに行われたかを正確に示す能力は低かった。
MultiFakeVerse
オーストラリアの研究者は、繊細なディープフェイクに対する文献での注目不足に対処するために、人を中心とした画像操作の新しいデータセットを作成しました。このデータセットでは、コンテキスト、感情、物語を変更する編集が行われますが、主体の基本的なアイデンティティは変更されません。
<img class=" wp-image-218825" src="https://www.unite.ai/wp-content/uploads/2025/06/details.jpg" alt="新しいコレクションからサンプル、リアル/フェイクのペア、編集の程度はさまざまです。たとえば、アジアの女性の医者の聴診器がAIによって除去され、権威が失われていることがわかります。一方、医者のノートをクリップボードに置き換える編集には、明らかな意味的な角度がありません。ソース:https://huggingface.co/datasets/parulgupta/MultiFakeVerse_preview” width=”884″ height=”429″ /> 新しいコレクションからサンプル、リアル/フェイクのペア、編集の程度はさまざまです。たとえば、アジアの女性の医者の聴診器がAIによって除去され、権威が失われていることがわかります。一方、医者のノートをクリップボードに置き換える編集には、明らかな意味的な角度がありません。 ソース:https://huggingface.co/datasets/parulgupta/MultiFakeVerse_preview
このコレクションは、MultiFakeVerseと呼ばれ、ビジョン言語モデル(VLMs)を使用して生成された845,826枚の画像で構成されています。これらの画像は、オンラインでアクセスおよびダウンロードできます。また、許可を得た場合にもアクセスできます。
方法
MultiFakeVerseデータセットは、4つの現実世界の画像セットから構成されています。これらの画像セットには、さまざまな状況にある人々が含まれています。研究者は、86,952枚の元の画像から、758,041枚の操作された画像を生成しました。
Gemini-2.0-FlashおよびChatGPT-4oフレームワークを使用して、各画像に6つの最小限の編集を提案しました。これらの編集は、画像の中で最も目立つ人物の認識を微妙に変更するように設計されています。
画像分析
各操作された画像は、変更された画像の量を決定するために、元の画像と比較されました。2つのバージョン間のピクセルレベルの違いは計算され、小さなランダムノイズはフィルタリングされ、意味のある編集に焦点が当てられました。
編集された画像のキャプションは、ShareGPT-4Vビジョン言語モデルを使用して生成され、Long-CLIPを使用して埋め込みに変換され、コンテンツの違いを比較することができました。
認知的影響の評価
Gemini-2.0-Flashを使用して、操作が6つの認知的影響領域で視聴者の認識をどのように変更するかを評価しました。
編集は、感情、個人のアイデンティティ、権力構造、シーンの物語、操作の意図、倫理的懸念の6つの側面で視聴者の認識を変更することが示されました。
メトリクス
MultiFakeVerseコレクションの視覚的な品質は、3つの標準的なメトリクスを使用して評価されました。
これらのメトリクスは、生成された画像の品質を評価するために使用されました。
ユーザー研究
ユーザー研究を実施して、MultiFakeVerseの繊細なフェイクを人間がどれだけ見つけられるかを調べました。
18人の参加者は、50枚の画像を表示され、画像がリアルかフェイクかを判断するように求められました。さらに、フェイクの場合は、どのような操作が行われたかを特定するように求められました。
テスト
テストの前に、データセットはトレーニング、検証、テストセットに分割されました。
各画像の操作された領域の検出を評価するために、面積下の曲線、F1スコア、交差係数を使用しました。
結論
新しい研究は、人間と機械の認識における盲点を暴露しています。ディープフェイクに関する公共の議論の大部分は、見出しを飾るアイデンティティの交換に焦点を当てていますが、これらのより静かな「物語の編集」は、検出がより難しく、長期的にはより腐食性である可能性があります。
システムがこのようなコンテンツの生成に更加積極的に参加し、私たち自身が写真ストリームの現実を変更することに更加参加するにつれて、粗い操作を検出することに頼る検出モデルは、不十分な防御を提供する可能性があります。
MultiFakeVerseが示すのは、検出が失敗したということではなく、問題の少なくとも一部が、より困難で、よりゆっくり進行する形態に移行している可能性があることです。小さな視覚的な嘘が気づかれずに蓄積する形態です。
初めて公開:2025年6月5日木曜日
原文から復元した図


出典と参考リンク


