
एआई की मूल बातें
मेटा-लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
Meta-learning एक प्रणाली को कार्यों के वितरण पर प्रशिक्षित करता है ताकि वह सीमित डेटा या गणना का उपयोग करके किसी नए, संबंधित कार्य के साथ अनुकूलित हो सके। इसे अक्सर “सीखने के लिए सीखना” कहा जाता है, लेकिन तकनीकी लक्ष्य अधिक सटीक है: शिक्षार्थी को अनुकूलित करना ताकि पहले के कार्यों के अनुभव से बाद के कार्य में अनुकूलन बेहतर हो।
Meta-learning few-shot learning और transfer learning के साथ ओवरलैप करता है, लेकिन ये शब्द एक‑दूसरे के स्थान पर उपयोग नहीं किए जा सकते। Few-shot लक्ष्य डेटा की मात्रा को दर्शाता है; transfer पुनः उपयोग को दर्शाता है; Meta-learning स्पष्ट रूप से कार्यों के बीच अनुकूलन को प्रशिक्षण का हिस्सा बनाता है।
मुख्य बिंदु
- Meta‑प्रशिक्षण कई कार्यों का उपयोग करता है, न कि केवल कई स्वतंत्र उदाहरणों का।
- एक N-way K-shot एपिसोड में N वर्ग होते हैं और प्रत्येक वर्ग के लिए K लेबल्ड सपोर्ट उदाहरण होते हैं।
- ग्रेडिएंट‑आधारित, मीट्रिक‑आधारित, मेमोरी‑आधारित, और लर्न्ड‑ऑप्टिमाइज़र विधियाँ विभिन्न तरीकों से अनुकूलित होती हैं।
- प्रदर्शन बहुत हद तक इस बात पर निर्भर करता है कि Meta‑प्रशिक्षण कार्य लक्ष्य कार्य के समान हैं या नहीं।
कार्य, सपोर्ट सेट और क्वेरी सेट
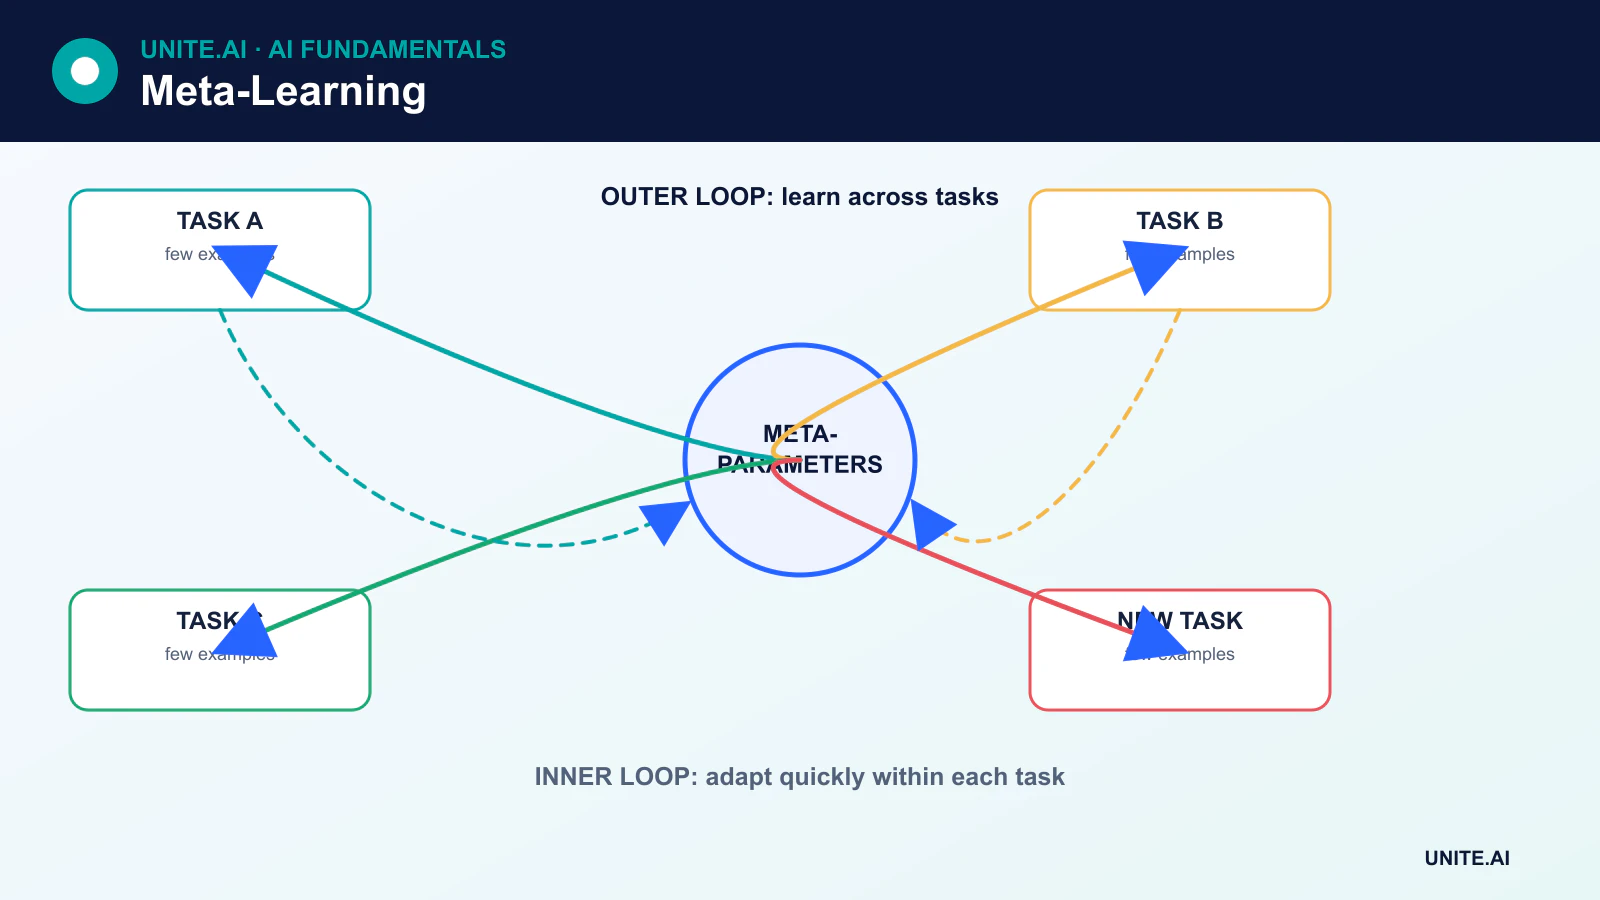
Meta‑learning डेटासेट कार्यों के रूप में व्यवस्थित होता है। Few‑shot वर्गीकरण में, एक एपिसोड 5-way 1-shot: पाँच वर्ग, प्रत्येक वर्ग के लिए एक लेबल्ड सपोर्ट उदाहरण, और अनुकूलन का मूल्यांकन करने के लिए अतिरिक्त क्वेरी उदाहरण हो सकते हैं। एक 5-way 5-shot कार्य में प्रत्येक पाँच वर्गों के लिए पाँच सपोर्ट उदाहरण होते हैं—कुल पाँच उदाहरण नहीं।
Meta‑प्रशिक्षण के दौरान, शिक्षार्थी लगातार सपोर्ट सेट पर अनुकूलित होता है और क्वेरी सेट पर मूल्यांकन किया जाता है। बाहरी उद्देश्य कार्यों के बीच भविष्य के क्वेरी प्रदर्शन को सुधारता है। Meta‑validation अलग‑अलग कार्यों पर विकल्पों को ट्यून करता है, और Meta‑testing वास्तविक रूप से अनदेखे कार्यों या वर्गों का मूल्यांकन करता है।
ग्रेडिएंट‑आधारित मेटा‑लर्निंग
Model-Agnostic Meta-Learning (MAML) एक प्रारंभिक बिंदु सीखता है जिससे कुछ gradient कदमों से नया कार्य पर अच्छा प्रदर्शन प्राप्त होता है। आंतरिक लूप सपोर्ट डेटा का उपयोग करके मॉडल पैरामीटर को अनुकूलित करता है। बाहरी लूप चयनित कार्यों में क्वेरी लॉस का उपयोग करके साझा प्रारंभिक बिंदु को अपडेट करता है।
MAML केवल वर्गीकरण तक सीमित नहीं है; जब मॉडल और कार्य विभेद्य होते हैं, तो इसे प्रतिगमन और reinforcement learning पर लागू किया जा सकता है। Reptile एक सरल प्रथम‑क्रम दृष्टिकोण प्रदान करता है जो पूर्ण MAML मेटा‑ग्रेडिएंट की गणना किए बिना पैरामीटर को कार्य‑अनुकूलित समाधान की ओर ले जाता है।
मीट्रिक‑आधारित मेटा‑लर्निंग
मीट्रिक‑आधारित विधियाँ एक एम्बेडिंग सीखती हैं जिसमें समान वर्ग के उदाहरण निकट होते हैं और विभिन्न वर्ग अलग होते हैं। एक प्रोटोटाइपिकल नेटवर्क सपोर्ट एम्बेडिंग का औसत लेकर प्रत्येक वर्ग के लिए एक प्रोटोटाइप बनाता है, फिर क्वेरी को उन प्रोटोटाइपों की दूरी के आधार पर वर्गीकृत करता है।
Matching और Siamese‑शैली के नेटवर्क संबंधित समानता तंत्र का उपयोग करते हैं। ये विधियाँ केवल यह जांच नहीं करतीं कि मॉडल “लक्ष्य मीट्रिक को हिट करता है” या नहीं; सीखी गई दूरी या प्रतिनिधित्व स्वयं भविष्यवाणी प्रक्रिया का हिस्सा होती है।
मेमोरी‑आधारित विधियाँ और लर्न्ड ऑप्टिमाइज़र
मेमोरी‑आधारित सिस्टम वर्तमान कार्य के बारे में जानकारी संग्रहीत करने के लिए पुनरावर्ती या अटेंशन‑आधारित स्थिति का उपयोग करते हैं। लर्न्ड ऑप्टिमाइज़र ग्रेडिएंट या प्रशिक्षण संकेतों को इनपुट के रूप में लेकर दूसरे मॉडल को अपडेट करना सीखते हैं। ये विधियाँ अनुकूलन नियम खोज सकती हैं, लेकिन वे पैरामीटर, गणना, और संभावित ओवरफ़िटिंग का एक अतिरिक्त स्तर जोड़ती हैं।
Meta-learning और इन‑कॉन्टेक्स्ट लर्निंग
बड़े transformers प्रॉम्प्ट में प्रदान किए गए उदाहरणों से अपने आउटपुट को बिना वज़न अपडेट किए अनुकूलित कर सकते हैं। इसे इन‑कॉन्टेक्स्ट लर्निंग कहा जाता है। यह Meta‑learning व्यवहार से मिलता‑जुलता है, और प्रशिक्षण डेटा कार्य अनुमान को प्रोत्साहित कर सकता है, लेकिन एक इन‑कॉन्टेक्स्ट लर्नर स्वचालित रूप से क्लासिकल एपिसोडिक Meta‑learning उद्देश्य के साथ प्रशिक्षित नहीं होता।
Meta-learning कहाँ उपयोगी है
संभावित अनुप्रयोगों में व्यक्तिगतकरण, रोबोटिक्स, कम‑संसाधन पहचान, कम मापों वाले वैज्ञानिक कार्य, और नए वातावरण में तेज़ अनुकूलन शामिल हैं। Meta‑learning सबसे आकर्षक तब होता है जब कई संबंधित स्रोत कार्य उपलब्ध हों लेकिन लक्ष्य कार्य का डेटा दुर्लभ हो।
सीमाएँ
Meta‑learning कम्प्यूटेशनली महंगा हो सकता है क्योंकि प्रशिक्षण में अनुकूलन को अनुकूलन के भीतर नेस्ट किया जाता है। परिणाम कार्य निर्माण, सपोर्ट/क्वेरी लीक, आर्किटेक्चर, और डोमेन शिफ्ट के प्रति संवेदनशील होते हैं। संकीर्ण, समान कार्यों पर प्रशिक्षित मॉडल उस वितरण के बाहर खराब अनुकूलित हो सकता है।
तुलनाओं में सामान्य ट्रांसफ़र‑लर्निंग और मल्टीटास्क बेसलाइन शामिल होनी चाहिए। एक मजबूत प्री‑ट्रेंड प्रतिनिधित्व जिसके बाद मानक फाइन‑ट्यूनिंग हो, वह समर्पित Meta‑learning एल्गोरिदम से सरल और अधिक प्रभावी हो सकता है।
कार्य, अनुकूलन, और आंतरिक‑बाहरी अनुकूलन संरचना
Meta‑learning कार्यों के वितरण पर प्रशिक्षण करता है ताकि एक शिक्षार्थी सीमित डेटा या अपडेट के साथ नए कार्य के साथ अनुकूलित हो सके। प्रत्येक एपिसोड एक कार्य चुनता है, उदाहरणों को अनुकूलन के लिए सपोर्ट सेट और मूल्यांकन के लिए क्वेरी सेट में विभाजित करता है, और एपिसोड के बीच साझा ज्ञान को अपडेट करता है। मीट्रिक‑आधारित विधियाँ एम्बेडिंग और तुलना नियम सीखती हैं; अनुकूलन‑आधारित विधियाँ प्रारंभिक बिंदु या अपडेट व्यवहार सीखती हैं; मेमोरी और मॉडल‑आधारित विधियाँ कार्य उदाहरणों पर निर्भर करती हैं। कार्य वितरण वास्तविक प्रशिक्षण डेटा है और इसे भविष्य के अनुकूलन समस्याओं के समान होना चाहिए।
Model‑agnostic Meta‑learning में, एक आंतरिक लूप सपोर्ट उदाहरणों पर पैरामीटर को अनुकूलित करता है और एक बाहरी लूप अनुकूलन के बाद क्वेरी उदाहरणों पर प्रदर्शन को ऑप्टिमाइज़ करता है। उच्च‑क्रम ग्रेडिएंट महंगे हो सकते हैं; प्रथम‑क्रम अनुमान लागत के लिए सटीकता का समझौता करते हैं। प्रोटोटाइपिकल नेटवर्क प्रत्येक वर्ग को सपोर्ट‑सेट के सेंट्रॉइड द्वारा दर्शाते हैं और दूरी के आधार पर वर्गीकृत करते हैं। ये विधियाँ मानती हैं कि वर्ग ज्यामिति, अनुकूलन कदम, और एपिसोड निर्माण तैनाती को प्रतिबिंबित करते हैं। एक विधि तेज़ सीखने का दिखावा कर सकती है जबकि स्थिर लेबल, अधिग्रहण कलाकृतियों, या स्रोत डेटासेट के बीच ओवरलैप का फायदा उठाती है।
मूल्यांकन, बेसलाइन, और वास्तविक‑दुनिया की सीमाएँ
प्रशिक्षण, मान्यकरण, और परीक्षण कार्यों को अलग‑अलग रखें—केवल उदाहरण नहीं—ताकि वास्तविक अनदेखे कार्यों पर अनुकूलन मापा जा सके। शॉट्स और अनुकूलन कदमों के अनुसार सटीकता या लॉस रिपोर्ट करें, कार्यों के बीच विश्वसनीय अंतराल, गणना, मेमोरी, और सपोर्ट‑सेट संरचना के प्रति संवेदनशीलता। ट्रांसफ़र लर्निंग, प्री‑ट्रेंड मॉडल का फाइन‑ट्यूनिंग, निकटतम पड़ोसी, और सभी स्रोत डेटा पर संयुक्त रूप से प्रशिक्षित मॉडल के साथ तुलना करें। कई स्पष्ट Meta‑learning लाभ घटते हैं जब बेसलाइन को समान बैकबोन, ऑगमेंटेशन, और ट्यूनिंग मिलती है।
वास्तविक तैनाती को यह पहचानने का तरीका चाहिए कि नया कार्य Meta‑training वितरण से बाहर है या नहीं। खराब या गलत लेबल वाले सपोर्ट उदाहरण तेज़, आत्मविश्वासी विफलता का कारण बन सकते हैं। अपडेट की मात्रा सीमित करें, अनुकूलित मॉडलों को मान्य करें, एक बैकअप रखें, और अनुकूलन डेटा को विषाक्तता से बचाएँ। बेस मॉडल, कार्य सैंपलर, एपिसोड सीड, और अनुकूलन कोड को ट्रैक करें। Meta‑learning छोटे‑डेटा समस्याओं के पुनरावृत्त परिवारों के लिए उपयोगी है, लेकिन यह मनमाने उदाहरणों से सामान्य सीखने की क्षमता नहीं बनाता और डोमेन‑विशिष्ट मूल्यांकन की आवश्यकता को नहीं हटाता।
व्यावहारिक उदाहरण: मशीनों में few-shot अनुकूलन
एक निर्माता प्रत्येक मशीन प्रकार को एक कार्य के रूप में मानता है और कई मशीनों में सत्यापित रखरखाव परिणामों के साथ एक विसंगति प्रतिनिधित्व पर Meta‑training करता है। परीक्षण मशीनों को कार्य प्रशिक्षण से पूरी तरह बाहर रखा जाता है। नई मशीन के लिए, एक छोटा सपोर्ट सेट सामान्य संचालन मोड को कवर करता है न कि मनमाने मिनटों के डेटा को। Meta‑learning को प्री‑ट्रेंड फ्रीज़्ड एन्कोडर, निकटतम पड़ोसी, और समान सपोर्ट उदाहरण और गणना का उपयोग करके सामान्य फाइन‑ट्यूनिंग के साथ तुलना किया जाता है।
मूल्यांकन कई सपोर्ट चयन दोहराता है और घटना पुनःस्मरण, झूठी अलार्म, अनुकूलन समय, और वैरिएंस रिपोर्ट करता है। सिस्टम तब abstain करता है जब नई मशीन का सेंसर सेट या डायनेमिक्स कार्य वितरण से बाहर हो। अनुकूलन अपडेट सीमित होते हैं और रखरखाव पर प्रभाव डालने से पहले समीक्षा किए जाते हैं। सपोर्ट लेबल और मशीन पहचान को विषाक्तता से सुरक्षित रखा जाता है, और प्रत्येक अनुकूलित मॉडल अपनी बेस संस्करण और उदाहरणों को बरकरार रखता है। तेज़ अनुकूलन केवल तभी स्वीकार्य है जब वह वास्तविक कार्य शिफ्ट के तहत सरल ट्रांसफ़र को लगातार मात दे।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को केवल सफल प्रदर्शन से अधिक चाहिए। उपयोगकर्ता, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, खराब या अनुपलब्ध इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक underserved समूह या वातावरण का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि स्वतंत्र समीक्षक परिणाम को पुनरुत्पादित कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित बैकअप रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया जिम्मेदार को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑दुनिया के प्रमाण की समीक्षा करें, न कि यह मानें कि ऑफ़लाइन प्रदर्शन बना रहेगा। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या उद्देश्यों में परिवर्तन होने पर पुनर्मूल्यांकन करें। एक बनाए रखा सिस्टम दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, विलोपन और रखरखाव प्रक्रियाएँ, और स्पष्ट बिंदु भी चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या few-shot प्रॉम्प्टिंग meta-learning है?
Few-shot प्रॉम्प्टिंग एक इन‑कॉन्टेक्स्ट अनुकूलन तकनीक है। यह कार्यों के बीच सीखने से जुड़ा व्यवहार दिखा सकती है, लेकिन यह सपोर्ट/क्वेरी एपिसोड या स्पष्ट meta‑ऑप्टिमाइज़ेशन लूप के साथ स्वचालित रूप से प्रशिक्षित नहीं होती।
Meta-learning का सबसे बड़ा जोखिम क्या है?
Meta‑training कार्यों और लक्ष्य कार्य के बीच असंगति तेज़ अनुकूलन को बेंचमार्क में मजबूत दिखा सकती है, लेकिन तैनाती में विफल हो सकती है। कार्य विभाजन और स्रोत उत्पत्ति को सामान्य train/test विभाजन की तरह ही सावधानीपूर्वक ऑडिट करना आवश्यक है।
मुख्य संदर्भ











