एआई की मूल बातें
रिइन्फोर्समेंट लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
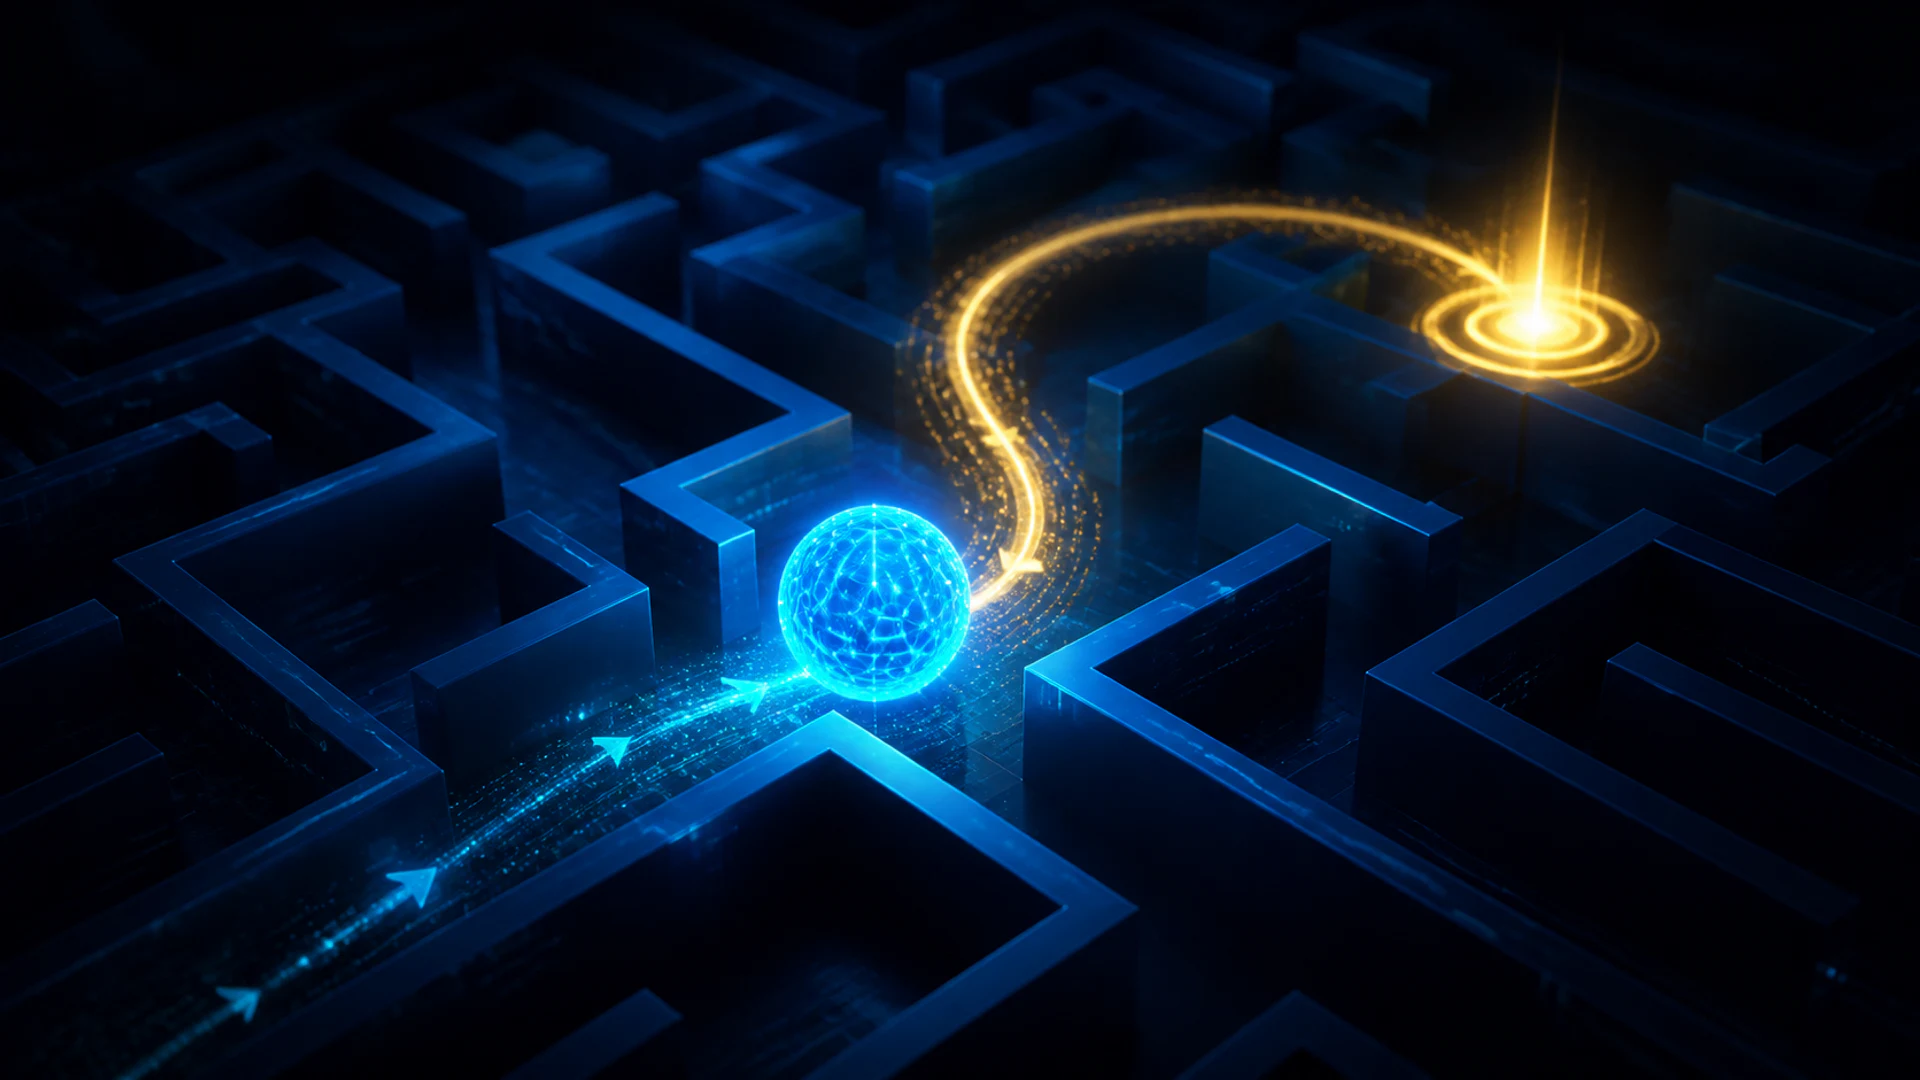
रिइन्फोर्समेंट लर्निंग (RL) एक मशीन-लर्निंग फ्रेमवर्क है जिसमें एक एजेंट पर्यावरण के साथ अंतःक्रिया करके कैसे कार्य करना सीखता है। प्रत्येक कार्रवाई के बाद, पर्यावरण बदलता है और एक इनाम लौट सकता है। एजेंट का उद्देश्य एक नीति सीखना है जो अपेक्षित संचयी इनाम को अधिकतम करे, न कि केवल अगले कदम का इनाम।
जब निर्णय समय के साथ विकसित होते हैं और एक कार्रवाई अगले होने वाले को प्रभावित करती है, तब RL का उपयोग किया जाता है। यह अवधारणात्मक रूप से सुपरवाइज़्ड लर्निंग से अलग है, जहाँ डेटा सेट प्रत्येक प्रशिक्षण उदाहरण के लिए लक्ष्य उत्तर प्रदान करता है।
मुख्य बिंदु
- एक RL समस्या में एक एजेंट, पर्यावरण, अवस्थाएँ, क्रियाएँ, इनाम, और एक नीति शामिल होती है।
- सकारात्मक और नकारात्मक सुदृढीकरण दोनों व्यवहार को बढ़ाते हैं; दंड व्यवहार को घटाता है।
- एजेंट को अपरिचित क्रियाओं की खोज और पहले से ज्ञात प्रभावी क्रियाओं के उपयोग के बीच संतुलन बनाना चाहिए।
- मूल्य-आधारित, नीति-आधारित, अभिनेता-आलोचक, मॉडल-आधारित, और ऑफ़लाइन विधियाँ विभिन्न RL सेटिंग्स को हल करती हैं।
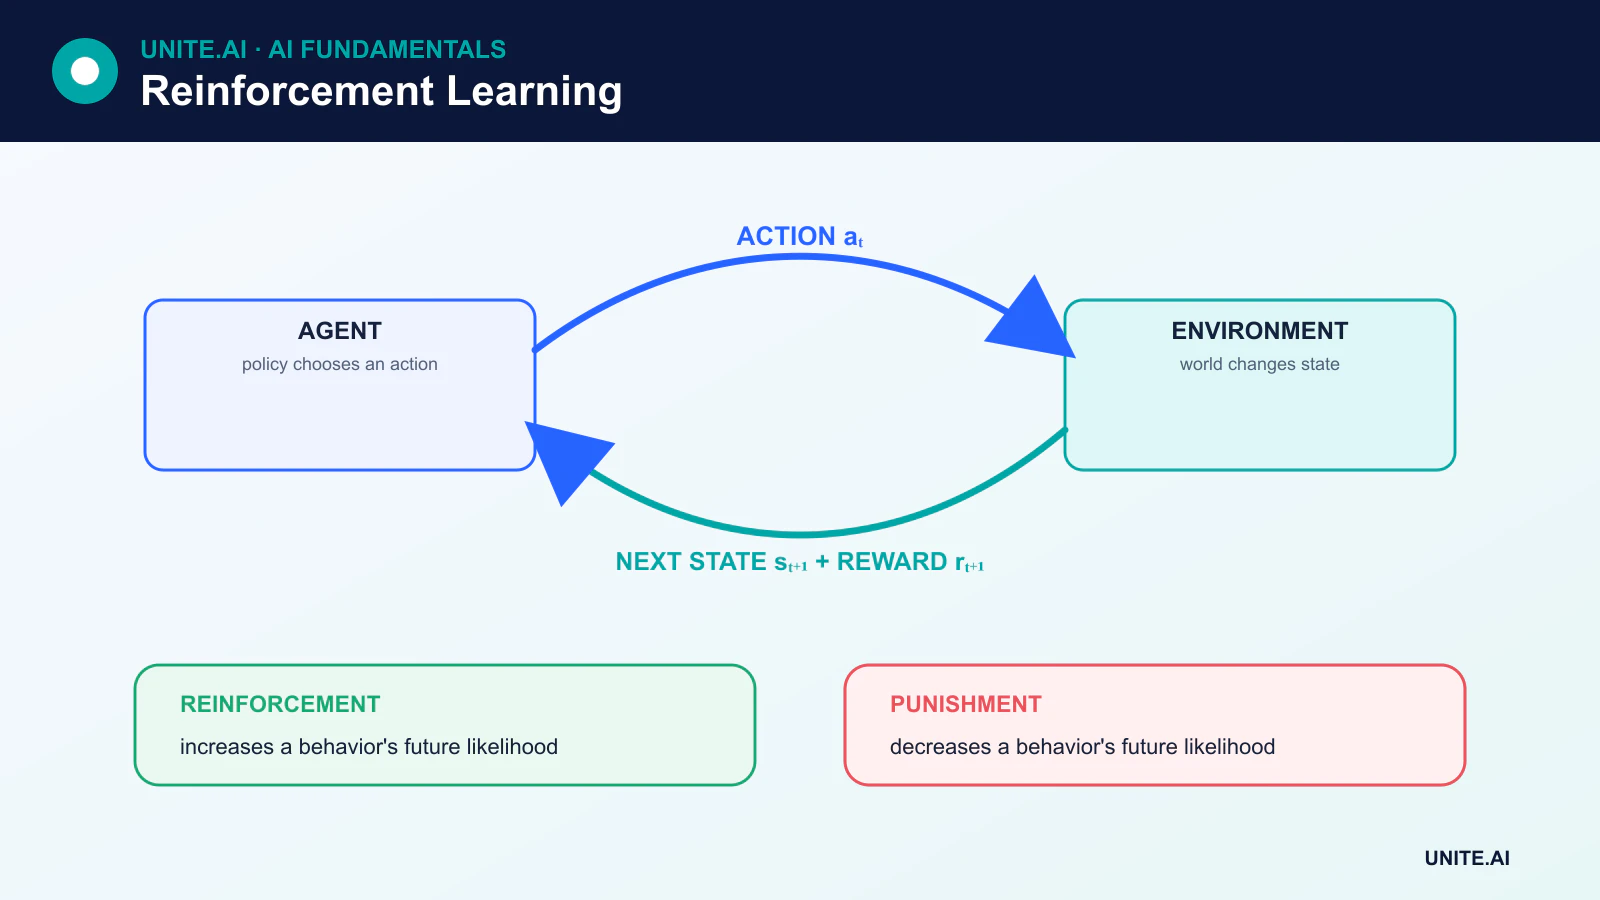
रिइन्फोर्समेंट लर्निंग के घटक
कई RL समस्याओं को मार्कोव निर्णय प्रक्रिया (MDP) के रूप में मॉडल किया जाता है। एक MDP में शामिल हैं:
- State: वर्तमान स्थिति का वर्णन करने वाली जानकारी।
- Action: एजेंट के लिए उपलब्ध विकल्प।
- Transition: कार्रवाई के बाद स्थिति कैसे बदलती है।
- Reward: संक्रमण द्वारा उत्पन्न त्वरित प्रतिक्रिया।
- Policy: क्रियाओं का चयन करने की एजेंट की रणनीति।
- Discount factor: भविष्य के इनाम को तत्काल इनाम की तुलना में कितनी ताकत से गिना जाता है।
एक अवस्था को दुनिया के बारे में सभी जानकारी प्रकट करने की आवश्यकता नहीं होती। जब महत्वपूर्ण जानकारी छिपी होती है, तो समस्या आंशिक रूप से देखी जा सकती है और एजेंट को स्मृति या विश्वास अवस्था की आवश्यकता पड़ सकती है।
सुदृढीकरण दंड के समान नहीं है
यह शब्दावली व्यवहारिक मनोविज्ञान से आती है। सकारात्मक सुदृढीकरण एक ऐसा परिणाम जोड़ता है जो किसी व्यवहार की संभावना बढ़ाता है। नकारात्मक सुदृढीकरण एक अप्रिय स्थिति को हटाता है और भी व्यवहार की संभावना बढ़ाता है। एक दंड जो किसी कार्रवाई को कम संभावित बनाने के लिए दिया जाता है, वह दंड है, न कि नकारात्मक सुदृढीकरण।
मशीन लर्निंग में, प्रैक्टिशनर अक्सर सीधे सकारात्मक इनाम, नकारात्मक इनाम, लागत, और दंड के बारे में बात करते हैं। मुख्य मुद्दा यह है कि ये संकेत एजेंट द्वारा अधिकतम करने की कोशिश किए जाने वाले रिटर्न को कैसे आकार देते हैं।
रिटर्न, मूल्य, और क्रेडिट असाइनमेंट
एक इनाम एक संक्रमण का वर्णन करता है। रिटर्न समय के साथ इनामों को मिलाता है, आमतौर पर भविष्य में देर से आने वाले इनामों को डिस्काउंट करता है। एक अवस्था-मूल्य फ़ंक्शन किसी अवस्था से अपेक्षित रिटर्न का अनुमान लगाता है, जबकि एक क्रिया-मूल्य फ़ंक्शन उस अवस्था में विशिष्ट क्रिया लेने के बाद अपेक्षित रिटर्न का अनुमान लगाता है।
यह क्रेडिट-असाइनमेंट समस्या उत्पन्न करता है: यदि कोई उपयोगी परिणाम बहुत बाद में आता है, तो कौन सी प्रारंभिक क्रियाएँ क्रेडिट के योग्य हैं? RL एल्गोरिदम इस संबंध का अनुमान लगाने के तरीके में भिन्न होते हैं।
मॉन्टे कार्लो और टेम्पोरल-डिफरेंस लर्निंग
मॉन्टे कार्लो विधियाँ पूर्ण रूप से सैंपल किए गए रिटर्न से सीखती हैं, आमतौर पर एक एपिसोड समाप्त होने के बाद। टेम्पोरल-डिफरेंस (TD) विधियाँ अंतिम परिणाम से पहले अनुमान को अपडेट करती हैं, देखे गए इनाम को अगले के अनुमान के साथ मिलाकर। इसलिए TD लर्निंग अपने वर्तमान मूल्य अनुमानों से बूटस्ट्रैप करती है।
इनमें से कोई भी परिवार सर्वत्र श्रेष्ठ नहीं है। मॉन्टे कार्लो लक्ष्य सैंपल की गई नीति के तहत पक्षपात‑रहित होते हैं लेकिन उच्च वैरिएंस हो सकता है और एपिसोड पूर्णता की आवश्यकता होती है। TD विधियाँ ऑनलाइन और निरंतर कार्यों से सीख सकती हैं, पर उनके बूटस्ट्रैप्ड लक्ष्य पक्षपात लाते हैं।
एक्सप्लोरेशन बनाम एक्सप्लॉइटेशन
एक्सप्लोरेशन उन क्रियाओं को आज़माकर जानकारी इकट्ठा करता है जिनका मूल्य अनिश्चित होता है। एक्सप्लॉइटेशन वह क्रिया चुनता है जिसे वर्तमान में सबसे अच्छा रिटर्न देने वाला माना जाता है। एक एजेंट जो कभी एक्सप्लोरेट नहीं करता, वह खराब रणनीति पर टिक सकता है; एक एजेंट जो कभी एक्सप्लॉइट नहीं करता, वह सीखी गई चीज़ों से लाभ नहीं उठा पाता।
सरल रणनीतियों में एप्सिलॉन-ग्रीडी क्रिया चयन, विश्वास‑आधारित एक्सप्लोरेशन, एंट्रॉपी बोनस, और अंतर्निहित‑इनाम विधियाँ शामिल हैं। सुरक्षा‑संकटपूर्ण परिस्थितियों में, अनियंत्रित एक्सप्लोरेशन अस्वीकार्य हो सकता है, इसलिए सिमुलेशन, प्रतिबंध, ऑफ़लाइन डेटा, या मानव निगरानी महत्वपूर्ण बन जाती हैं।
मुख्य रिइन्फोर्समेंट‑लर्निंग दृष्टिकोण
मूल्य‑आधारित विधियाँ
Q‑लर्निंग और संबंधित एल्गोरिदम क्रिया मूल्यों को सीखते हैं और उच्च‑मूल्य वाली क्रियाओं को चुनकर एक नीति निकालते हैं। डीप रिइन्फोर्समेंट लर्निंग न्यूरल नेटवर्क्स का उपयोग करती है ताकि जब अवस्था स्थान तालिका के लिए बहुत बड़े हों, तो मूल्य फ़ंक्शन या नीतियों का अनुमान लगाया जा सके।
नीति‑ग्रेडिएंट विधियाँ
नीति‑ग्रेडिएंट विधियाँ सीधे पैरामीटरयुक्त नीति को समायोजित करके अपेक्षित रिटर्न में सुधार करती हैं। ये सतत क्रियाओं और स्टोकैस्टिक नीतियों के लिए उपयोगी हैं, लेकिन उच्च वैरिएंस ग्रेडिएंट अनुमान हो सकते हैं।
एक्टर‑क्रिटिक विधियाँ
एक्टर क्रियाओं का चयन करता है जबकि एक क्रिटिक मूल्य का अनुमान लगाता है और सीखने का संकेत प्रदान करता है। यह सीधे नीति अनुकूलन को मूल्य अनुमान के साथ मिलाता है।
मॉडल‑आधारित और मॉडल‑फ्री RL
मॉडल‑आधारित सिस्टम संक्रमण और इनाम का मॉडल सीखते या उपयोग करते हैं ताकि वे योजना बना सकें। मॉडल‑फ्री सिस्टम बिना पर्यावरण को स्पष्ट रूप से मॉडल किए मूल्य या नीतियों को सीखते हैं। मॉडल‑आधारित विधियाँ अनुभव को कुशलता से उपयोग कर सकती हैं, लेकिन सीखे गए मॉडल में त्रुटियाँ योजना को भटकाने का कारण बन सकती हैं।
ऑफ़लाइन रिइन्फोर्समेंट लर्निंग
ऑफ़लाइन RL एक स्थिर डेटा सेट से सीखता है, न कि प्रशिक्षण के दौरान नई अंतःक्रियाएँ एकत्र करके। यह एक्सप्लोरेशन की लागत या जोखिम को कम कर सकता है, लेकिन एजेंट को डेटा में कम प्रतिनिधित्व वाली क्रियाओं का अधिक अनुमान लगाने से बचना चाहिए।
RLHF और मानव प्राथमिकताएँ
मानव फीडबैक से रिइन्फोर्समेंट लर्निंग (RLHF) प्राथमिकता डेटा का उपयोग करके एक रिवॉर्ड सिग्नल प्रशिक्षित करता है या सीधे नीति को अनुकूलित करता है। इसका उपयोग भाषा‑मॉडल व्यवहार को मानव निर्णयों के साथ संरेखित करने के लिए किया गया है। प्राथमिकता अनुकूलन सत्य या सुरक्षा की गारंटी नहीं है: परिणाम इस बात पर निर्भर करते हैं कि फीडबैक किसने दिया, उनसे क्या मूल्यांकन करने को कहा गया, और लक्ष्य कैसे डिज़ाइन किया गया।
सीमाएँ
RL को बहुत बड़ी संख्या में अंतःक्रियाओं की आवश्यकता हो सकती है, प्रशिक्षण के दौरान अस्थिर व्यवहार कर सकता है, और रिवॉर्ड फ़ंक्शन में अनपेक्षित शॉर्टकट का उपयोग कर सकता है। मूल्यांकन कठिन है क्योंकि परिणाम यादृच्छिक सीड और पर्यावरण विवरणों के साथ बदल सकते हैं। मजबूत प्रथा में कई रन, पारदर्शी बेसलाइन, प्रतिबंधित लक्ष्य, आउट‑ऑफ़‑डिस्ट्रिब्यूशन परीक्षण, और रिवॉर्ड हैकिंग की निगरानी शामिल है।
RL समस्या का डिजाइन: अवस्था, कार्रवाई, इनाम, और क्षितिज
रिइन्फोर्समेंट लर्निंग क्रमिक निर्णयों को मॉडल करती है। पर्यावरण एक अवलोकन उत्पन्न करता है, एजेंट नीति के तहत एक कार्रवाई चुनता है, और एक संक्रमण इनाम और अगला अवलोकन देता है। एक मार्कोव निर्णय प्रक्रिया मानती है कि अवस्था में भविष्य के संक्रमण और इनाम की भविष्यवाणी के लिए आवश्यक जानकारी होती है; आंशिक अवलोकनीयता के लिए स्मृति, विश्वास अवस्था, या पुनरावर्ती प्रतिनिधित्व आवश्यक होते हैं। डिस्काउंटिंग विलंबित परिणामों के वजन को नियंत्रित करता है, जबकि एपिसोडिक और निरंतर कार्यों को अलग‑अलग रिटर्न परिभाषाओं की आवश्यकता होती है। खराब अवस्था या कार्रवाई डिज़ाइन एक हल करने योग्य लक्ष्य को सीखने योग्य नहीं बना सकता।
इनाम डिज़ाइन व्यवहार को अप्रत्यक्ष रूप से निर्दिष्ट करता है और विफलता का प्रमुख स्रोत है। एक प्रॉक्सी का शोषण किया जा सकता है: गति के लिए इनामित एजेंट सुरक्षा को अनदेखा कर सकता है, जबकि केवल कार्य पूर्णता पर इनामित एजेंट को बहुत कम सीखने का संकेत मिल सकता है। वास्तविक आवश्यकताओं के आधार पर प्रतिबंध और समाप्ति नियम जोड़ें, इनाम संवेदनशीलता का परीक्षण करें, और अनपेक्षित रणनीतियों के लिए ट्रैजेक्टरी की जाँच करें। एक्सप्लोरेशन विधियाँ जानकारी एकत्र करने और वर्तमान ज्ञान का उपयोग करने के बीच संतुलन बनाती हैं। ऑफ‑पॉलिसी डेटा नमूना दक्षता को सुधार सकता है, लेकिन व्यवहार और लक्ष्य नीति के बीच असंगति के लिए विशेष एल्गोरिदम की आवश्यकता होती है।
मूल्यांकन, सिमुलेशन, और सुरक्षित तैनाती
मूल्य‑आधारित विधियाँ अवस्थाओं या क्रियाओं के लिए अपेक्षित रिटर्न का अनुमान लगाती हैं; नीति‑ग्रेडिएंट विधियाँ पैरामीटरयुक्त नीति को अनुकूलित करती हैं; एक्टर‑क्रिटिक विधियाँ दोनों सीखती हैं। मॉडल‑आधारित RL संक्रमण डायनामिक्स को सीखता या उपयोग करता है ताकि योजना बना सके। उपयुक्त परिवार कार्रवाई प्रकार, डेटा, सिम्युलेटर की सटीकता, क्षितिज, और स्थिरता आवश्यकताओं पर निर्भर करता है। हेयुरिस्टिक, सुपरवाइज़्ड, और कंट्रोल‑थ्योरी बेसलाइन के साथ तुलना करें। औसत और सबसे खराब स्थिति के रिटर्न, प्रतिबंध उल्लंघन, नमूना दक्षता, पर्यावरण परिवर्तन के प्रति मजबूती, और सीड्स के बीच वैरिएंस का मूल्यांकन करें, न कि केवल सबसे अच्छे लर्निंग कर्व वाले रन को चुनें।
ऑनलाइन एक्सप्लोरेशन स्वास्थ्य‑सेवा, वित्त, रोबोटिक्स, और बुनियादी ढाँचे में अस्वीकार्य हो सकता है। जहाँ संभव हो, सिमुलेशन या लॉग किए गए डेटा में प्रशिक्षण दें, सिम्युलेटर‑से‑वास्तविकता अंतर को मापें, और ऑफ‑पॉलिसी मूल्यांकन को सावधानी से उपयोग करें क्योंकि अनदेखी क्रियाओं का समर्थन नहीं होता। तैनाती को क्रियाओं, दर, संसाधनों, और संचालन क्षेत्र तक सीमित करना चाहिए; परिणामस्वरूप विकल्पों के लिए मानव अनुमोदन शामिल होना चाहिए; और एक सुरक्षित नियंत्रक या शटडाउन प्रदान करना चाहिए। इनाम को वास्तविक परिणामों के साथ मॉनिटर करें क्योंकि एजेंट अपना स्कोर बढ़ा सकता है जबकि इच्छित लक्ष्य को नुकसान पहुंचा रहा हो। पर्यावरण, नीति, या इनाम में परिवर्तन के बाद पुनः सत्यापित करें।
व्यावहारिक उदाहरण: रिइन्फोर्समेंट लर्निंग के साथ ऊर्जा नियंत्रण
एक भवन ऑपरेटर तापमान, उपस्थिति, मौसम, उपकरण अवस्था, और बिजली मूल्य को मॉडल करता है, जहाँ क्रियाएँ सुरक्षित सेटपॉइंट समायोजन तक सीमित हैं। इनाम में आराम, ऊर्जा, मांग शुल्क, और उपकरण प्रतिबंध शामिल होते हैं, लेकिन वास्तविक आराम उल्लंघनों का अलग से मूल्यांकन किया जाता है ताकि इनाम अनुकूलन नुकसान को छुपा न सके। ऐतिहासिक नियंत्रण और मॉडल‑प्रेडिक्टिव नियंत्रण बेसलाइन प्रदान करते हैं। प्रशिक्षण एक कैलिब्रेटेड सिम्युलेटर का उपयोग करता है जिसमें यादृच्छिक मौसम, सेंसर शोर, और उपकरण दक्षता शामिल है।
भवन को प्रभावित करने से पहले, नीति लाइव अवलोकनों के खिलाफ चलती है बिना कोई कार्रवाई किए। इंजीनियर ट्रैजेक्टरी, प्रतिबंध मार्जिन, और छुट्टियों, हीट वेव, आउटेज, और गायब सेंसर के दौरान व्यवहार की जाँच करते हैं। तैनाती क्रिया दर और सीमा को सीमित करती है और मौजूदा सुरक्षा नियंत्रक को बनाए रखती है। एक मानव कभी भी ओवरराइड कर सकता है। मॉनिटरिंग ऊर्जा और आराम की तुलना मिलते‑जुलते अवधि से करती है, हस्तक्षेपों को रिकॉर्ड करती है, और यदि उल्लंघन, अनपेक्षित साइक्लिंग, या मॉडल असंगति निर्धारित थ्रेशोल्ड से अधिक हो तो रोल‑बैक करती है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ता, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक उपेक्षित समूहों या पर्यावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। एक चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित बैकअप बनाए रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया जिम्मेदार को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, यह मानने के बजाय कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या लक्ष्य बदलें, पुनः‑मूल्यांकन करें। एक बनाए रखा गया सिस्टम दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, हटाने और रखरखाव प्रक्रियाएँ, और एक स्पष्ट बिंदु भी चाहिए जहाँ इसे निष्क्रिय या बदलना चाहिए।
प्राथमिक संदर्भ