
KI-Modelle und Plattformen
Innerhalb von OpenAIs o3 und o4-mini: Freischaltung neuer Möglichkeiten durch multimodales Reasoning und integrierte Toolsets

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Am 16. April 2025 veröffentlichte OpenAI aktualisierte Versionen seiner fortschrittlichen Reasoning-Modelle. Diese neuen Modelle, o3 und o4-mini, bieten Verbesserungen gegenüber ihren Vorgängern, o1 und o3-mini. Die neuesten Modelle liefern verbesserte Leistung, neue Funktionen und größere Zugänglichkeit. Dieser Artikel erforscht die primären Vorteile von o3 und o4-mini, skizziert ihre Hauptfähigkeiten und diskutiert, wie sie die Zukunft von KI-Anwendungen beeinflussen könnten. Bevor wir jedoch in die Details von o3 und o4-mini eintauchen, ist es wichtig, OpenAIs Entwicklung von großen Sprachmodellen und Reasoning-Systemen zu verstehen.
OpenAIs Entwicklung von großen Sprachmodellen
OpenAIs Entwicklung von großen Sprachmodellen begann mit GPT-2 und GPT-3, die ChatGPT in den Mainstream brachten, dank ihrer Fähigkeit, flüssigen und kontextuell genauen Text zu produzieren. Diese Modelle wurden weitgehend für Aufgaben wie Zusammenfassung, Übersetzung und Fragebeantwortung eingesetzt. Als Benutzer sie jedoch auf komplexere Szenarien anwendeten, wurden ihre Einschränkungen deutlich. Diese Modelle hatten oft Schwierigkeiten mit Aufgaben, die tiefes Reasoning, logische Konsistenz und mehrschrittiges Problemlösen erforderten. Um diese Herausforderungen zu bewältigen, führte OpenAI GPT-4 ein und konzentrierte sich auf die Verbesserung der Reasoning-Fähigkeiten seiner Modelle. Diese Verschiebung führte zur Entwicklung von o1 und o3-mini. Beide Modelle verwendeten eine Methode namens Chain-of-Thought-Prompting, die es ihnen ermöglichte, logischere und genauere Antworten zu generieren, indem sie schrittweise reasonierten. Während o1 für fortgeschrittene Problemlösungsaufgaben konzipiert ist, ist o3-mini darauf ausgelegt, ähnliche Fähigkeiten auf effizientere und kostengünstigere Weise bereitzustellen. Auf dieser Grundlage hat OpenAI nun o3 und o4-mini eingeführt, die die Reasoning-Fähigkeiten ihrer LLMs weiter verbessern. Diese Modelle sind darauf ausgelegt, genauere und besser durchdachte Antworten zu liefern, insbesondere in technischen Bereichen wie Programmierung, Mathematik und wissenschaftlicher Analyse – Domänen, in denen logische Präzision entscheidend ist. Im folgenden Abschnitt werden wir untersuchen, wie o3 und o4-mini ihre Vorgänger verbessern.
Schlußfolgerungen in o3 und o4-mini
Verbesserte Reasoning-Fähigkeiten
Eine der wichtigsten Verbesserungen in o3 und o4-mini ist ihre verbesserte Reasoning-Fähigkeit für komplexe Aufgaben. Im Gegensatz zu früheren Modellen, die schnelle Antworten lieferten, nehmen o3 und o4-mini mehr Zeit, um jeden Prompt zu verarbeiten. Diese zusätzliche Verarbeitung ermöglicht es ihnen, gründlicher zu reasonieren und genauere Antworten zu liefern, was zu verbesserten Ergebnissen auf Benchmarks führt. Zum Beispiel übertrifft o3 o1 um 9% auf LiveBench.ai, einem Benchmark, der die Leistung über mehrere komplexe Aufgaben wie Logik, Mathematik und Code bewertet. Auf dem SWE-Benchmark, der das Reasoning in Software-Engineering-Aufgaben testet, erzielte o3 eine Punktzahl von 69,1%, was sogar konkurrierende Modelle wie Gemini 2.5 Pro übertraf, das 63,8% erreichte. O4-mini erreichte auf dem gleichen Benchmark 68,1%, was fast die gleiche Reasoning-Tiefe bei wesentlich geringeren Kosten bietet.
Multimodale Integration: Denken mit Bildern
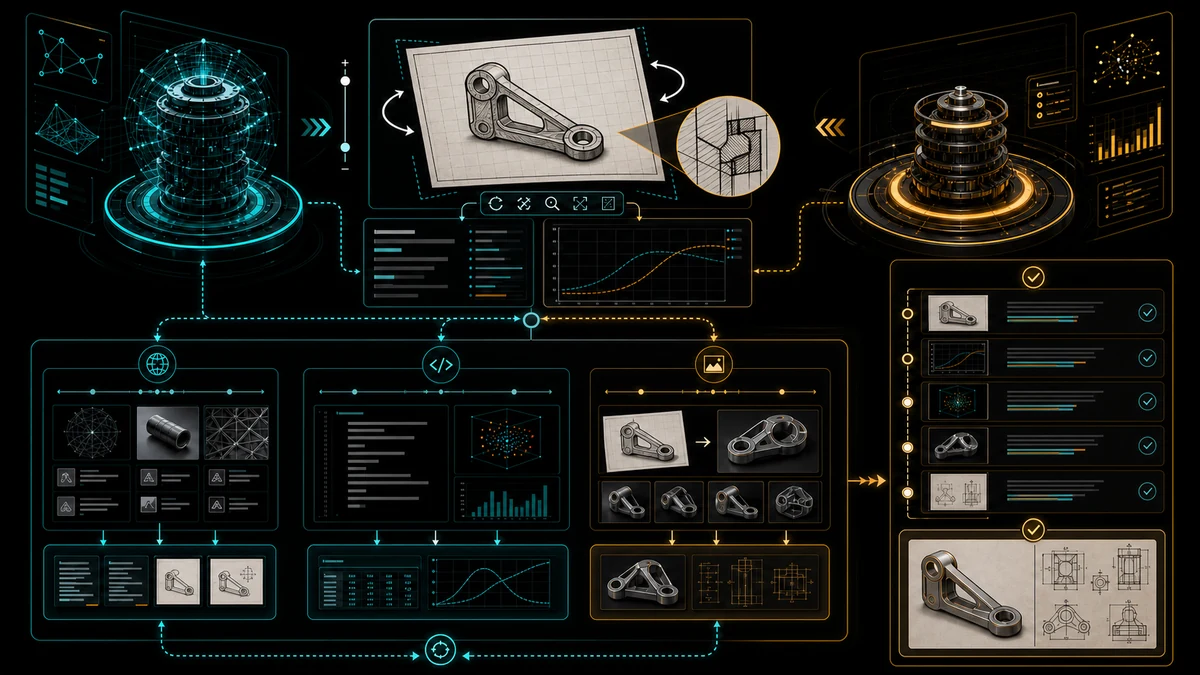
Eine der innovativsten Funktionen von o3 und o4-mini ist ihre Fähigkeit, “mit Bildern zu denken”. Das bedeutet, dass sie nicht nur textuelle Informationen verarbeiten, sondern auch visuelle Daten direkt in ihren Reasoning-Prozess integrieren können. Sie können Bilder analysieren und verstehen, sogar wenn sie von schlechter Qualität sind – wie handschriftliche Notizen, Skizzen oder Diagramme. Zum Beispiel könnte ein Benutzer ein Diagramm eines komplexen Systems hochladen, und das Modell könnte es analysieren, potenzielle Probleme identifizieren oder sogar Vorschläge für Verbesserungen machen. Diese Fähigkeit schließt die Lücke zwischen textuellen und visuellen Daten und ermöglicht intuitivere und umfassendere Interaktionen mit KI. Beide Modelle können Aktionen wie Zoomen auf Details oder Drehen von Bildern ausführen, um sie besser zu verstehen. Diese multimodale Reasoning ist ein wesentlicher Fortschritt gegenüber Vorgängern wie o1, die hauptsächlich textbasiert waren. Sie eröffnet neue Möglichkeiten für Anwendungen in Bereichen wie Bildung, wo visuelle Hilfsmittel entscheidend sind, und Forschung, wo Diagramme und Grafiken oft zentral für das Verständnis sind.
Erweiterte Tool-Nutzung
o3 und o4-mini sind die ersten OpenAI-Modelle, die alle in ChatGPT verfügbaren Tools gleichzeitig nutzen. Zu diesen Tools gehören:
- Web-Browsing: Damit die Modelle die neuesten Informationen für zeitkritische Abfragen abrufen können.
- Python-Code-Ausführung: Damit sie komplexe Berechnungen oder Datenanalysen durchführen können.
- Bildverarbeitung und -generierung: Damit sie ihre Fähigkeit, mit visuellen Daten zu arbeiten, verbessern können.
Durch die Nutzung dieser Tools können o3 und o4-mini komplexe, mehrschrittige Probleme effektiver lösen. Wenn beispielsweise ein Benutzer eine Frage stellt, die aktuelle Daten erfordert, kann das Modell eine Web-Suche durchführen, um die neuesten Informationen abzurufen. Ebenso kann es für Aufgaben, die Datenanalyse erfordern, Python-Code ausführen, um die Daten zu verarbeiten. Diese Integration ist ein wesentlicher Schritt in Richtung autonomer KI-Agenten, die eine breitere Palette von Aufgaben ohne menschliche Intervention bewältigen können. Die Einführung von Codex CLI, einem leichten, Open-Source-Coding-Agent, der mit o3 und o4-mini zusammenarbeitet, erhöht ihre Nützlichkeit für Entwickler.
Auswirkungen und neue Möglichkeiten
Die Veröffentlichung von o3 und o4-mini hat weitreichende Auswirkungen auf verschiedene Branchen:
- Bildung: Diese Modelle können Schülern und Lehrern helfen, indem sie detaillierte Erklärungen und visuelle Hilfsmittel bereitstellen, was das Lernen interaktiver und effektiver macht. Zum Beispiel könnte ein Schüler eine Skizze eines Mathematikproblems hochladen, und das Modell könnte eine schrittweise Lösung bereitstellen.
- Forschung: Sie können die Entdeckung beschleunigen, indem sie komplexe Datensätze analysieren, Hypothesen generieren und visuelle Daten wie Grafiken und Diagramme interpretieren, was für Bereiche wie Physik oder Biologie von unschätzbarem Wert ist.
- Industrie: Sie können Prozesse optimieren, Entscheidungen verbessern und Kundeninteraktionen durch die Verarbeitung von textuellen und visuellen Abfragen verbessern, wie z.B. die Analyse von Produktentwürfen oder die Lösung technischer Probleme.
- Kreativität und Medien: Autoren können diese Modelle nutzen, um Kapitelübersichten in einfache Storyboards umzuwandeln. Musiker können visuelle Elemente zu einer Melodie hinzufügen. Filmredakteure erhalten Vorschläge für die Timing. Architekten können handgezeichnete Grundrisse in detaillierte 3D-Bläupausen umwandeln, die Struktur- und Nachhaltigkeitsnotizen enthalten.
- Barrierefreiheit und Inklusion: Für blinde Benutzer beschreiben die Modelle Bilder detailliert. Für gehörlose Benutzer konvertieren sie Diagramme in visuelle Sequenzen oder untertitelten Text. Ihre Übersetzung von Texten und Bildern hilft, Sprach- und Kulturbarrieren zu überbrücken.
- Richtung autonome Agenten: Da die Modelle im Web browsen, Code ausführen und Bilder in einem Workflow verarbeiten können, bilden sie die Grundlage für autonome Agenten. Entwickler beschreiben eine Funktion; das Modell schreibt, testet und deployt den Code. Wissensarbeiter können die Datenerfassung, -analyse, -visualisierung und Berichterstellung an einen einzigen KI-Assistenten delegieren.
Einschränkungen und was als Nächstes kommt
Trotz dieser Fortschritte haben o3 und o4-mini immer noch einen Wissensstand von August 2023, der ihre Fähigkeit, auf die neuesten Ereignisse oder Technologien zu reagieren, einschränkt, es sei denn, sie werden durch Web-Browsing ergänzt. Zukünftige Iterationen werden wahrscheinlich diese Lücke durch die Verbesserung der Echtzeit-Datenverarbeitung schließen.
Wir können auch weiteren Fortschritt in Richtung autonomer KI-Agenten erwarten – Systeme, die planen, reasonieren, handeln und lernen können, mit minimaler menschlicher Aufsicht. OpenAIs Integration von Tools, Reasoning-Modellen und Echtzeit-Datenzugriff signalisiert, dass wir uns diesen Systemen nähern.
Fazit
OpenAIs neue Modelle, o3 und o4-mini, bieten Verbesserungen in Reasoning, multimodalem Verständnis und Tool-Integration. Sie sind genauer, vielseitiger und nützlicher über eine breite Palette von Aufgaben – von der Analyse komplexer Daten und der Code-Generierung bis zur Interpretation von Bildern. Diese Fortschritte haben das Potenzial, die Produktivität erheblich zu steigern und die Innovation in verschiedenen Branchen zu beschleunigen.





