
Interviews
Fabiana Clemente, Mitgründerin und Chief Data Officer bei YData – Interviewreihe

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
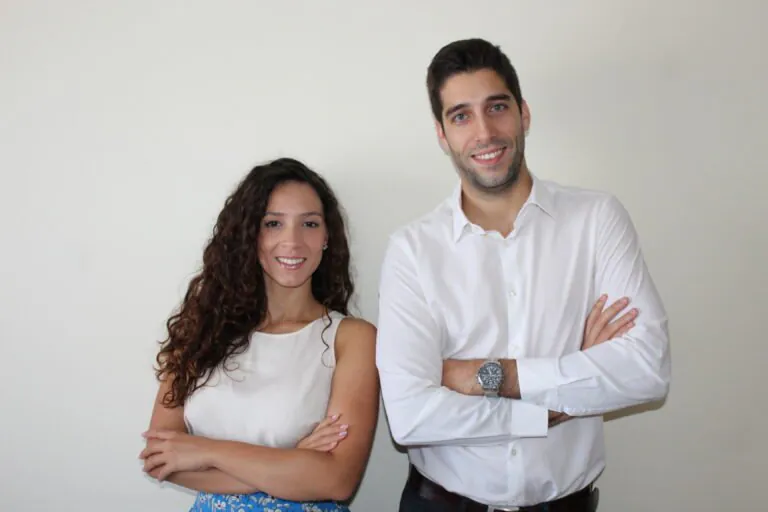
Fabiana Clemente ist die Mitgründerin und Chief Data Officer bei YData. YData ist ein KI-Startup, das die erste datenzentrierte Entwicklungslösung entwickelt hat, um Datenentdeckung, -verbesserung und -skalierung in einer einzigen Plattform zu kombinieren.
Was hat Sie ursprünglich zur KI und zum maschinellen Lernen hingezogen?
Mein Hintergrund liegt in der angewandten Mathematik, wo ich die Gelegenheit hatte, zu lernen und zu verstehen, wie wir Informationen aus Daten extrahieren können, sowie wie man dies mithilfe von Code tut. Zu dieser Zeit war es nicht so “sexy” wie das maschinelle Lernen, aber es war definitiv das, was meine Leidenschaft für diesen Bereich entfachte.
Können Sie die Entstehungsgeschichte hinter YData teilen?
Als Data Scientist, der für Startups und Unternehmen gearbeitet hat, hatte ich meine fairen Anteil an Herausforderungen – manchmal war der Zugriff auf Daten aus Sicherheits- oder Datenschutzgründen blockiert, manchmal war der Zugriff einfach, aber die Qualität der Daten war nicht einmal annähernd ausreichend, um KI-basierte Lösungen zu entwickeln. Da ich wusste, dass diese Herausforderungen in den meisten Organisationen sehr häufig sind, inspirierte uns dies, das Unternehmen mit dem Ziel zu gründen, diesen Teams zu helfen, diese Hindernisse zu überwinden, indem wir ihre KI-Entwicklung mit verbesserten Daten beschleunigen.
Können Sie unserem Publikum erklären, was synthetische Daten sind?
Synthetische Daten gelten als alle Daten, die nicht in der realen Welt generiert wurden, also alle Daten, die künstlich erstellt wurden. Es gibt Methoden, die die Generierung von synthetischen Daten ermöglichen – von regelbasierten Strategien bis hin zur Verwendung von Machine- oder Deep-Learning-Modellen, um diese “Regeln” für uns zu lernen. Bei YData haben wir uns auf eine Deep-Learning-basierte Strategie spezialisiert, um neue Daten zu generieren, die das Verhalten von realen Ereignissen beibehalten, ohne Bedenken hinsichtlich des Datenschutzes.
Was macht synthetische Daten so wichtig?
Je mehr Organisationen die Bedeutung von Daten für den Aufschwung ihrer Geschäfte erkennen, desto mehr wird die Bedeutung und Rolle von synthetischen Daten verstanden. Die Erfassung von echten Daten ist nicht nur zeitaufwändig und teuer, sondern manchmal auch unmöglich. Um KI-Anwendungen zu entwickeln, sind Daten ein harter Anforderung – hier kommt die synthetische Datenrettung. Die Fähigkeit, unsichtbare Szenarien zu generieren oder einfach den Zugriff auf Daten zu entsperren, ist der Schlüssel, um in einer Welt voranzukommen, in der Pioniere wie Andrew Ng feststellen, dass es wichtig ist, datenzentriert zu werden, um eine erfolgreiche KI-Adoption zu erreichen.
Wir können bereits in selbstfahrenden Autos oder anderen Automatisierungsaktivitäten die Bedeutung von synthetischen Daten erkennen, also denke ich, dass es nur natürlich ist, dass dieses Verständnis sich über alle Branchen ausbreitet.
Wie generiert YData synthetische Daten?
YData nutzt hauptsächlich Deep-Generative-Modelle, um die statistischen Attribute und Korrelationen zwischen Variablen der ursprünglichen Daten zu erlernen. Dies ermöglicht es dem Modell, ein statistisch relevantes Dataset zu generieren, das den gleichen Geschäftswert wie das Original hat, ohne dass die ursprünglichen Aufzeichnungen nachverfolgt werden können.
YData treibt diese Technologie voran und ist das Unternehmen hinter der Synthetic Data Community – einer Gruppe von Data-Science-Experten, die sich verpflichtet haben, diese Technologie zu verbreiten und jedem zu helfen, der sie lernen und verwenden möchte.
Wie hilft die YData-Plattform bei der Entdeckung und Freigabe neuer Datenquellen?
Die YData-Plattform enthält integrierte Konnektoren für jede Art von Datenbank, Data-Warehouse oder Data-See, die es Benutzern ermöglicht, einfach auf relevante Metadaten zuzugreifen und zu verstehen, ob die vorhandenen Daten nützlich sind, um die Geschäftsfrage zu beantworten, die sie in den Händen haben – ohne sogar die realen Aufzeichnungen anzusehen.
Können Sie einige Details zur Synthetic Data Open Source Community teilen?
Synthetische Daten sind noch in den frühen Tagen und deshalb ist das Bewusstsein darüber, wie sie generiert werden, welche Vorteile oder Einschränkungen sie haben, noch nicht bei einem größeren Publikum angekommen. Deshalb haben wir bei YData beschlossen, einen eher pädagogischen Ansatz zu verfolgen, indem wir die Synthetic Data Community geschaffen haben – neben einem Ort, an dem man Ideen austauschen oder Hilfe von Experten im Bereich synthetischer Daten erhalten kann, ist es auch ein Ort, an dem Data Scientists und andere technische Profile ihre Reise in die synthetischen Daten beginnen können, mit einigen der interessantesten Algorithmen aus der Literatur.
Wir bieten auch eine Perspektive auf die Datenqualität, damit Data Scientists zuerst die Daten verstehen, mit denen sie arbeiten, bevor sie diese synthetisieren oder die Datenverbesserung durchführen. Wir sind wirklich daran interessiert, Daten-Teams zu helfen, datenzentrierter zu werden.
YData hat kürzlich 2,7 Millionen Dollar an Finanzierungsmitteln gesichert, um die internationale Expansion zu beschleunigen. Können Sie einige Details darüber teilen, was dies für die Zukunft des Unternehmens und seine Expansionsstrategie bedeutet?
YData ist bereits international aufgestellt – wir wussten, dass diese Art von Technologie frühe Anwender benötigt, die normalerweise in den am weitesten entwickelten Ländern zu finden sind. Deshalb waren unsere ersten Kunden bereits außerhalb von Portugal, über ganz Europa verteilt, und wir etablieren nun eine Präsenz in Nordamerika. Diese Finanzierung ermöglicht es uns, unsere Präsenz auf beiden Kontinenten zu stärken, nicht nur kommerziell, sondern auch, um das Team zu vergrößern: Wir sind ein vollständig verteiltes Team, was es uns ermöglicht, die besten Talente zu rekrutieren, wo immer sie sind.
Gibt es noch etwas, das Sie über YData teilen möchten?
YData treibt die Grenzen der datenzentrierten KI voran und schafft eine neue Kategorie: DataPrepOps – obwohl es ein hässlicher Name ist, ist es ein Schmerz, den die meisten Unternehmen heutzutage bei der Datenwissenschaftsentwicklung haben. Die Datenqualitätstrend setzt sich fort und nach Data Pipelines und Data Observability ist die Datenqualität für Data-Science-Teams noch in den Kinderschuhen und YData etabliert sich als Thought Leader in der Datenpräparation.
Vielen Dank für das großartige Interview. Leser, die mehr erfahren möchten, sollten YData besuchen.


